


投稿作者:周中柱(悉尼大学博士、TogetherAI 高级研究科学家)
长上下文推理正在把 KV Cache 推成大模型 serving 的关键瓶颈。每生成一个新 token,模型都要反复读取越来越长的历史 Key 和 Value;上下文越长、batch 越大,KV Cache 对显存容量和带宽的压力就越明显。直接把历史 KV 压到 INT2 看似能大幅省显存,但极低比特量化很容易破坏 attention 分布,导致推理和代码任务明显掉分。
为什么 2-bit KV Cache 这么难?INT2 只有 4 个量化等级,而 KV activation 中常常有少数幅值极大的 outlier channel。如果这些 outlier 主导量化尺度,大多数正常值会被挤到很少的有效等级里,注意力分布很快漂移。普通 Hadamard 旋转能把 outlier 摊平,但它不知道模型在 attention 里真正读哪些方向。
在这项工作中,Together AI 团队及其合作者提出了 OSCAR,一种 attention-aware 的 2-bit KV Cache 量化方案:先在离线阶段估计每层、每个 head 的注意力相关协方差,再生成固定旋转矩阵和裁剪阈值,让量化误差尽量避开 attention 最敏感的方向。
论文:https://arxiv.org/abs/2605.17757
项目主页:https://oscar-quantize.github.io/
代码:https://github.com/FutureMLS-Lab/OSCAR
简单来说,OSCAR 的核心就是把旋转目标从“重建原始 K/V 向量”改成“保留 attention 消费 KV 的方式”。
在约 2.28 effective bits per KV element 的预算下,OSCAR 仍能接近 BF16;在 Qwen3-4B-Thinking 上,相比全层 3-bit K/V TurboQuant 最高提升 40.1 分。
如图 1,研究团队对比了 naive INT2、Hadamard-only、clip-only 和 OSCAR 在量化误差传播链路上的差异。关键点是, 相比之前量化的工作,比如 TurboQuant 压缩的是向量,但忽略了真正影响模型的是 attention 的质量,OSCAR 保留的是 attention 真正会读的方向。
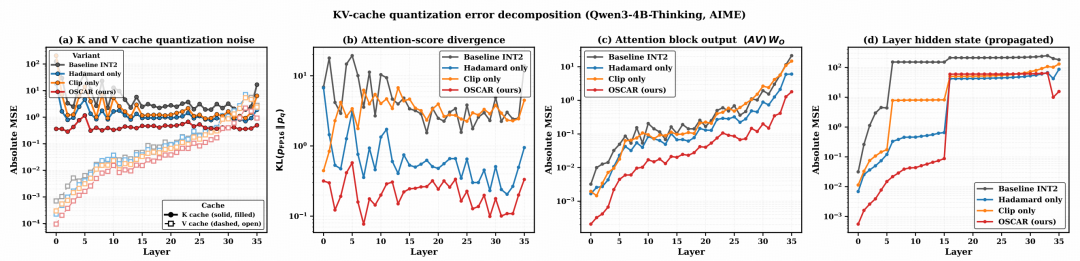
图 1:为什么只看 K/V 重建误差会误导判断
OSCAR 的意义在于,它把“低比特 KV Cache 能不能真正上线”这个问题拆成了精度和系统两部分同时处理。它既不是只追求 K/V 张量重建误差,也不是靠保留大量高精度层来换分,而是围绕 attention 的实际使用方式设计旋转、裁剪、分组和在线 cache 布局。对长上下文 Agent、共享系统提示、多轮工具调用等长前缀高复用场景来说,这类方案有机会把显存节省直接转化为更高并发和更低解码成本。
研究方法
图 2 展示了 OSCAR 从离线校准到在线 serving 的端到端流程。
在离线阶段,OSCAR 基于少量校准样本估计 attention-aware rotation 与 clipping thresholds,使 KV activations 在进入 INT2 量化前被变换到更适合低比特表示的空间。
在线 serving 阶段,系统保留 sink tokens 与 recent tokens 为 BF16,以维持关键上下文的精度;而占比最大的历史 KV cache 则经过 rotation 后以 INT2 形式存储,并集成到 SGLang paged KV cache 中进行真实推理。因此,OSCAR 不仅是一个单独的量化方法,而是一套面向实际 LLM serving 的 2-bit KV cache compression pipeline,同时覆盖离线校准、混合精度缓存管理与在线 paged-KV 部署。
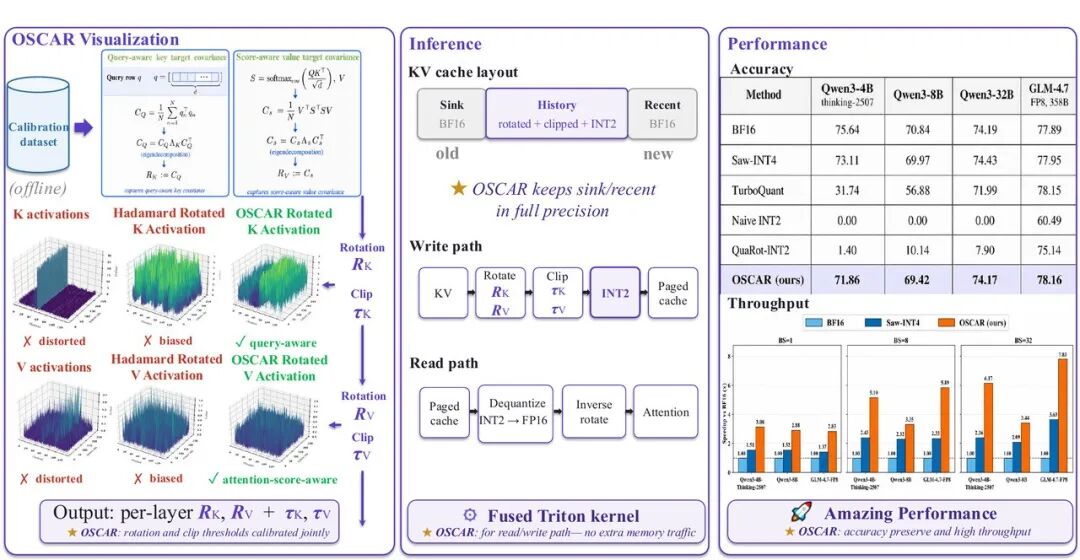
图 2:OSCAR 整体流程图
具体而言,OSCAR分为以下几点:
注意力感知旋转:对 Key,量化误差会通过 QKᵀ 进入 attention logits,因此 OSCAR 用 query covariance(QᵀQ)来指导 Key 的旋转;对 Value,误差会被 attention score 加权后进入输出,因此使用 score-weighted value covariance(VᵀSᵀSV)来指导 Value 的旋转。
旋转与分组设计:最终旋转由 U、Hadamard 和 bit-reversal 组合而成。U 对齐 attention 相关方向,Hadamard 分散 outlier 能量,bit-reversal 让 INT2 分组更均衡,避免少数异常通道主导某个 group 的量化尺度。
离线校准:系统只需要少量校准样本,就能为每层、每个 head 估计 rotation matrix 和 clipping threshold。参数生成后在推理阶段固定复用,不依赖任务级微调,也不需要在线学习。
在线 serving 路径:OSCAR 在 SGLang 中采用三段式 token pool:BF16 sink(64 tokens)、INT2 history、BF16 recent(256 tokens)。新 token 先进入 recent window,随着解码推进,较老 token 会由融合 Triton kernel 完成 rotate、clip、quantize 和 pack,再进入 INT2 history。decode 时,INT2 段和 BF16 段分别计算,最后通过 online softmax merge 合并结果。
研究结果
OSCAR 代码库已经支持 Qwen3-4B-Thinking、Qwen3-8B、Qwen3-32B, Qwen3.5 系列,GLM-4.7-FP8,minimax2.7 等现代 reasoning/coding 模型。
OSCAR 系统评测,覆盖 GPQA、HumanEval、LiveCodeBench v6、AIME25、MATH500 以及 128K 长上下文 RULER-NIAH。结果表明,在接近真实 2-bit 的 2.28 BPE 设置下,OSCAR 仍能基本保持 BF16 质量:小模型约掉 1.6 的精度,中/大规模模型几乎与 BF16 持平;相比之下,naive INT2 和 QuaRot-INT2 在复杂 reasoning/coding 任务上大多崩溃,TurboQuant 在公平的全层低比特设置下也出现明显质量下降。
与此同时,OSCAR 带来直接的系统收益:相对 BF16 history KV storage 可减少约 8× KV cache memory,在长上下文和 prefix-cache 命中场景下实现最高约 3× decode 加速和约 7× job-level throughput 提升。
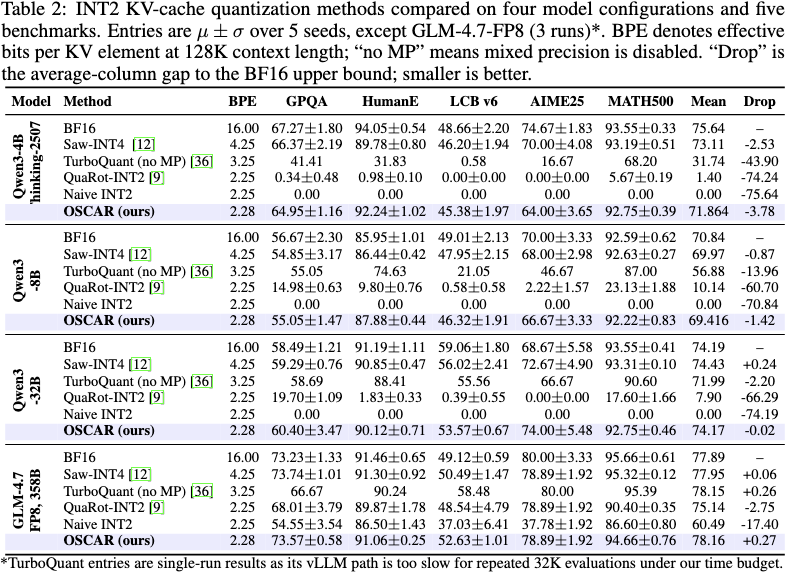
图 3:完整主结果表,多种 KV 量化方法同场对比
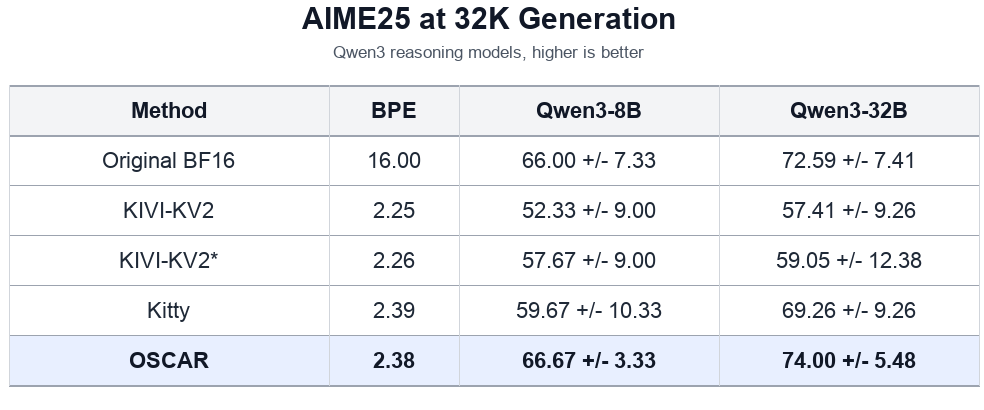
图 4:AIME25 32K 生成,和 KIVI / Kitty 的专项对比
- 精度方面,在 Qwen3-4B-Thinking、Qwen3-8B、Qwen3-32B 和 GLM-4.7-FP8 上评估,任务覆盖 GPQA、HumanEval、LiveCodeBench v6、AIME25 和 MATH500,最长生成长度达到 32K,并对每个配置运行 5 次取平均。见图 3,4。在 2.28 BPE 下,OSCAR 在 Qwen3-4B-Thinking 上距离 BF16 只差 3.78 分,在 Qwen3-8B 上只差 1.42 分;到 Qwen3-32B 和 GLM-4.7-FP8 时,整体表现基本贴近 BF16。对照方法中,naive INT2 和 QuaRot-INT2 在 reasoning / coding 任务上经常出现明显退化;全层 3-bit K/V TurboQuant 在没有 mixed-precision 保护的公平设置下,小模型分数也有较大损失。
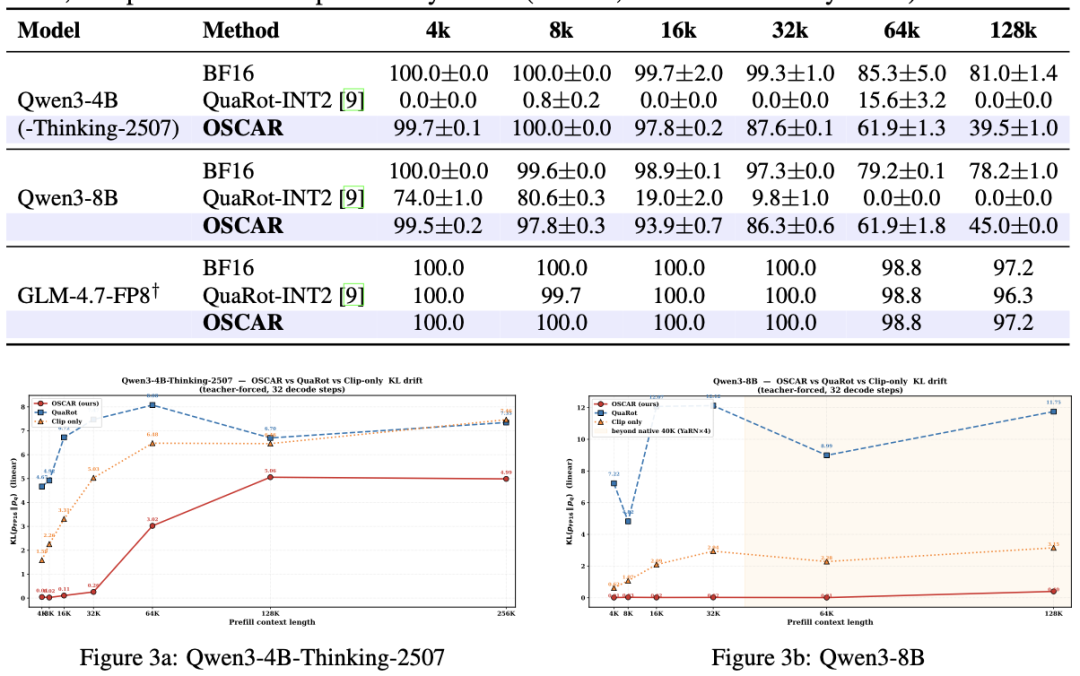
图 5:long context 下 OSCAR的稳定KL
- 长上下文方面,128K RULER-NIAH 测试显示,OSCAR 在 Qwen3-8B 和 GLM-4.7-FP8 上保持了更稳定的检索能力,说明 attention-aware rotation 可以缓解历史 KV 误差随上下文长度积累的问题。见图5。
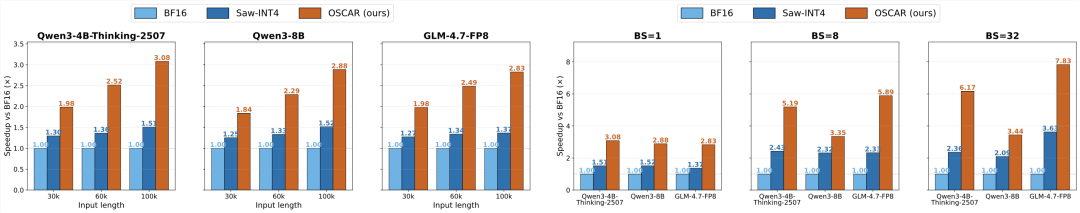
图 6:100k 长上下文下的 decode / batch throughput
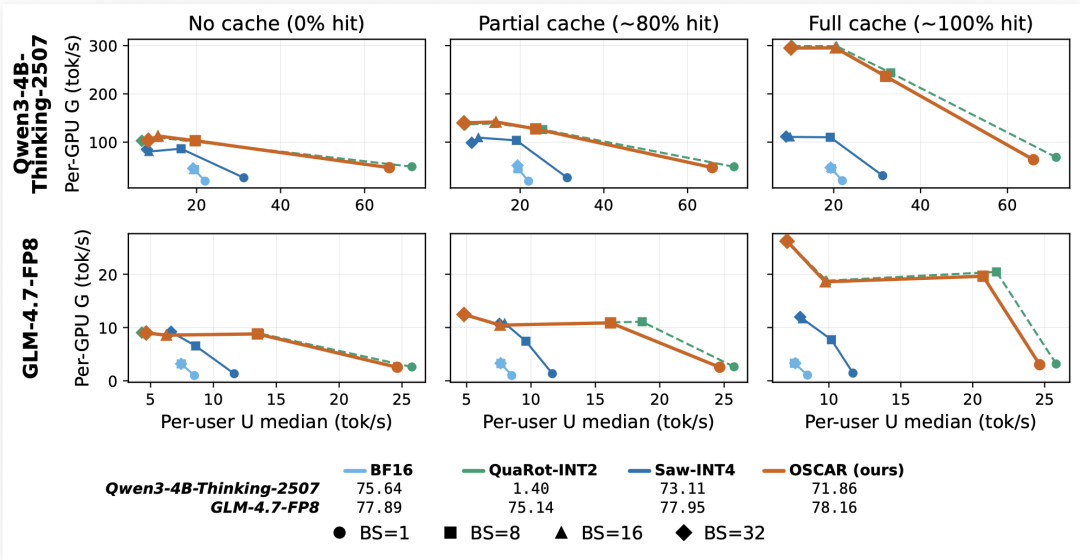
图 7:prefix cache 命中率越高,吞吐前沿越往外推
- 系统方面,相比 BF16 history storage,OSCAR 可将 KV Cache memory 降低约 8 倍;在 100k context、batch-size-1、full prefix-cache hit 的设置下,decode 最高约 3 倍加速;在大 batch 且显存预算固定时,job-level throughput 最高约 7 倍。见图6,7。
不足与未来方向
当然,这项研究依然存在一些局限性。
例如,当前结果已经覆盖多个模型和任务,但真实线上 workload 更复杂,仍需要在更多模型架构、硬件环境、prefix cache 命中模式和多租户场景中继续验证。
另外,OSCAR 重点解决的是 attention-aware rotation 与 2-bit KV serving,未来可以进一步探索与 TurboQuant 这类更强 codebook / online vector quantization 方法结合,把压缩率和精度边界继续向前推。
最后,生产部署还需要关注 kernel 兼容性、调度开销、cache layout 复杂度、异常长请求下的尾延迟,以及 INT2 history 与 BF16 sink/recent 窗口大小的动态选择。
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢