

Qwen4 还没正式登场,阿里通义千问团队先放出了「架构预告」—— Qwen3.8-Flash-Next 已正式开放权重!
作为 Qwen4 模型结构的先导预览版本,Qwen3.8-Flash-Next 是一款多模态 MoE 模型,围绕 Attention、Residual、Embedding 和 Optimization 四个方面进行系统升级:通过 GDN + QSA 混合注意力降低长上下文计算开销,引入 Gated Residual 增强跨层信息传递稳定性,并利用 N-gram Embedding以更低计算成本扩展模型容量,探索更高效的大模型架构设计。同时在优化层面引入 Muon 优化器,并针对正交化精度、Muon 与 AdamW 的参数分工等进行调整。
模型在效率与能力之间实现了新的平衡:Qwen3.8-Flash-Next 主模型参数量达到 125B,额外配备 51B N-gram Embedding,每 token 激活参数仅 6B;相比 Qwen3.7-Plus,训练成本降低至约 1/9,同时在编码、办公等任务中展现出更强表现。此外,模型原生支持 262K Token 上下文,并可通过 YaRN 扩展至 100 万 Token,适用于长文档分析、复杂推理和 Agent 工作流等场景。
目前,HyperAI 教程板块已上线「Qwen3.8-Flash-Next-FP8 多模态大模型」 ,支持一键完成模型部署,快速体验其长上下文、多模态与高效推理能力~
在线运行:
更多在线教程:
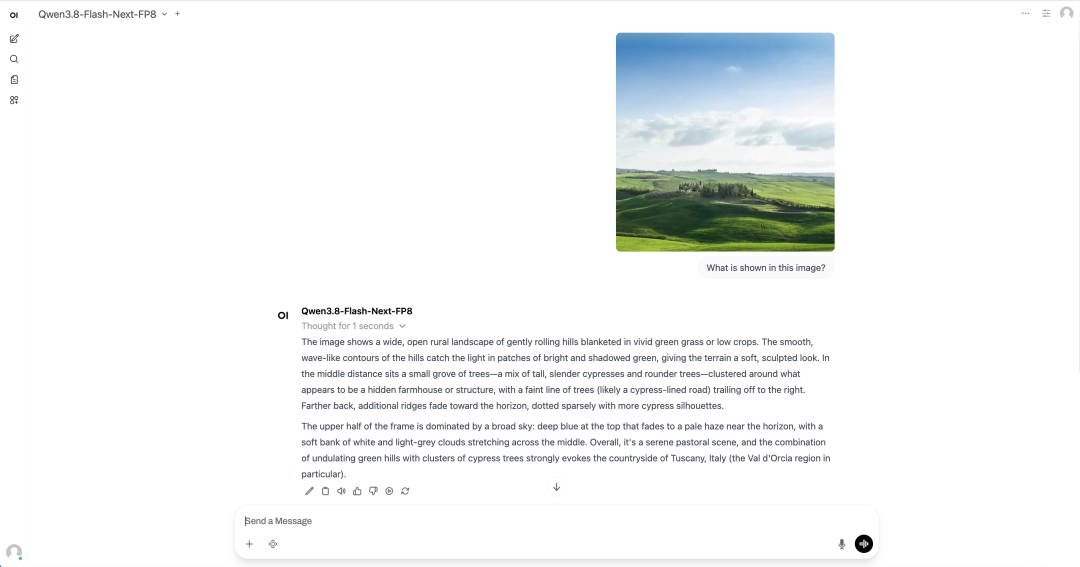
demo 页面
Demo 运行
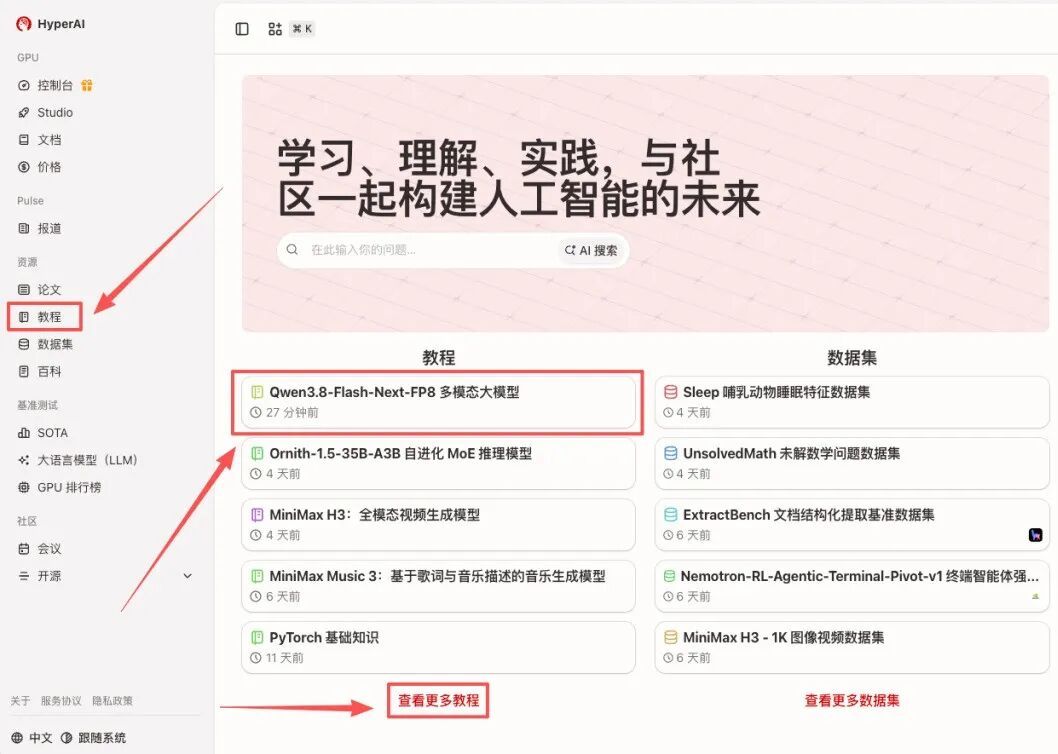
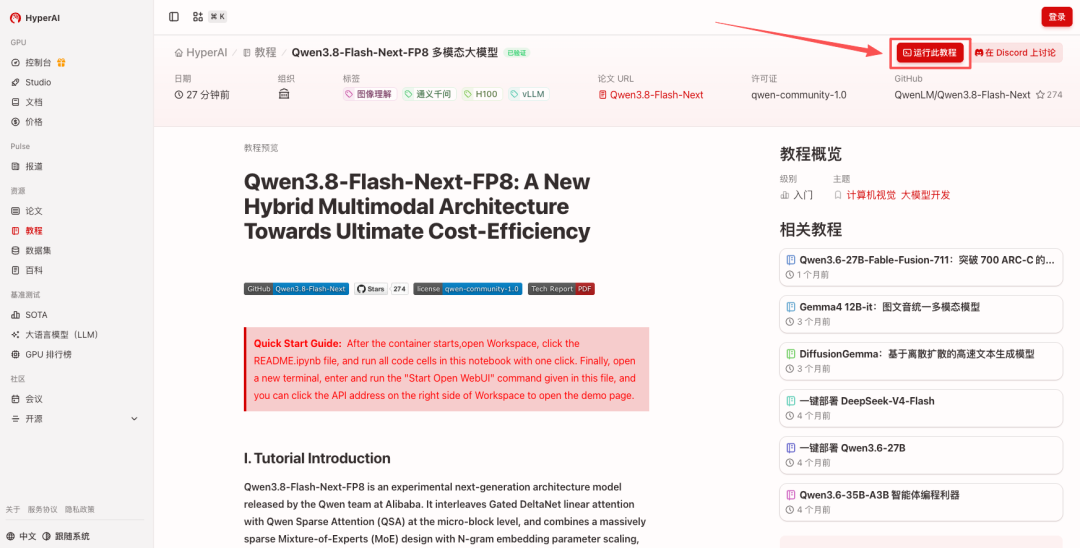
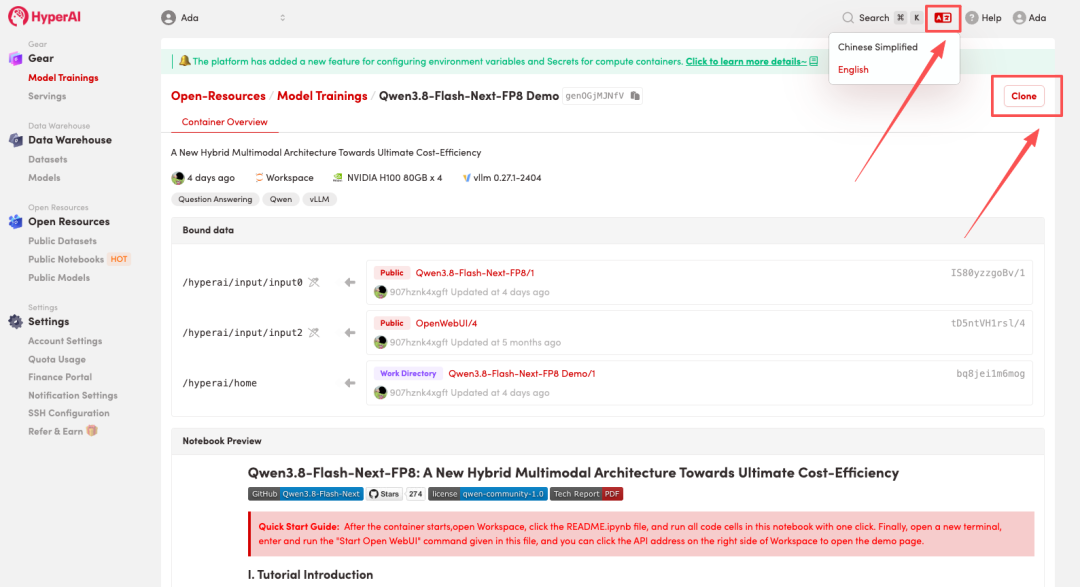
1.进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「Qwen3.8-Flash-Next-FP8 多模态大模型」,点击「运行此教程」。
2.页面跳转后,点击右上角「Clone」,将该教程克隆至自己的容器中。
注:页面右上角支持切换语言,目前提供中文及英文两种语言,本教程文章以英文为例进行步骤展示。
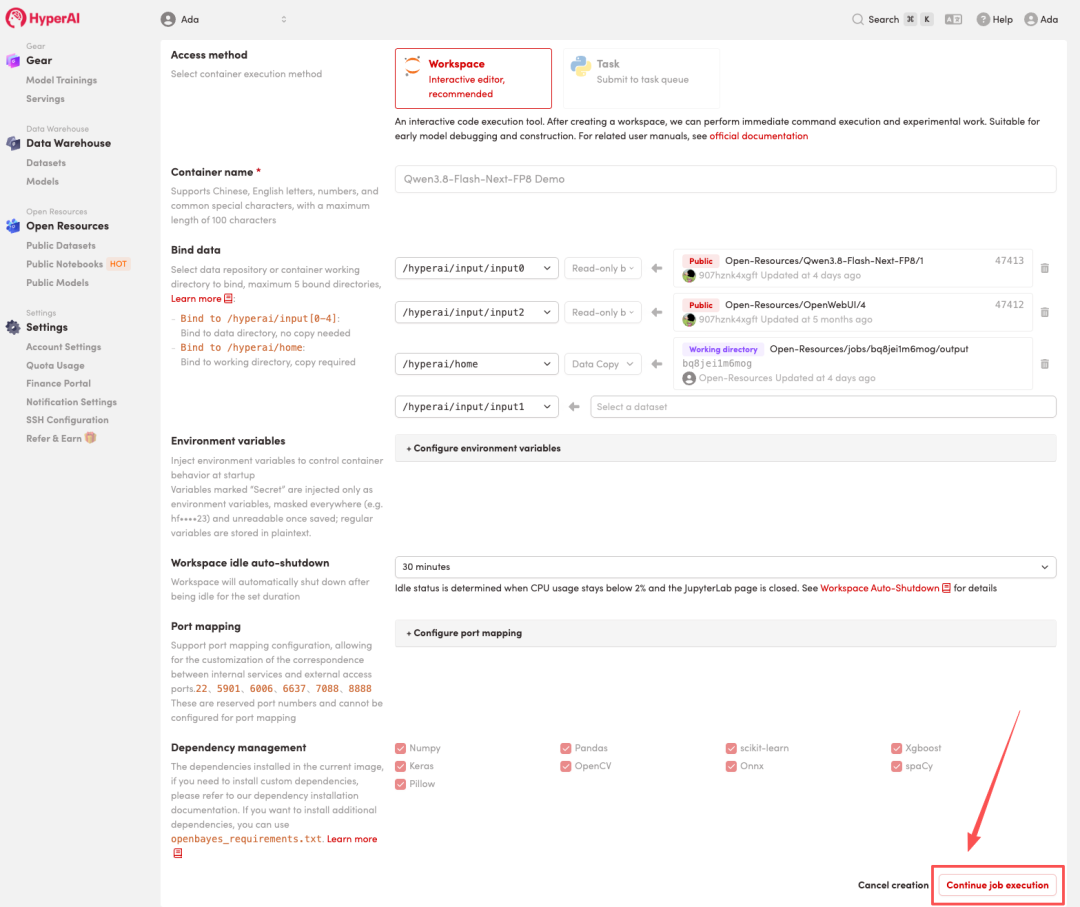
3.选择「NVIDIA H100 80GB x 4」以及「vllm」镜像,点击「Continue job execution(继续执行)」。
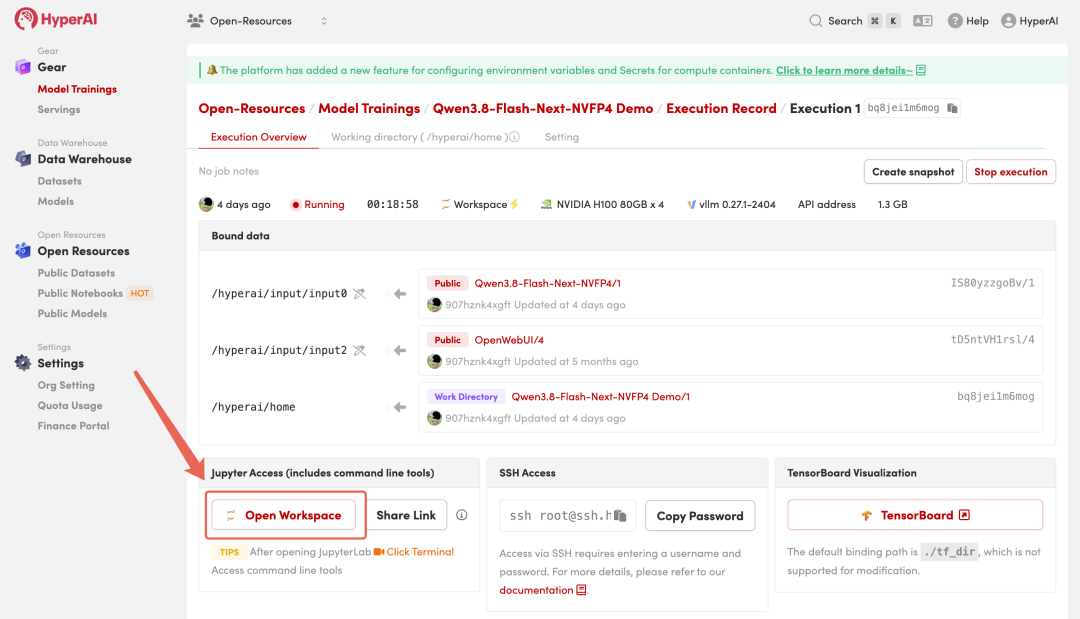
4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。
效果展示
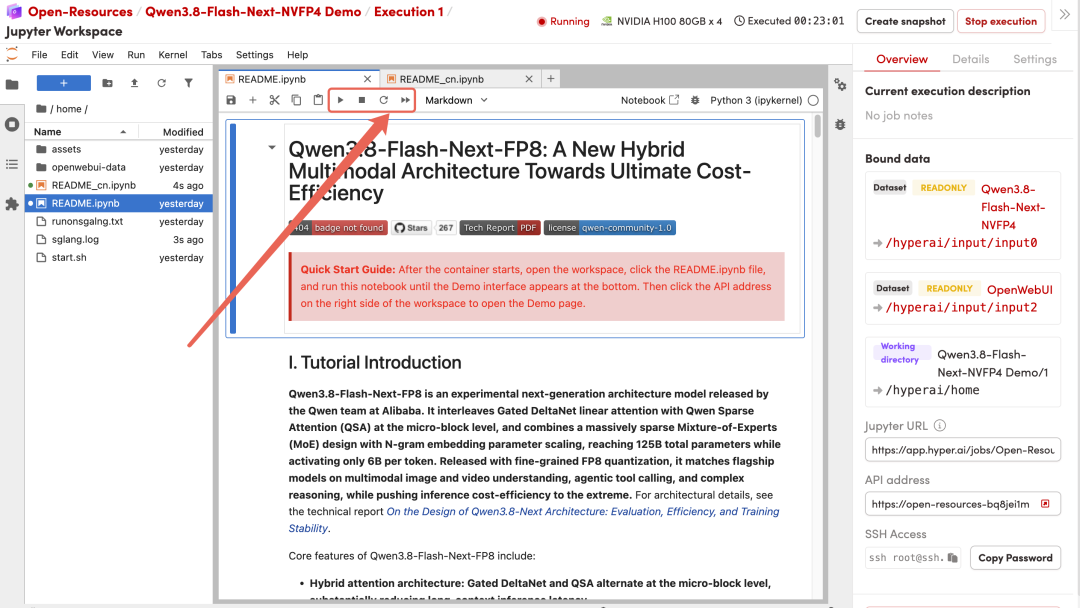
1.页面跳转后,点击左侧 README 文件,进入后点击上方 Run(运行)。
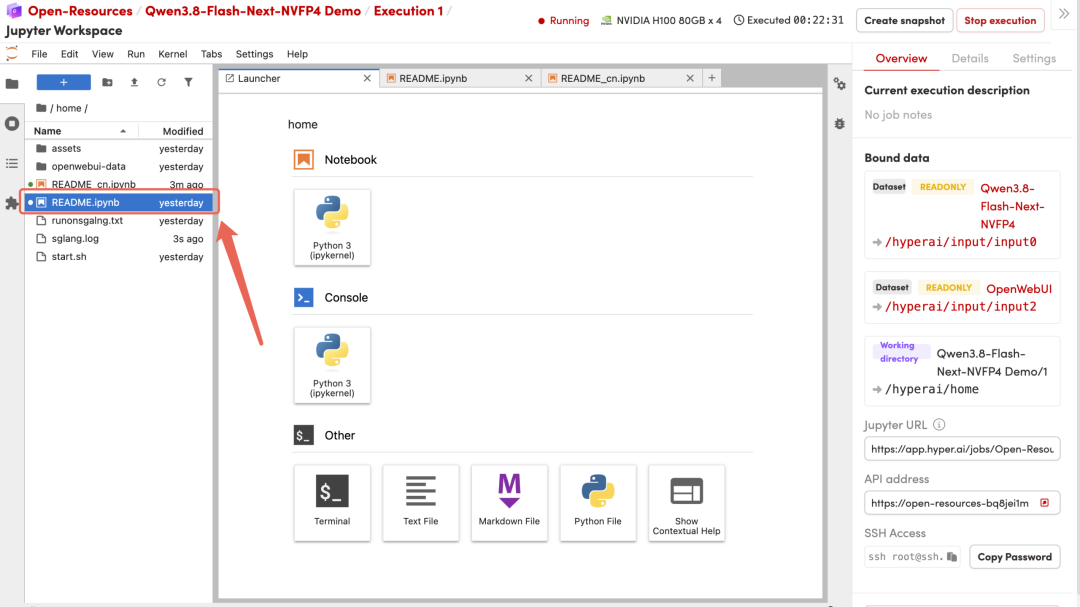
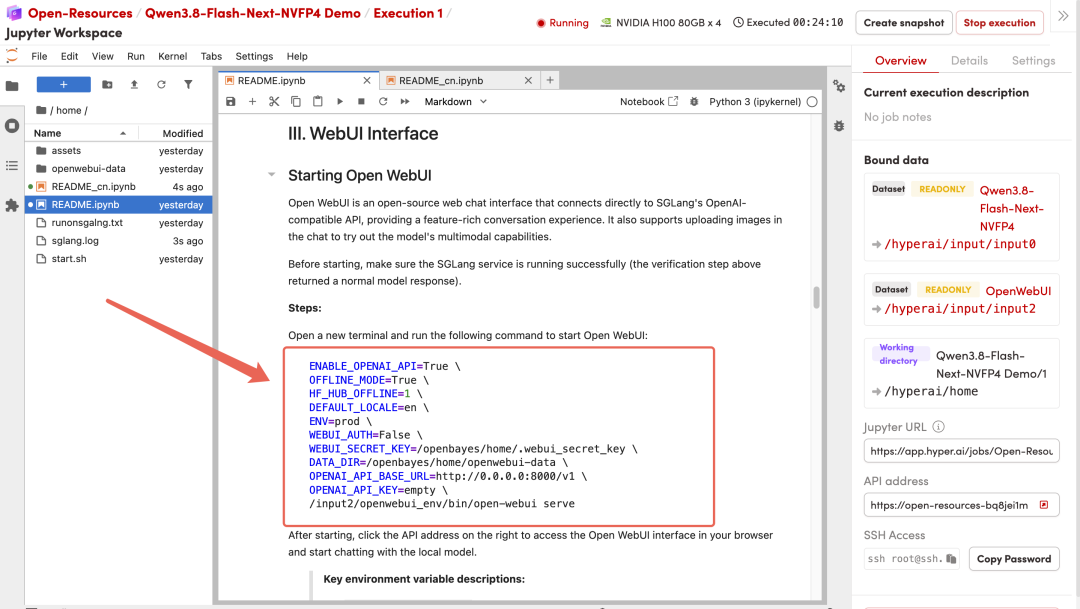
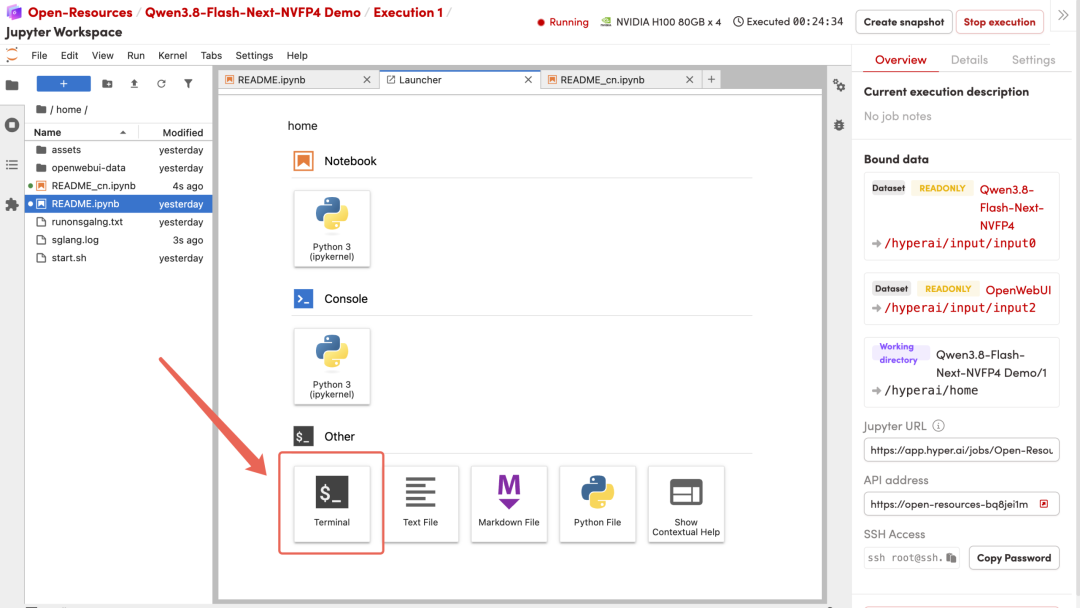
2.待运行完毕后,请打开新终端,执行以下命令启动 Open WebUI。
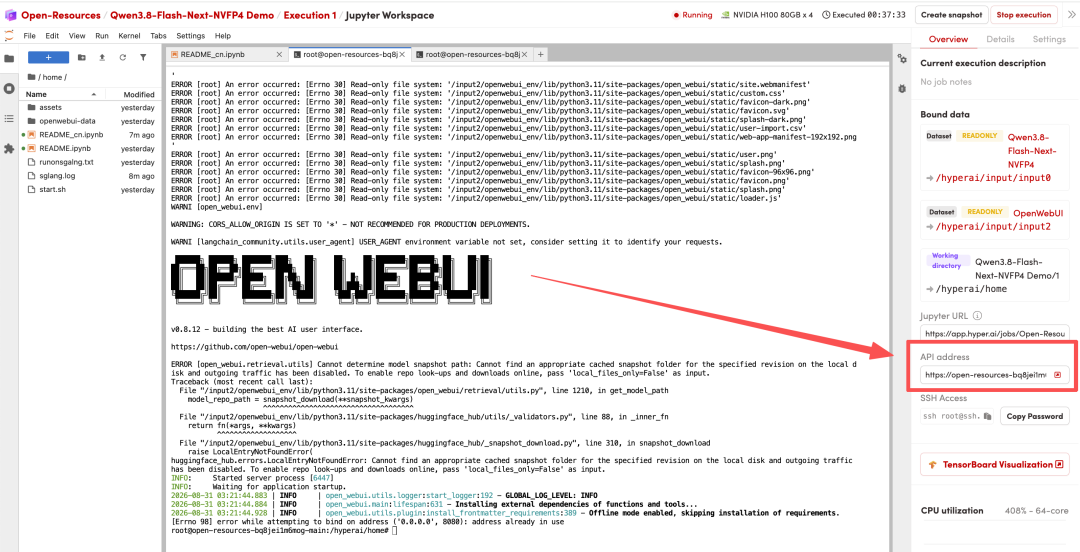
3.启动后,点击右侧 API 地址即可在浏览器中访问 Open WebUI 界面,开始与本地模型对话。
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢