

最近,一项“AI 直接优化酶催化活性”的工作发表于美国化学会旗舰期刊 Journal of the American Chemical Society。这项名为 CatESO 的方法,由深圳理工大学/上海纽约大学张增辉教授以及中国科学院杭州医学研究所陈广勇联合团队开发;第一作者甘镇嘉来自华东师范大学与 NYU-ECNU 计算化学联合研究中心。相比单纯预测一个酶“好不好”,CatESO 更进一步:让预测模型直接参与酶序列的搜索与优化,把催化性能本身变成设计目标。
AI 蛋白设计正在经历一次角色反转。从 trRosetta 的深度网络幻觉,到 BindCraft 对 AlphaFold2 的反向调用,一条思路已经被反复验证:结构预测模型压缩在参数中的几何与相互作用规律,可以通过梯度被“反向读取”,并直接参与序列搜索。但过去这类反向设计所优化的目标,几乎都停留在结构稳定性与分子结合层面。催化功能能不能也这样被调用?酶的周转数 kcat,能否从一个事后评价指标,变成直接驱动序列搜索的可微目标?
CatESO 正是围绕这一问题展开。它先训练一个底物感知的 kcat 预测器,再把预测器整体反转为可微设计引擎,把预测活性、序列合理性与折叠置信度写进同一个损失函数,让梯度沿同一条优化轨迹改写序列。
价值在梯度,不在打分
Kcat 的优化之所以困难,本质上受到两个尺度的共同限制:一方面,可用于监督学习的实验动力学数据十分有限;另一方面,蛋白序列空间却近乎无限。有限的数据与不可穷举的序列空间之间,构成了酶活性优化最基本的矛盾。围绕这一问题,AI 酶设计逐渐形成了两条相对独立的技术路线。一类以 CatPred、OmniESI 等为代表,重点提升 kcat 等动力学参数的预测能力;另一类以 RFdiffusion、LigandMPNN、ZymCTRL 等为代表,负责蛋白骨架或序列生成。
但目前主流流程仍然是:先生成候选结构或序列,再用预测模型评分和筛选。 换句话说,动力学预测器通常只出现在流程末端,充当“评估器”或“过滤器”,真正决定序列如何搜索的过程,并没有直接受到催化动力学目标的驱动。
CatESO 背后的判断是:对蛋白设计来说,一个高精度预测器的价值,并不仅仅是给候选序列打分,更重要的是它可微。面对巨大的蛋白序列空间,逐一生成、逐一打分显然不可行;但如果模型能够提供预测值关于输入序列的梯度,就可以进一步回答一个更直接的问题:当前序列应该朝哪个方向改变,才能让预测活性继续上升?于是,搜索不再需要在整个序列空间中盲目展开,而可以沿着预测模型定义的局部方向,逐步进入更高活性的区域。
不过,可微本身并不保证设计一定可靠。直接对预测器输出做梯度上升,与构造对抗样本面临相似风险:优化器可能不断放大模型的系统性偏差,最终得到一批在预测器看来分数很高、但在结构稳定性或生物物理合理性上并不成立的序列。因此,真正可用的可微蛋白设计,不是简单地“对预测分数做梯度上升”,而必须把目标放进一个受到结构、序列与生物物理约束的优化回路中。CatESO 试图建立的正是这样一种框架。
把 kcat 预测器改造成可微设计引擎
预测器这一侧,酶序列由冻结的 ESM-2(3B)编码,底物与反应物走残差 GCN 得到分子级嵌入,多头自注意力(MHSA)建模反应物集合内部的依赖。两个跨模态模块负责耦合两侧:MCDC 用底物描述子现场生成作用在残基特征上的卷积核;ICFE 让残基与分子特征做双向交叉注意力。在 CatPred-DB 的五个序列一致性阈值(100%、99%、80%、60%、40%)上,CatESO 全部领先。低同源区间的领先尤其关键,因为那正是可微设计器一旦离开局部突变邻域就必须进入的区域,梯度必须在那里仍然可信。
反转过程很直接:kcat 预测器、ESM-2 与 ESMFold 全部冻结,只更新可变位点上的氨基酸 logits。固定位点被钳在原始残基上,因此催化残基可以直接排除在优化之外。每一步用 Gumbel-Softmax 把 logits 松弛成可微的软序列,梯度再回到 logits。常规的生成–预测–筛选流程把这三项放在彼此分离的阶段,CatESO 把它们折进同一条优化轨迹。
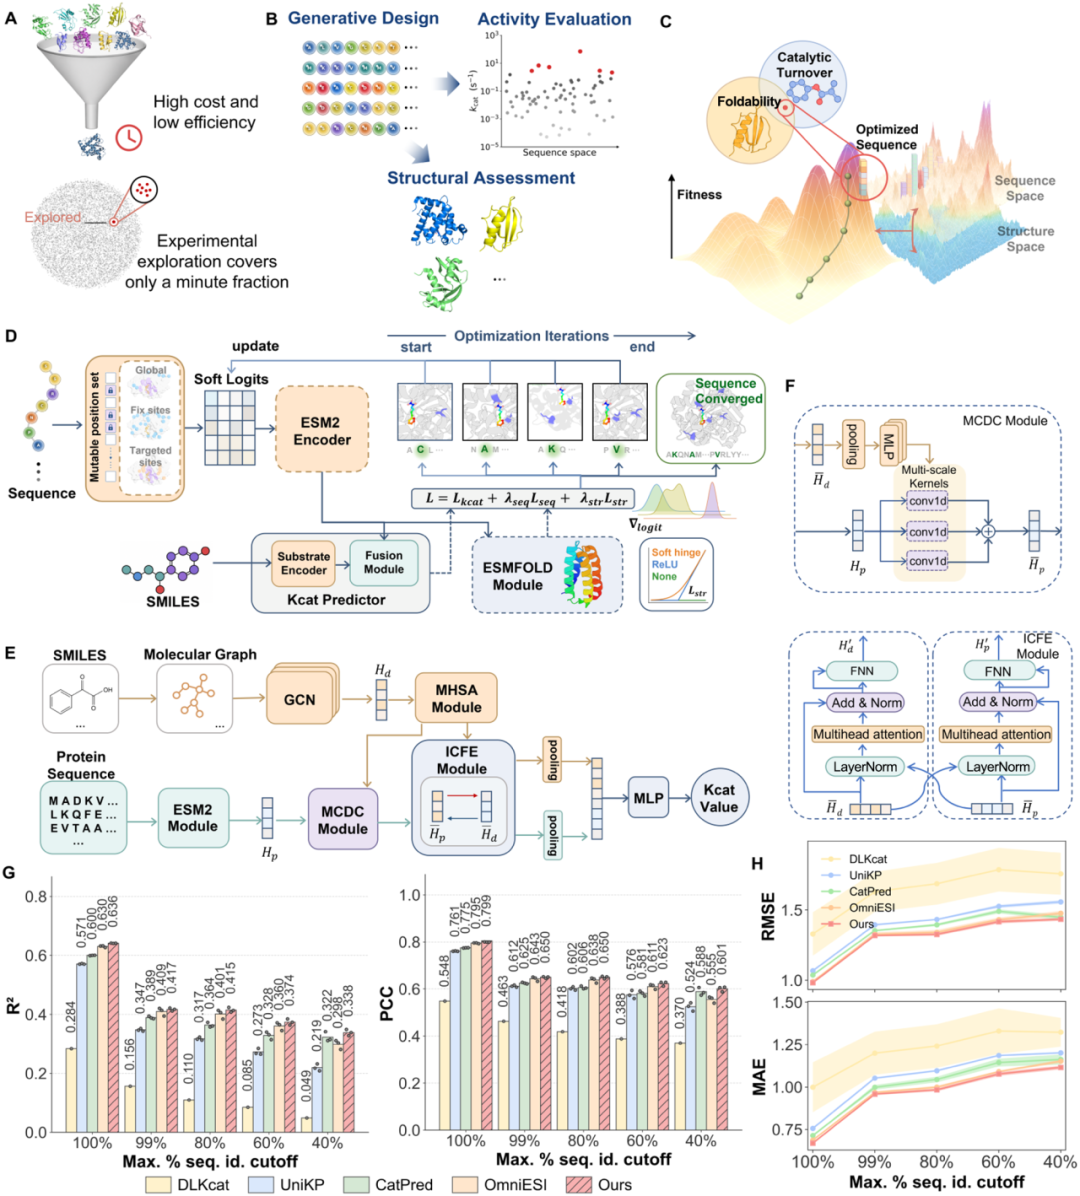
图 1|CatESO 将底物感知的 kcat 预测器反向用于酶序列优化,在催化活性、序列偏离与结构置信度的共同约束下,通过梯度直接搜索更优序列。
撤掉结构约束,梯度会钻预测器的空子
这个框架里最容易被认为只是“辅助项”的,其实是结构约束。作者用 Q9P9E3 做了一组直接对照:其余超参数全部固定,只改变结构正则的形式——ReLU 惩罚、soft hinge 惩罚,以及完全不加结构约束。三种设置都能把预测活性推到野生型之上,真正的区别出现在结构代价上。以 pLDDT = 70 为阈值,两种结构惩罚下分别有 82.0% 和 86.0% 的序列同时落在高活性、高置信区域;而完全没有结构惩罚时,这一比例只有 36.0%,其余 64.0% 都滑入了高预测活性、低结构置信的区域。
Rosetta 的折叠能量给出了相同趋势:无结构约束设计的折叠 ΔΔG 中位数达到 2.22 kcal/mol,而两种正则化策略下仅为 0.36 和 0.65 kcal/mol。使用 Protenix 与 OmniESI 两个留出模型重新评估,同样的分离依旧存在。进一步把突变位置映射回结构可以看到:加入正则后,突变集中在一小批高度重合的位点;没有结构约束时,突变分布明显更加分散,其中包括一些可能对维持折叠稳定性至关重要的位置。
这组对照揭示了可微设计中一个很关键的问题:一旦撤掉约束,梯度并不会停止优化,而是会越来越有效地利用预测器的漏洞。
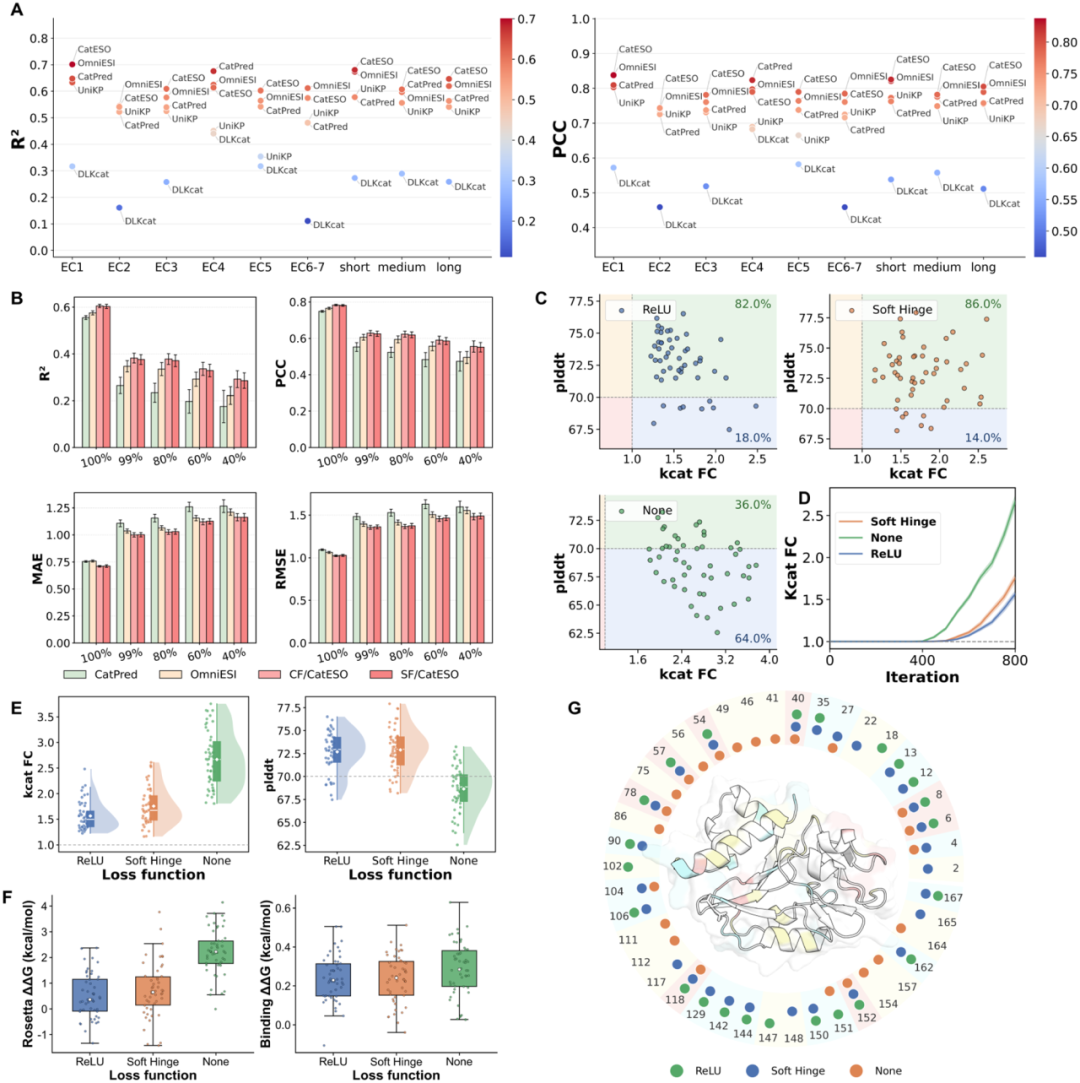
图 2|结构约束决定了可微优化能否保持在合理的蛋白序列空间中:加入结构正则后,CatESO 能在提升预测 kcat 的同时维持较高折叠置信度与较低结构能量代价。
七类分布外酶:活性提升,但结构代价不大
为了检验 CatESO 是否能够走出训练集附近的局部序列空间,作者经过多轮筛选与 MMseqs2 去同源,构建了野生型酶的严格分布外测试集,并从七个 EC 大类中分别选择一个聚类中心作为起始酶。这些蛋白与训练集的最大序列一致性均低于 34%,因此并不是简单的近邻优化。
经过优化和去冗余后,98.8% 的设计变体预测 kcat 高于对应野生型,中位提升倍数为 1.52,最高达到 3.54,七个代表性酶全部获得提升。与此同时,设计所付出的结构代价相对有限:每突变的 Rosetta 折叠 ΔΔG 中位数位于 0.18–0.97 kcal/mol,单个替换整体接近热中性;结合 ΔΔG 的中位数也普遍接近零。
更值得关注的是突变出现的位置。每个酶的突变位点少于 40 个,大约占蛋白长度的 5%–20%,并集中在少数反复出现的热点上,例如 P80077 的 F290、P82597 的 L96。这些热点大多没有直接落在与配体接触的催化核心,而更多出现在结合口袋邻近残基、底物通道附近的柔性 loop,以及更远端的折叠区域。不过作者对这部分结果的表述非常谨慎:这些热点应该被理解为模型提出的可验证假设,而不是突变能够改善催化的直接机制证据。
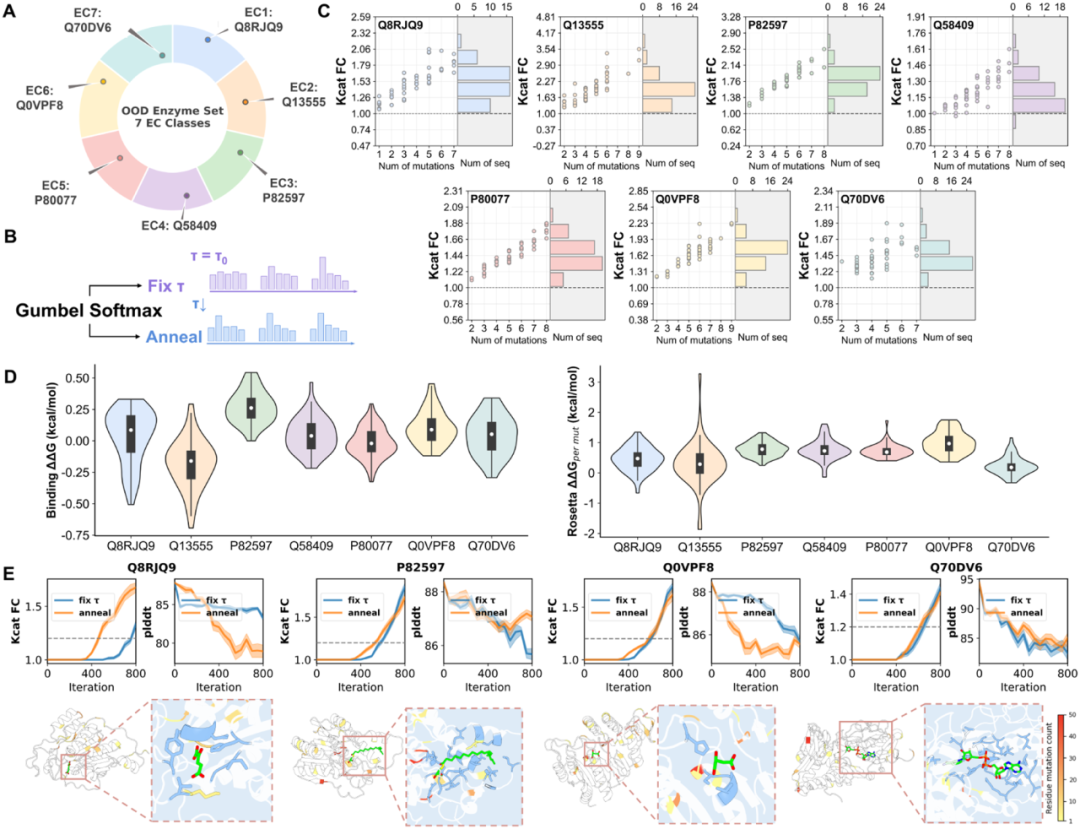
图 3|在七类分布外酶上,CatESO 以较少的序列改动实现预测 kcat 的普遍提升,并保持整体结构稳定。
与生成式方法正面对比:结构与活性兼顾
作者还把 CatESO 与两类典型生成式方法放到了同一套评估体系下:结构生成路线 RFdiffusion + LigandMPNN,以及蛋白语言模型路线 ZymCTRL。
统一使用 Protenix 评估后,CatESO 生成的所有变体 pLDDT 都高于 70,其中 70.3% 超过 90;两个基线中,pLDDT 超过 90 的比例分别只有 10.4% 和 37.2%,而低于 70 的比例分别达到 32.9% 和 26.9%。在七个代表性靶标中,有五个设计序列预测结构与对应野生型之间的主链 RMSD 低于 1.1 Å。
如果把活性与结构同时纳入评价,CatESO 用自身预测器打分时,联合成功率平均达到 99.7%,而两个基线分别为 38% 和 64.0%。作者又使用 OmniESI 对所有设计重新评估。重新打分后,各方法的绝对成功率都明显下降,但相对排序基本保留:CatESO 为 65.7%,RFdiffusion+LigandMPNN 为 19.4%,ZymCTRL 为 55.4%。
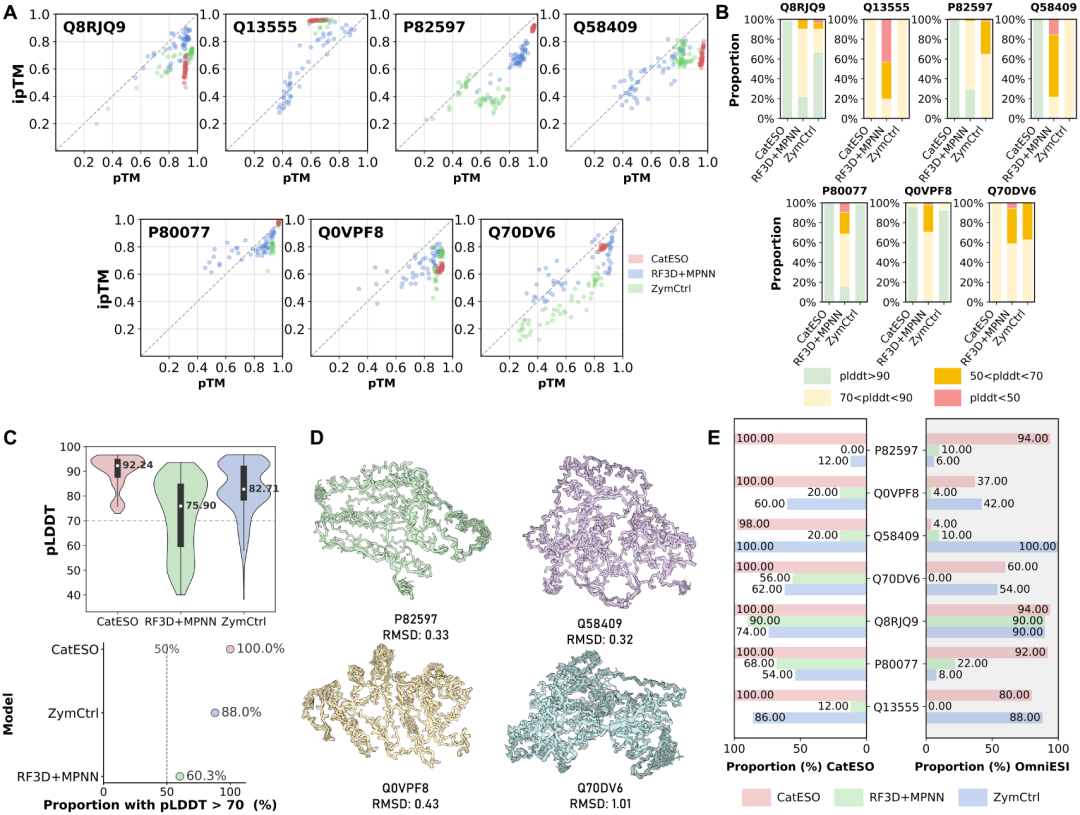
图 4|与现有结构和序列生成方法相比,CatESO 的设计在结构置信度与预测活性两方面表现出更好的综合结果。
梯度可以指路,但不能没有边界
如果把几类方法放在一起看,会发现它们其实是从不同方向进行酶设计的。RFdiffusion+LigandMPNN 更偏结构生成,ZymCTRL 更依赖蛋白序列本身的规律,而 CatESO 的切入点是功能:它直接把催化动力学目标接进序列优化。前两类方法的设计能力更多是在训练阶段学出来的,CatESO 则把更多的设计要求放到了推理阶段,更换底物、改变固定位点或调整结构惩罚,都不需要重新训练底层模型。
但这篇工作的边界也很清楚:目前所有活性提升都还是预测结果,没有经过湿实验验证。作者没有回避这一点。尤其是在 Q58409 上,两个预测器给出相反结论的情况,最终仍然需要依靠定点突变、蛋白表达以及稳态动力学实验。
因此,这项工作最值得关注的是把一个新的设计问题摆到了台前:一个功能预测模型,能不能不再只负责最后打分,而是直接参与序列怎么改、往哪里改?CatESO 的答案是可以,但前提也很明确:梯度可以帮你找到方向,是一把很好用的工具,前提是有人替它设边界。
研究单位:华东师范大学;上海纽约大学(NYU-ECNU 计算化学联合研究中心);纽约大学;香港中文大学;浙江大学;复旦大学;上海交通大学;中国科学院杭州医学研究所;深圳理工大学
通讯作者:Guangyong Chen(陈广勇), John Z.H. Zhang(张增辉)
第一作者:甘镇嘉
项目代码:
https://github.com/zhenjiagan/CatESO
参考资料
Zhenjia Gan, Yuzhi Xu, Junde Xu, Zhihao Wu, Juping Huang, Jiabin Yin, Guangyong Chen, John Z. H. Zhang. CatESO: Differentiable Enzyme Sequence Optimization Guided by Substrate-Aware kcat Prediction. Journal of the American Chemical Society, 2026.
https://doi.org/10.1021/jacs.6c14365
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢