

Xiaomi-TabLDM是一款基于上下文学习的表格数据基础大模型,用于分类和回归,无需针对特定任务进行微调即可实现卓越的预测精度。该模型完全基于结构因果模型 (SCM) 生成的合成数据进行预训练,从而能够更灵活地利用上下文信息并更高效地扩展容量。
i) 新的性能标杆。在基准测试中展现出强大的回归性能:Xiaomi-TabLDM 在 OpenML-CTR23 测试中排名第一,在 TALENT、TabArena 和 BCCO 测试中均排名第二,在四个互补的基准测试套件中均表现出始终如一的强大回归性能。优异的性能-效率平衡:Xiaomi-TabLDM 兼具强大的预测性能和显著降低的计算成本。例如,在 TabArena 回归测试中,它取得了第二高的 Elo 评分,同时训练时间比排名第一的 TabFM 减少了 82%,预测时间减少了 68%。
ii) 大规模合成预训练。 Xiaomi-TabLDM 扩展了用于预训练的合成表格数据的覆盖范围和多样性。我们还采用了三阶段训练策略,结合双流特征分组、轻量级注意力残差和稀疏混合专家模型,使 Xiaomi-TabLDM 能够学习更丰富的特征交互和跨不同表格任务的专家专长。
iii) 测试时扩展。Xiaomi-TabLDM 通过测试时计算扩展进一步扩展了表格预测能力,在推理时分配额外的计算资源可以持续提升模型的预测性能,优于基础模型。
论文:Xiaomi-TabLDM: A Tabular Foundation Model Technical Report
单位:小米
GitHub: https://github.com/xiaomi-research/xiaomi-tabldm
Hugging Face: https://huggingface.co/occams/Xiaomi-TabLDM
请索引第125篇论文
 |  |
当 SCM 遇上 MoE:小米 Xiaomi-TabLDM 与表格基础模型的"第三条路"
如果说过去三年的人工智能有什么"灯下黑",表格一定算一个。
外面是万亿参数、长上下文、Agent、世界模型,热闹得像跨年晚会。而真实世界的绝大多数高价值数据,仍然老老实实地躺在电子病历、工艺参数表、授信记录、材料基因组数据库和问卷里,一行一个样本,一列一个变量。
这些东西有个朴素的名字:结构化数据。
2026 年 9 月,小米放出了 Xiaomi-TabLDM 的技术报告。它不谈通用智能,只做一件极其克制的事:给你一张从没见过的表,不做任何微调,直接把测试集的标签吐出来。
读完这份 34 页的报告,我最想说的是——这可能是今年最值得 AI+交叉学科研究者精读的一份技术报告。不是因为它榜单一路飘红,而是因为它把三件事讲得异常清楚:先验从哪里来、容量怎么加、推理时还能不能再榨一点性能。而这三件事,每一件都能原封不动地搬到别的学科去。
01 先把结论摆在桌上:四张榜单,一个信号
作者自己给的总结很诚实:Xiaomi-TabLDM 在 OpenML-CTR23 上排名第一,在 TALENT、TabArena、BCCO 三个套件的回归任务上排名第二。
注意这个限定词——回归。这不是保守,这是这篇论文最值得玩味的地方。
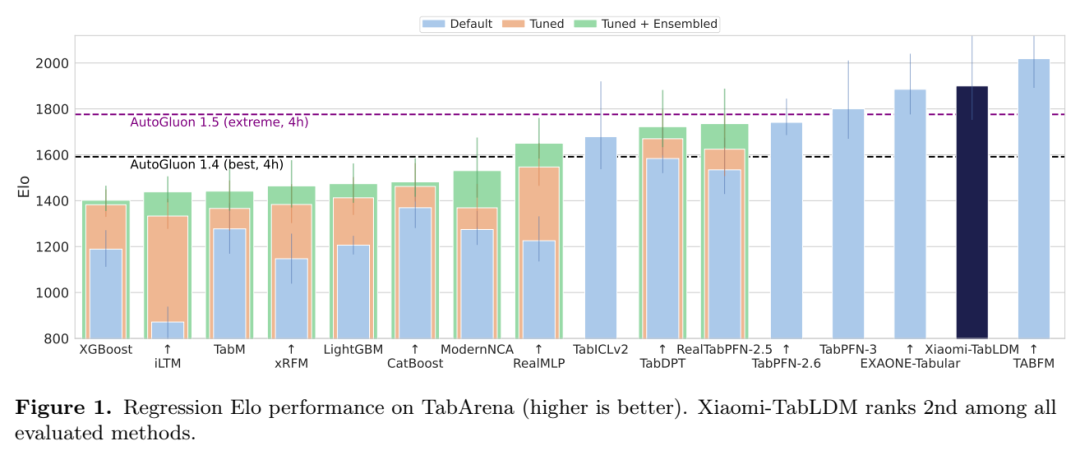
图 1|TabArena 回归任务 Elo 排名(越高越好)。Xiaomi-TabLDM 在所有被评估方法中位列第 2,仅次于 TabFM。横轴上方三组标记分别代表默认配置、调参后、调参+集成。
先看 OpenML-CTR23。这是一个纯粹为表格回归设计的基准套件,33 个数据集。
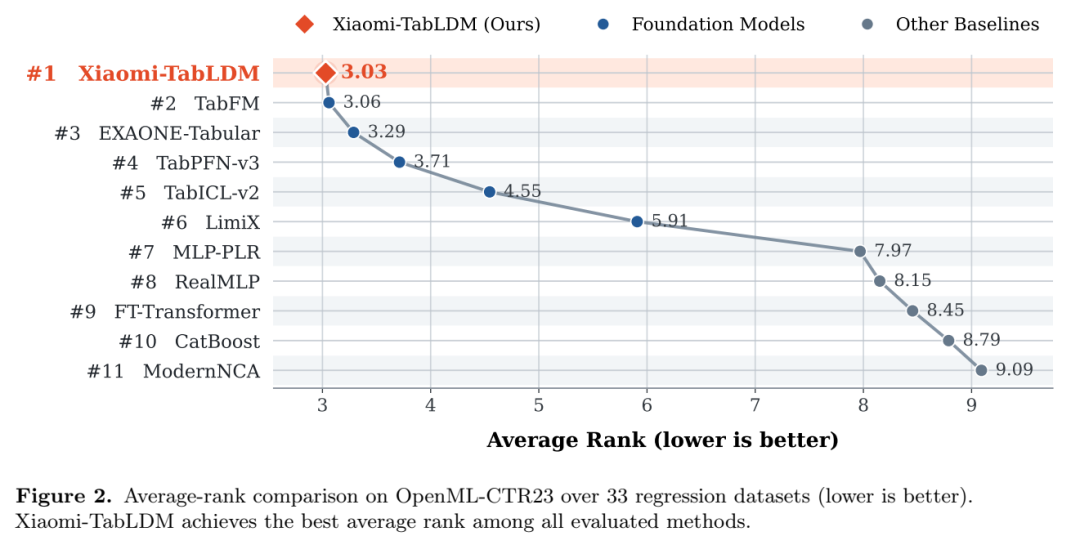
图 2|OpenML-CTR23(33 个回归数据集)平均排名,越低越好。Xiaomi-TabLDM 以 3.03 的平均排名位列第一。
这里必须说一句实话:它赢得很险。TabFM 是 3.06,Xiaomi-TabLDM 是 3.03,差距 0.03。任何负责任的解读者都不该把 0.03 吹成"碾压"——但它后面的梯队拉得很开:TabPFN-v3 是 3.71,TabICL-v2 是 4.55,LimiX 是 5.91。也就是说,第一梯队只有两个人,其余都是第二梯队。
再把镜头切到 TALENT。这个套件有 300 个数据集,是四个套件里最大的一个。
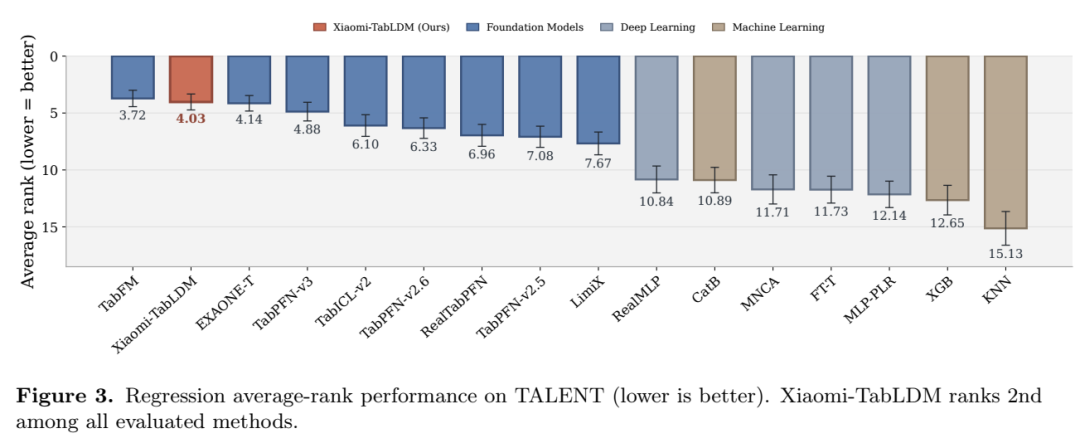
图 3|TALENT 回归任务平均排名(越低越好)。Xiaomi-TabLDM 4.03,排在第 2,TabFM 3.72 居首。
4.03 对 3.72,还是第二。而在它身后,EXAONE-Tabular 4.14、TabPFN-v3 4.88、TabICL-v2 6.10、TabPFN-2.6 6.33——差距就不是零点几了。
所以第一个信号已经很清晰:这个模型在回归上有一致性的、跨套件的优势,但它并不是"全能冠军"。 承认这一点,后面所有的讨论才有意义。
为了让后面的数字有坐标,先把四个套件的基本盘摆出来。
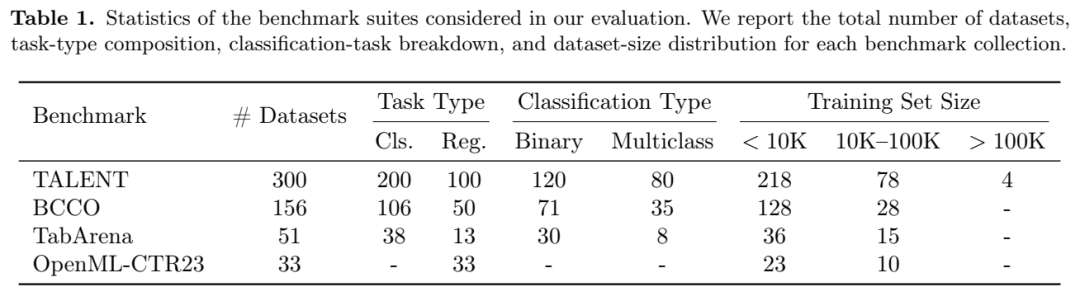
表 1|四个基准套件的统计。TALENT 300 个数据集(200 分类 / 100 回归),BCCO 156 个(106 / 50),TabArena 51 个(38 / 13)共 816 个任务,OpenML-CTR23 33 个全回归。绝大多数数据集训练样本在 1 万以内。
这张表有个容易被忽略的细节:BCCO 有近三分之一的数据集含缺失值。对需要跨数据条件泛化的模型来说,这是个相当刻薄的设置。
02 从"一数据集一模型"到"一模型打天下"
要理解 Xiaomi-TabLDM 的位置,得先看清它站在谁的肩膀上。
表格预测的旧世界属于 XGBoost、LightGBM、CatBoost 和 AutoGluon。Boosted tree 在这块地盘上称王称霸了十几年,大量的实证研究都表明深度网络在表格问题上并不占优。
深度学习这边也不是没努力过。TabNet、AutoInt、TabTransformer、SAINT 走注意力路线;NODE、DANets、DCN-v2、T2G-Former 做神经决策与特征交互;TANGOS、TabCaps、Trompt、ExcelFormer、TabR、DNNR、SwitchTab 各出奇招。但这些方法有一个共同点:每个数据集都要单独训练和调参。
TabPFN 换了个思路:在海量合成表格任务上预训练一个 transformer,推理时把目标数据集的带标签样本当作上下文喂进去,一次前向传播直接出预测。这就是表格的 in-context learning(ICL)。
这条路后来被 TabPFN v2、TabPFN-2.5、TabICL、TabDPT、LimiX、TabFM、EXAONE-Tabular 一路拓宽。范式也随之迁移:从"为每个数据集训一个专用模型",变成"造一个可复用的预训练预测器"。
Xiaomi-TabLDM 沿着这个方向继续走,但走了三步自己的棋:更宽的合成先验、更省的容量扩展、推理时再投入计算。
03 拆开机器看:列、行、上下文,三层各解决一件事
整篇报告的核心图是图 4。它不是那种"看懂了但不知道为什么"的架构图,而是层次分明地交代了三次表示变换。
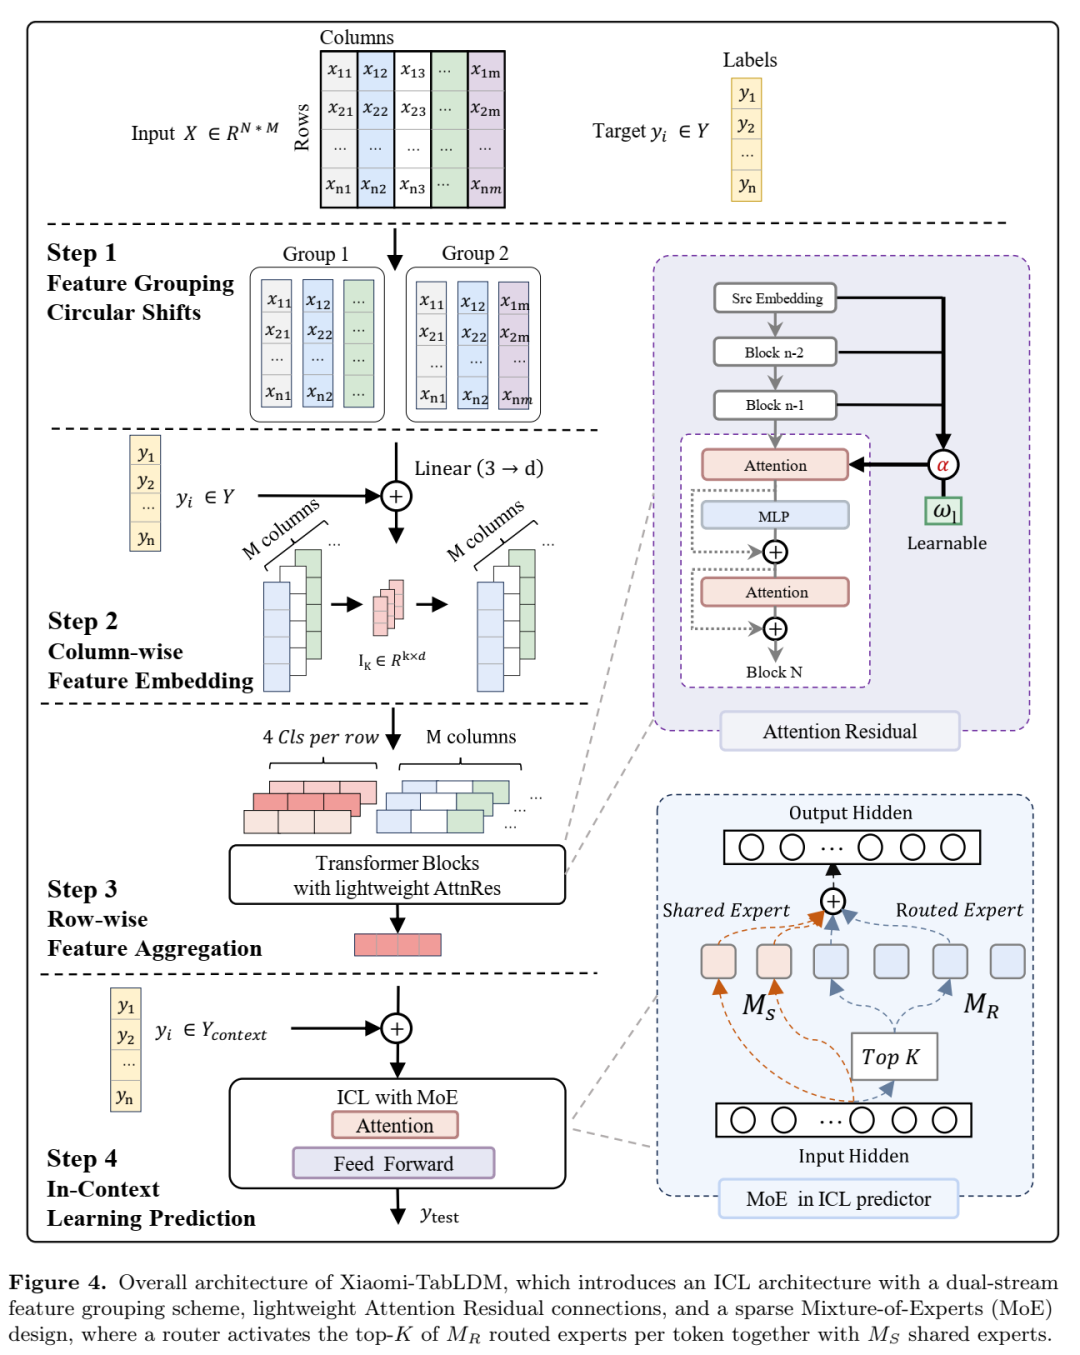
图 4|Xiaomi-TabLDM 总体架构。四步流水线:Step 1 特征分组(循环移位)→ Step 2 列级特征嵌入(Set Transformer + inducing points)→ Step 3 行级特征聚合(带 lightweight AttnRes 的 Transformer blocks,4 个 CLS token)→ Step 4 带 MoE 的 ICL 预测器。右下角放大了 AttnRes 与 MoE 的内部结构。
第一层:列。 表格的列本质上是一个无序集合,可 transformer 天然想给输入排个序。Xiaomi-TabLDM 的解法是"双流特征分组":把第 j 列和另外两列捆成一个三元组,用一个共享的 Linear(3→128) 编码。
第一条流沿用 TabICLv2 的二进偏移 (1, 2, 4),看近邻;第二条流用宽度自适应偏移 (1, ⌊√s⌋, s),其中 s = min(32, m−1),看得远但不越过表格边界。窄表时偏移可能撞车(模 m 后指向同一列),此时挪动一个偏移保证三列互不相同,两条流保持互补。最后两条流的嵌入相加。
这设计有点像学术合作:一个合作者找同办公室的,另一个专找跨国的。两条流叠加,局部交互和长程交互一起进来了。
每条列再由一个 Set Transformer 编码,用 128 个 inducing points 做诱导点注意力,而不是让所有行两两互相关注。这一步把长度 n 的变长列压成定长向量,同时避开了 O(n²) 的陷阱。
第二层:行。 每行的各列嵌入前面拼上 4 个可学习的 CLS token,过 3 层自注意力(8 头,RoPE 基频 100000),最后 CLS token 查询全序列,拼接状态形成该行的定长向量。
这里真正的创新是 lightweight AttnRes。标准残差连接只把上一层的输出递给当前层,等于用固定的、均匀的权重聚合所有早期输出。AttnRes 把这个固定求和换成学出来的、依赖输入的权重。
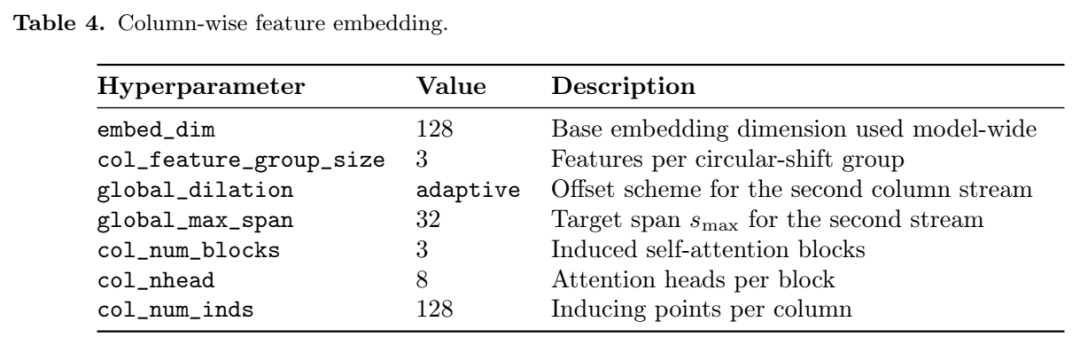
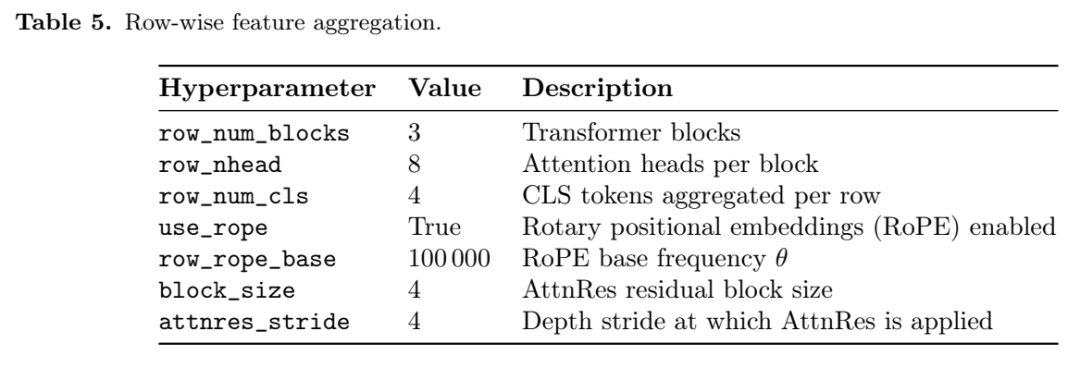
表 4 & 表 5|列级嵌入与行级聚合的超参数。注意 block_size=4、attnres_stride=4:AttnRes 只在深度上按固定步幅施加,层只关注已完成的 block 表示,而不是每一个前序层。
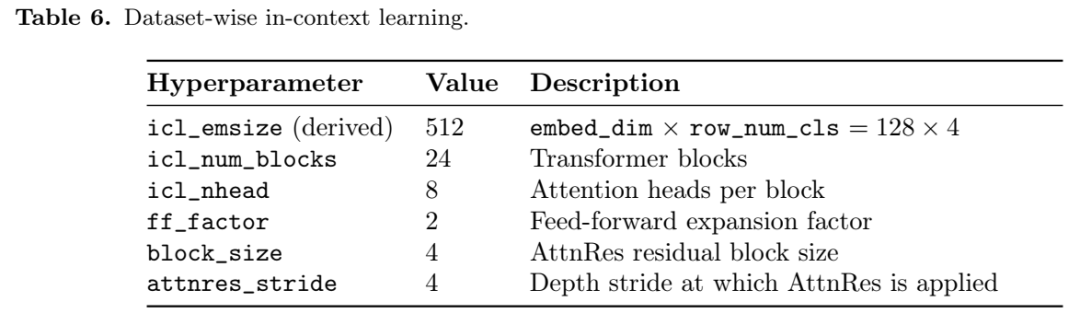
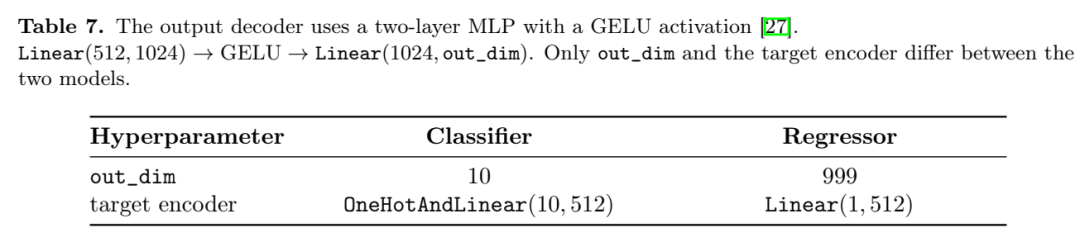
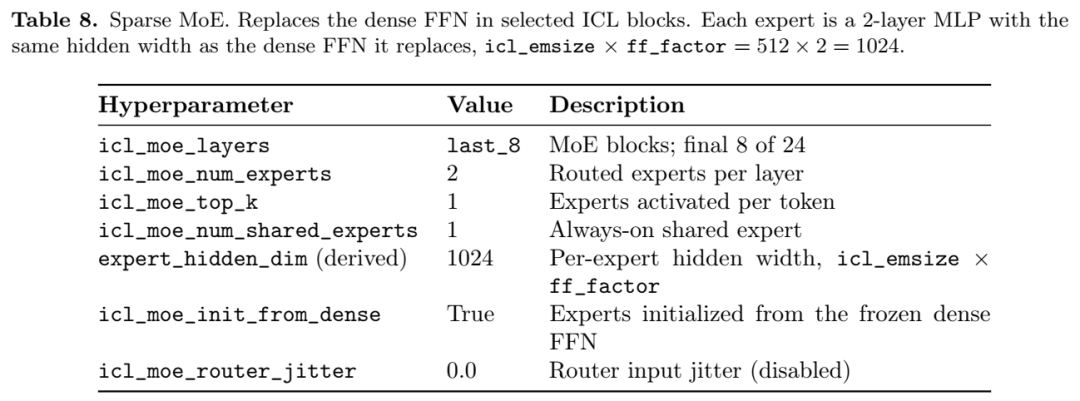
表 6、7、8|ICL 阶段、输出解码器与稀疏 MoE 的配置。ICL 共 24 层,MoE 放在最后 8 层;每个专家是 hidden=1024 的两层 MLP;分类器输出 10 维、回归器输出 999 维(对应 999 个分位数)。
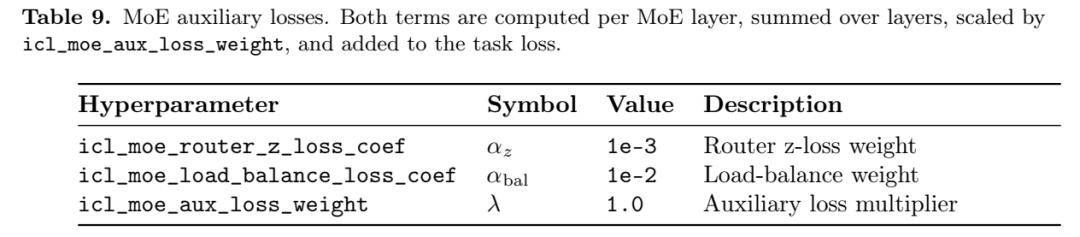
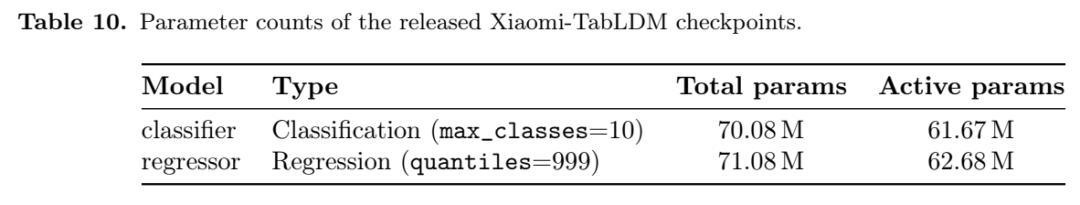
表 9 & 表 10|MoE 辅助损失与参数量。分类器总参数 70.08M、激活 61.67M;回归器 71.08M / 62.68M。
报告里有一句话我认为是全篇最重要的工程注脚之一:Stage 1 如果不开 AttnRes,模型在较大数据集(大约超过 1200 个样本)上会在更早的步数崩溃。 一个"连接方式"的改动,直接决定了课程学习能不能往下走。做深度网络的同学对这种"不崩就是胜利"的经验应该不陌生。
第三层:上下文。 24 层 ICL transformer 里,训练行之间互相注意以建模集合内结构,测试行只注意训练行以形成预测。最后 8 层的 FFN 被替换为稀疏 MoE:2 个路由专家、top-1 激活、外加 1 个共享专家。
共享专家的设计借的是 DeepSeekMoE 的思路:所有 token 都要用的公共变换交给共享专家去学,路由专家就不必每个人重学一遍加减法,可以专心做特化。
参数量因此与路由专家数成正比,而每个 token 的计算量只与激活的 K 个专家有关——这就是"容量与算力解耦"的具体含义。70.08M 总参数里只有 61.67M 被激活,就是这个道理。
路由用 Switch 式负载均衡损失(α=1e-2)加 router z-loss(α=1e-3)正则,专家由冻结的 dense FFN 初始化。先训 dense,再裂变成专家——这是个非常实用、也非常省事的做法。
04 数据从哪来:不是爬来的,是"造"出来的
这是我最想让交叉学科的读者细看的一节。
Xiaomi-TabLDM 完全在合成数据上预训练,合成数据的发动机是结构因果模型(SCM)先验。
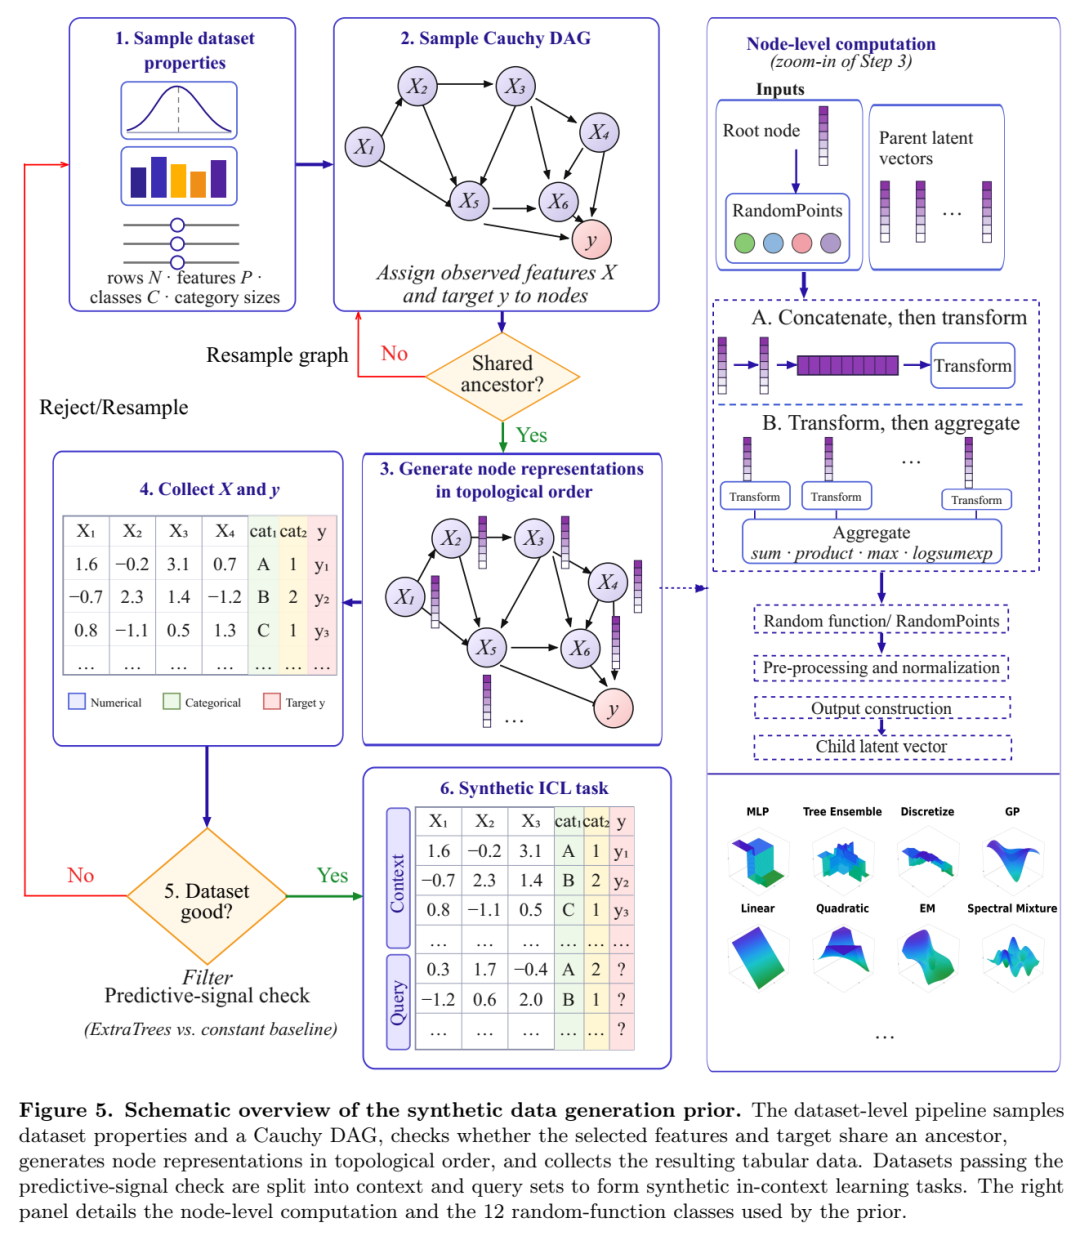
图 5|合成数据生成先验的完整流水线。六步:① 采样数据集属性;② 采样 Cauchy DAG 并把观测特征 X 与目标 y 分配到节点上,若二者无共享祖先则重采图;③ 按拓扑序生成节点表示;④ 收集 X 与 y(只观测部分维度,其余维度构成潜在变异);⑤ 用 ExtraTrees 对常数预测器做预测信号检查,不过关就拒绝/重采;⑥ 拆成 context 与 query 形成 ICL 任务。右侧放大了节点级计算与 12 类随机函数。
先把流程走一遍。
图结构用的是 TabICL-v2 的随机 Cauchy 图机制,节点表示按拓扑序在图中传播,并注入高斯噪声增加多样性。作者还额外增加了变换函数,以拓宽先验在平滑性、稀疏性、可加性和局部结构上的覆盖。
数据构建时,观测特征和目标被分配到采样出的图节点上:数值特征和回归目标来自连续潜变量维度,类别特征和分类目标通过离散化或类别采样产生。只有部分维度被观测到,其余维度提供潜在变异。再随机缩放,让不同任务中特征和节点的重要性各不相同。
后处理与质检这一步很讲究:标准化、随机置换列,然后剔除无效或无信息的任务。具体地,如果特征和目标在图上没有共同祖先,这张图直接重采;如果一个 ExtraTrees 模型不能稳定地打败常数预测器,这个任务直接丢掉。
换句话说:他们没有去抓数据,他们造了一整个世界,并且给这个世界装了一道质检。
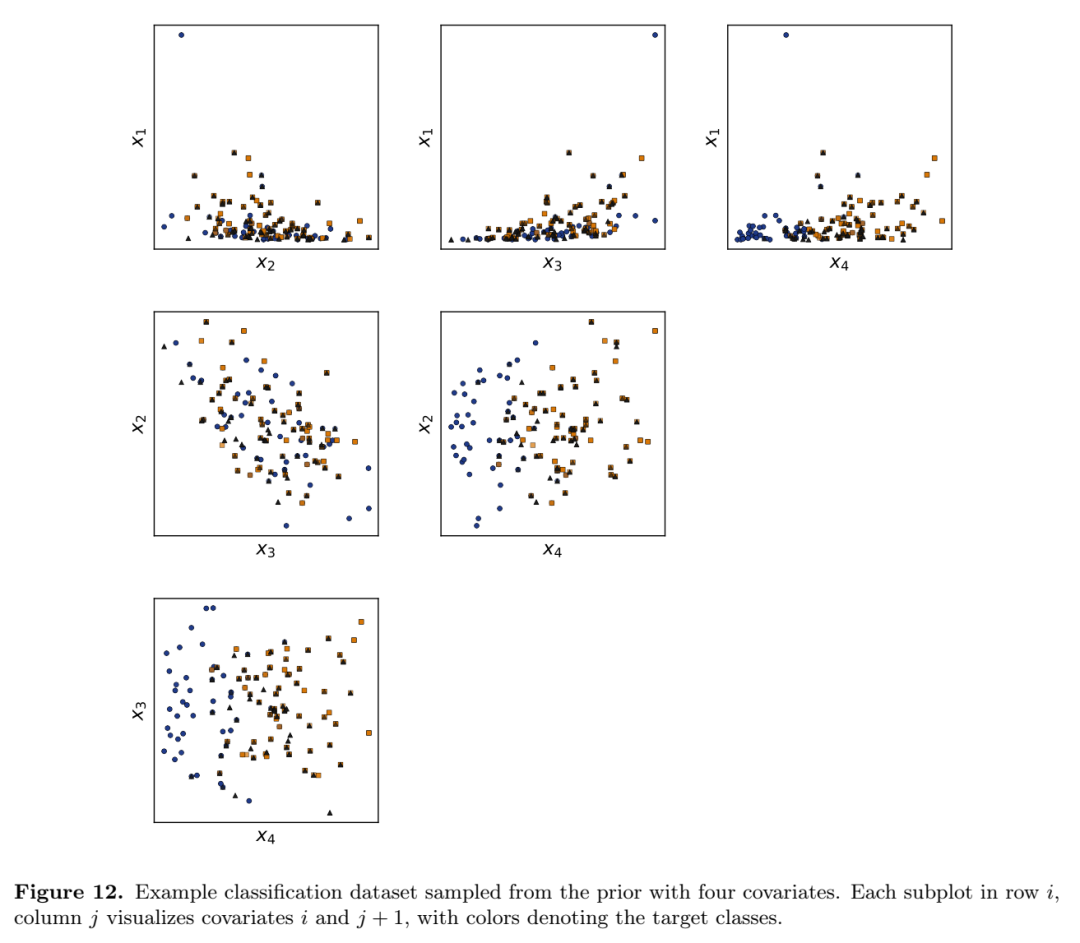
图 12|从先验中采样的一个四协变量分类数据集示例。第 i 行第 j 列的子图展示协变量 i 与 j+1 的散点,颜色为类别标签。
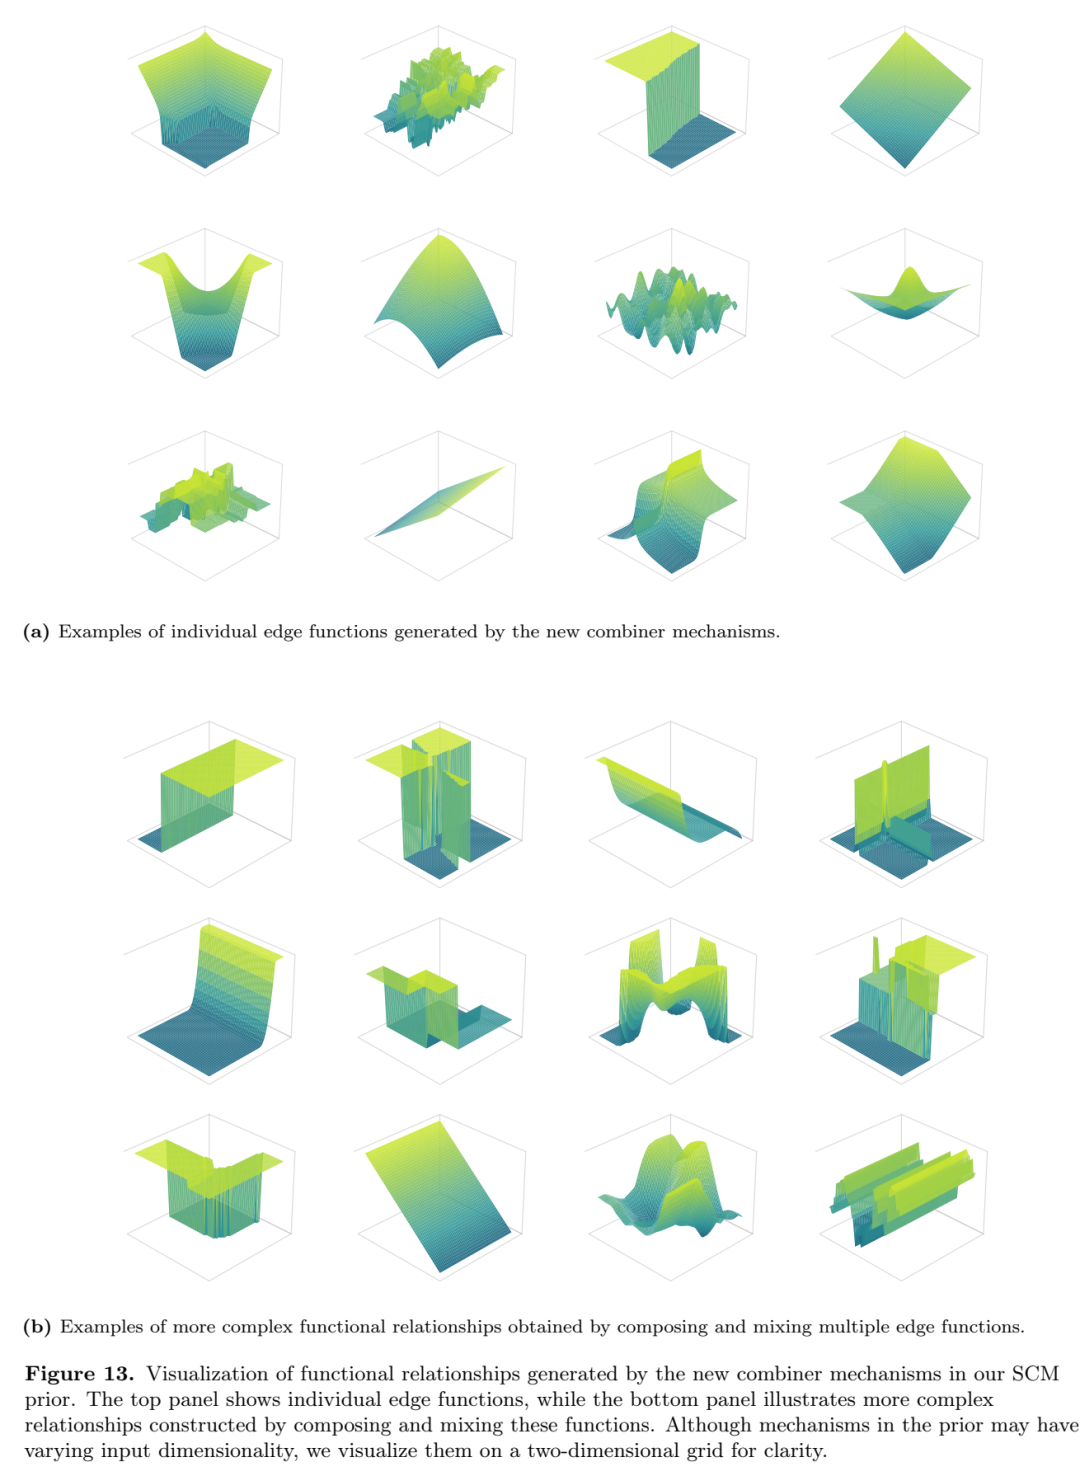
图 13|SCM 先验中新组合机制生成的函数关系可视化。(a) 单条边函数:平滑非线性映射、局部响应、分段跃迁、高度不规则曲面,形态跨度极大;(b) 组合与混合多条边函数后得到的更复杂关系。
图 13 是这一节的题眼。上半部分的单条边函数已经足够多样,下半部分说明组合与混合进一步爆炸式地扩张了函数关系空间。这正是不依赖少数几种预定函数形式、而选择"可组合的随机函数池"的价值所在。
先验到底能造出什么样的图景?图 12 给了一个四协变量的例子——注意那些子图,决策边界的形状一点都不"教科书"。
05 三阶段课程:从 1024 行走到 60000 行
分类器和回归器分开预训练,课程分三段,数据集规模逐级放大。
Stage 1:分类 500K 步、回归 300K 步,数据集固定 1024 个样本,其中 30–90% 作为训练集,峰值学习率 8e-4,梯度裁剪 10。此阶段使用默认 dense FFN,但已启用 AttnRes。
Stage 2:40K 步,数据集规模 400–10240(对数均匀采样),约 80% 作训练,学习率 1e-4,裁剪 10。MoE 及其辅助损失从这一阶段开始启用。
Stage 3:10K 步,数据集 400–60000(对数均匀),学习率 2e-5,裁剪 1。这一阶段的目的很明确:让模型适应长上下文、大样本推理。
优化器是 Muon(基于 TabICLv2 的实现),配 cosine 学习率调度与 0.01 的权重衰减。8 张 A100-80GB:Stage 1 约 7–10 天,Stage 2、Stage 3 各约 2 天,从 Stage 2 起启用 FlashAttention-2。
还有一个细节值得单独拎出来:回归器用的是 999 个分位数上的 pinball loss。
这意味着它学的不是一条回归线,而是整条条件分布。我倾向于认为,这是它在四个套件的回归任务上全面开花的技术原因之一——当你把回归建模成分位数回归,你对重尾、异方差、偏态的鲁棒性天然就比只拟合均值的模型强。
(顺带一提,模型预训练时最多支持 10 个类别。超过 10 类怎么办?用 TabICLv2 的 mixed-radix 集成:把标签重写成 D 个混合基数数字,每个基数不超过 10,逐位跑一次列级 transformer 再平均输出。优雅的"拼装式"扩展,不需要重训。)
06 推理时再榨一把:不动一个参数的 Test-time Scaling
模型训完了,还能不能更好?能——加推理时的计算。
Xiaomi-TabLDM 的做法是四步。
一是特征洗牌与子采样。 每个集成成员用随机打乱的特征顺序,并随机采样一个特征子集做训练和推理。这既降低了对列顺序的敏感,又以几乎为零的成本制造了预测多样性。
二是多样的预处理视角。 不同归一化方案、分位数变换、基于 SVD 的表示、特征交互,组合出互补的视图。对回归,还额外考虑重尾结果的目标变换。
三是 NNLS 组合。 对保留下来的各推理视角,学习非负权重。大数据集用单个 holdout 集上的预测估计权重;否则用 K 折交叉验证生成 out-of-fold 预测,以获得更大更稳的估计样本。然后对 one-hot 标签(分类)或连续目标(回归)拟合非负最小二乘。
四是最终分类校准。 组合后的类别概率在验证集上校准,取调整后概率最大的类别作为标签。
整个流程的哲学很清楚:不修改底层模型,只增加被评估的预测路径的数量与多样性。 而 NNLS 那一步加的非负约束,本质上是防止集成权重过拟合的一道刹车。
07 把四个榜单读成一张地图
TALENT:回归第二,二分类并列第一。
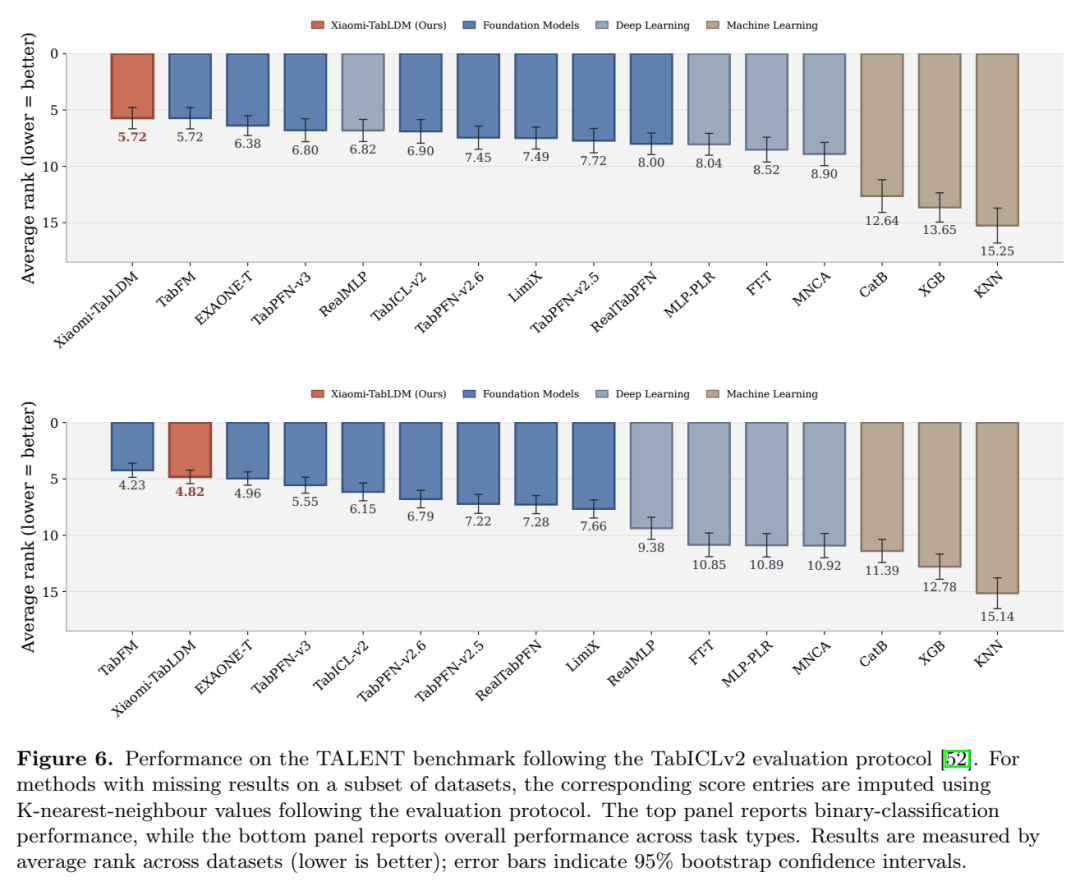
图 6|TALENT 基准上的表现(遵循 TabICLv2 评估协议,缺失结果用 KNN 插补)。上图为二分类,下图为跨任务类型的整体表现。指标为跨数据集平均排名(越低越好),误差棒为 95% bootstrap 置信区间。
回归上,Xiaomi-TabLDM 平均排名 4.03(100 个回归数据集),仅次于 TabFM 的 3.72。整体(下图)平均排名 4.82,同样第二,TabFM 4.23。身后是 EXAONE-Tabular 4.96、TabPFN-v3 5.55、TabICL-v2 6.15。
有意思的是上图:二分类平均排名 5.72,与 TabFM 并列第一。这提示我们,它在分类上并不弱,只是"强的方式"不一样。
TabArena:回归第二,效率账很好看。
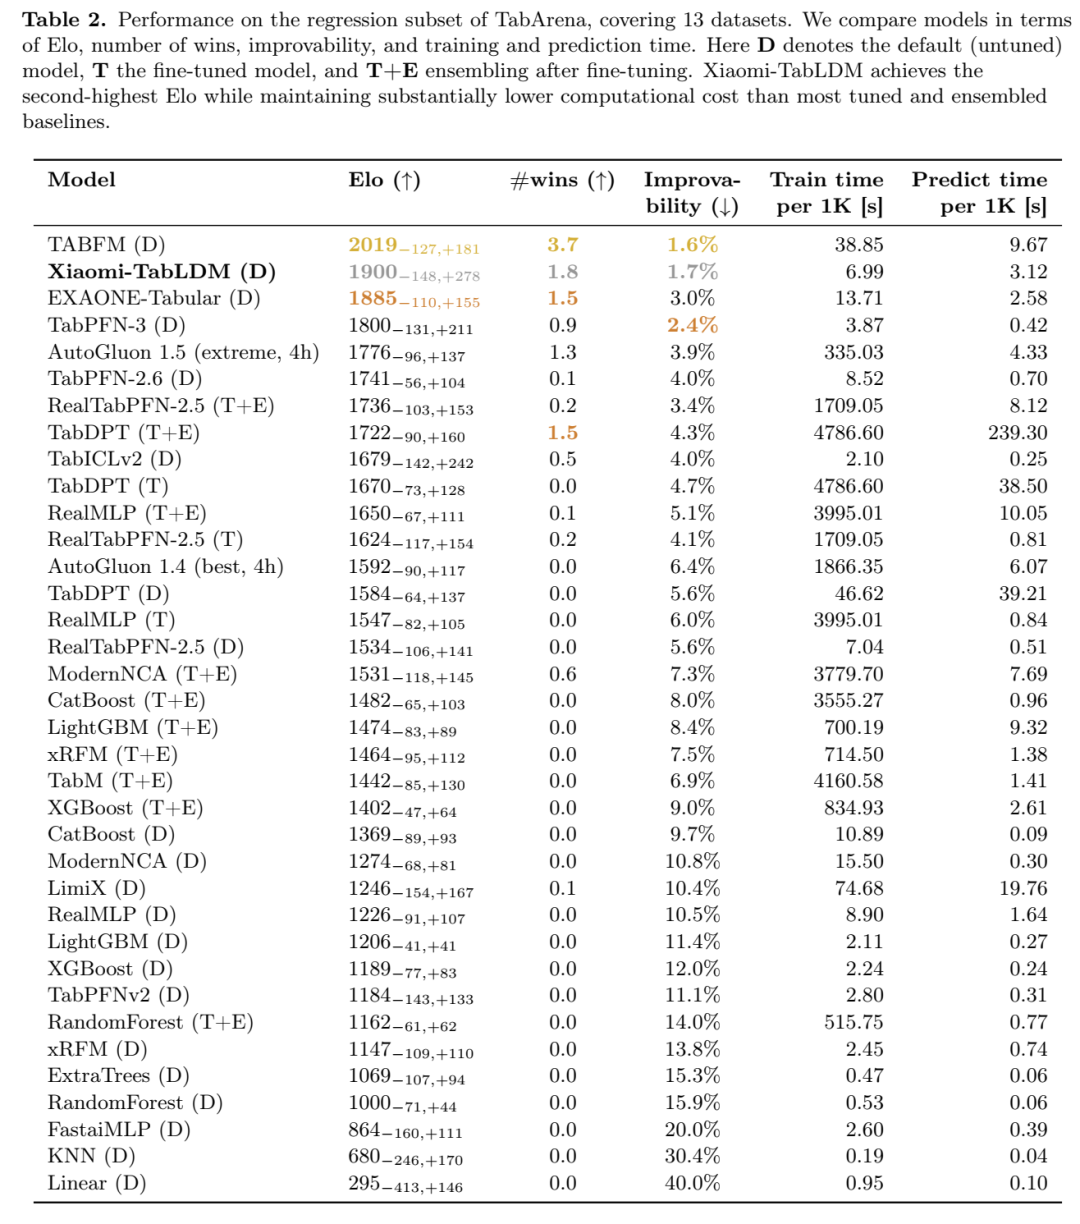
表 2|TabArena 回归子集(13 个数据集)榜单。D=默认(未调参),T=微调,T+E=微调后集成。
13 个回归数据集上,Xiaomi-TabLDM 的 Elo 是 1900,点估计第二,TabFM 2019 居首。它超过了 EXAONE-Tabular(1885)、TabPFN-3(1800)、TabPFN-2.6(1741)、TabICLv2(1679),也超过了重度调参的 AutoGluon 1.5 extreme(1776)。
Improvability 这个指标很直观:它衡量"还要再降低多少误差,才能追上该数据集上的最佳方法"。Xiaomi-TabLDM 是 1.7%,仅比 TabFM 的 1.6% 高 0.1 个百分点。
然后是最有说服力的一组数字:训练时间 6.99 s/1K 样本 vs TabFM 的 38.85 s,预测时间 3.12 s/1K vs 9.67 s。训练时间少 82%,预测时间少 68%。
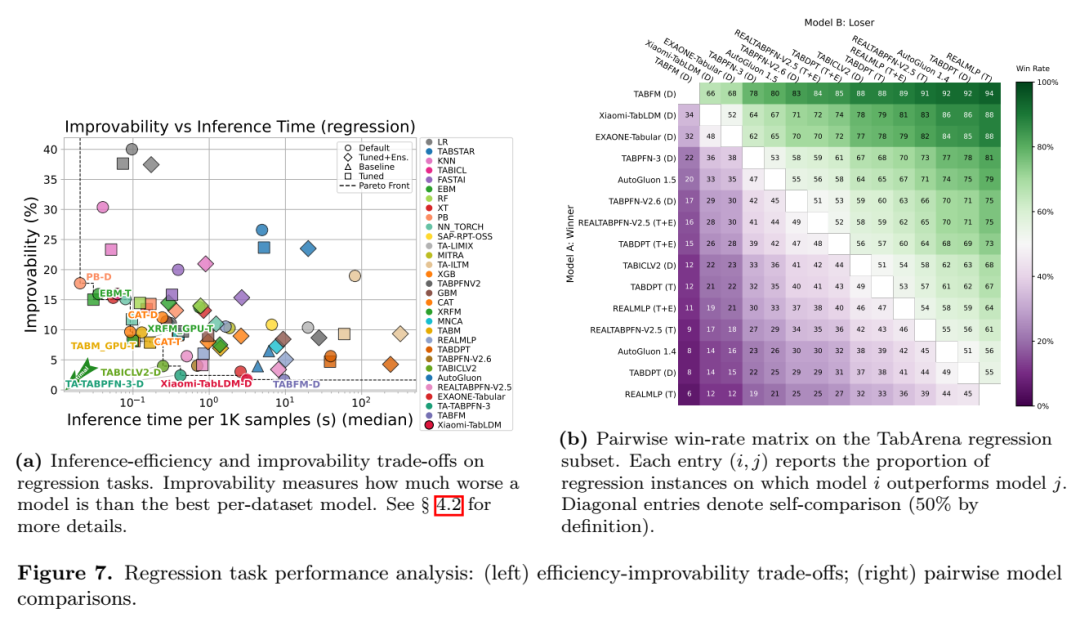
图 7|回归任务的效率-可提升性权衡(左)与成对胜率矩阵(右)。左图纵轴 improvability 越低越好,横轴为每 1000 样本的中位推理时间,虚线为 Pareto 前沿。右图每个格子 (i, j) 表示模型 i 胜过模型 j 的回归任务比例。
左图把这件事画成了一笔明白账:Xiaomi-TabLDM 落在高性能区域内,几乎贴着 Pareto 前沿。右图则给出了更细的颗粒度——它对 AutoGluon 1.5 的成对胜率是 67%,对 TabICLv2 是 78%。
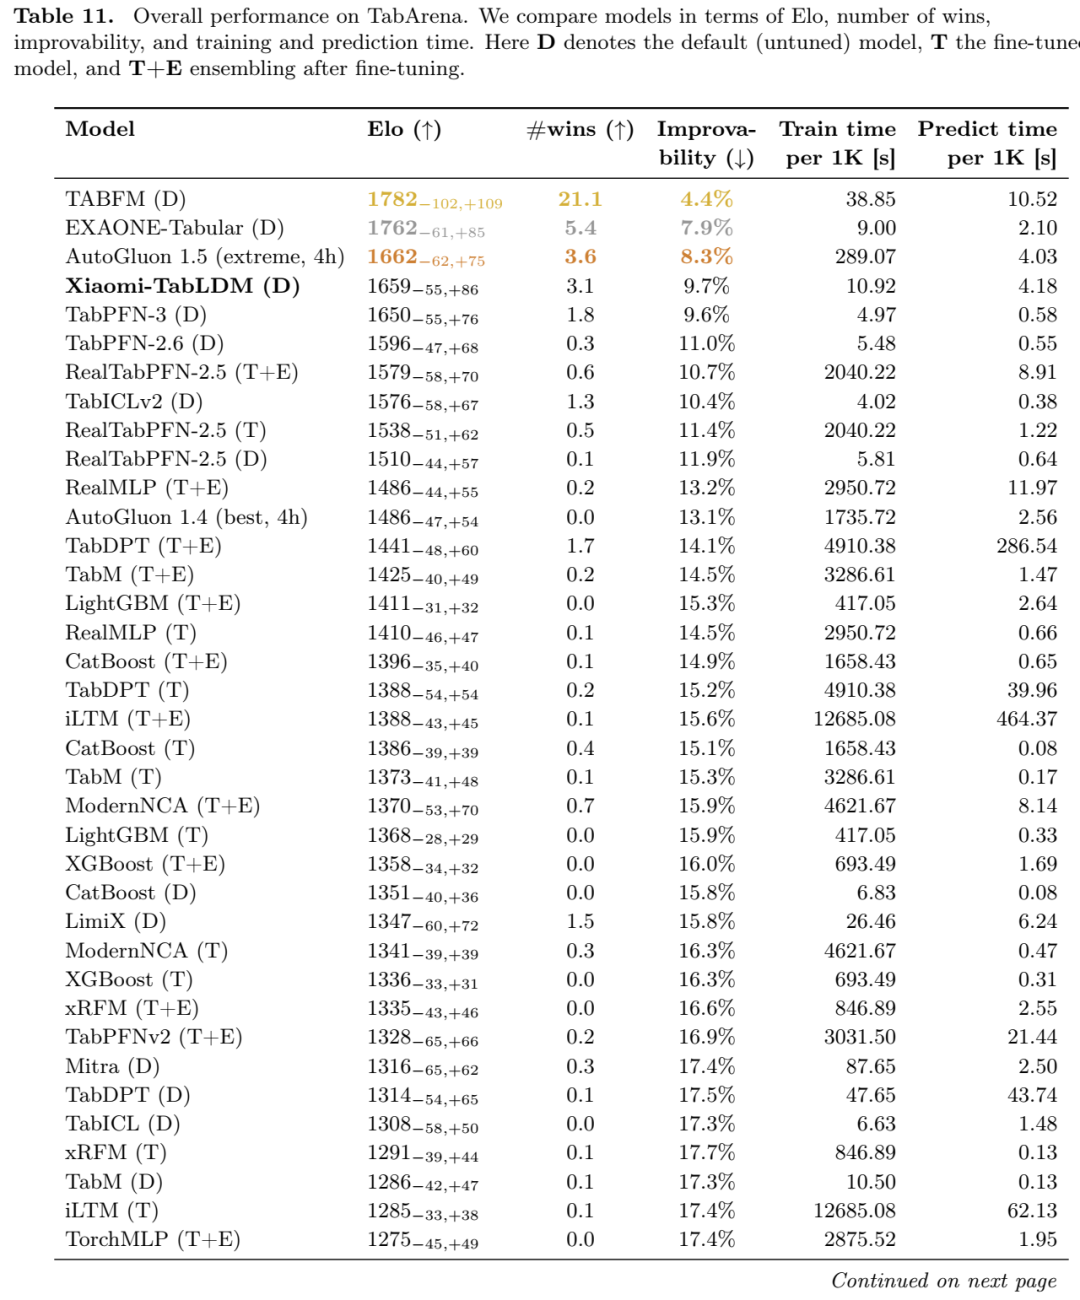
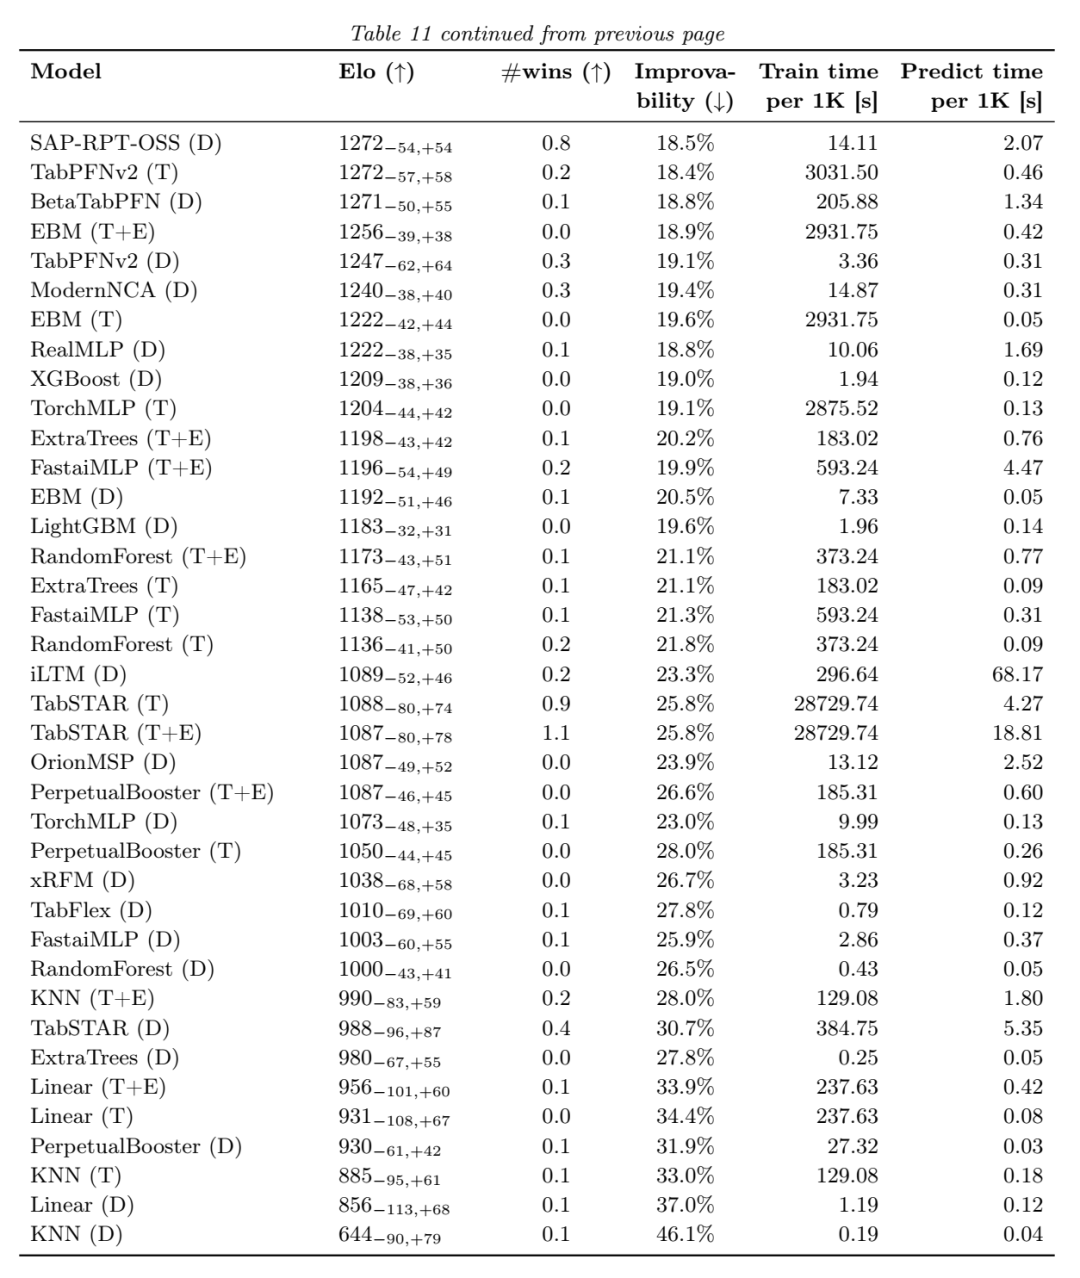
表 11|TabArena 完整榜单(51 个数据集、816 个任务)。
在全部 51 个数据集上,Xiaomi-TabLDM 的 Elo 是 1659,点估计第四,与 AutoGluon 1.5 extreme(1662)几乎持平,超过 TabPFN-3(1650)、TabPFN-2.6(1596)、RealTabPFN-2.5 调参+集成(1579)、TabICLv2(1576)。数据集胜场 3.1。
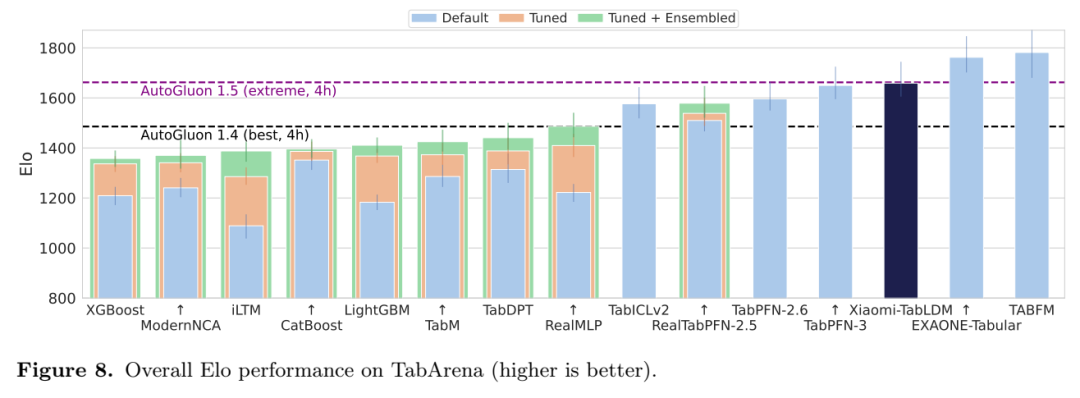
图 8|TabArena 整体 Elo(越高越好)。Xiaomi-TabLDM 以 1659 位列第四。
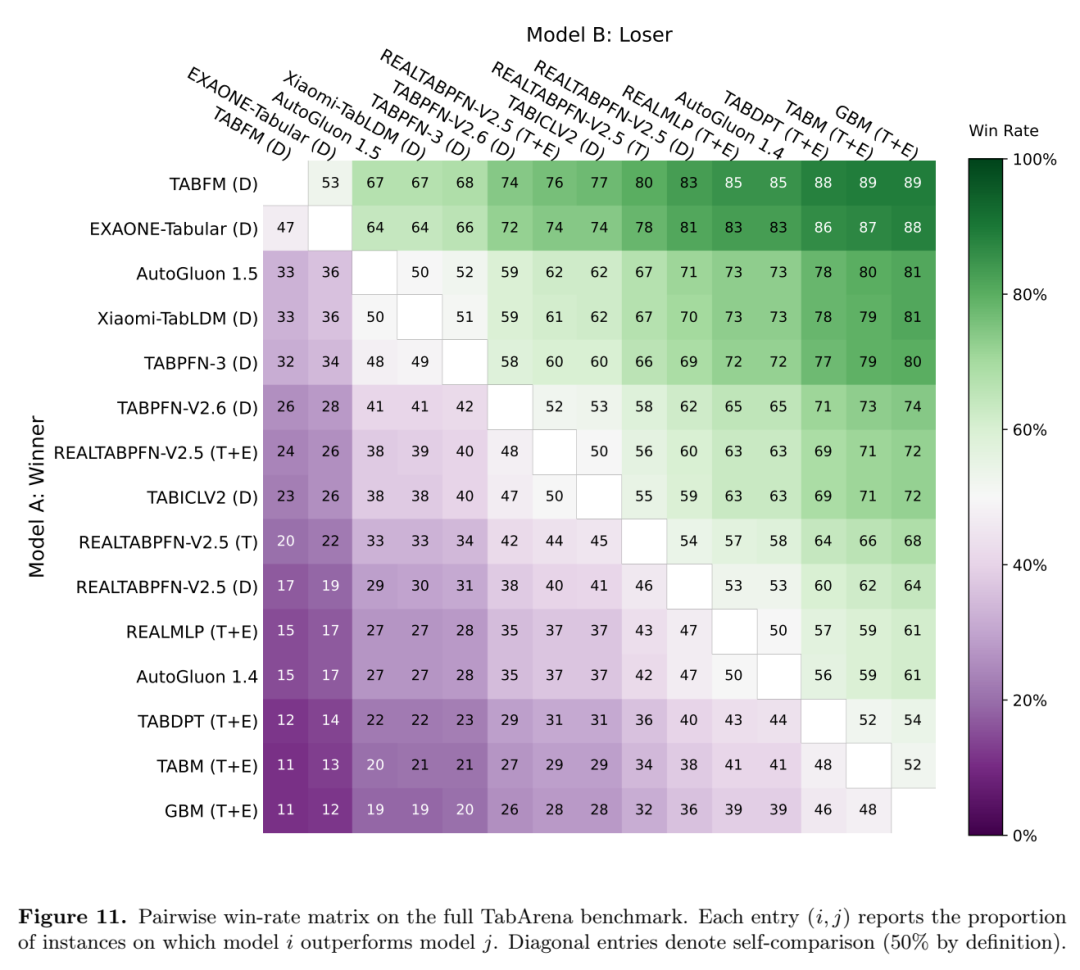
图 11|TabArena 全基准的成对胜率矩阵。
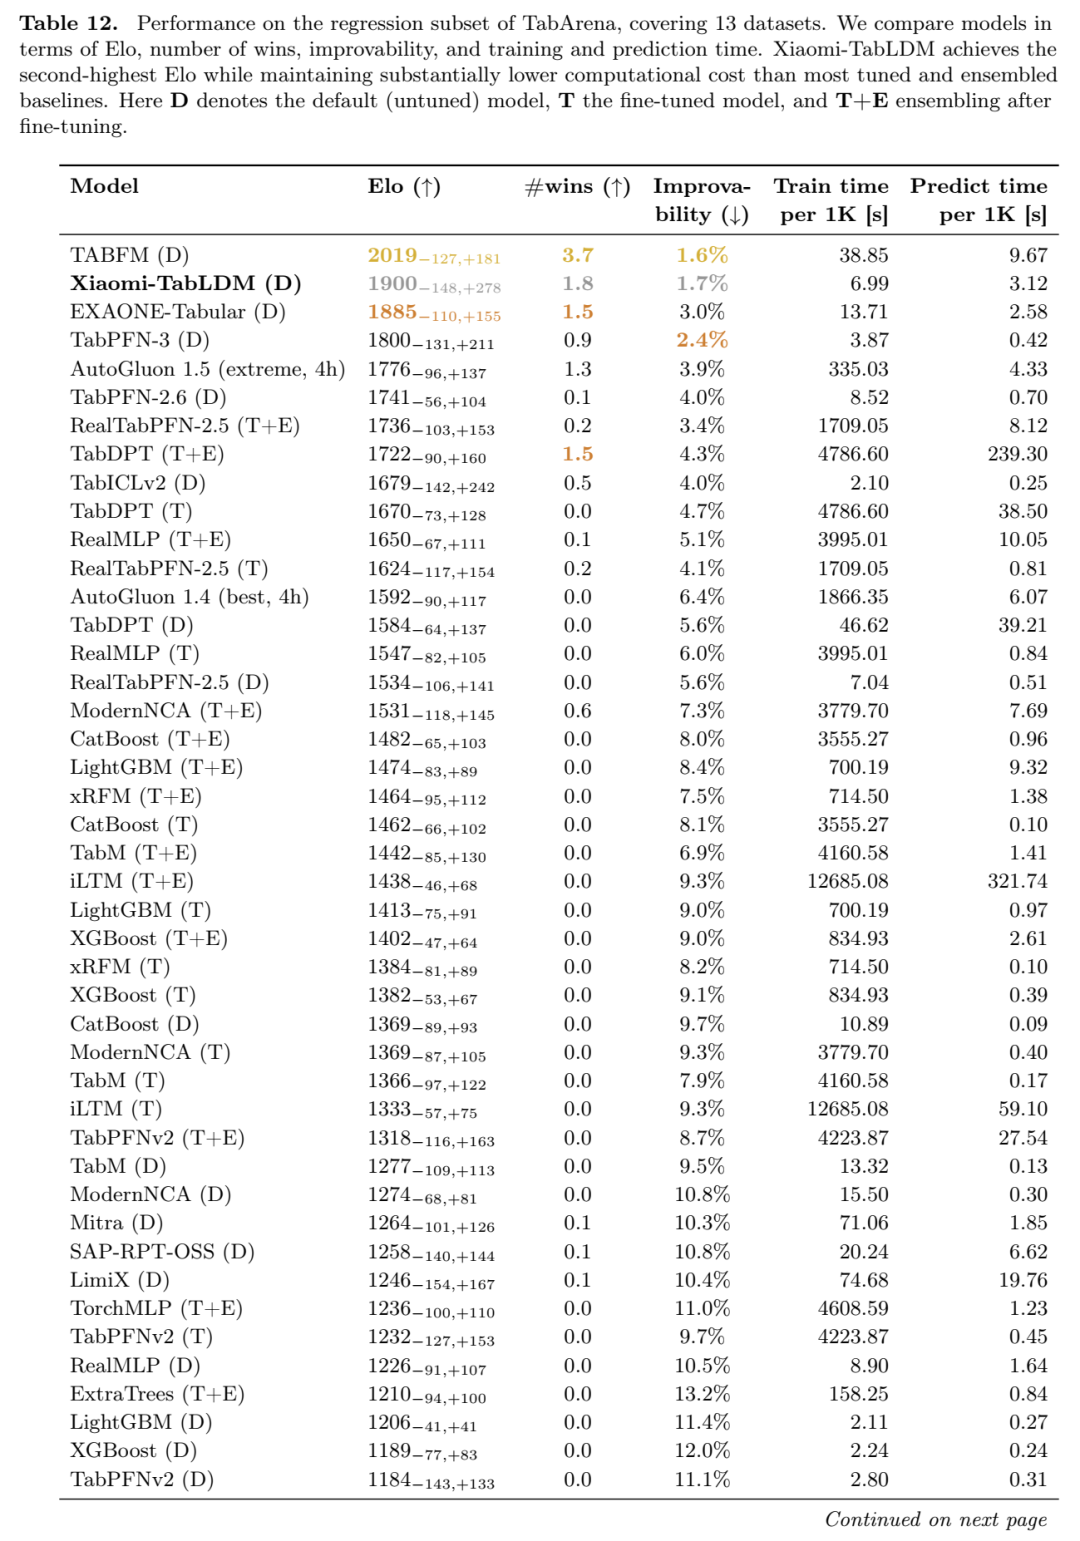
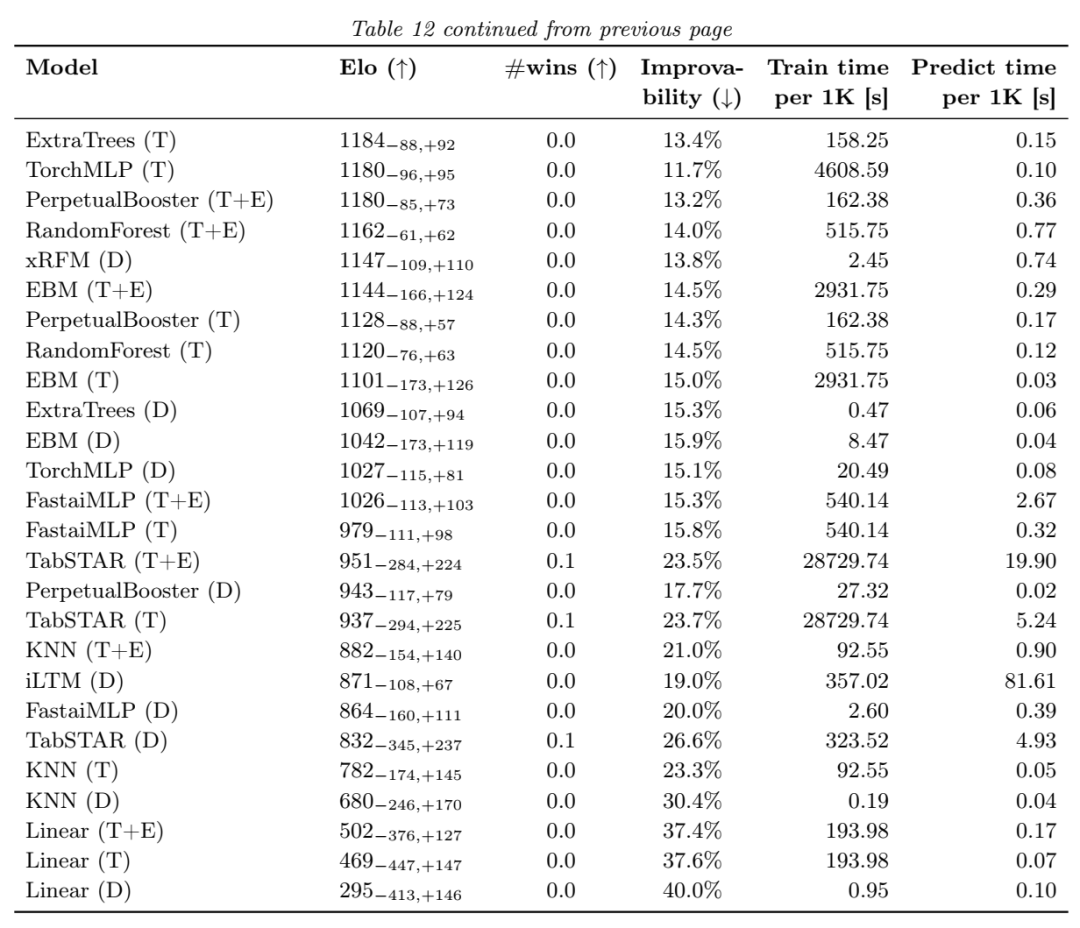
表 12|TabArena 回归子集完整榜单(附录版)。内容与表 2 一致,此处给出完整排序,便于对照尾部的传统方法。
BCCO:回归稳居第二,多分类也很能打。
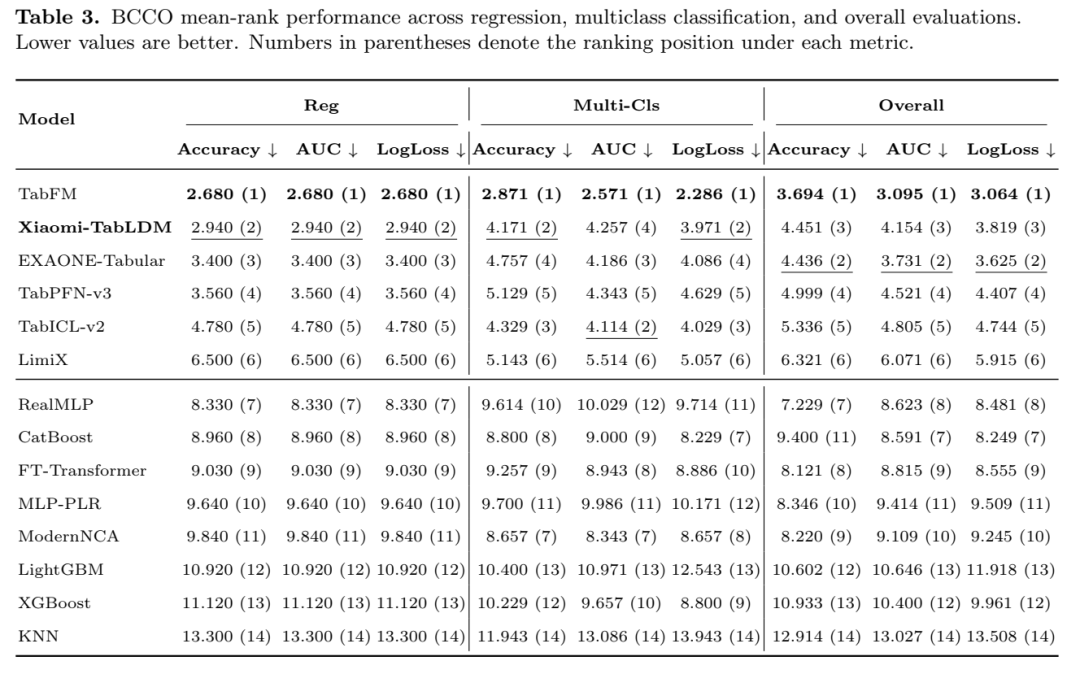
表 3|BCCO 在回归、多分类与整体三类评估上的平均排名(越低越好,括号内为排名位次)。
回归上,Xiaomi-TabLDM 在 Accuracy、AUC、LogLoss 三个指标下均为第 2,平均排名 2.940,仅次于 TabFM 的 2.680。多分类上,Accuracy 4.171(第 2)、LogLoss 3.971(第 2)、AUC 4.257(第 4)。汇总到整个 BCCO,Accuracy 4.451、AUC 4.154、LogLoss 3.819,三项均列第 3。
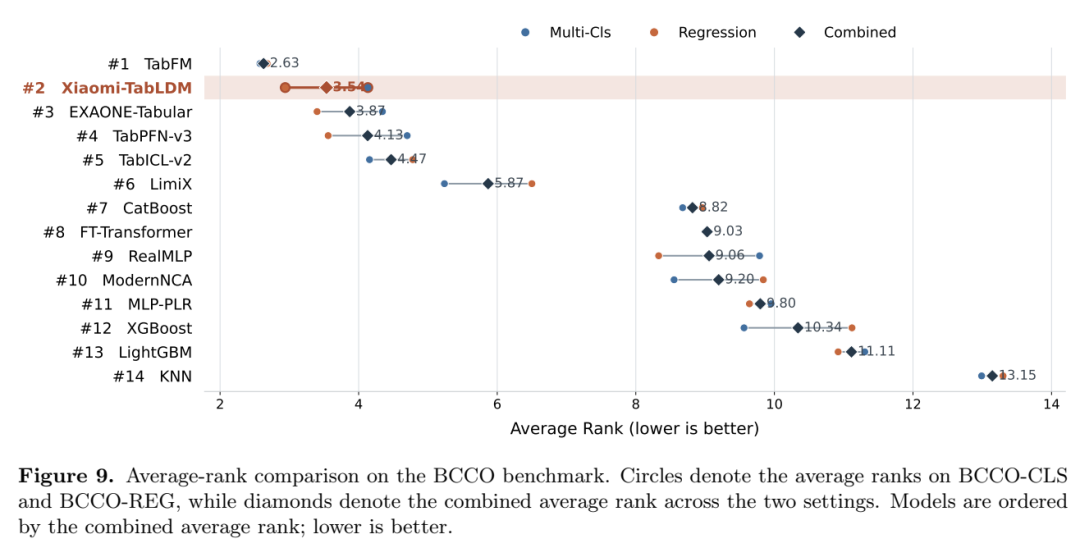
图 9|BCCO 平均排名对比。圆点为 BCCO-CLS 与 BCCO-REG 上的排名,菱形为两者合并后的综合排名。
图 9 把这件事可视化得很清楚:圆点与菱形三层信息叠在一张图上。Xiaomi-TabLDM 的综合排名 3.54,紧随 TabFM 的 2.63,第三名 EXAONE-Tabular 是 3.87。别忘了 BCCO 的刻薄之处:近三分之一的数据集含缺失值。
OpenML-CTR23:唯一的第一。 回到图 2。33 个纯回归数据集,Xiaomi-TabLDM 平均排名 3.03,是所有被评估方法中的最好成绩。这是它在四大套件里唯一的一个"第一",也是最有分量的一个——因为这个套件只考回归。
08 它到底学到了什么:把行向量投影到二维看一眼
榜单之外,我更关心一件事:这个模型是不是真的"看懂"了表格?
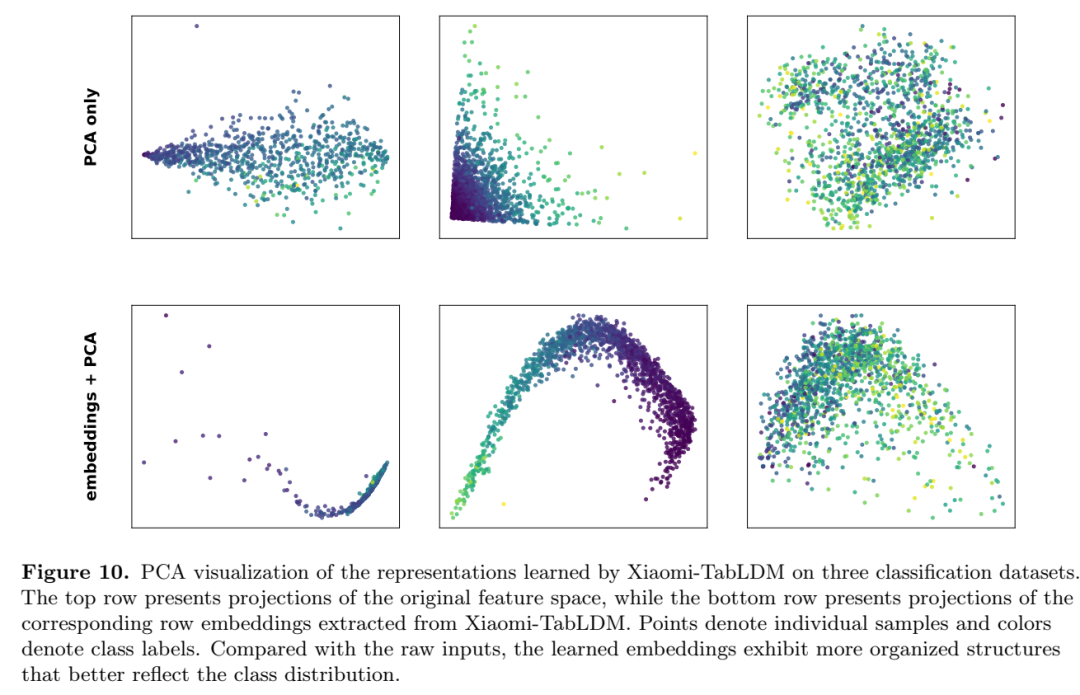
图 10|三个分类数据集上学到的表示做 PCA 可视化。上行直接对原始输入特征做 2D PCA,下行对 Xiaomi-TabLDM 提取的行嵌入做 PCA。点为样本,颜色为类别标签。
结果相当直观。原始特征空间的投影是弥散的、几乎看不出组织的;而行嵌入的投影出现了连贯的弯曲流形和更紧致的样本结构。
这说明 Xiaomi-TabLDM 把异质的表格输入变换成了更能捕捉底层结构的表示。对做交叉学科的人来说,这张图的意义超出"模型可解释性"——它暗示这条路:表格基础模型可以当作一个通用的表格表征提取器,接到你自己的下游科学任务上。
09 附录里最被低估的一节:2240 个数据集的噪声压力测试
如果这篇报告只能留一节精读,我会选附录 C。
它做了一件在主流表格论文里极其罕见的事:用受控因子实验,测试表格回归模型对外生噪声的敏感性。
实验设计。 每个数据集由一个含 32 个观测变量的 SCM 生成,31 个是预测特征,拓扑序最后一个节点作为回归目标。不引入潜变量,避免未观测混杂因素干扰。
图用有序 Erdős–Rényi 构造采样:给定拓扑序,每条符合该序的前向边以概率 p 独立加入,无环性由构造保证。图密度是第一个因子,两个水平:稀疏 p∼U[0.04, 0.10](期望平均入度约 0.62–1.55);稠密 p∼U[0.25, 0.40](约 3.88–6.20)。
信噪比是第二个因子,四个水平:L1 为 sj∼U[−5, 0),L2 为 U[0, 5),L3 为 U[5, 10],Lrand 为 U[−5, 10](允许低 SNR 与高 SNR 节点共存于同一张图)。噪声按 σj = 10^(−sj/20) 注入。
关键的一条:子节点接收到的是带噪的 xj,而不是去噪后的纯结构信号。所以上游引入的扰动会沿图向下传播。这比"在最后一层加噪"真实得多。
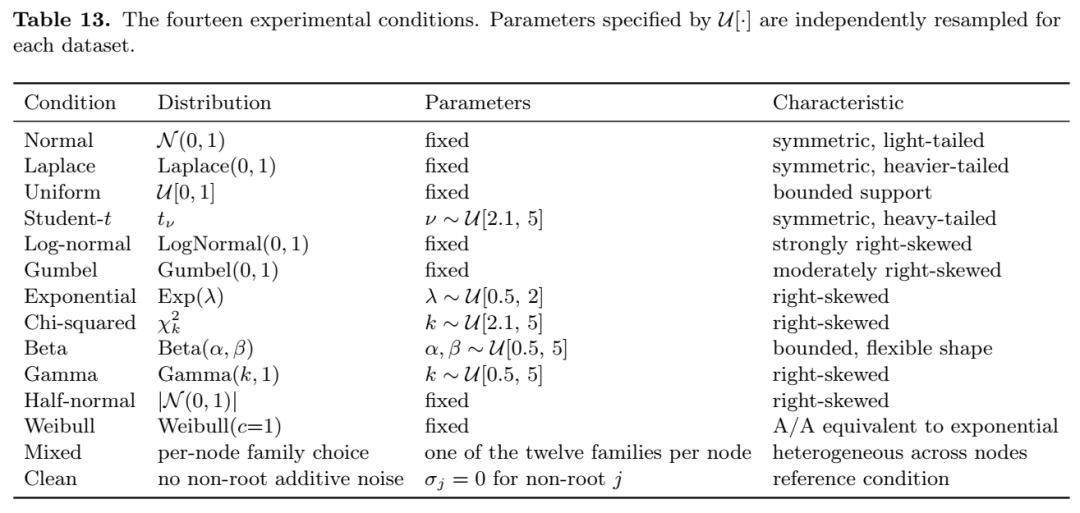
表 13|十四个实验条件。十二种单一噪声分布、一个混合噪声条件,以及一个无加性噪声的 Clean 参考条件。
于是形成 2(图密度)× 4(SNR)× 20(基础配置)× 14(噪声条件)= 2240 个数据集的平衡全因子设计。每个基础配置固定图结构、结构函数、SNR 向量和特征置换,只改变噪声条件。
结果。 在全部 2240 个数据集上,Xiaomi-TabLDM 取得最高 R² 的次数是 1575 次,第一名占比 70.3%;LimiX 是 16.0%,TabICLv2 是 13.7%。
更值得看的是稳定性。它在全部十三个非 Clean 噪声条件下都保持优势:最低的第一名占比是 63.8%(Laplace 和 Student-t 条件),最高是 78.1%(Exponential)。即使在最不利的噪声分布下,它仍然在接近三分之二的数据集上排第一。相比之下,LimiX 在任何条件下都没超过约 28%,TabICLv2 的最高值约 25%——而且出现在 Clean 参考条件下。
然后是全篇我最欣赏的一个细节。 Exponential 与 Weibull 这两个条件构成一个刻意设计的、分布等价的 A/A 对照:Weibull(c=1) 等价于指数分布,而指数分布的率参数在标准化后被消除。两者在总体层面共享同一个标准化分布,但由相互独立的随机样本生成。
结果:它们的第一名占比相差 5.0 个百分点。
这 5.0 个百分点,就是"纯抽样随机性"的噪声地板。换句话说:任何小于 5 个百分点的榜单差异,在这套实验尺度下都应该被怀疑。 我强烈建议把这个 A/A 对照的思路抄进你的论文里——无论是做材料筛选、临床预测还是政策评估,一个内置的、分布等价的随机性基线,比任何漂亮的数字都更能说明你的结论有多稳。
10 给 AI+交叉学科的六条启发
第一,结构化数据是交叉学科的母语,别再用 token 去翻译它。 表格保留的东西——数值尺度、缺失模式、类别结构、变量间关系——恰恰是科学推理的骨架。把一张临床表 flatten 成自然语言喂给 LLM,是在削足适履;而表格基础模型是原生的。
第二,SCM 先验的本质,是把"领域知识"编译成"数据生成器"。 这是全篇最可迁移的思想。模型的先验不是靠爬真实数据堆出来的,而是靠一个可参数化的因果生成过程。反过来说:如果你能把你所在学科的数据生成机制写成 DAG + 结构函数族 + 噪声分布族,你就拥有了一个专属的预训练世界。这是从"数据驱动"走向"机制驱动 + 数据驱动"的转译接口。材料学的成分-工艺-性能链、流行病学的传播链、经济学的供需链,都可以这样写。
第三,附录 C 是一份可以直接搬走的实验设计模板。平衡全因子 + 分布等价 A/A 对照 + 噪声沿因果图传播。这套东西的价值远超表格学习本身。审稿人问"你的结论有多稳"时,一个 5.0 pp 的噪声地板比十句"robustness check 已通过"都有力。
第四,稀疏 MoE 是"通识 + 专业分工"的组织学原理。 共享专家学所有样本共用的变换,路由专家只做特化。容量随专家数增长,激活量不变。这个结构隐喻放之四海皆准:你不需要每次开会都把所有专家请到现场,但你需要一个所有人都认可的公共语言(共享专家)。
第五,Test-time scaling 让"算力"变成一种新的科研资源。 对那些样本极少、但单次预测价值极高的问题——罕见病的预后、昂贵实验的参数推荐——你可以在推理时用特征洗牌、多视角预处理和 NNLS 集成去换精度,而一个模型参数都不用更新。零样本、少标注、可负担,这是给小样本科学场景的直接红利。
第六,效率账是有学科含义的。 训练时间降 82%、预测时间降 68%,意味着超参搜索和重复交叉验证的成本大幅下降。很多交叉学科课题恰恰卡在"算力预算不够跑完整套 ablation"上。便宜的强基线,会改变一整个领域的研究节奏。
11 泼几盆冷水
读到这儿如果已经准备换模型了,先听我说完。
第一盆:合成到真实的鸿沟仍在。 模型完全在 SCM 合成数据上预训练,靠先验的多样性去覆盖真实分布。这既是它最优雅的地方,也是最大的风险——先验没覆盖的机制不会凭空出现。时空自相关、测量误差、选择偏倚、分布漂移、人为填报的怪癖,这些在真实科学数据里到处都是,而在图 5 那条流水线里没有位置。
第二盆:它强在回归,不是全才。 四个套件上回归都是最强项;多分类的 AUC(BCCO 上 4.257,第 4)相对弱一些。如果你的问题是多分类或高度不平衡的分类,别照搬这个结论。
第三盆:置信区间在提醒你别太当真。 TabArena 回归 Elo:Xiaomi-TabLDM 1900(−148, +278),TabFM 2019(−127, +181)。两个区间高度重叠。在这个尺度上,"第二"和"第一"在统计上未必可分。恰恰是附录 C 的 A/A 对照教会我们要这样读榜单。
第四盆:复现门槛。 8 张 A100-80GB,Stage 1 就是 7–10 天。好消息是权重和代码都放出来了,你可以直接用,不必自己烧一遍。
第五盆:能力边界要记牢。 预训练最多 10 类,超过要靠 mixed-radix 拼装;回归输出是 999 个分位数,本质是离散化的条件分布,尾部行为的精度取决于分位点密度。另外,论文没有对缺失值机制做单独分析——而 BCCO 有近三分之一的数据集含缺失值。
12 写在最后:四个可以做下去的题目
Xiaomi-TabLDM 是一份很"实在"的技术报告。它没有宣称范式革命,只是把先验、容量、推理这三件事各往前推了一格,然后用四个套件、2240 个受控数据集把每一格都量了一遍。
我最喜欢的一句话在结论里:提升表格基础模型,并不必然要求把模型规模或算力成本堆上去;有效的架构设计与容量分配,提供了另一条实用路径。
对一个算力有限、数据昂贵、但领域知识丰富的交叉学科课题组来说,这句话的分量,比任何一个 SOTA 都重。
如果你正想找题目,这里有四个:
领域专属 SCM 先验——把你学科的生成机制写进先验,看 domain-specialized 的表格基础模型能不能打过通用款;
表格基础模型作为通用表征器——图 10 只是个 PCA,把它接到你自己的下游任务上,系统评估"表格嵌入"能迁移多远;
合成先验的泛化理论——为什么在 SCM 上训出来的模型能泛化到真实表,prior mismatch 的泛化界长什么样,这个问题目前几乎是空白;
自适应的 test-time 预算分配——什么时候该停止增加推理视角,NNLS 权重的熵能不能作为停止准则。

内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢