

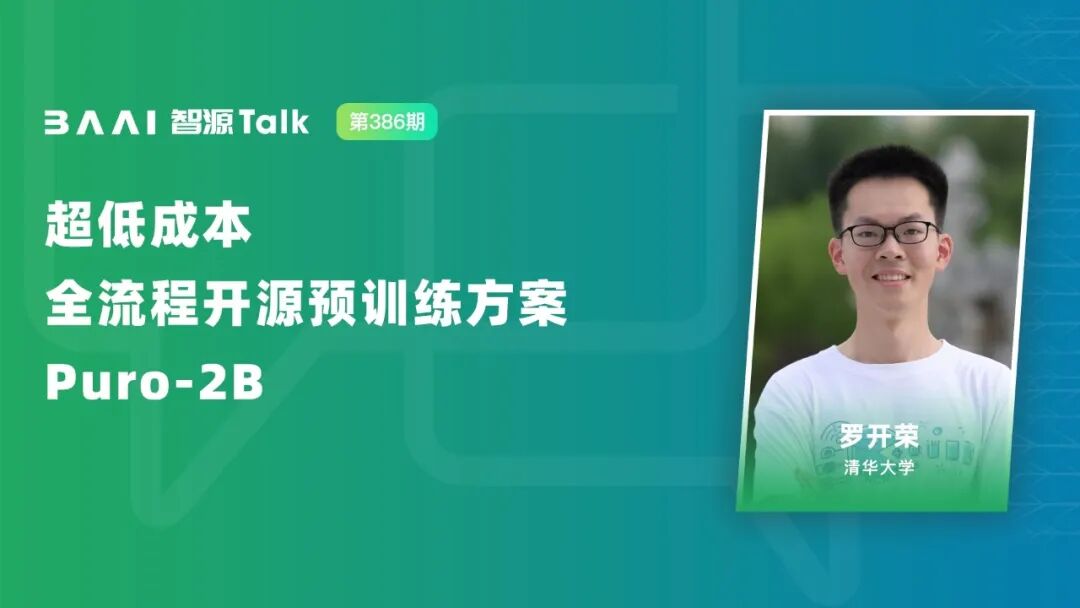
报告主题:超低成本,全流程开源预训练方案Puro-2B
报告日期:09月17日(周四) 10:30-11:30
语言模型预训练几乎已成为高昂成本的代名词,让许多学术团队和开源社区望而却步。尽管已有众多优秀的开放权重模型和开源训练方案,但仍然缺乏兼顾成本效率、硬件可及性与全流程开源的预训练方案。即使在较小的模型规模上,训练 Llama-3.2-3B 的成本也超过 150 万美元,复现 SmolLM3-3B 则需要超过 70 万美元。
本报告介绍一套旨在降低这一门槛的全流程开源预训练方案。基于该方案,我们在消费级显卡 RTX 5090 上采用 FP8 精度,从零训练了 Puro-2B(普罗-2B)系列模型,训练数据量最高达 1.4 万亿 token。该系列覆盖了不同的训练预算,其中性能最优的模型在我们的评测框架下表现接近 Qwen2.5-1.5B,预训练计算成本不足 6900 美元;达到 Qwen2-1.5B 性能水平所需的预训练计算预算则不到 5090 美元。这一成本效率来自硬件选型、低精度训练、Hyperball 优化器、课程模型平均(CMA)与数据配方等多个方面的共同改进。
我们以 Apache 2.0 许可协议开放 Puro-2B 的完整训练方案,包括数据、代码和模型权重,希望让更多普通实验室能够参与语言模型的预训练与研究。
报告嘉宾:
罗开荣,清华大学计算机系三年级博士生,本科毕业于清华大学姚班,师从陈文光教授,也与吕凯风教授长期密切合作。主要研究方向为语言模型的 Scaling 规律与高效预训练,相关成果发表于 ICLR、ACL 等国际会议,其中 CMA 工作入选 ICLR 2026 口头报告(Oral)。主导训练了开元-2B(鹏城脑海)、普罗-2B 等全流程开源的小型语言模型,致力于降低语言模型预训练的成本与参与门槛。
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢