

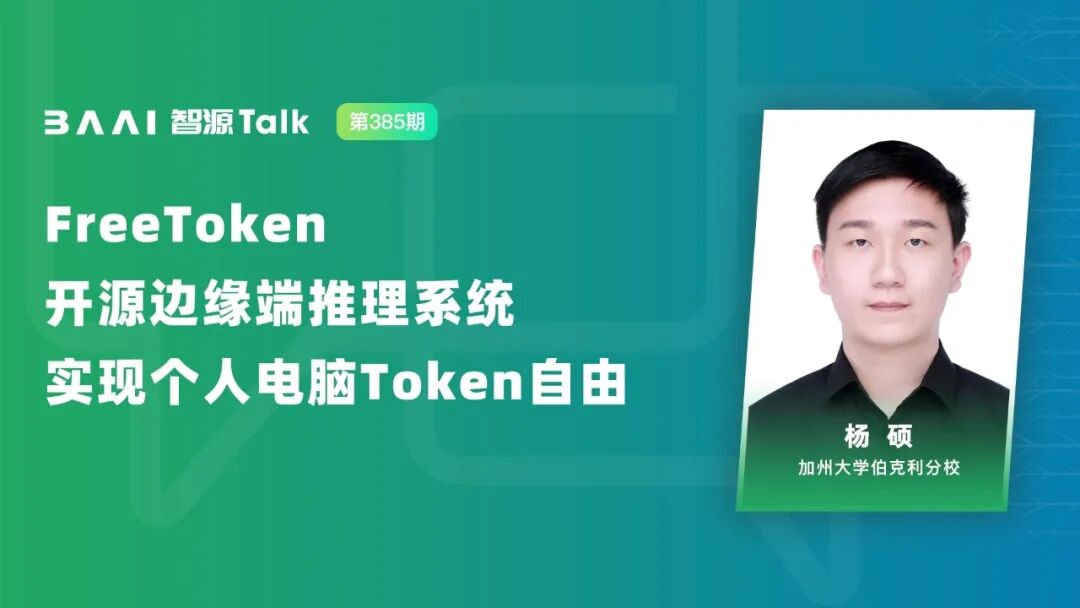
报告主题:实现个人电脑Token自由,端侧推理引擎FreeToken
报告日期:09月16日(周三) 10:30-11:30
议题详情:
语言模型预训练几乎已成为高昂成本的代名词,让许多学术团队和开源社区望而却步。本次智源TALK邀请由UC Berkeley、MIT等机构联合开源的端侧推理引擎 FreeToken,彻底打破了“大模型权重虽开源,但普通人电脑跑不动”的硬件壁垒。它让消费级显卡也能流畅运行满血版顶尖MoE模型,真正实现了个人电脑的Token自由。
FreeToken 针对本地人工智能应用的两大现实特征,对整个服务栈进行了协同设计:一是智能体(agent)类工作负载的执行模式持续动态变化;二是边缘硬件资源具有高度异构性,且不同设备间的资源配比差异显著。这两大特征具体体现在模型布局与加载、专家模块驻留策略、CPU–GPU 协同执行、智能体状态复用机制以及运行时内存管理等关键环节。
FreeToken 并不预先固化某种卸载策略,而是持续地、动态地将计算任务与模型状态映射到设备当前实际可用的资源之上。FreeToken 支持超过 20 种 MoE 模型,并已在涵盖从仅配备 8GB 显存的笔记本 GPU 到单块工作站级 GPU 的多种硬件平台上,成功运行真实的代码生成与工具调用类智能体。
更重要的是,它显著拓展了各类终端设备的实际服务能力:在普通笔记本上即可部署 35B 参数规模的模型,在高端游戏台式机上可运行高达 284B 参数的模型,甚至可在单块工作站级 GPU 上直接部署参数量达 753B 的 GLM-5.2 模型。FreeToken 将开源权重真正转化为可即装即用的本地化软件,使用户手中已有的终端设备成为支撑前沿级人工智能能力的切实可行平台。本系统已在 flashml.ai 开源发布。
报告嘉宾:
Shuo Yang is a Ph.D. researcher in EECS at UC Berkeley, working on machine learning systems with a focus on efficient AI inference and hardware-aware algorithm design. His recent work explores how to rethink AI systems and algorithms around modern hardware, spanning efficient LLM serving, large-scale model inference on consumer hardware, and high-performance machine learning operators. He is the lead developer of FlashLib and FreeToken: FlashLib redesigns classical machine learning algorithms for modern accelerators, while FreeToken enables frontier-scale models to run efficiently on personal and edge hardware.
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢