

人工智能赋能的虚拟细胞模型代表了一种新兴的计算机辅助药物发现方法 ,然而,大多数现有方法缺乏大规模、时间分辨的扰动蛋白质组学数据以及用于预测治疗反应的可解释框架。在此,我们从系统性扰动的乳腺癌细胞系中生成了超过3800万个蛋白质丰度的时间序列测量数据,并开发了虚拟细胞模型ProteinTalks。ProteinTalks的核心在于大规模动态蛋白质组学资源与模型架构的协同作用,从而构建了一个全新的预训练框架,该框架能够从时间序列蛋白质组轨迹中学习可迁移的动态潜在表征。通过模拟蛋白质如何对不同扰动做出条件性响应,该方法使模型能够作为多种药物发现任务的实用工具:预测药物疗效和协同作用、发现新的药物组合、探究与耐药性相关的蛋白质、对患者反应进行分层以及筛选用于患者类器官的候选药物。它还展现出强大的可迁移性,不仅适用于细胞系,还适用于患者来源的类器官和临床活检样本,并且在评估的方案下,其性能通常优于选定的基准实现。总而言之,ProteinTalks 展示了可扩展的可迁移动态表征预训练如何使基于蛋白质组学的、具有动态感知能力的虚拟细胞模型能够推动计算机辅助药物发现的发展。
论文:An operational perturbation proteomics-based virtual cell model
单位:西湖大学、北大、北京科学智能研究院、哈医大等
发布日期:2026年
https://t.zsxq.com/73o3v
请索引第128篇论文
 |  |
3800 万次测量之后:一个会"算时间"的虚拟细胞,登上了 Nature
深度解读 ProteinTalks:当 AI 不再只给细胞拍快照,而是拍了一部蛋白质组的电影。
2026 年 9 月 9 日,西湖大学郭天南团队联合北京大学、哈尔滨医科大学、DP Technology 等单位,在 Nature 上线了一篇论文《An operational perturbation proteomics-based virtual cell model》。
这篇论文里埋着一条对 AI+交叉学科研究者极有营养的方法论暗线,而这条线,恰恰藏在摘要里最容易被滑过去的那个词上:operational(可操作的)。
第一,他们真的自己做了湿实验,而且做得很重:3800 万条蛋白丰度测量、16,311 份扰动蛋白质组样本、约 6,668 小时的质谱机时。请注意"6668 小时"这个数字——那是 278 个昼夜不停转的质谱仪日,相当于一台机器连续跑了九个月。
第二,他们的模型很小。论文自己写的:比现有静态转录组基础模型少约 1000 倍的参数和样本,却在跨细胞系、跨药物、跨癌种、病人来源移植瘤、501 例临床活检、患者类器官这一长串任务上,普遍打过了 Geneformer、GeneCompass、UCE 这三个转录组基础模型。
第三,它不是"预测完就结束"的那种论文。它把模型输出的 SHAP 值做了时间维度上的推广,据此挑出一个叫 AKR1C3 的蛋白,回去做 siRNA 敲低,真把 BT20 细胞对多西他赛的敏感性拉了回来(Δln[IC50] = 4.24);又在三位三阴性乳腺癌患者的类器官里,从 3000 个老药中筛出三个候选,实测 IC50 全部优于顺铂,其中 CAY10603 在 P855 这位患者身上是 0.33 nM 对 0.53 mM——差了六个数量级。
01 虚拟细胞的"中年危机":热闹了两年,还是不敢下场开药
如果你在 2024 年之后做过 AI for Science,你一定被"虚拟细胞(virtual cell)"这个词刷过屏。
2024 年 Cell 那篇由 Bunne 等人牵头、几十位作者联署的愿景文章《How to build the virtual cell with artificial intelligence》,把这件事推上了风口。逻辑很朴素:既然大模型能学会语言的统计结构,为什么不能学会细胞的"状态结构"?只要喂给它足够多的组学数据,它就能在计算机里模拟一个细胞,然后在硅基世界里试药——省钱、省时、省命。
于是各路模型蜂拥而至。Geneformer、scFoundation、UCE 这类"通用嵌入派",从转录组快照里学细胞表示;STATE、x-Cell、CellOT、STACK 这类"扰动响应派",用 Perturb-seq 数据学扰动之后的表达变化;PRESCIENT、TrajectoryNet、DeepRUOT 这类"轨迹派",试图把细胞状态的变化过程插值出来。
这三类工作都很扎实,也都推动了领域。但如果你诚实地翻一翻 2025 到 2026 年的评测文献,会发现气氛有点尴尬。
Ahlmann-Eltze 等人在 Nature Methods 上给出的结论相当不客气:深度学习做基因扰动效应预测,尚未稳定超过简单的线性基线。Boiarsky 等人对单细胞基础模型的深度评测、Kedzierska 等人的零样本评测,也都指向同一个方向——这些模型学到了漂亮的细胞"地图",却未必学到了可靠的"导航能力"。Dibaeinia 等人 2026 年的预印本更直接,标题就叫《Virtual cells need context, not just scale》:虚拟细胞需要的不是规模,是语境。
为什么会这样?论文在这里给了一个我认为非常关键、也非常"蛋白质组学人"的回答:
转录组只是中心法则的中间层。真正干活的是蛋白。
mRNA 到蛋白之间隔着翻译调控、蛋白降解、修饰、定位、复合物组装……一整条"最后一公里"。你测得再准的转录本,也只是细胞"打算做什么"的计划书;蛋白组才是"实际干了什么"的施工记录。用计划书去预测药物反应,中间差的那一层,恰恰是耐药机制最喜欢藏身的地方。
这不是说转录组不好——它便宜、通量高、生态成熟。而是说,如果一个领域全都押注在一种模态上,那它就欠世界一个对照实验。ProteinTalks 就是那个对照实验。
02 ProteinTalks 的三句话版本
如果你只有 30 秒,记住这三句话就够了。
第一句(数据): 作者用 96 孔板高通量平台,把 18 株乳腺癌细胞系(16 株三阴性 TNBC + 2 株非 TNBC)暴露在 63 个 FDA 批准的小分子药物以及 59 个药物组合之下,在 0、6、24、48 小时四个时间点取样,做 DIA-MS(数据非依赖采集质谱),配上 CCK8 细胞活力测定,构建了一个名为 PTDS 的扰动蛋白质组资源库。
第二句(模型): 在此基础上训练的 ProteinTalks,用一个神经 ODE(神经常微分方程)把"基线蛋白组 + 药物靶点"这个初始条件,沿着时间轴积分出 6/24/48 小时的蛋白组轨迹;再把这些预测出的时间分辨蛋白组与药物分子特征拼接,用一个多层感知机预测药效与联合用药协同。损失函数是两块的加权:蛋白组重建的 MSE,加上药效预测的 BCE,权重 λ = 0.8。
第三句(应用): 这个模型能干五件事——追踪细胞状态轨迹、找与药敏相关的蛋白、预测 PDX 模型的药效、给患者做预后分层、以及给患者类器官做个体化用药排序。
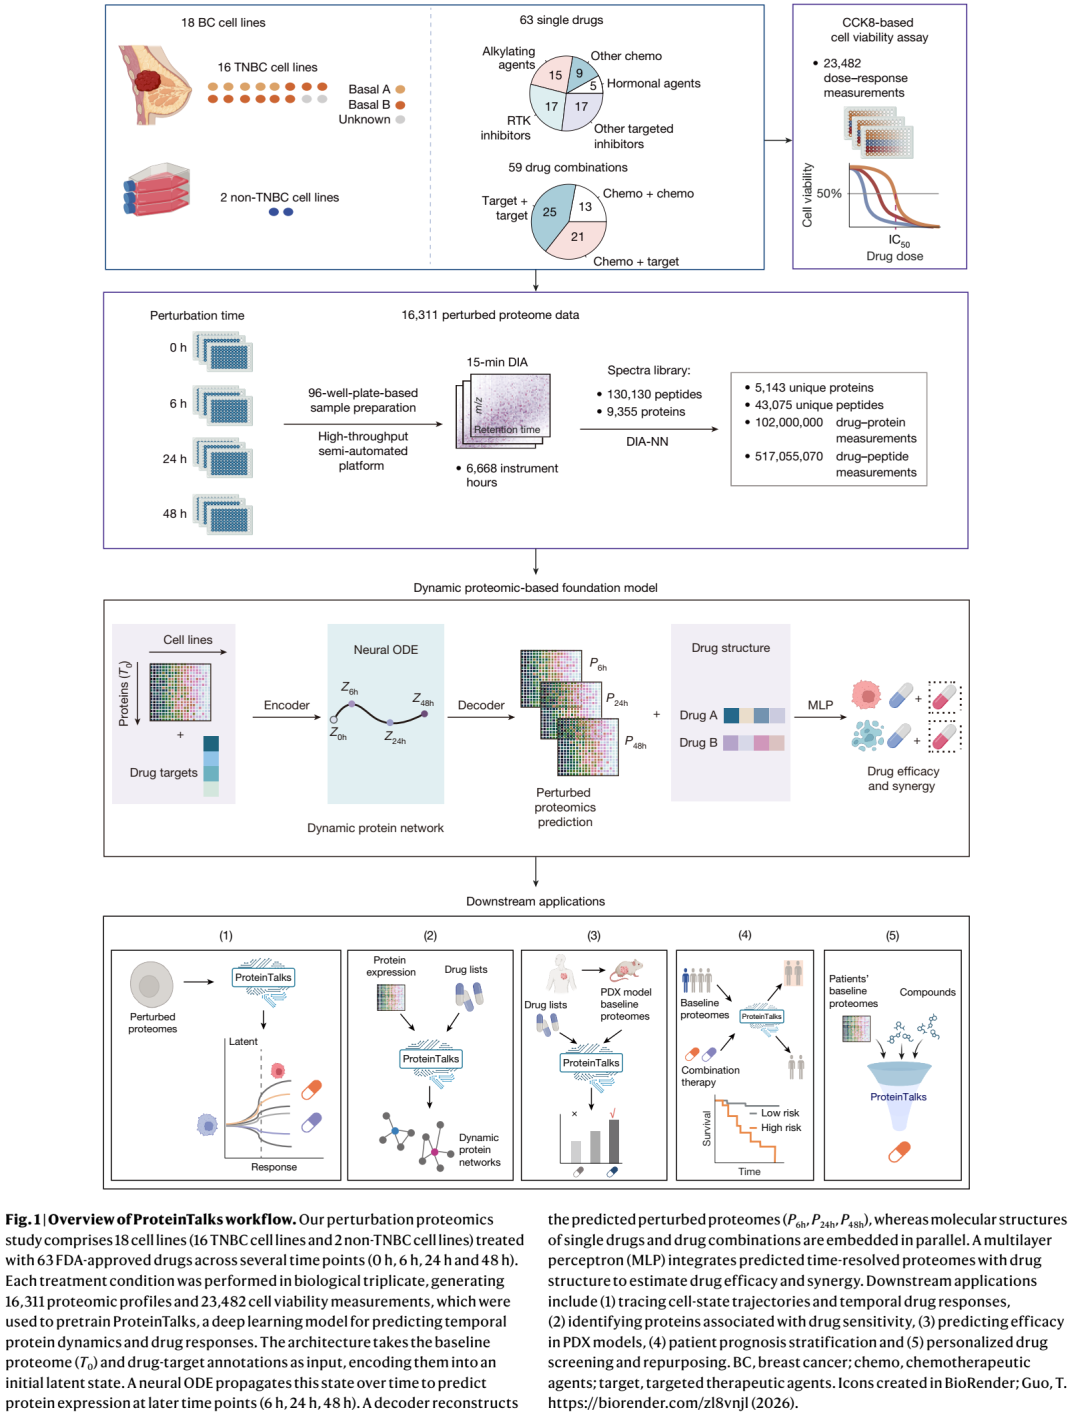
图 1:ProteinTalks 整体工作流程。是整篇论文的总地图,值得花两分钟细看。上半部分从左侧的 18 株细胞系出发,经过 63 个单药(按烷化剂、微管抑制剂、激素类、RTK 抑制剂等分类)与 59 个组合,在 0/6/24/48 小时取样,进入 96 孔板半自动样品制备 + 15 分钟 DIA 质谱流程,最终产出 16,311 份扰动蛋白质组和 23,482 个剂量反应测量值;中间是核心的动态蛋白质组基础模型——基线蛋白 P0h 与药物靶点一起进 Encoder,经神经 ODE 积分到 6/24/48 小时的潜状态 Z,再由 Decoder 还原为预测的蛋白组 P6h/P24h/P48h,右侧并行地把药物 A/B 的分子结构嵌入进来,与预测蛋白组一起喂给 MLP,输出药效与协同性;最下方一排是五个下游应用。
注意图 1 中间那句话:"Dynamic protein network"(动态蛋白网络)。这篇论文真正想卖的,不是又一个预测器,而是一个"网络是随时间重连"的世界观。
03 3800 万条测量是怎么"熬"出来的
做 AI 的人习惯了 ImageNet 那种"数据在网上、下载就行"的世界。做蛋白质组学的人没有这种福气——每一个数据点都是肽段、液相、质谱、机时和钱。
论文的规模是这样的:18 株细胞系 × 63 个 FDA 批准药物 × 59 个组合 × 3 个时间点 × 生物学三重复,产生 16,311 个 DIA-MS 数据文件,DIA-NN 分析后得到 5,585 个蛋白组、超过 3800 万条蛋白测量;配套 23,482 个细胞活力测量。Fig. 1 里还标了两个很吓人的谱库数字:约 9,355 个蛋白、130,130 条肽段,以及 5,143 个独特蛋白、43,075 条独特肽段——这是"建库"层面的规模,比实际定量的 5,585 个蛋白组厚得多,也正是高通量 DIA 的底气所在。
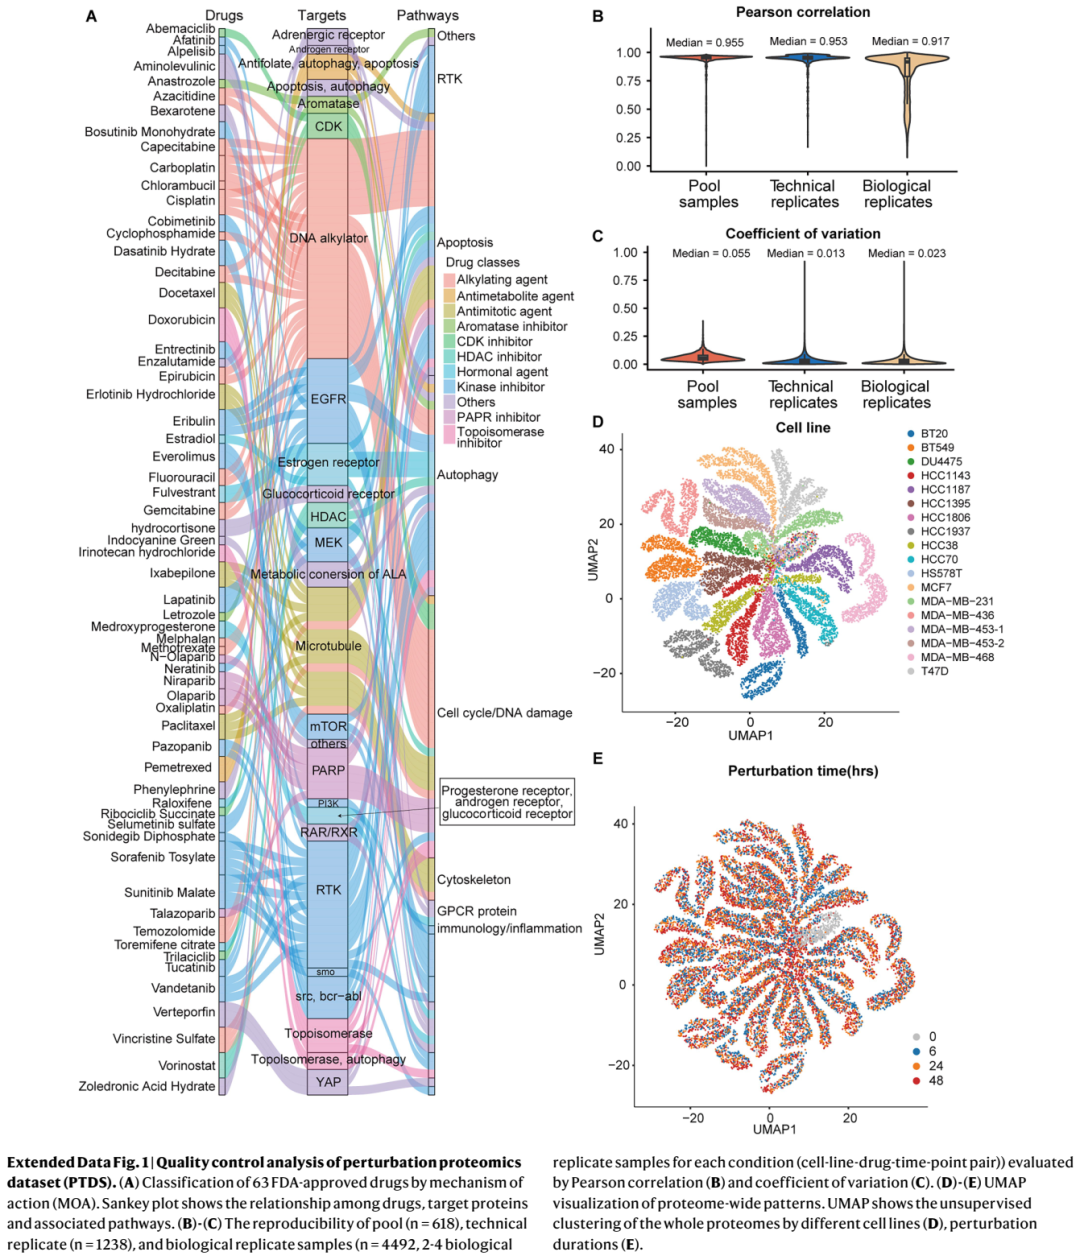
扩展数据图 1:PTDS 数据质控与药物分类。是这份资源的"体检报告"。A 面板用 Sankey 图把 63 个药物、靶蛋白与通路的关系串起来,一眼能看出这些药覆盖了 DNA 损伤修复、微管、激素受体、RTK 等主要通路簇;B、C 面板给出混合样本(n = 618)、技术重复(n = 1238)与生物学重复(n = 4492)的 Pearson 相关与变异系数——这是质谱圈判断数据能不能用的硬指标;D、E 面板的 UMAP 显示,全蛋白组既能按细胞系分开(D),也能按扰动时长分开(E)。换句话说:细胞系身份和"被处理了多久"这两个信号,都比噪声大得多。
这里有个值得学的设计选择。已有扰动转录组研究通常在给药后 6–24 小时取样;作者认为蛋白层面存在"转录到翻译"的滞后,于是先做了一个"先导实验":在 3 株细胞系、55 个单药与 57 个组合上,测了 0、2、4、6、8、10、12、24、36、48、60 小时共 11 个时间点,得到 2,528 份样本的 mtPTDS 数据集。
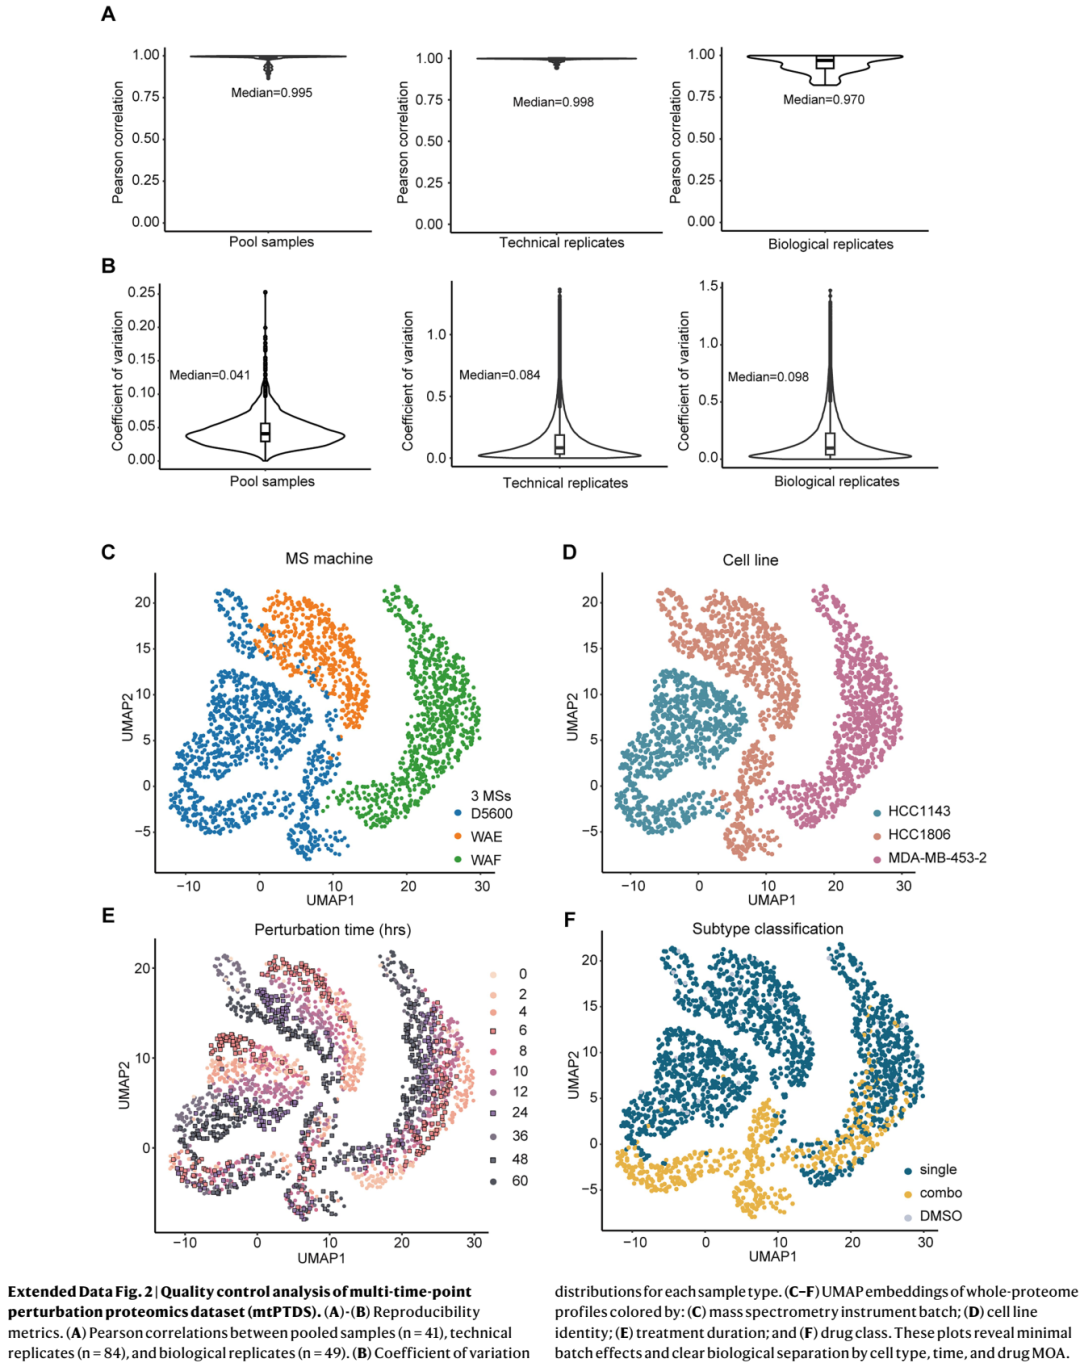
扩展数据图 2:多时间点数据集 mtPTDS 的质控。给出了这个先导实验的质控与结构。A、B 面板显示混合样本、技术重复、生物学重复的相关性与变异系数都相当漂亮;C–F 面板的 UMAP 分别按仪器批次、细胞系、处理时长和药物类别着色——按批次着色几乎看不出结构(说明批次效应被压住了),按时长、细胞系、药类着色则分得一清二楚。这正是作者敢选时间点的依据。
结果很有意思:UMAP 上蛋白组按采样时间自动聚成三团——早期(0/2/4/6 小时)、中期(8/10/12/24 小时)、晚期(36/48/60 小时)。于是他们只取 6、24、48 小时三个点加 0 小时基线,就把早、中、晚三个阶段的蛋白响应都覆盖住了。
这个决策节约了多少资源?如果不做先导实验、直接上 11 个时间点,样本量会是现在的三倍多,机时会奔着两万小时去。先花小钱搞清楚"时间轴该在哪几处下刀",再花大钱铺开——这是非常典型、也非常值得 AI 同学学习的实验设计思维:数据不是越多越好,而是要在正确的维度上有分辨率。
04 先别急着建模:让数据自己开口说话
很多 AI 论文的习惯是:数据一到手,立刻上模型。这篇论文让人舒服的地方在于,它先花了整整一节做"数据自证"——不靠模型,先看数据本身有没有生物学信号。
第一个证据:扰动蛋白组能反映药物的作用机制(MOA)。
作者在 63 个药物里鉴定到了 61 个蛋白靶点,占全部药物靶点的 48.8%。最有故事的是 TYMS(胸苷酸合成酶)——它是卡培他滨活性代谢物的经典靶点。数据显示,在卡培他滨耐药细胞里,TYMS 的蛋白量随着处理时间逐步升高;而在 HCC1143 细胞中敲低 TYMS,细胞对卡培他滨重新敏感了。
这一来一回,就把"相关性"推到了"因果性"的门口:蛋白组的时间轨迹,可以自己指出耐药机制。
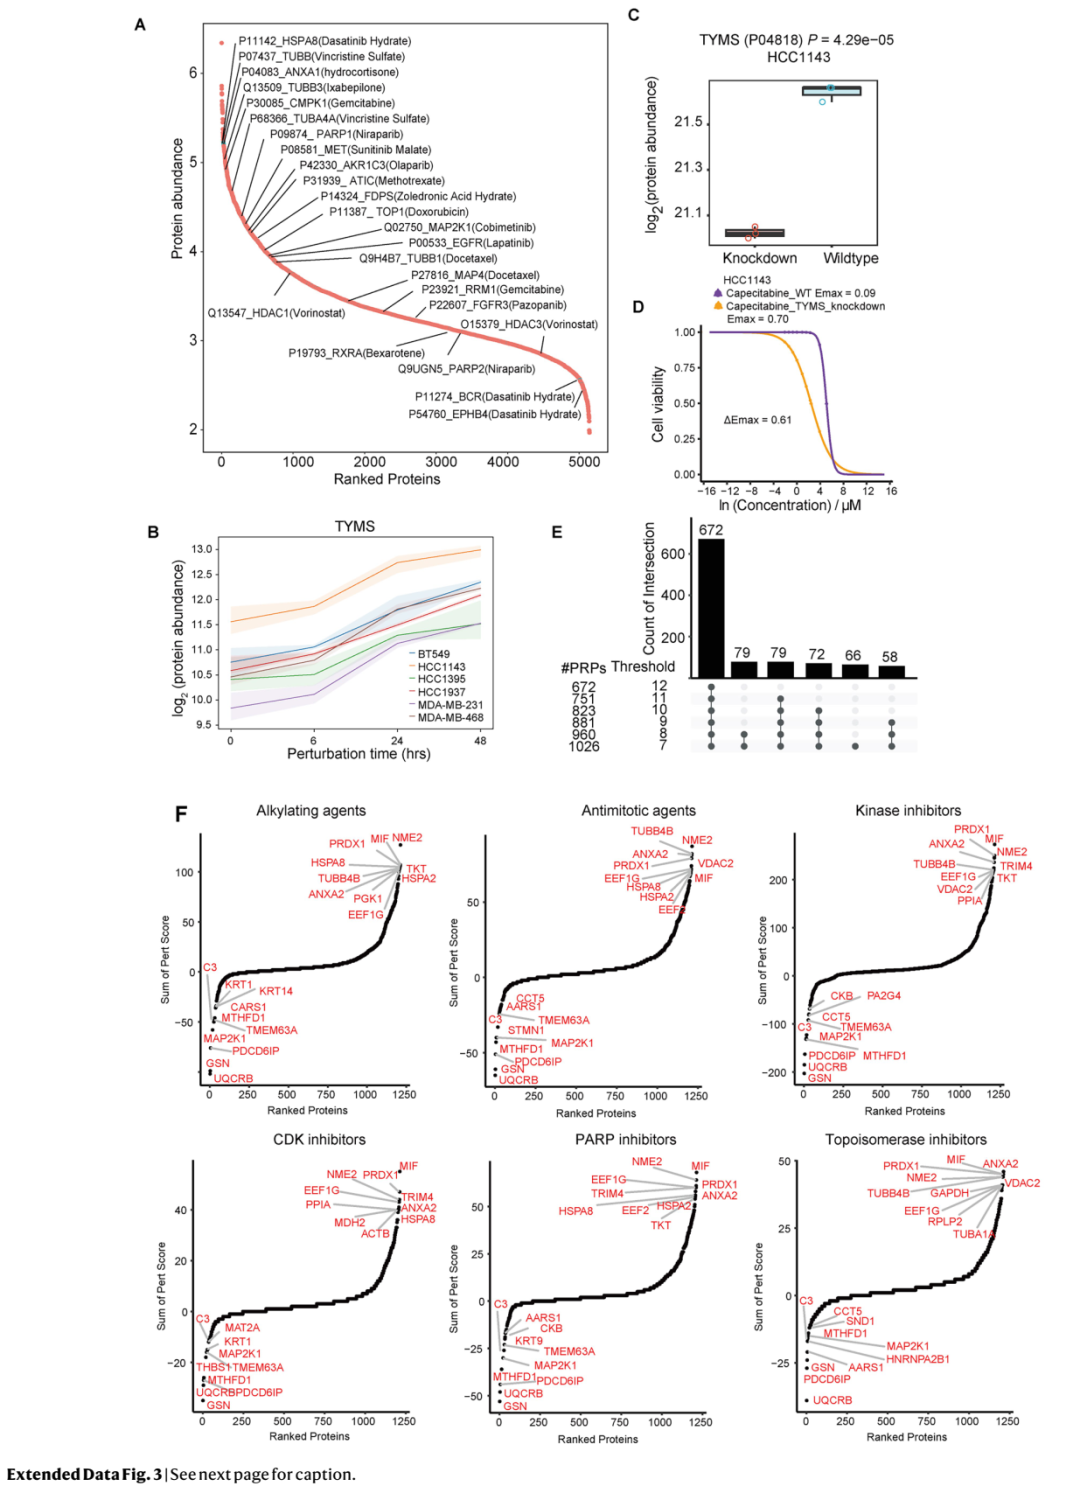
扩展数据图 3:扰动打分 PertScore 与 TYMS 功能验证。把这条线索铺开。A 面板列出鉴定到的药物靶点;B 面板是 TYMS 蛋白随时间的表达曲线(log2 丰度 ± s.e.),耐药组一路向上;C、D 面板是 siRNA 敲低效率和剂量反应曲线,敲低后卡培他滨敏感性显著回升;E 面板是 PertScore 阈值敏感性分析——在 7、8、9、10、11、12 这六个阈值下,鉴定到的扰动相关蛋白有 82% 是重合的,说明这个指标并不依赖主观截断;F 面板按药物类别展示扰动打分分布。
顺着这条线,作者定义了一个叫 PertScore 的扰动打分,用来量化蛋白在扰动下的变化强度,并筛出 823 个扰动相关蛋白(PertScore ≥ 10,FDR < 0.05)。
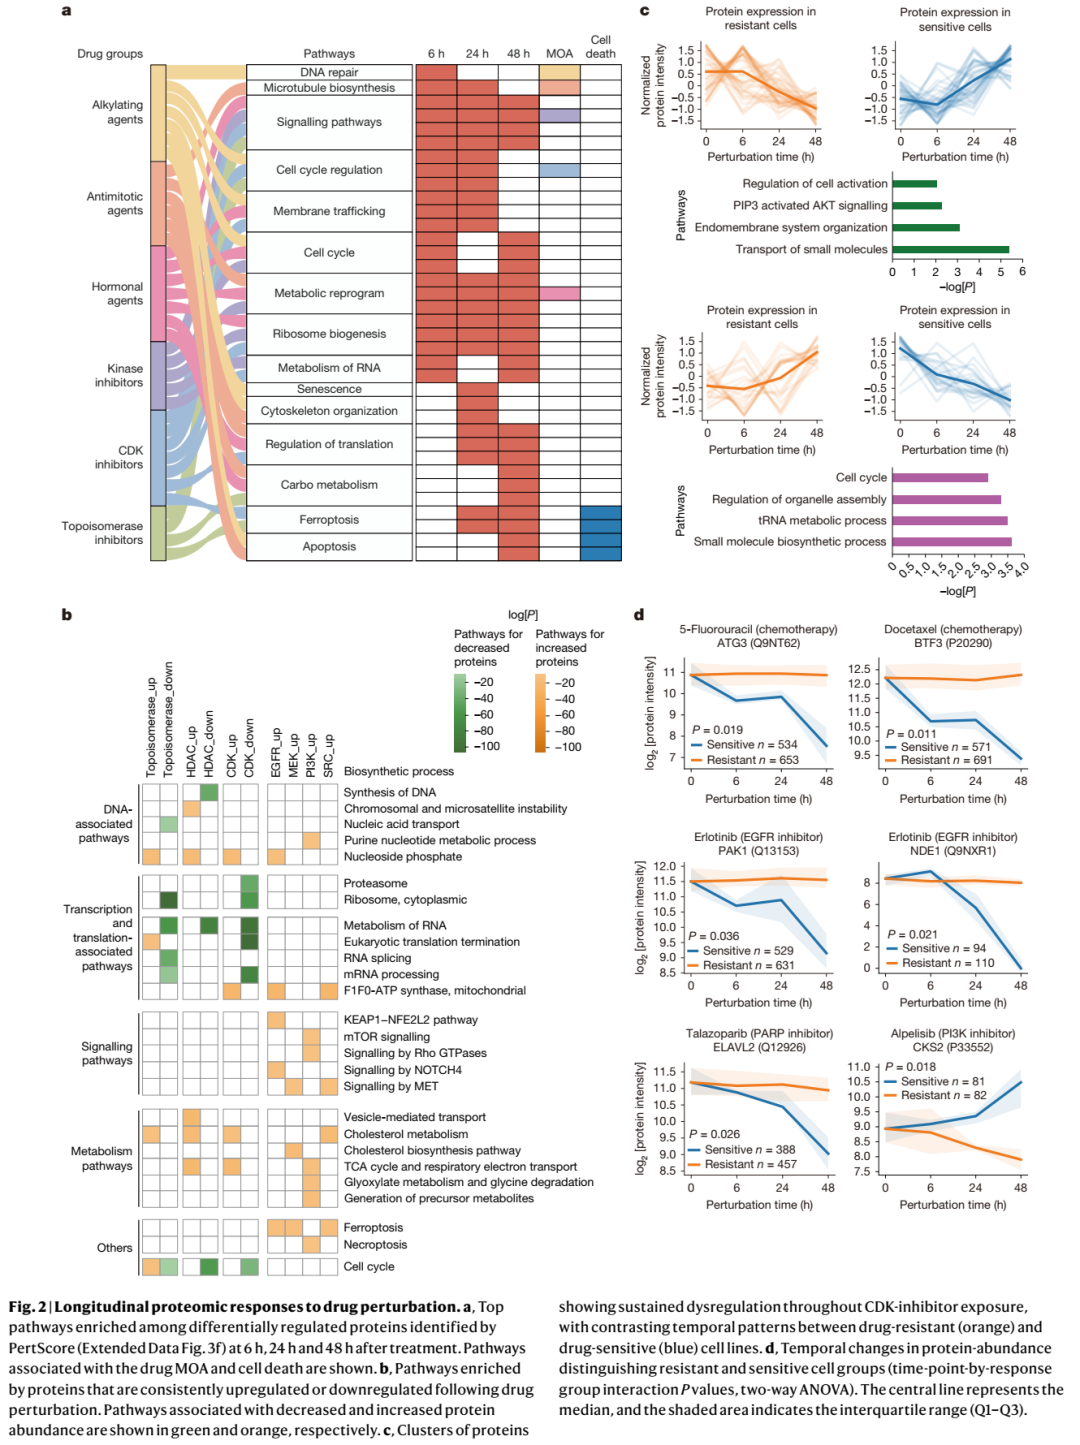
图 2:药物扰动的纵向蛋白质组响应。是这一节的视觉核心,也是我最想在组会上逐格讲的一张图。a 面板展示这些扰动相关蛋白在 6、24、48 小时富集的通路:6 小时富集的是 MOA 相关通路(DNA 修复、微管、信号通路、细胞周期调控等),48 小时富集的则是细胞死亡相关通路。这张图几乎是一句生物学常识的定量版本——细胞先"知道自己被打中了哪里",48 小时后才"决定去死"。烷化剂主要扰动 DNA 损伤修复、激素疗法改写代谢重编程、微管抑制剂重塑细胞骨架、CDK 抑制剂搅动细胞周期,全都对得上教科书。
b 面板用 mFuzz 模糊聚类,把每类药下持续上调/下调的蛋白收敛成通路:化疗药和靶向药都会升高核酸合成与脂肪酸代谢相关蛋白、降低 RNA 加工与细胞周期相关蛋白;激酶抑制剂则特异性上调 MET、NOTCH4、mTOR 信号。
c、d 面板则是我认为全篇最"值钱"的一张:耐药组与敏感组的蛋白时间轨迹是分叉的。 63 个蛋白在 CDK 抑制剂耐药组与敏感组之间呈现差异动态(ANOVA,P < 0.05),其中 41 个在耐药组随时间上调、在敏感组下调(富集于细胞周期、蛋白定位、嘌呤核糖核苷酸代谢、碳代谢),另外 22 个方向相反(富集于小分子转运、内膜系统组织、AKT 信号)。
落到具体药物,故事就更有味道了。5-氟尿嘧啶处理下,ATG3 在 48 小时出现最大分歧(倍数变化 0.15),而 ATG3 是自噬相关蛋白——自噬增强导致化疗耐药,这条文献里的老故事,在这里被蛋白组自己讲了一遍。多西他赛处理下是 BTF3(0.12 倍),而 BTF3 关联肿瘤干细胞样状态;厄洛替尼处理下是 PAK1(0.21 倍)与 NDE1(敏感组直接未检出),前者激活 AKT 通路、后者与 EGFR 互作;PARP 抑制剂 talazoparib 下是 ELAVL2(0.30 倍差异),牵出糖酵解重编程;而 PI3K 抑制剂 alpelisib 下的 CKS2 则反向——敏感组高、耐药组低,48 小时最大差异 7.71 倍。
读到这里,你大概能体会作者为什么强调"time-resolved"。如果只测 48 小时一个终点,你看到的是一张静态的差异表;测了三个时间点,你看到的是耐药细胞"如何一步步把通路改写掉"的过程片。 对做表示学习的人来说,前者是样本,后者是轨迹——轨迹里才藏着动力学的因果线索。
05 AI 内核:不是把 ODE 当装饰,而是让动力学去塑造表示
终于到了模型部分。这一节我会讲得比论文细一点,因为这个架构的选择里藏着的思路,对做 AI 的人最有迁移价值。
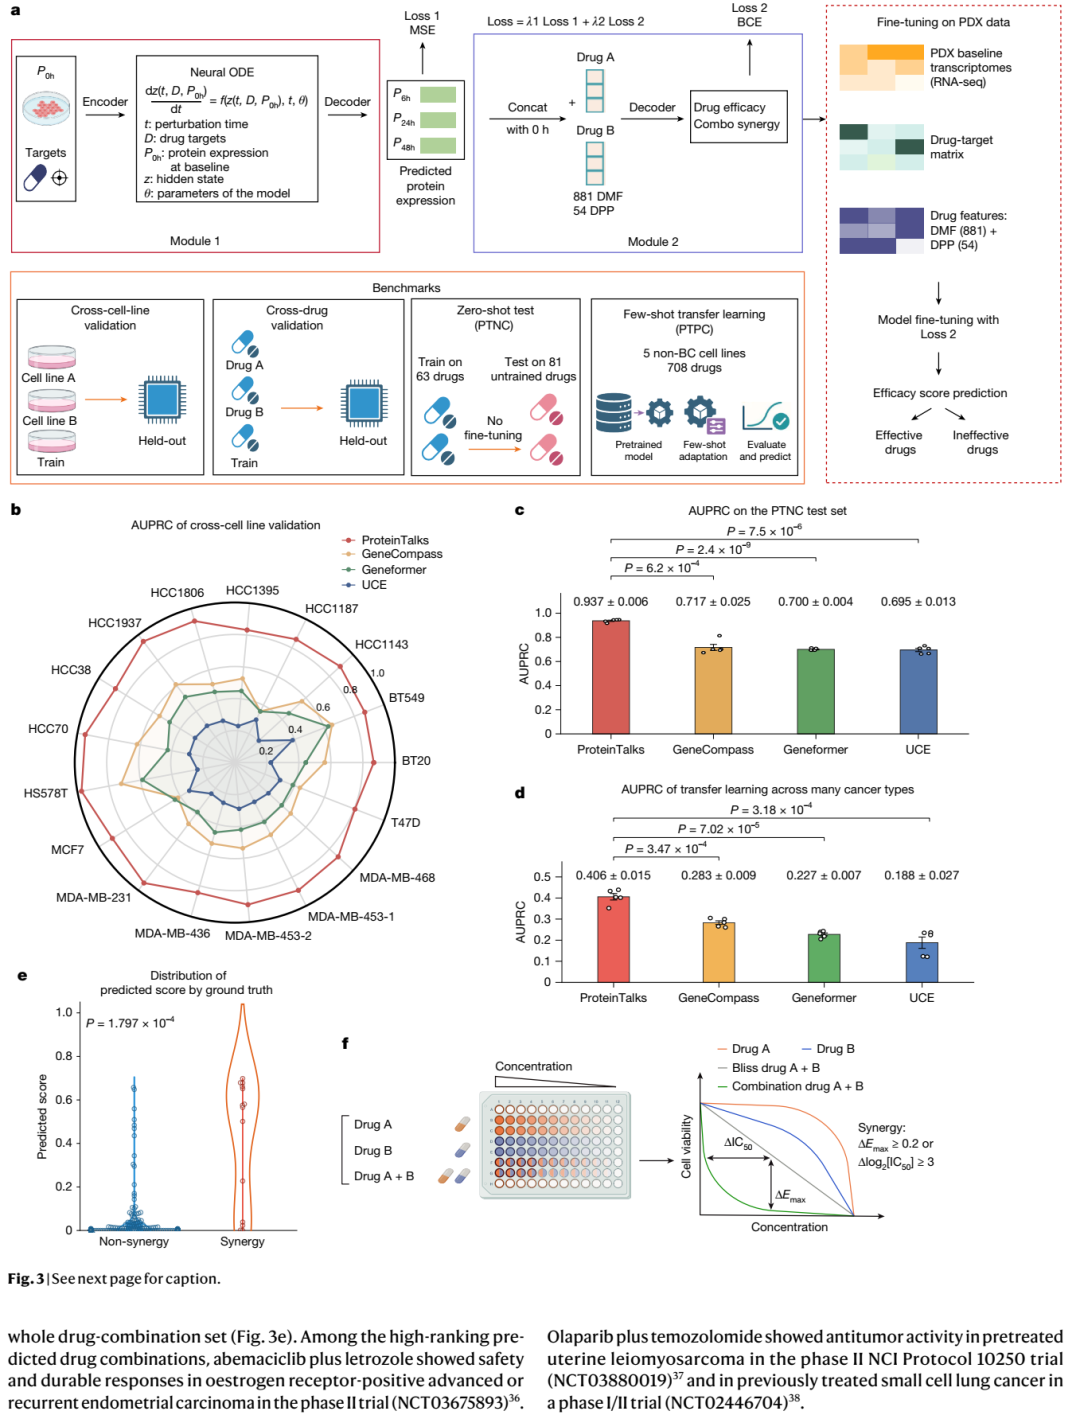
图 3:ProteinTalks 架构、训练策略与基准评测。是模型的完整画像。a 面板:Module 1(左,红色)用神经 ODE 从基线蛋白组 P0h 和药物靶点注释出发生成时间分辨的扰动蛋白组,损失是重建 MSE;Module 2(中,紫色)把药物分子指纹 DMF(881 维)、药物理化性质 DPP(54 维)、P0h 以及 Module 1 预测的三个时间点蛋白组,拼起来送进卷积网络 C3 映射到 32 维,再与药物 SMILES 特征(935 维 × 2 → C4 → 32 维)融合,经过 L5/L6 输出药效或协同概率,损失是 BCE;总损失 L = (1 − λ)·L_pro + λ·L_pheno,λ = 0.8。b–d 面板是评测结果,下面会细讲;e 面板是协同分数在真实协同(n = 14)与非协同(n = 384)组合上的分布,P = 1.797 × 10⁻⁴;f 面板是实验验证流程示意。
拆开看几个很"工程"却很关键的决策。
输入侧:把蛋白当作"序列位置",但用逐点卷积而不是全连接。 作者把 5,585 个蛋白排成一个轴,先用一个线性层把 [P0h, D] 映射到每蛋白 32 维,再用 kernel size = 1 的一维卷积(C1)升到 64 维。为什么是 1×1 卷积而不是全连接?论文说得很明白:参数量与蛋白数量解耦,并且每个蛋白的嵌入只依赖它自己的特征,不去和"邻居"混合——因为蛋白在轴上的排列本来就没有序列含义,让模型去学"相邻蛋白"的卷积核是没有意义的归纳偏置。
这是一个很漂亮的"负责任的归纳偏置"案例:不是所有结构都该建模,有些结构必须明确地"关掉"。
动力学侧:用两层小网络参数化向量场,RK4 积分。 初始条件 z0 = C1(基线状态与扰动描述符的联合嵌入),然后 dz/dt = fθ(z(t), t, D),用四阶 Runge–Kutta 在 {0, 6, 24, 48} 上求解,得到三个未来时刻的嵌入;再由卷积解码器 C2 降回 32 维、线性层 L4 还原到蛋白空间,得到 P̂6h / P̂24h / P̂48h。
请特别注意这里的建模哲学与 PRESCIENT、TrajectoryNet、DeepRUOT 那类方法的差别。后者大多是在预先定义好的潜空间里(常常是 PCA 嵌入)做插值或最优传输——潜空间是先定的,轨迹是在里面走的。ProteinTalks 反过来:扰动条件下的轨迹本身参与塑造潜表示。用论文的话说,"dynamics themselves shape the learned representation"。
这两句话看起来差不多,其实差了一个方法论世代。前者是"先压缩,再插值";后者是"边演化,边学习压缩什么"。从机器学习理论上看,后者把时间连续性做成了一种正则——模型必须找到一组坐标,使得在这组坐标下,成千上万条不同药物、不同细胞系的蛋白轨迹都服从同一个光滑向量场。能被同一个向量场解释的表示,天然更可能抓住"机制"而不是"快照"。
顺带说一句,这也是鄂维南(Weinan E)老师作为共同作者出现在这篇论文里时,我最期待看到的那种思路——用动力系统的语言去重新表述表示学习,而不是把动力系统当成一个花哨的插件。
训练侧的细节也值得抄进你的实验记录本: batch size 64;AdamW,初始学习率 5 × 10⁻⁴,权重衰减 1 × 10⁻⁴;ReduceLROnPlateau 调度;早停耐心 500 个验证 epoch,进入 SWAG(随机权重平均-高斯)阶段后放宽到 1000;SWAG 阶段在学习率降到初始值 20% 以下时启动,固定学习率 5 × 10⁻⁴,每轮收集快照,最多存 20 个模型用于协方差估计;随机种子 1995。超参搜索扫了 hidden width {32, 64, 128}、dropout {0, 0.1, 0.2}、优化器 {SGD, AdamW}、学习率 {1e−4, 5e−4}、batch size {64, 128},共 35 次训练;最优单配置(AUROC 0.927)是 AdamW + 5e−4 + hidden 64 + batch 64 + dropout 0。
注意 SWAG 的使用。在一篇要上临床应用的论文里,给预测加上不确定性估计,并且用权重平均提升鲁棒性——这是很"AI for Science 老手"的做法。做交叉学科的同学请记住:你的模型会被放进实验流程里,输出的不只是一个数,而是别人要不要花三个月做一个实验的依据。
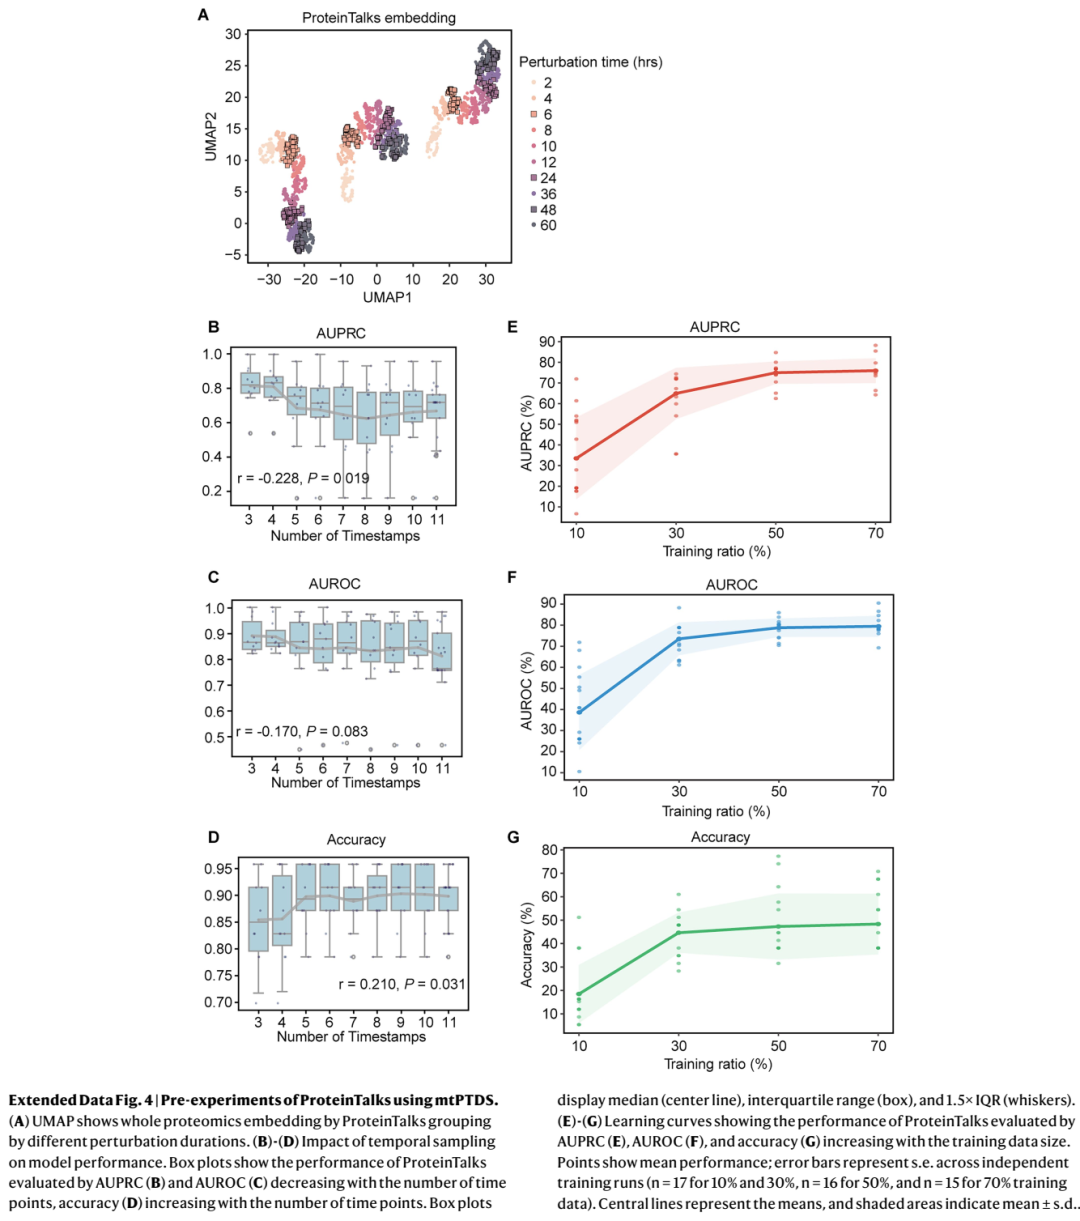
扩展数据图 4:时间点选择与学习曲线。回答了两个审稿人一定会问的问题。A 面板是 ProteinTalks 学到的全蛋白组嵌入按扰动时长着色的 UMAP——模型自己把时间排成了一个有序的渐变,说明它真的编码了时间的演化方向。B–D 面板是时间点数量的消融:时间点变多,准确率小幅上升(P = 0.03),AUPRC 反而下降(P = 0.02)——典型的判别力与精确率-召回率之间的权衡,作者据此定下四个时间点。E–G 面板是学习曲线:训练数据从 10% 增加到 70%,AUPRC、AUROC、准确率都还在单调上升,没有看到明显的平台。
那条没有出现平台的曲线,我认为是整篇论文里最意味深长的一张图。它意味着:这个方向的上限,目前主要被数据规模而不是被架构卡住。 对正在找选题的博士生来说,这句话的含金量,懂得都懂。
06 四道泛化考题:它到底"学会了"还是"记住了"
模型的评测设计,是这篇论文我认为做得最扎实的部分。作者没有只报一个漂亮的整体指标,而是拆成四道递进的考题。
第一道:跨细胞系(留一细胞系)。 在 17 个可评估细胞系上,ProteinTalks 取得平均 AUPRC 0.89、AUROC 0.95、准确率 0.90,超过了 7 个基线——包括 GeneCompass、Geneformer、UCE 三个转录组基础模型,以及 bagging、KNN、随机森林、DeepSynergy 四个传统机器学习方法。相对这些基线,AUPRC 提升 10%–221%,AUROC 提升 4%–98%,准确率提升 3%–21%。图 3b 的雷达图上,那条红线几乎在所有细胞系方向上都压着其他三条线。
第二道:跨药物(留一药)。 这是更难的一档——62 个单药各自留出作为测试。结果 AUPRC 0.57、AUROC 0.64、准确率 0.76;比转录组基础模型在 AUROC 上高 13%–23%,准确率高 24%,比传统机器学习在准确率上高 12%–22%。指标明显低于跨细胞系那一档,这很诚实:从"没见过的细胞"泛化,比从"没见过的药"泛化容易,因为药物化学结构是全新的输入空间。
第三道:零样本到未训练化合物(PTNC)。 作者额外构造了一个独立数据集:4 株 TNBC 细胞系、81 个 PTDS 里完全没出现过的抗癌化合物、2,076 个剂量反应测量,过滤后得到 173 个高可信药物–细胞系组合。冻结模型直接推理,结果是 AUPRC 0.94、AUROC 0.89、准确率 0.85;而 Geneformer 是 0.70 / 0.51 / 0.31,GeneCompass 0.72 / 0.53 / 0.42,UCE 0.71 / 0.50 / 0.31。平均提升幅度:AUPRC 32%、AUROC 73%、准确率 150%。
准确率提升150%——这个数字要结合基线一起看才有意义:Geneformer 在这个任务上的准确率是 0.31,基本是"比抛硬币好一点"。这不是说 Geneformer 不好,而是说用转录组快照的嵌入去做跨化学空间的药效外推,本身就是它的训练目标里没有的东西。模态选错了,参数再多也没用。
第四道:少样本迁移到其他癌种(PTPC)。 5 株非乳腺癌细胞系——黑色素瘤 A375、结直肠 HCT116、肺 NCI-H1975 与 NCI-H2170、胰腺 Panc 10.05——暴露在 708 个已上市或在研化合物下,测 6 与 24 小时的蛋白组,共 2,307 份样本(去除质控与重复后 2,021 份独立样本),定量 5,171 个蛋白。ProteinTalks 取得 AUPRC 0.41、AUROC 0.77,对应地超过 Geneformer(0.23 / 0.56)、GeneCompass(0.28 / 0.72)、UCE(0.19 / 0.54),AUPRC 提升 74%、AUROC 提升 28%。
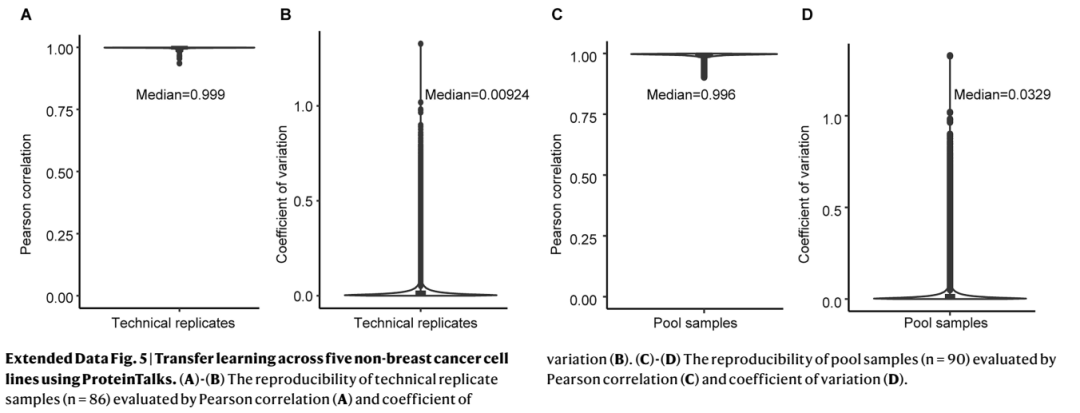
扩展数据图 5:五种非乳腺癌细胞系的迁移学习数据质控。给出 PTPC 的质控:技术重复(n = 86)与混合样本(n = 90)的 Pearson 相关与变异系数。这类图通常没人看,但它决定了上面那组"跨癌种"数字的含金量——如果跨癌种的数据本身不可重复,迁移结果再漂亮也是空中楼阁。
顺便补一句联合用药。作者在 PTDS 覆盖的 914 个"组合–细胞系"元组之外,枚举了 63 个化合物构成的所有 1,953 个两药组合 × 18 株细胞系 = 35,154 个元组,让冻结的模型逐一打分。预测协同分在实验判定为协同(n = 14)与非协同(n = 384)的组合之间差异显著(图 3e,P = 1.797 × 10⁻⁴)。然后他们挑了四个高分组去做湿实验验证:bosutinib + tucatinib 在 HCC1395(ΔEmax = 0.31)与 HCC1143(ΔEmax = 0.28)、bosutinib + abemaciclib 在 HCC70(ΔEmax = 0.39)与 HCC1806(ΔEmax = 0.74),四个全部达到预设协同标准(ΔEmax ≥ 0.2 或 Δlog2[IC50] ≥ 3)。
更有意思的是模型高分组合里,abemaciclib + letrozole 的组合此前已在雌激素受体阳性晚期/复发性子宫内膜癌的 II 期试验中显示出安全性与持续缓解(NCT03675893),奥拉帕利 + 替莫唑胺的组合也在子宫平滑肌肉瘤(NCT03880019)与经治小细胞肺癌(NCT02446704)中显示活性。模型打出的高分,与别人花几年做的临床试验撞在了同一个组合上——这比任何 AUC 数字都有说服力。
07 可解释性:让 SHAP 长出时间轴
到目前为止,我们看到的还是一个"更准的预测器"。这篇论文真正从"预测"跨到"可操作",靠的是可解释性这一节。
常规 SHAP 问的是:"哪些特征贡献了这个预测?"它是一个静态的、针对单个输出的归因。作者问了一个更难的问题:"在给药后的第 6 小时、第 24 小时、第 48 小时,哪些基线蛋白正在驱动模型对未来蛋白组的预测?这个驱动关系又是怎么随时间变化的?"
他们称之为 dynamical SHAP:以治疗前蛋白组(t = 0)为输入,让模型生成 t ∈ {6, 24, 48} 小时的预测蛋白丰度向量,对每个 t 计算每个输入蛋白对每个输出蛋白的归因,得到一个带时间索引的归因矩阵 Φ(t) = {ϕ_i(→t_j)}。为了让解释具有"对比性",他们用 SHAP 的 PermutationExplainer,背景集取自同一药物类别但标签相反的样本——正样本用匹配的负样本做背景,反之亦然。
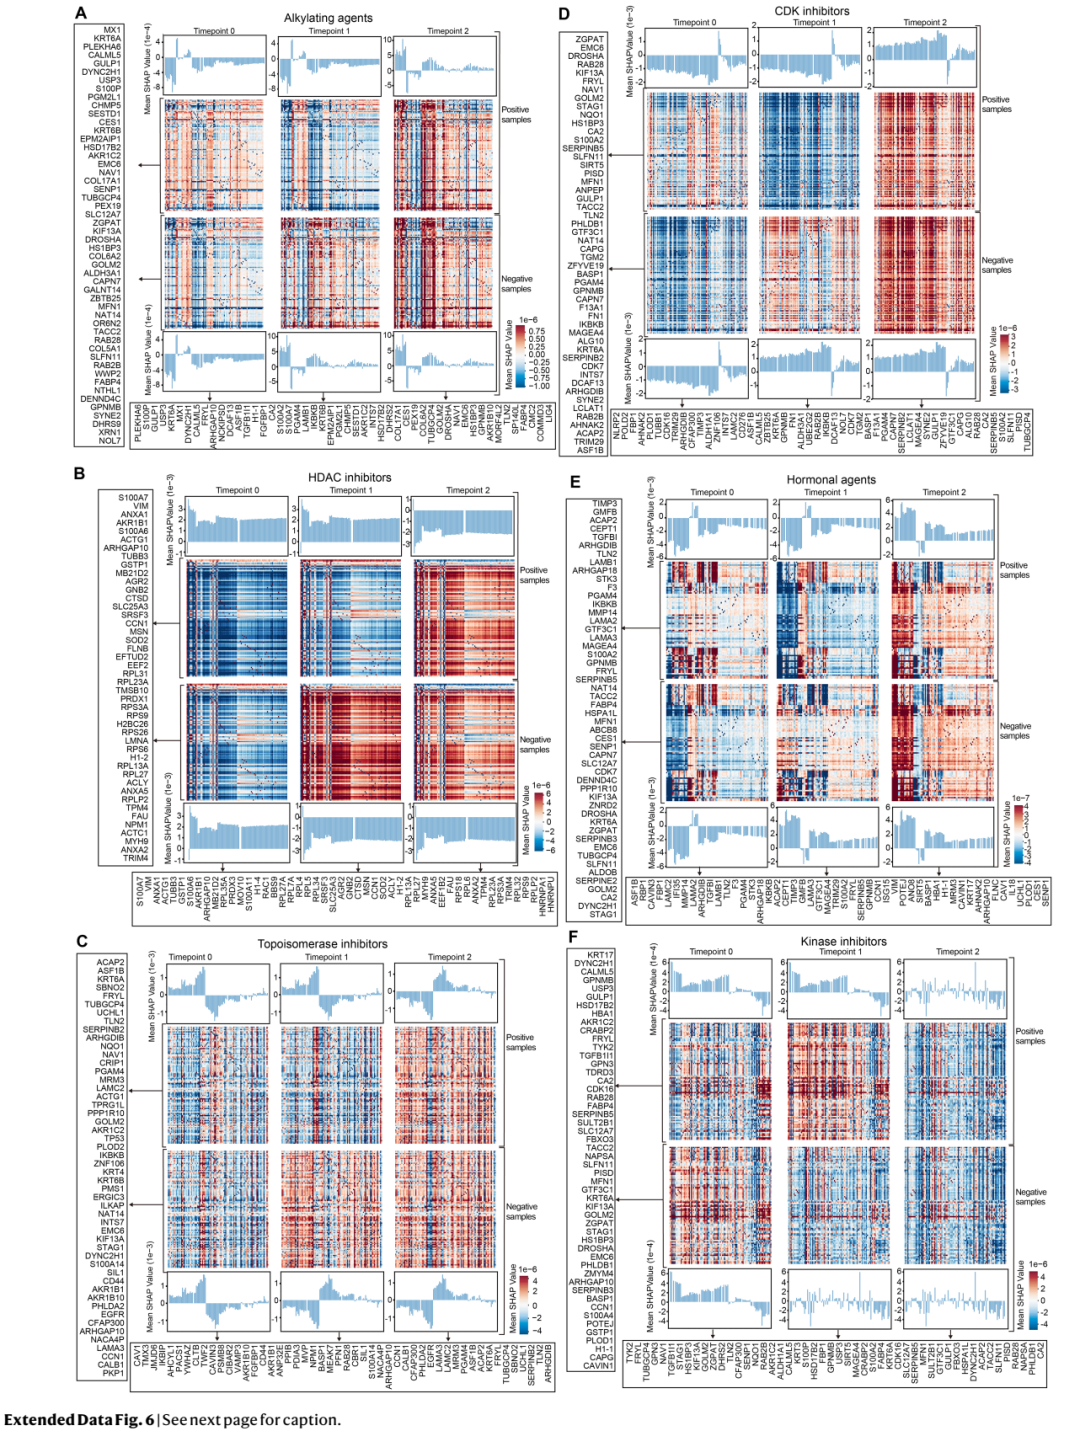
扩展数据图 6:六类药物的动态 SHAP 图谱。展示了这个设计的产出:对烷化剂、HDAC 抑制剂、拓扑异构酶抑制剂、CDK 抑制剂、激素类药物、激酶抑制剂六类药,列出对药效预测影响最大的蛋白及其影响对象,颜色表示 SHAP 值大小,柱状图给出逐列 SHAP 值之和。结果出现了非常整齐的"药物类别签名":烷化剂、HDAC 抑制剂和拓扑异构酶抑制剂在 6 小时几乎不分叉,到 24 小时才明显分离——DNA 损伤与表观遗传重塑需要经过调控级联,蛋白层面的"迟到"是合理的;而 CDK 抑制剂、激素类药物和 RXR 抑制剂在 6 小时就已经明显分叉——信号通路的蛋白响应本来就更即时。
这条发现单看是生物学常识,但从模型里自己长出来,意义完全不同:它说明模型学到的潜轨迹,确实对应着真实的、有药物类别特异性的动力学。
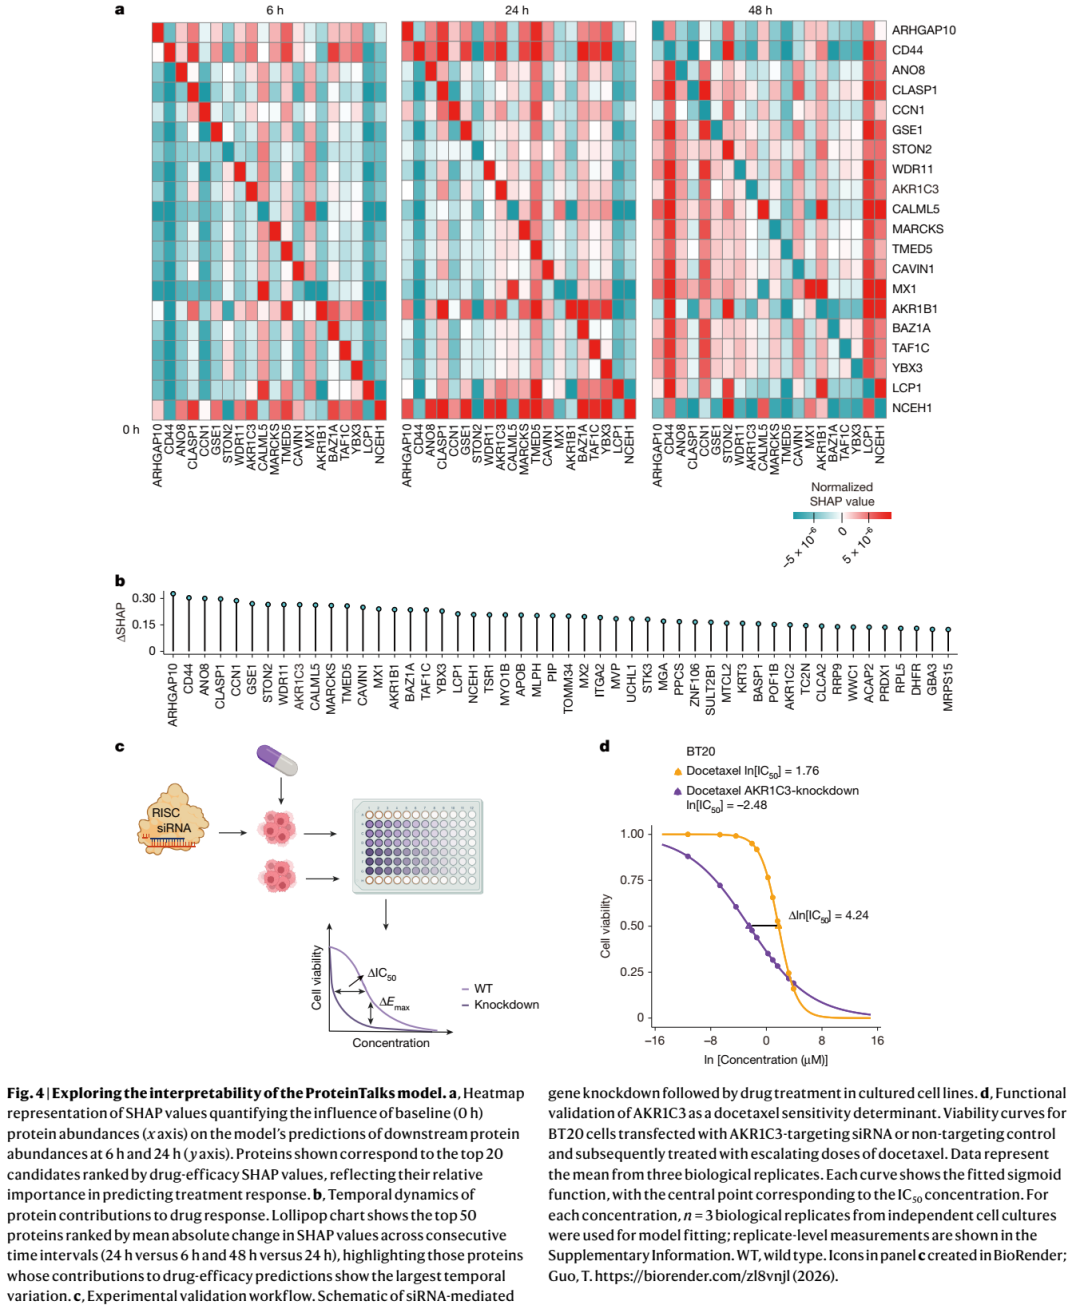
图 4:ProteinTalks 模型的可解释性探索。把可解释性推到了实验台。a 面板是归因热图:横轴是基线(0 小时)蛋白丰度,纵轴是模型对 6 与 24 小时蛋白丰度的预测,展示的是按药效 SHAP 值排名前 20 的蛋白如何"从基线出发驱动未来"。b 面板是时间动态棒棒糖图:按相邻时间点之间 SHAP 值的平均绝对变化(24h vs 6h、48h vs 24h)排出前 50 个蛋白,也就是"贡献变化最剧烈"的那些角色。c 面板是 siRNA 敲低 + 给药的实验流程。d 面板是功能验证:在 BT20 细胞中敲低 AKR1C3 后,多西他赛的 ln[IC50] 从 1.76 降到 −2.48,Δln[IC50] = 4.24,细胞活力曲线整体左移。
AKR1C3 这个例子很能说明问题。它不是教科书里的微管相关蛋白,而是醛酮还原酶家族成员——一个"做代谢的"蛋白。模型却把它列为抗微管药物响应最重要的蛋白之一。作者敲低它,细胞真的对多西他赛敏感了。
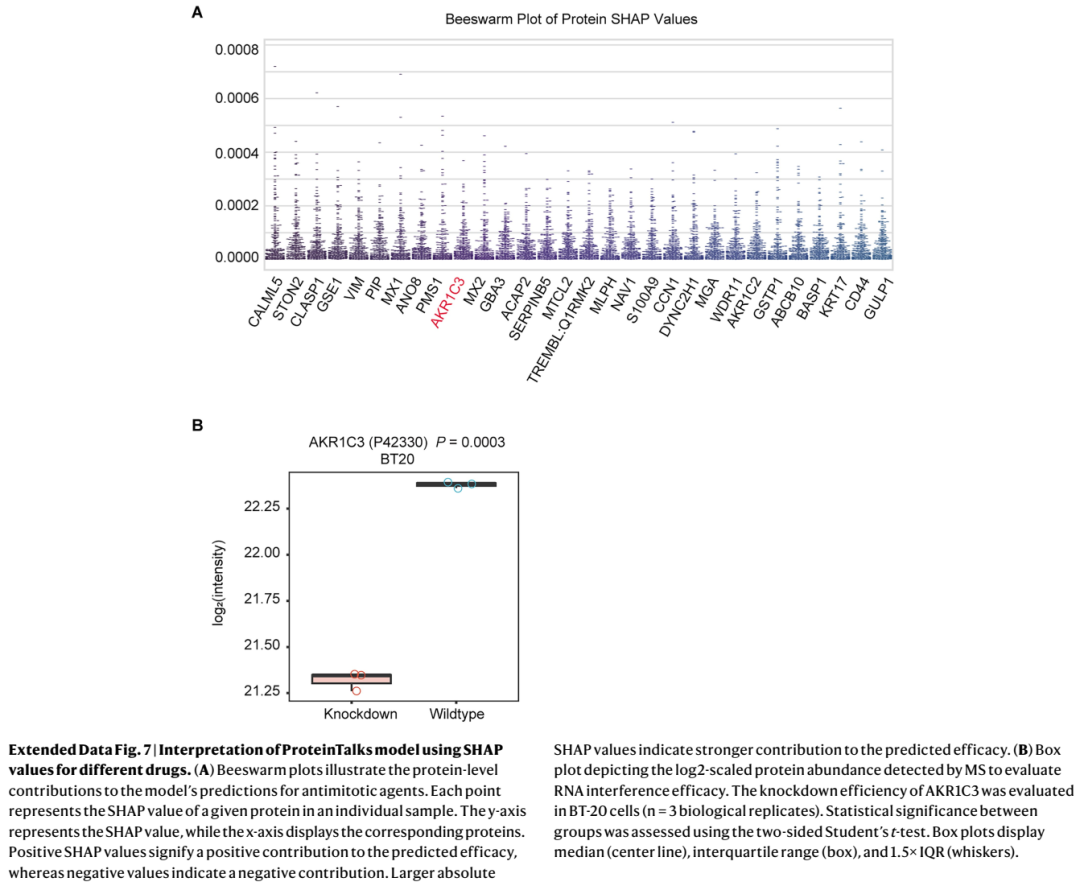
扩展数据图 7:SHAP 解释与敲低效率验证。补充了细节:A 面板是抗微管药物下蛋白层面 SHAP 贡献的蜂群图,每个点是一个样本中某个蛋白的 SHAP 值,正值表示正向推动药效预测;B 面板是质谱检测的 AKR1C3 敲低效率箱线图(n = 3 生物学重复),确认敲低是真的敲下来了。
更让我兴奋的是论文里的另一句话:在模型排名前 100 的蛋白中,有一批在肿瘤中功能表征很有限的蛋白,比如 ZFYVE19、SYNE2 以及一些锌指蛋白,共 18 个化疗相关蛋白。对做 AI+生物的人来说,这才是"可解释性"的最高形态:模型不是复述已知生物学,而是给你一份"值得去做实验的未知清单"。
08 走出培养皿:PDX、501 例活检与患者类器官
做细胞系做得再漂亮,审稿人都会问一句:临床呢?作者用三个层次回答。
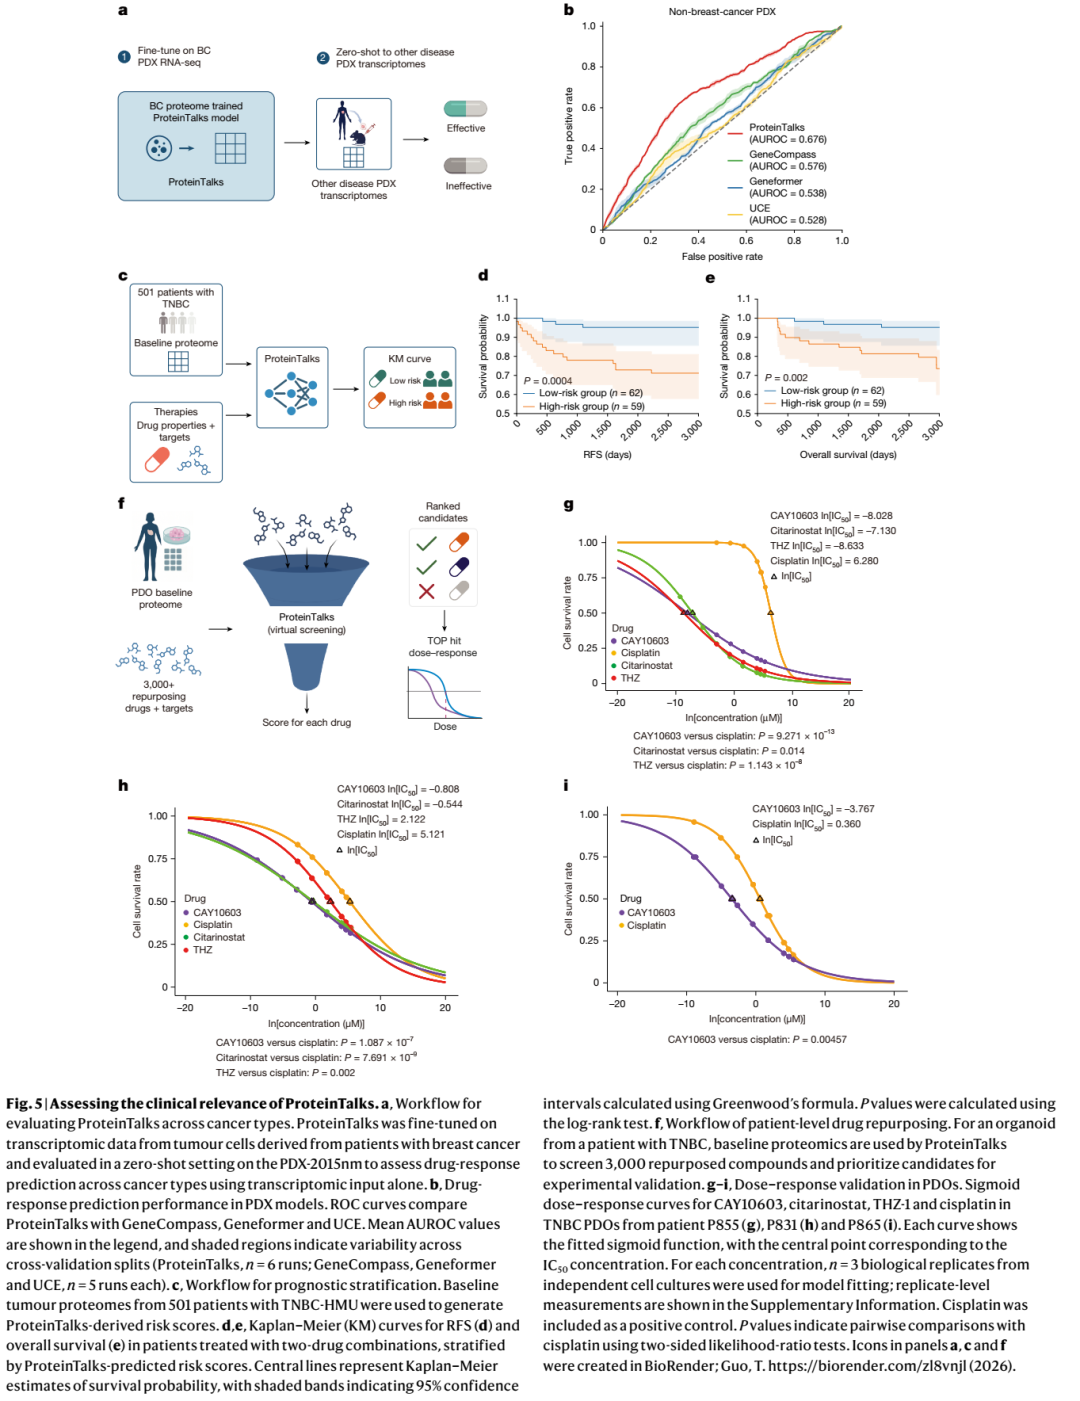
图 5:ProteinTalks 的临床相关性评估。是临床部分的全家福。a 面板是跨癌种评估流程;b 面板是 PDX 药效预测的 ROC 曲线;c 面板是预后分层流程;d、e 面板是 501 例 TNBC 患者的无复发生存与总生存 Kaplan–Meier 曲线;f 面板是患者级药物重定位流程;g、h、i 面板是三位患者类器官(P855、P831、P865)的剂量反应验证曲线。
第一层:PDX 与患者来源肿瘤细胞。 作者用 30 例乳腺癌患者来源肿瘤细胞模型(PDTC)、96 个化合物的转录组数据对 ProteinTalks 做微调,并用"是否用扰动蛋白组预训练"做了对照:从零训练的准确率 0.65、AUROC 0.65、AUPRC 0.72,而用 PTDS 预训练后变成 0.71、0.74、0.77。这个对照很关键——它直接证明了"扰动蛋白组预训练"这件事本身带来了增量,而不是"换个数据集碰巧更好"。
接下来更狠:用乳腺癌 PDX 转录组微调后,在 140 个非乳腺癌 PDX 转录组上做零样本评估,ProteinTalks 的 AUROC 达到 0.676,而 GeneCompass、Geneformer、UCE 分别是 0.576、0.538、0.528——平均高出 24%。请注意这里的模态转换:用蛋白组预训练的模型,拿去做转录组输入的预测任务,依然赢过了原生的转录组基础模型。 这件事的含义,比它看起来的要深——它暗示蛋白组预训练学到的表示,抓住了某种跨模态可迁移的"细胞状态结构"。
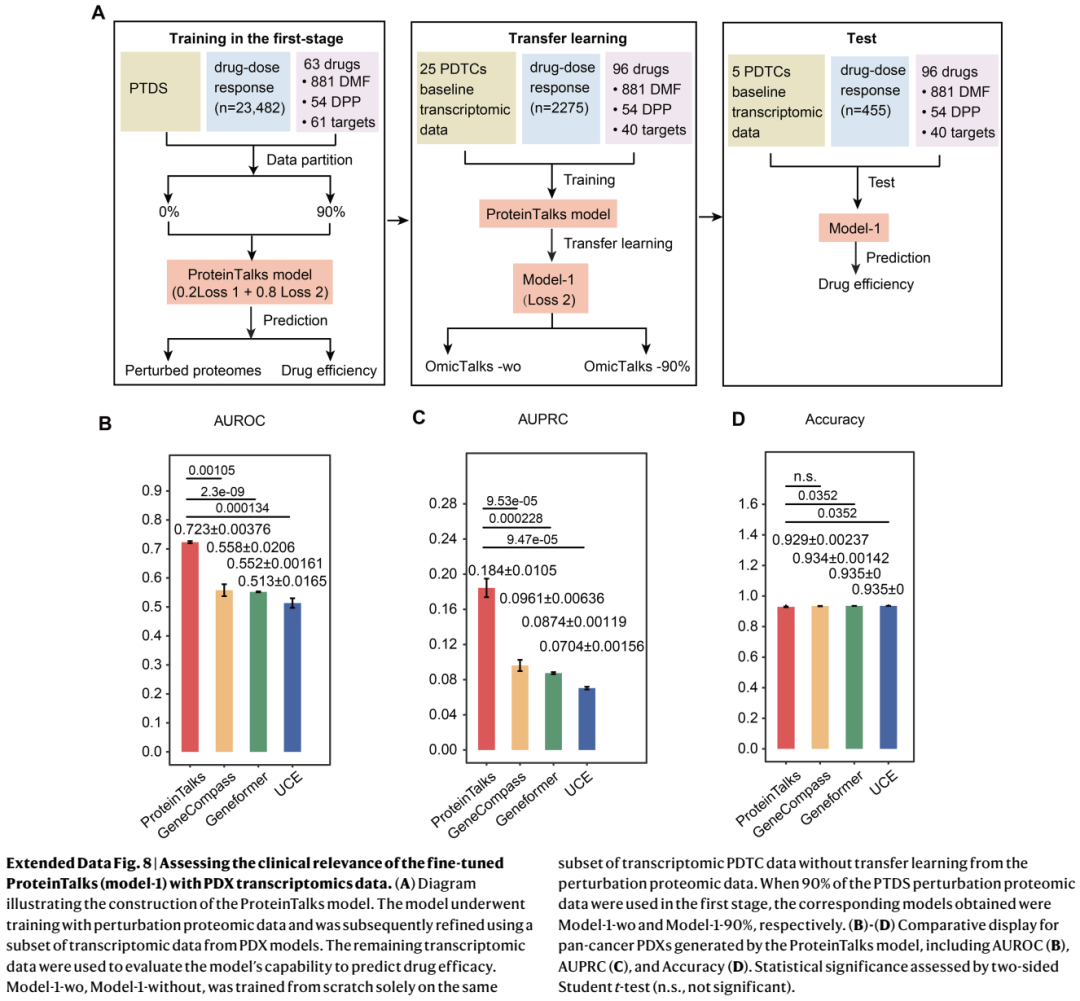
扩展数据图 8:PDX 转录组微调对照。给出了更完整的对照:A 面板是模型构建示意图(Model-1-wo 表示完全不用扰动蛋白组预训练、仅用同样的 PDX 转录组从零训练;Model-1-90% 表示第一阶段用了 90% 的 PTDS);B–D 面板是泛癌 PDX 上的 AUROC、AUPRC 与准确率对比(两样本 t 检验,n.s. 表示不显著)。这张图让读者能自己判断:蛋白组预训练的增益到底来自哪里、在哪些指标上显著。
第二层:501 例真实患者活检的预后分层。 作者对 501 例初治三阴性乳腺癌 FFPE 穿刺标本(TNBC-HMU 队列)做了蛋白组检测,定量 3,583 个蛋白,用 ProteinTalks 依据基线肿瘤蛋白组与治疗方案计算个体化风险评分。按中位数分高低危后,接受两药联合方案的患者,无复发生存(RFS)的组间差异 P = 0.0004,总生存(OS)P = 0.002(低危组 n = 62,高危组 n = 59)。
对超过模型"两药上限"的多药方案,作者换了个办法:取 SHAP 排名前 100 的蛋白组成生物标志物面板,同样能显著分层。
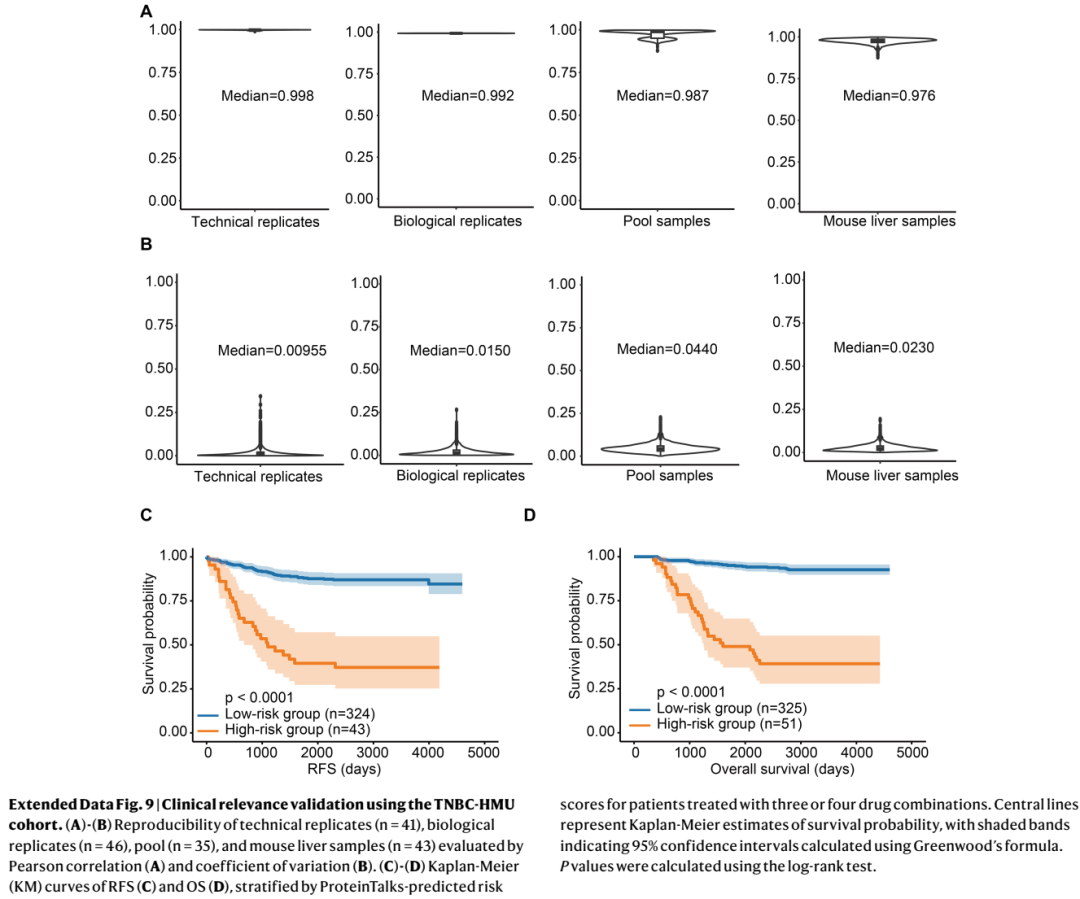
扩展数据图 9:TNBC-HMU 队列的质控与多药方案验证。给出这一队列的质控与补充验证:A、B 面板是技术重复(n = 41)、生物学重复(n = 46)、混合样本(n = 35)、小鼠肝脏样本(n = 43)的相关性与变异系数;C、D 面板是三药或四药方案患者的 RFS 与 OS 的 KM 曲线。FFPE 样本是临床上最容易获得、也是蛋白组最难做的样本类型之一,能把 501 例 FFPE 做下来并给出可重复的质控,本身就是工程能力的证明。
第三层:患者类器官的个体化用药筛选。 这是全篇最"临门一脚"的部分。作者拿三位 TNBC 患者(P855、P831、P865)的类器官(PDO)基线蛋白组,让 ProteinTalks 对 3,000 多个已上市或临床期化合物做虚拟筛选,排序后挑候选去做九点剂量反应实验。
顺铂排在靠前位置——这一点很妙,因为这三位患者在临床上接受卡铂–紫杉醇–卡瑞利珠单抗联合治疗后,都达到了 Miller & Payne 5 级病理完全缓解。模型在不知道临床结局的情况下,把铂类排了上来,这算是一次"盲测通过"。
更值得说的是三个非铂候选:citarinostat(HDAC6 抑制剂,I 期 NCT02551185)、THZ-1(CDK7 抑制剂)、CAY10603(HDAC6 抑制剂)。三者在三位患者的类器官上 IC50 全部显著低于顺铂:P855 上分别是 0.80 nM、0.18 nM、0.33 nM,而顺铂是 0.53 mM;P831 上是 0.58 μM、8.35 μM、0.45 μM,顺铂 0.17 mM;P865 上 CAY10603 为 23.1 nM,顺铂 1.43 μM。
换算成倍数看更直观:P865 上优势约 62 倍(23.1 nM 对 1.43 μM),P831 上约 378 倍(0.45 μM 对 0.17 mM),P855 上约 160 万倍(0.33 nM 对 0.53 mM)。哪怕你对类器官药敏与临床疗效之间的转化率打个很大的折扣,这个结果也足够支撑一句:模型筛出来的不是噪声。
09 给 AI+交叉学科同学的六点启发
第一,数据集与架构要"协同设计",而不是各干各的。
论文把这一点写在了讨论的第一句:"A key feature of ProteinTalks is the alignment between dataset collection and architecture design." 他们不是为了跑 neural ODE 才去收时间序列,也不是收完时间序列才想"嗯,可以用 ODE"——而是一开始就知道自己想要的是"条件动力学",然后倒推出数据应该长什么样:需要在多个时间点、多个药物、多个细胞系上做交叉采样。
反观很多交叉学科项目,AI 这边拿到什么数据就用什么数据,生物那边有什么技术就做什么数据,两边在"数据形状"上从不谈判。ProteinTalks 给了一个正面的范例:先定义你要学的数学对象,再定义测量它所需的最小实验设计。
第二,模态选择的优先级,可能高于模型规模。
这篇论文反复在讲一件事:转录组是中间层,蛋白是执行者。他们用少 1000 倍的参数,在多个任务上打赢了参数量级大得多的转录组基础模型,靠的就是换了一个离表型更近的观测层。
当然,这个对比要公平看待——双方的训练数据、预训练语料、评测协议不可能完全对齐,论文也谨慎地写了"under the evaluated protocols"。但趋势本身是有信息量的:当你的任务关心的是"细胞实际在做什么"时,测量层的选择会直接影响天花板。
对做 AI 的同学的提醒是:别急着问"用多大的模型",先问"我这个 y 到底由哪一层决定"。选错了输入模态,Transformer 堆到 100 层也是在拟合中间变量。
第三,"时间"是最便宜、也最被浪费的因果线索。
在观测数据里做因果推断,最头疼的是混杂。而时间维度几乎是白送的干预信息:药物的作用是"因",蛋白的变化是"果",因果之间天然有先后顺序。
这篇论文用的办法不算复杂——就是在 0、6、24、48 小时采样,然后用 ODE 把这个序列当作连续轨迹来建模。但它换来的东西很值钱:模型被迫去学"状态如何演化",而不是"状态是什么"。前者更接近机制,外推能力自然更强。
做机器学习的同学可以想想自己的问题里有没有被折叠掉的时间轴。很多被当成"静态分类"的任务,其实只是因为数据是按静态方式采集的。
第四,可解释性要跟着研究对象一起"动起来"。
如果说这篇论文在方法上有什么最容易被抄走的创新,我投 dynamical SHAP 一票。
传统可解释性是"给一个预测,找一组重要特征"。但当你研究的对象是一个动态系统时,重要特征本身是随时间变的——6 小时重要的蛋白,48 小时可能已经退场。把 SHAP 推广成时间索引的归因矩阵,再配上"同药异标"的背景集做对比,得到的就不再是"重要特征列表",而是一张"谁在什么时候开始起作用"的时间表。
这张表可以直接翻译成实验计划:在 T 时刻、针对 P 蛋白、用 siRNA 敲低、看药敏变化。AKR1C3 就是这么来的。
第五,闭环,闭环,还是闭环。
请数一数这篇论文里有多少次"模型 → 假设 → 湿实验 → 回到模型"的循环:TYMS(耐药机制假设 → 敲低 → 恢复敏感性);四个联合用药组合(虚拟筛选 → CCK8 验证 → 全部达标);AKR1C3(SHAP 排序 → 敲低 → Δln[IC50] = 4.24);PDX(预训练对照 → 零样本迁移);501 例队列(风险评分 → KM 分层);PDO(3000 药虚拟筛选 → 九点剂量反应 → IC50 优于顺铂)。
六个闭环,层层递进。这才是"operational"这个词的真正含义——不是"我们的模型跑通了",而是"我们的输出能直接变成别人的实验排期"。
对刚入行的同学,我的建议是:如果你的项目里一个闭环都没有,那它还没有真正开始。
第六,把模型设计成"可被别人调用"的模块。
论文的讨论里有一段不太起眼但我觉得很重要的话:他们说 ProteinTalks 作为一个"基于时间分辨蛋白组状态转移的模块",可以自然地嵌入到更广泛的智能体架构里,比如 CellForge 那种多智能体框架——由智能体自主设计和改进神经网络架构、协调多组学感知、生成生物学假设、形成闭环实验验证。在这个图景里,ProteinTalks 提供的是"动态蛋白组骨干网络"。
这是 2026 年做 AI for Science 必须要有的自觉:你的模型大概率不会是终局,它会是某个更大系统里的一个器官。 所以接口要干净、表示要通用、不确定性要给出(还记得 SWAG 吗)。
10 哪些地方值得打问号
一篇 Nature 论文也经不起无限吹捧。作为带学生读文献的人,我必须把冷水泼在前面。
其一,深度与通量的取舍。 论文自己承认:DIA-MS 策略优先保证通量,牺牲了深度,5,585 个蛋白组远少于超深度方法能覆盖的一万个以上。这意味着大量低丰度蛋白——尤其是转录因子、激酶这类"很重要但很少"的调控分子——可能压根没被观测到。模型看到的世界,是被质谱检测限裁剪过的世界。
其二,PTM 与多组学的缺席。 磷酸化、泛素化这些翻译后修饰,恰恰是细胞信号传导最即时、也最贴近药靶的语言。论文里 6 小时就出现分叉的 CDK 抑制剂响应,如果有磷酸化数据,故事会清楚得多。作者把这一点明确列为未来方向。
其三,剂量与序贯给药未被建模。 现实中的化疗方案是"第 1 天给 A,第 8 天给 B,剂量随时间调整"。当前框架只处理两药组合,没有显式建模剂量依赖与给药顺序。这也解释了为什么 501 例队列里,只有两药方案能直接用完整模型,三药四药方案只能退而求其次用生物标志物面板。
其四,疾病谱偏窄。 数据集以癌细胞系为主,而且高度偏向 TNBC(16/18 是三阴性)。虽然 PTPC 补了五个非乳腺癌细胞系,但每个癌种只有一株细胞系——离"跨癌种泛化"这个说法,还差着好几个数量级的细胞系多样性。
其五,评测口径要留个心眼。 论文在 PTDS 上用的是样本级随机划分(70/20/10),没有按细胞系或实验条件分层。虽然他们在跨细胞系与跨药物评测上用了严格的留一法,但主体训练切分仍可能让同一细胞系-药物-时间点的不同重复落入训练与验证集,从而轻微高估。另外,转录组基础模型的基线实现是"紧凑多模态分类器"(细胞嵌入 + 药物指纹),不是这些模型的原生用法——这在基准评测里是常见且必要的做法,但读者应该知道基线是被"重新包装"过的。
其六,从相关到因果的距离。 SHAP 值高,不等于因果。AKR1C3 的故事之所以漂亮,是因为后面补了敲低实验;但排在它后面的那 99 个蛋白,目前仍然是"模型认为重要"而已。
其七,临床部分仍是回顾性的。 501 例队列是回顾性分层,PDO 验证只有三位患者,三位患者还都恰好是铂类敏感、都达到了病理完全缓解。这是个很短的、被高度筛选过的验证链。 从"能在 3 个类器官上筛出候选"到"能改变临床决策",中间还隔着前瞻性试验。
把这些说清楚,不是要否定这篇论文——恰恰相反,只有知道边界在哪,你才知道该往哪儿接着做。
11 写在最后:给做 AI + Science 的三句话
读完整篇,我最想跟学生们说的是三句话。
第一句:在交叉学科里,"数据主权"就是话语权。 这篇论文最不可复制的不是模型,是那 6,668 小时的质谱机时和 501 例患者样本。ProteinTalks 的护城河在数据侧,模型反而写得克制、干净、可复现(连随机种子都写进了方法)。当所有人都能调用同一个大模型时,你手里独有的、有结构的、别人生成不出来的数据,才是真正的壁垒。
第二句:不要迷信"规模",要迷信"约束"。 少 1000 倍参数还能赢,靠的不是运气,是把物理世界的先验——时间的连续性、蛋白的功能执行者地位、扰动的因果方向——老老实实写进了数据与架构。归纳偏置不是玄学,它是你在样本稀缺时唯一能借的力。
第三句:让模型的输出止于"可执行的下一步"。 预测一个 IC50 是论文;预测一个值得敲低的基因、并且你或你的合作者真的去敲了,那才是研究。这篇论文之所以配得上 Nature,不是因为它的 AUROC 有多高,而是因为它把 AUROC 换成了六个闭环。
最后,留一个小问题给看到这里的你:如果你的研究对象也有一个被折叠起来的"时间轴"——无论是细胞对药物的响应、材料在循环载荷下的疲劳、还是用户在产品上的行为演化——你会不会也试着,给它拍一部电影,而不是一张照片?
愿你的模型也能长出时间感。

内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢