

DRUGONE
基因调控网络(gene regulatory network,GRN)描述转录因子与靶基因之间的调控关系,是理解细胞状态、基因表达控制和细胞命运的重要工具。然而,仅依赖单细胞RNA测序从表达相关性反推出调控网络通常存在较大不确定性,因此多数GRN推断方法需要首先提供一张“先验网络”,告诉模型哪些转录因子–基因组合更可能存在真实调控关系。问题在于,高质量先验通常依赖人工整理的调控数据库、转录因子结合位点、ATAC-seq或ChIP-seq等实验数据,对于研究不足的物种和细胞类型往往并不存在。
研究人员提出GLM-Prior,尝试让基因组语言模型直接从核苷酸序列学习这种调控先验。GLM-Prior以预训练于850个物种、包含2.5亿参数的Nucleotide Transformer为基础,将转录因子结合基序与候选靶基因序列联合输入模型,预测二者是否可能形成调控关系,再将结果构建为TF–gene先验矩阵。随后,这张序列先验被输入PMF-GRN,与单细胞表达数据结合,得到细胞环境相关的最终GRN。
在酵母、人和小鼠六种细胞环境中的系统评价显示,GLM-Prior的能力高度依赖训练数据中阳性调控关系的数量以及转录因子覆盖度。在数据较丰富的哺乳动物体系中,它能够稳定学习超过随机水平的序列调控信号,并支持人–小鼠之间的跨物种迁移;但从哺乳动物迁移到进化距离更远的酵母时,性能仍接近随机。与依赖染色质可及性的先验相比,GLM-Prior在五种哺乳动物细胞环境中的四种取得最佳先验表现。更重要的是,系统比较显示:最终GRN质量主要受初始先验质量限制,而下游GRN算法更多是在已有先验基础上进行修正,而不是重新建立网络。
从单细胞RNA测序推断GRN的基本目标,是回答“哪些转录因子正在调控哪些基因”。但表达数据本身主要反映最终转录结果,同一表达模式可能由不同调控机制产生。因此,现代GRN方法通常利用先验知识缩小可能的调控空间。
传统方法主要从已知TF–gene数据库或染色质可及性中构建先验。例如,在开放染色质区域寻找转录因子结合基序,再根据其是否位于基因启动子附近建立候选调控边。这种策略具有明确生物学依据,但也存在明显限制:转录因子基序注释并不完整,ATAC-seq具有细胞类型依赖性,而且基于启动子邻近关系的方法可能遗漏远距离调控。更现实的问题是,许多研究不足的物种根本没有匹配的染色质可及性数据。
基因组语言模型提供了另一种可能。类似蛋白质语言模型从蛋白序列学习进化规律,Nucleotide Transformer等模型通过大规模基因组预训练获得DNA序列表示。如果调控关系能够在序列中留下可学习的特征,就可能利用注释丰富物种中的调控数据训练模型,再把这种知识迁移到缺乏实验数据的相关物种。
因此,GLM-Prior真正要解决的不是直接从DNA序列“预测完整GRN”,而是一个更加具体的问题:能否利用基因组语言模型产生足够有信息量、而且能够跨物种迁移的TF–gene先验,为后续单细胞GRN推断提供起点?
方法
研究人员建立两阶段框架。第一阶段GLM-Prior以2.5亿参数Nucleotide Transformer为基础,该模型此前在850个物种基因组上完成预训练。研究人员将来自CisBP的转录因子结合基序与候选靶基因的gene-body序列组合输入Transformer,根据YEASTRACT、STRING和TRRUST等已有调控关系训练二分类模型。由于真正已知的正调控边远少于未注释组合,训练中采用负样本下采样、类别加权和正负样本均衡批次;模型输出每个TF–gene组合的调控概率,再通过验证集阈值转化为先验网络。第二阶段将该先验输入PMF-GRN,并结合单细胞RNA表达推断转录因子活性和环境相关的调控网络,同时估计每条调控边的不确定性。研究分别评价单物种训练、跨物种迁移和人–小鼠–酵母多物种训练,并进一步与Inferelator-Prior和CellOracle等染色质可及性先验进行比较。论文第3页图1完整展示了从序列构建先验,再利用单细胞表达进行GRN修正的双阶段流程。
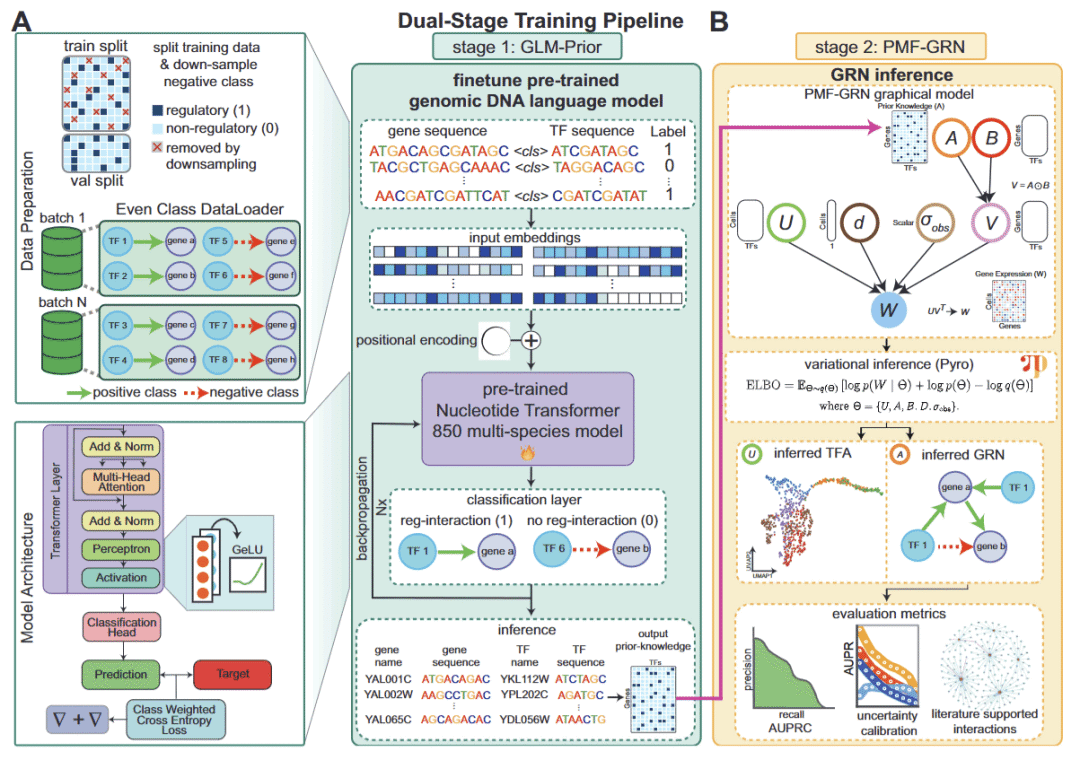
图1:GLM-Prior与PMF-GRN双阶段框架——基因组语言模型从TF基序和基因序列构建先验网络,再结合单细胞表达推断GRN。
结果
GLM-Prior能够学习序列相关的调控先验,但性能高度依赖训练数据
研究人员首先在酵母、人胚胎干细胞、HepG2、人源之外的小鼠胚胎干细胞、树突状细胞和造血干细胞六种环境中测试GLM-Prior。
不同体系之间差异非常明显。酵母训练数据只有660条阳性调控关系,GLM-Prior的AUPRC约为0.02,仅略高于0.01的随机水平。人胚胎干细胞达到0.19–0.20,HepG2达到0.29–0.30;小鼠胚胎干细胞达到0.22–0.24。小鼠树突状细胞仍停留在约0.09的随机水平,而小鼠造血干细胞表现最好,达到0.44–0.49,相比随机水平0.37有更明显提高。
这些结果没有显示“基因组语言模型普遍能够准确恢复调控网络”,而是揭示了更重要的规律:模型是否有效,很大程度上取决于可用于监督学习的阳性调控标签数量、TF覆盖以及训练与测试网络之间的匹配程度。
研究人员还排查了gene-body组成、基因长度、序列相似性和数据库注释密度等潜在捷径,没有发现GLM-Prior的性能可以简单归因于这些因素,支持模型确实学习到了更复杂的序列相关信号。
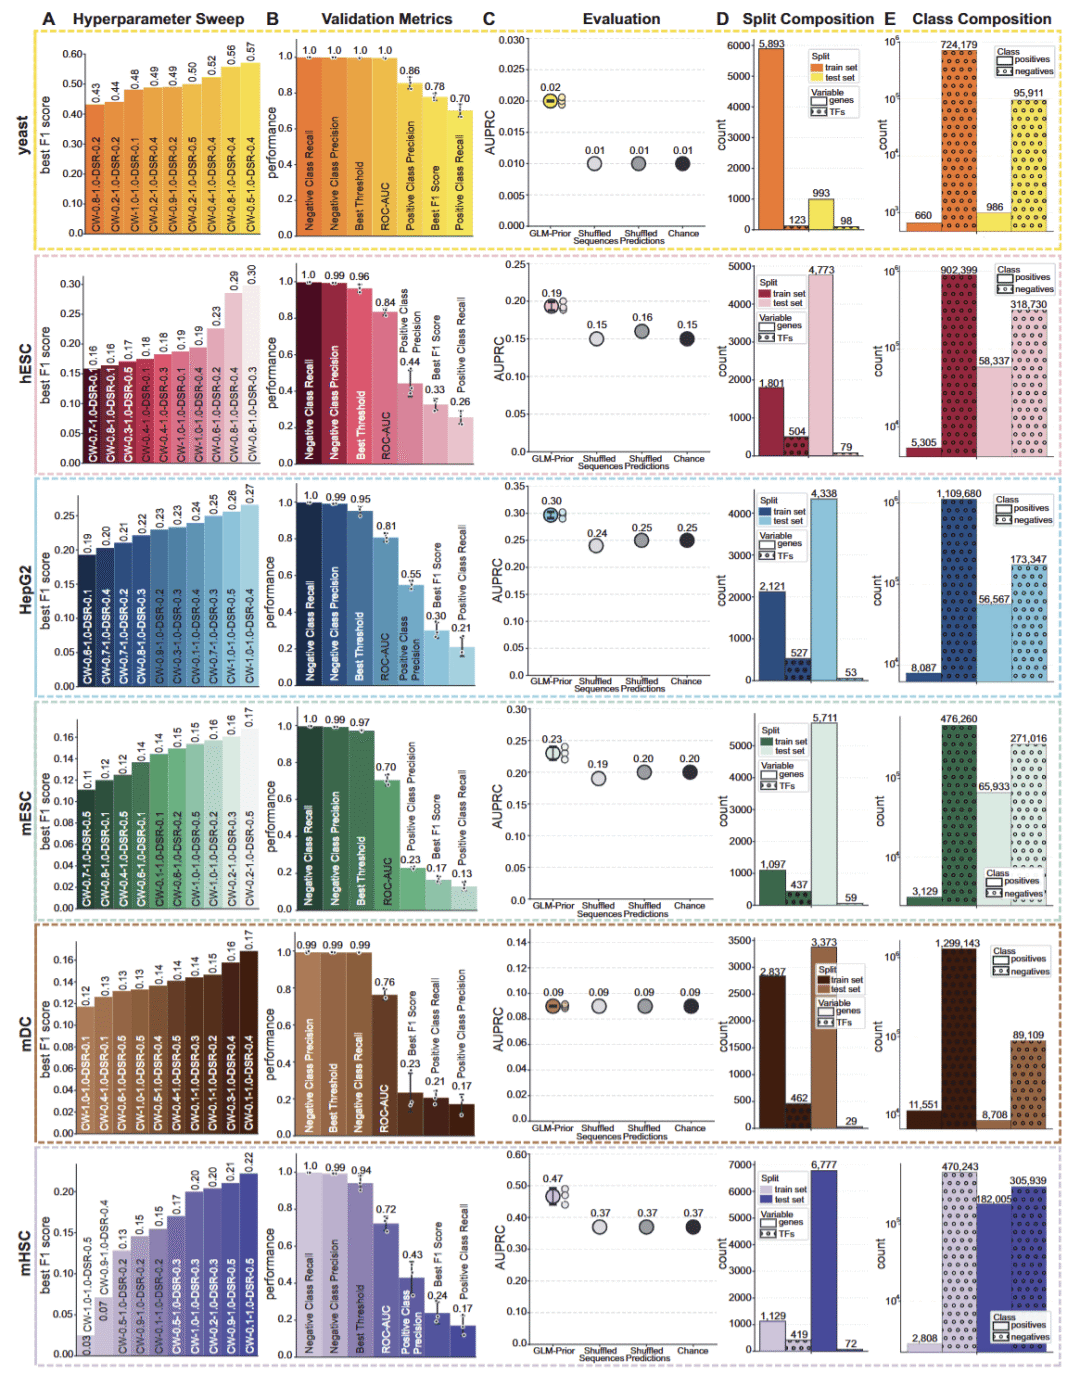
图2:GLM-Prior在酵母、人和小鼠六种细胞环境中的训练数据组成、独立参考网络AUPRC以及随机和序列打乱对照。
序列先验能够在人和小鼠之间迁移
研究人员进一步测试一个更有实际价值的问题:如果目标物种缺少调控注释,能否使用另一个物种训练的模型?
结果显示,人和小鼠之间具有明显迁移能力。小鼠模型迁移到人HepG2后,AUPRC从单物种模型的约0.30提高到0.31;迁移至人胚胎干细胞后仍保持约0.19。人类模型用于小鼠细胞时也基本保持与单物种训练相近的性能。
但这种能力具有明确的进化边界。使用人和小鼠训练后预测酵母,AUPRC仍只有0.02,几乎处于随机水平。也就是说,GLM-Prior目前支持的是相关哺乳动物之间的迁移,而不是普遍意义上的跨物种泛化。
将人、小鼠和酵母共同用于多物种训练后,一个统一模型在六种环境中基本保持了单物种模型的性能。论文第7页图3显示,多物种模型没有因为同时学习多个物种而出现明显整体性能崩溃,为未来构建通用序列先验模型提供了初步依据。
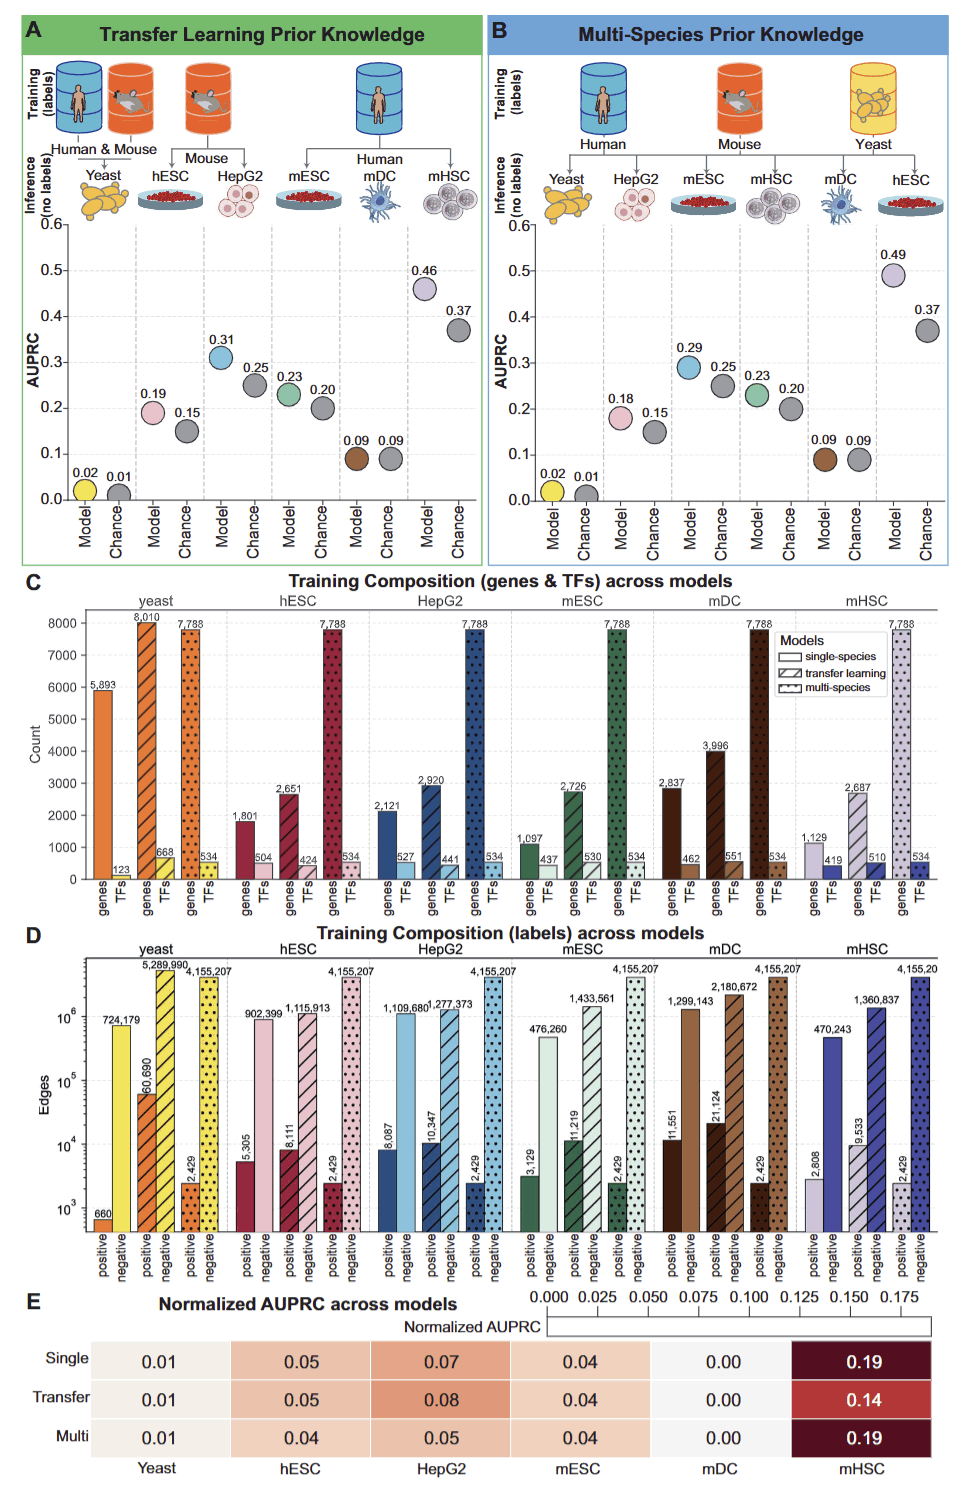
图3:GLM-Prior在人–小鼠–酵母之间的跨物种迁移学习以及统一多物种训练结果。
单细胞表达主要是在序列先验基础上进行有限修正
将GLM-Prior输入PMF-GRN后,最终GRN性能总体保持或提高。HepG2的AUPRC从0.30提高到0.38,小鼠胚胎干细胞从0.23提高到0.27,小鼠造血干细胞从0.49提高到0.52;而酵母和人胚胎干细胞基本没有变化。
值得注意的是,PMF-GRN并没有大规模重建网络,而是保留绝大多数GLM-Prior边,只增加少量由表达数据支持的新关系。当初始先验接近随机时,即使提供大量单细胞表达数据也很难补救。例如酵母GLM-Prior只有0.02,加入PMF-GRN后仍为0.02。
因此,单细胞表达更像是对先验进行环境相关的精修,而不是从一个错误起点重新恢复正确网络。
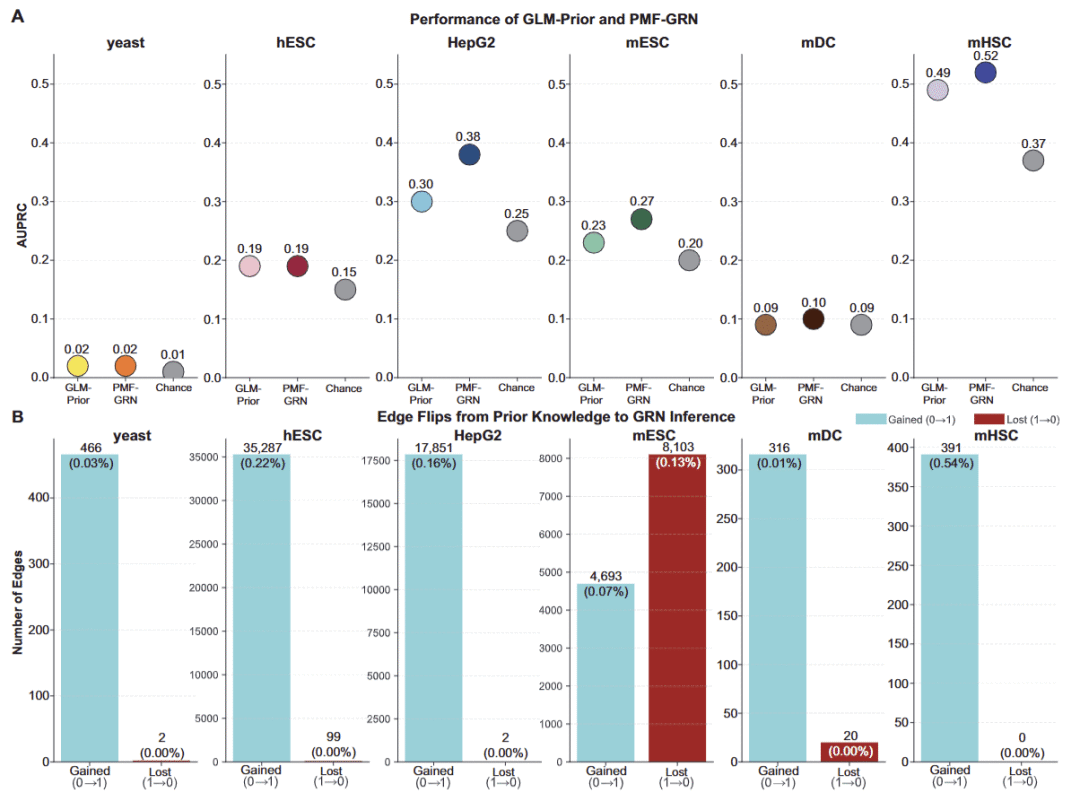
图4:GLM-Prior先验与PMF-GRN最终网络的性能比较,以及单细胞表达推断过程中增加和删除的调控边。
序列先验在多数哺乳动物环境中优于可及性先验
研究人员随后将GLM-Prior与Inferelator-Prior和CellOracle进行比较。后两者利用匹配细胞中的ATAC-seq和TF基序构建调控先验,因此拥有GLM-Prior没有使用的细胞环境特异染色质信息。
结果却显示,在五种哺乳动物细胞环境中,GLM-Prior在四种取得最佳先验性能,包括人胚胎干细胞以及三种小鼠细胞;CellOracle则在HepG2表现最好。酵母同样更适合CellOracle,其AUPRC为0.05,而GLM-Prior为0.02。
这并不意味着序列先验普遍优于ATAC-seq,而是说明两类先验具有不同适用条件。对于缺少匹配染色质实验的体系,GLM-Prior提供了一种不依赖额外测序技术的替代方案。
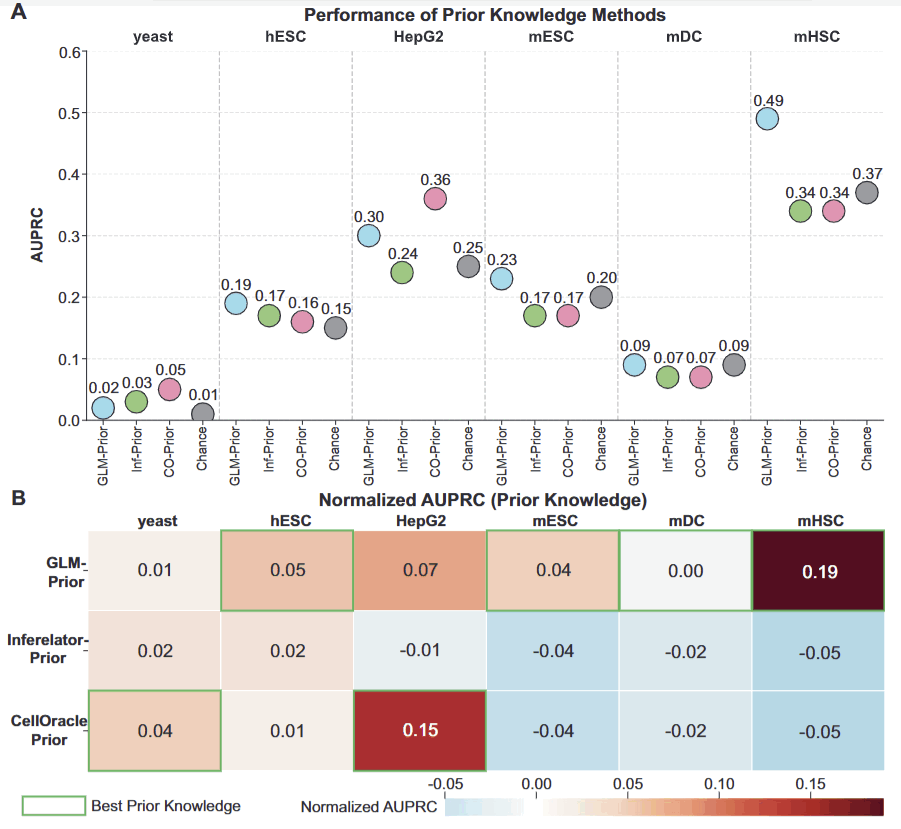
图5:GLM-Prior、Inferelator-Prior和CellOracle先验在六种细胞环境中的AUPRC及标准化性能比较。
最终GRN的上限主要由初始先验决定
研究人员进一步比较三套完整流程。结果出现一个清晰规律:初始先验很弱时,表达数据通常无法彻底挽救网络;先验已经较强时,下游GRN算法则主要带来小幅修正;最大的改善通常出现在中等质量的先验上。
为了确认究竟是“先验”还是“GRN算法”更重要,研究人员最后进行全交叉实验,将三种先验分别输入PMF-GRN、Inferelator和CellOracle,形成每种细胞环境9种组合。
结果显示,表现最好的最终GRN通常跟随表现最好的先验,而不是跟随某一种固定GRN算法。没有任何一种下游方法在所有物种和先验上持续获胜。
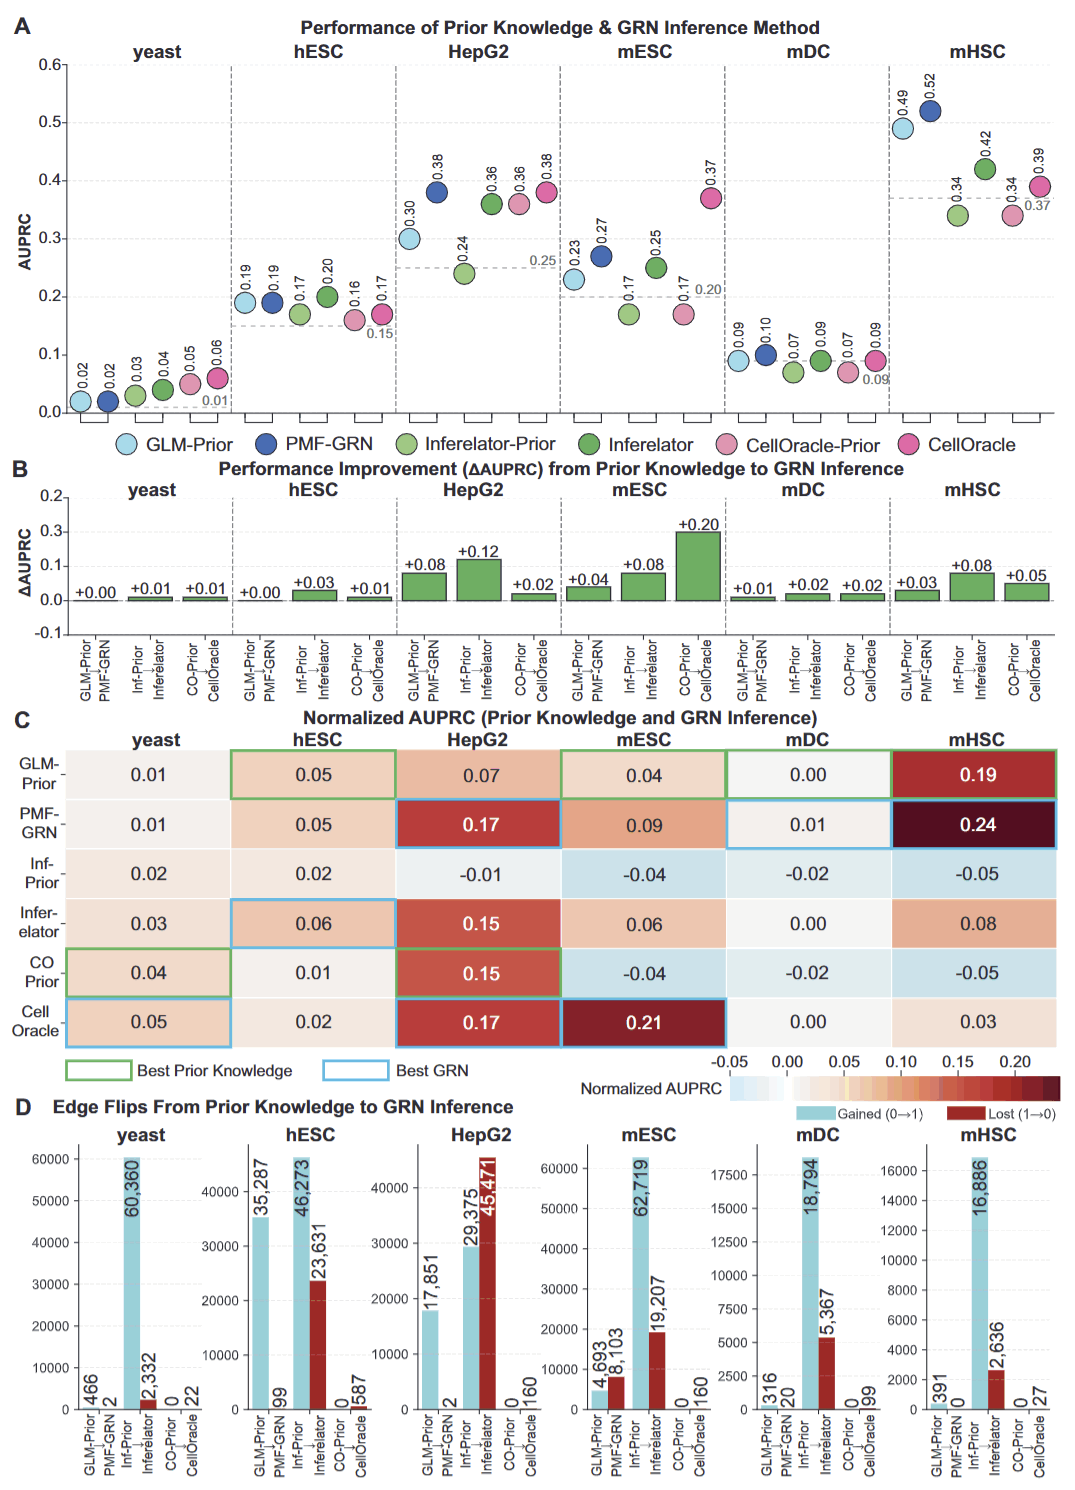
图6:GLM-Prior、Inferelator和CellOracle完整先验–GRN流程的性能提升,以及不同算法对先验网络的修改方式。
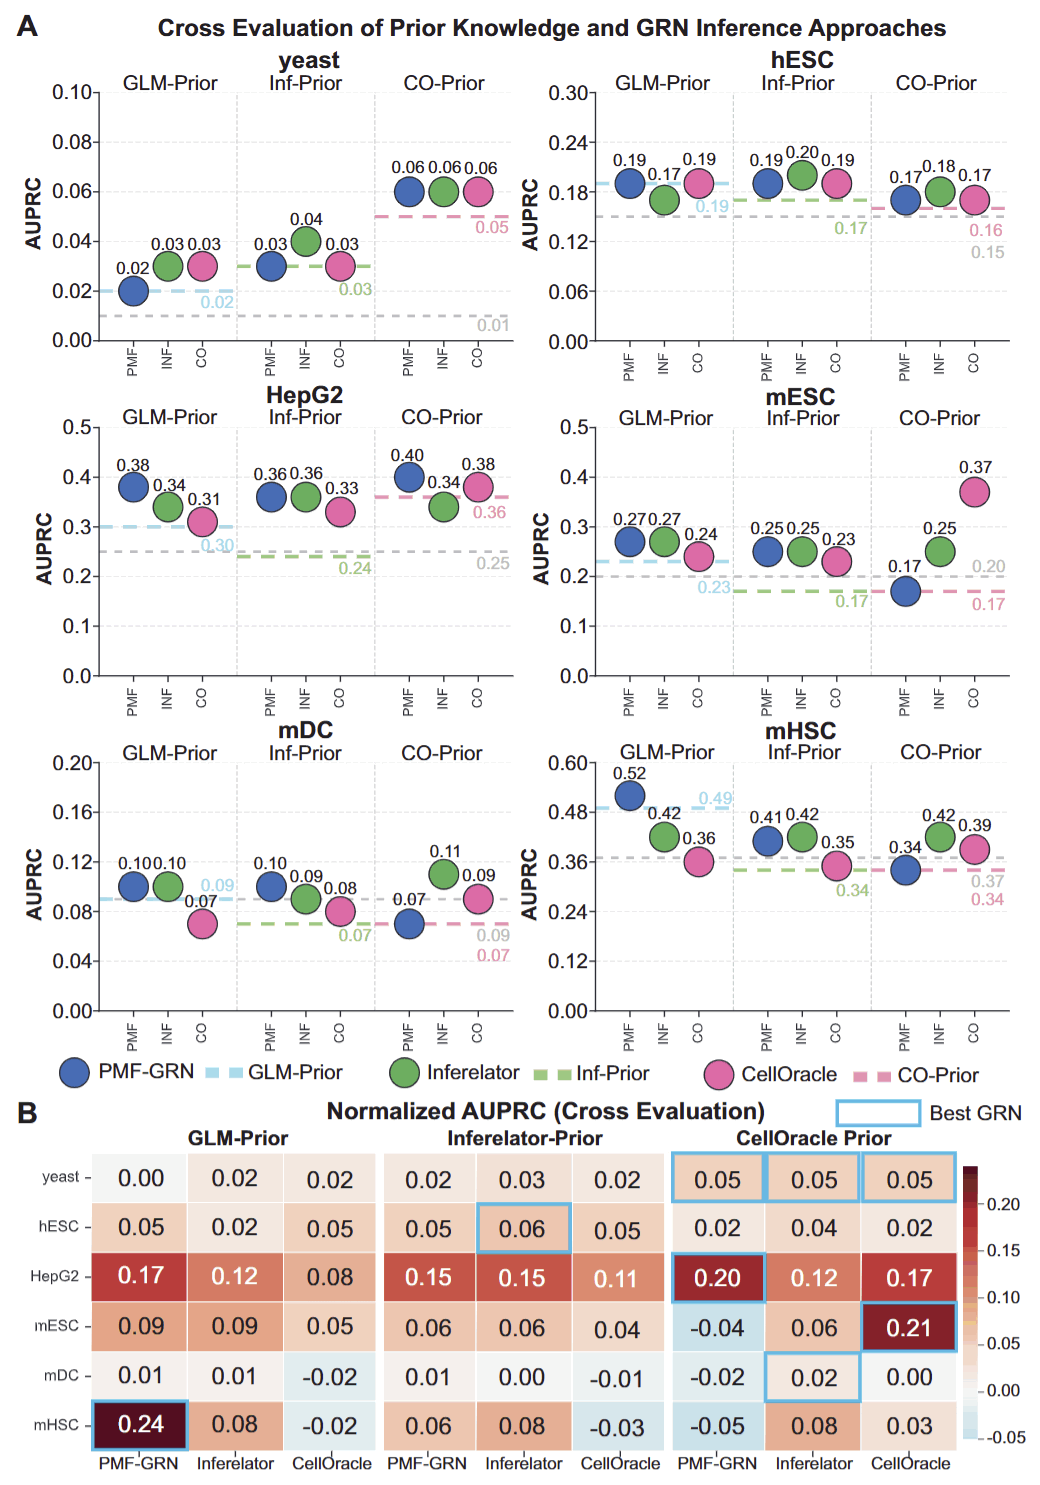
图7:三种先验与三种GRN推断算法的九种全交叉组合,展示先验质量对最终GRN性能的主导作用。
讨论
这项研究最重要的贡献并不是提出一个新的“端到端GRN预测模型”,而是重新强调了一个过去容易被忽视的问题:GRN推断的上限可能首先取决于你给模型什么样的先验,而不是最后选择哪一种网络推断算法。
论文的全交叉实验对此提供了最直接证据。同一种PMF-GRN换用不同先验后性能可以发生巨大变化,而同一个高质量先验交给不同GRN算法时,最终结果往往仍然具有竞争力。研究人员因此认为,当前GRN研究不应该只不断开发更加复杂的表达建模方法,也需要投入更多精力研究如何构建、评价和迁移高质量先验。
GLM-Prior在这里提供了一种新的先验来源。传统方法依赖“这个细胞的染色质哪里开放”,GLM-Prior则试图学习“从序列本身看,这个TF和这个基因是否具有形成调控关系的潜力”。因此,它产生的更接近一种序列层面的基础调控脚手架,之后再由单细胞表达将其调整到具体细胞环境。
这种分工也解释了GLM-Prior与PMF-GRN为什么适合形成双阶段框架。GLM-Prior没有观察当前细胞的实验数据,因此无法单独恢复完整的细胞类型特异网络;PMF-GRN则利用单细胞表达修正序列先验,并为调控边提供不确定性。换句话说,前者提供“可能存在什么调控关系”,后者进一步判断“在当前细胞环境中哪些关系得到表达数据支持”。
真正具有应用吸引力的是迁移能力。对于人和小鼠等研究充分的物种,可以获得大量TF–gene注释和多组学数据;但许多非模式生物只有基因组序列和有限的单细胞RNA测序。如果序列先验能够从研究充分的相关物种迁移过去,就可以在缺少ATAC-seq和ChIP-seq的情况下为GRN推断提供初始结构。论文的人–小鼠结果证明这种思路具有可行性,但哺乳动物到酵母的失败也说明目前还不能把它理解成真正的“跨生命树通用GRN模型”。
同时,这篇论文对自身结果保持了比较重要的边界。GLM-Prior在一些数据集中的提升并不大:hESC和mESC只是稳定高于随机,而mDC完全没有检测到改善。因此,目前证据支持的是“在部分具有足够监督数据的哺乳动物环境中,基因组语言模型可以学习有信息量的序列先验”,而不是已经证明可以仅凭DNA准确恢复TF调控网络。
其最大的限制来自训练标签本身。数据库没有记录某个TF–gene关系,并不意味着实验已经证明二者没有调控关系。GLM-Prior却必须把大量未注释组合当作负样本训练,其中必然混入真实但尚未发现的调控边。与此同时,负样本数量极其庞大,研究人员不得不进行下采样,又可能进一步遗漏有信息量的组合。未来使用正样本–未标注学习可能比传统二分类更符合真实调控数据的性质。
另一个限制来自参考网络本身。论文使用的独立参考网络虽然能够避免训练集与测试集直接重叠,但它们同样不是完整的真实GRN。尤其在哺乳动物中,参考网络往往来自ChIP-seq等实验数据,而不同实验对不同类型调控关系的覆盖并不均衡。因此,模型与参考网络AUPRC更高,只能说明它与当前可用的调控注释更加一致,并不能直接证明预测出的全部调控边在生物学上都更加正确。
这一点对于理解不同先验方法的比较尤其重要。例如CellOracle在HepG2中的先验AUPRC达到0.36,高于GLM-Prior的0.30。研究人员指出,HepG2本身是ENCODE中研究非常充分的细胞系,而用于评价的参考网络大量依赖TF占据相关证据。CellOracle恰好利用开放染色质中的TF基序和邻近关系构建网络,因此其建模假设与参考网络的构建方式具有较高一致性。
所以,图5中GLM-Prior在五种哺乳动物环境中的四种获得最佳结果,并不能简单解读为“DNA语言模型已经优于ATAC-seq”。更准确的结论是:在本文所采用的独立参考网络和评价体系下,序列来源的先验在多个哺乳动物环境中表现出具有竞争力甚至更高的参考网络一致性,而且不需要目标细胞类型匹配的染色质可及性实验。
这实际上也是GLM-Prior最现实的应用场景。如果目标细胞已经拥有高质量ATAC-seq、ChIP-seq和经过充分验证的TF–gene数据库,那么没有必要认为序列模型必须取代这些实验信息。GLM-Prior真正有优势的场景,是实验先验不存在或难以获得:例如研究不足的哺乳动物、缺乏匹配ATAC-seq的细胞群,或者希望在获得单细胞表达数据之前先建立一个基础候选调控网络。
此外,GLM-Prior当前的序列输入设计仍然比较简化。模型将TF结合基序与gene-body序列组合起来预测调控关系。gene body能够为每个基因提供统一、容易获得的序列表示,但真实转录调控显然不仅发生在基因体内部。启动子、增强子、绝缘子、染色质状态以及三维基因组结构都可能决定一个TF最终能否调控某个基因。
研究人员专门进行了多项诊断实验,以排除模型只是根据gene-body长度、整体核苷酸组成、基因家族相似性或数据库注释频率“走捷径”的可能性。结果支持GLM-Prior确实捕获了这些简单代理变量之外的序列相关信息。但这些分析并不能回答模型究竟学习到了什么具体调控语法,也不能证明gene-body就是最合理的靶基因序列表示。
因此,一个自然的下一步是把GLM-Prior从当前的“TF motif+gene body”扩展为更加完整的调控序列模型。例如同时加入启动子和候选增强子,并进一步结合染色质开放状态、三维染色质接触和细胞类型特异调控注释。这样,序列模型负责学习相对稳定的调控潜力,而实验组学则负责提供细胞环境信息,两者并不是竞争关系,而更可能形成互补关系。论文也将这种多模态扩展明确列为未来方向。
另一个值得关注的结果,是PMF-GRN对GLM-Prior网络的修改实际上非常有限。例如在HepG2中,PMF-GRN使AUPRC从0.30提高到0.38,但只增加约0.16%的边,几乎没有删除原有边;在mHSC中,从0.49提高到0.52时只增加约0.54%的边。论文第9页图4直观显示,PMF-GRN整体更倾向于保留序列先验骨架,再添加少量得到单细胞表达支持的调控关系。
这说明“序列先验+单细胞表达”并不是两个模型各贡献一半信息。至少在当前PMF-GRN框架中,先验定义了网络的大致结构,表达数据主要完成局部调整。这也解释了为什么酵母中的结果没有得到挽救:当GLM-Prior本身接近随机时,即使PMF-GRN获得两个较大的单细胞表达数据集,最终AUPRC仍然停留在0.02。
但这并不意味着所有GRN算法都只能进行很小的修改。论文第11页图6显示,不同方法使用先验的方式差异很大。PMF-GRN主要增加新边;Inferelator既可以增加也可以删除关系;CellOracle则主要通过回归把已有先验中的边权重压缩到零,本质上进行网络剪枝,而不能提出先验中原本不存在的新边。
这种算法差异解释了一个看似矛盾的结果:在小鼠胚胎干细胞中,CellOracle的初始先验甚至低于随机水平,但经过CellOracle自身回归筛选后,最终网络反而取得所有方法中最好的标准化结果。研究人员认为,这是因为原始CellOracle网络比较稠密,其中包含有用边,只是同时包含大量错误关系;表达数据通过大规模剪枝能够把有价值的结构保留下来。
因此,“先验决定最终性能”并不是绝对规律。更准确地说,先验质量通常定义了GRN推断能够达到的大致性能范围,而下游算法能在这个范围内进行不同程度的扩展、重加权或剪枝。 在少数先验结构与算法机制高度匹配的情况下,一个较弱但包含潜在正确关系的稠密先验仍可能被显著修复。
这也是为什么研究人员最终进行了图7中的九种全交叉组合,而不是只比较三套方法各自默认的“先验+算法”。结果表明,交换下游GRN算法偶尔能够改善结果,例如HepG2中将CellOracle先验输入PMF-GRN获得了更高性能;但这种反转并不常见。总体上,高质量先验仍然更容易产生高质量最终网络。
更重要的是,没有任何一种GRN推断算法在所有环境中持续获胜。PMF-GRN在部分HepG2和mHSC组合中表现最好,Inferelator在某些hESC和mDC条件中更好,而CellOracle在mESC中特别突出。这说明“最好的GRN算法”并不存在脱离先验和数据环境的统一答案。
从这一角度看,这篇论文其实提出了一个比GLM-Prior本身更普遍的结论:GRN推断应该把“先验构建”和“表达数据推断”作为两个独立模块分别评价。 如果只报告最终GRN的AUPRC,很难知道性能来自优秀的初始网络,还是来自强大的表达建模算法。通过把三种先验和三种GRN算法完全交叉,研究人员能够明确看到二者各自的贡献。
这种模块化思路也使GLM-Prior具有较好的扩展性。它并不要求一定与PMF-GRN绑定。理论上,GLM-Prior产生的序列先验可以输入其他能够接受先验网络的GRN算法;反过来,PMF-GRN也可以接受CellOracle或Inferelator产生的先验。论文的全交叉实验已经直接验证了这种可替换性。
从更长远的角度看,GLM-Prior还有一个重要但目前尚未实现的方向:从静态“边预测”走向动态调控建模。目前模型最终回答的仍然是某个TF与某个基因之间是否存在候选调控关系,但真实GRN具有时间性和状态依赖性。同一条调控边可能在干细胞中活跃,在分化后关闭;TF活性也可能随着刺激产生瞬时变化。
研究人员因此提出,未来可以进一步建模调控模块、时间轨迹、扰动响应以及动态TF活性状态,并将序列先验与更多模态联合起来。这样,问题就能够从“TF A是否可能调控gene B”进一步转向“在什么细胞状态、什么时间以及什么扰动条件下,这条调控关系真正发挥作用”。
总体而言,GLM-Prior建立了一条非常清晰的路线:大规模多物种基因组预训练 → TF基序与基因序列配对 → 调控数据库监督微调 → 序列来源TF–gene先验 → 跨相关物种迁移 → 单细胞表达修正 → 环境相关GRN。
这项工作的价值并不在于证明“只看DNA序列就能解决GRN推断”。事实上,论文的数据恰恰表明这种说法过于乐观:酵母和mDC结果接近随机,人–小鼠迁移有效但哺乳动物–酵母迁移失败,最终性能仍然受到训练标签完整性和参考网络质量的明显限制。
更准确的意义在于,研究证明了基因组语言模型可以成为GRN先验知识的一种新来源。它不要求每一个目标细胞类型都拥有匹配的ATAC-seq或ChIP-seq,而是尝试把DNA序列中相对稳定的调控信息压缩进一个能够迁移的模型,再由单细胞表达数据赋予其具体细胞环境。
因此,这项研究真正改变的可能不是GRN推断的最后一步,而是它的第一步。过去研究通常把先验网络视为一个固定输入,然后重点比较后面的推断算法;GLM-Prior及其系统交叉实验则表明,先验本身就是决定最终网络质量的核心建模问题。
如果未来能够利用更完整、更高质量的调控标签训练基因组基础模型,并将启动子、增强子、染色质状态、三维基因组和单细胞多组学共同纳入框架,那么GLM-Prior所代表的路线有望进一步发展为一种“可迁移的调控基础先验”:先从大规模基因组中学习跨物种共享的调控规则,再利用少量目标物种或目标细胞数据完成环境适配。
最终,这篇工作的核心启示可以概括为:在基因调控网络推断中,表达数据能够帮助修正网络,但一个好的起点仍然极其重要。 基因组语言模型提供了一种从DNA序列自动构建这一“起点”的方法,而其在人和小鼠之间表现出的迁移能力,则为那些只有基因组序列和单细胞表达数据、却缺乏系统调控实验的生物体系提供了一条值得继续探索的GRN推断路径。
整理 | DrugOne团队
参考资料
Skok Gibbs, C., Chen, A., Bonneau, R. et al. GLM-Prior: a genomic language model for transferable sequence-derived priors in gene regulatory network inference. Nat Commun (2026).
https://doi.org/10.1038/s41467-026-77381-8
内容为【DrugOne】公众号原创|转载请注明来源
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢