

DRUGONE
由大语言模型驱动的自主医疗AI智能体已经能够通过多轮问诊、调用检查工具、整合临床证据并给出诊断及推理过程。然而,真正进入医疗机构并不只取决于平均诊断准确率,还需要解决两个相互独立的问题:一是运行层面的可信性,即患者数据、模型版本、审计和部署是否能够由医疗机构自主控制;二是决策层面的可信性,即在每一次具体诊断时,系统能否判断自己的答案是否足够可靠,以及什么时候应该把病例交还给医生。
研究人员建立了一套完全在医疗机构本地运行的自主临床AI智能体,并提出多视角可靠性评估框架,从模型内部生成概率、语言表达出的确定性以及多次运行之间的行为稳定性三个角度评价诊断和推理。系统在两个基于MIMIC-IV构建的临床基准上分别达到90.04%和83.8%的诊断准确率,其中最佳本地模型在主要任务上与云端模型仅相差约0.7个百分点。
最重要的发现是,模型“自己说有多确定”并不是最可靠的信号,反而是面对同一病例反复运行时是否持续给出相同诊断最能预测正确性。诊断行为一致性的AUC达到0.860,在人为削弱患者信息后仍达到0.875。当一致性阈值设为0.90时,可以让AI自主处理49.4%的病例,而这些病例的诊断准确率达到98.9%,其余病例则交由医生复核。研究由此提出“选择性自主(selective autonomy)”的临床AI模式:不是让AI处理所有患者,而是让它识别自己相对稳定的病例,并主动将不稳定病例升级至人工审查。
当前医疗大语言模型的评价通常集中于“答对多少题”,但临床部署需要更加复杂的可信性。一个准确率很高的云端模型仍可能面临患者数据离开医院、模型版本变化难以控制、日志和审计受外部供应商影响等问题。因此,研究人员首先提出operational trust(运行可信):数据和模型应在医疗机构能够控制、审计和管理的环境中运行。
但本地部署本身并不能解决医疗安全问题。即使数据完全不离开医院,模型仍然可能做出错误诊断。更危险的是,大语言模型可能以非常确定的语言表达错误答案。因此第二个问题是decisional trust(决策可信):医生需要知道哪些结果值得依赖,哪些结果存在明显不确定性。
这一问题对于AI智能体尤其重要。普通问答模型只生成一次答案,而智能体会不断询问患者、调用血液检查、影像报告和其他工具。早期一次微小的不稳定就可能沿着多轮推理不断传播,最终形成完全不同的诊断路径。研究人员因此认为,临床AI安全评价必须从“平均准确率”转向“每一次决策发生时能否识别风险”。
方法
研究人员构建完全本地部署的双智能体模拟系统,包括Patient Agent和Physician Agent。Patient Agent根据真实病例资料模拟患者,Physician Agent通过多轮对话获取病史,并能够调用体格检查、血液、尿液、微生物、影像、药物和操作等工具,最终输出单一诊断及结构化推理过程。系统使用MIRA-v2的551例7疾病病例、CDM的2,400例4种急腹症病例以及VivaBench的990例跨10个专科病例进行评价。本地部署比较GLM-4.5-Air、GLM-5、Qwen-3.5和GPT-OSS等开放权重模型。研究人员进一步分别对最终诊断和推理过程计算四类指标,包括内部生成概率ProbScore、语言确定性LingCert、临床概念密度ConceptDensity以及重复运行之间的语义一致性Consistency;默认每个病例独立运行5次。随后通过移除Patient Agent真实病史制造信息不足压力测试,并利用不同可靠性阈值模拟“AI自主处理或转交医生”的选择性自主流程。全部临床数据处理均在本地受控环境完成,没有将临床文本传输给外部模型提供商。
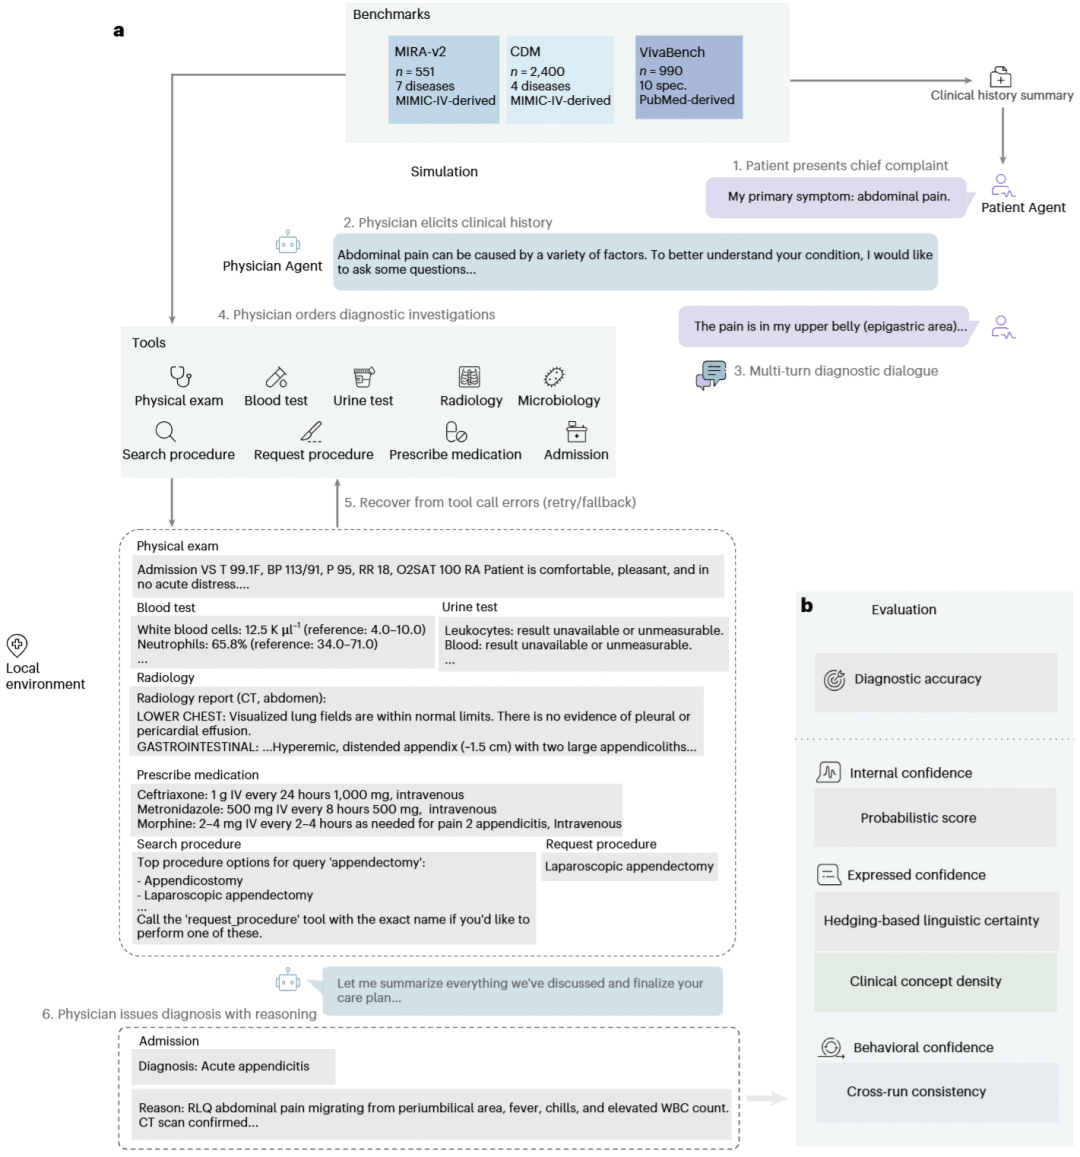
图1:本地部署自主临床AI智能体框架——Patient Agent与Physician Agent多轮交互、临床工具调用、最终诊断,以及内部、语言和行为三个层面的可靠性评价。
结果
本地部署模型的诊断性能接近云端模型
研究人员首先回答一个现实问题:为了让医疗数据留在医院内部,是否必须明显牺牲模型性能?
在MIRA-v2的7疾病任务中,Qwen-3.5达到90.0%的准确率,GLM-5为89.7%,GLM-4.5-Air为88.4%,GPT-OSS为85.3%;作为云端基线的GPT-5.2达到90.7%。因此最佳本地模型与云端基线只相差约0.7个百分点。
在CDM的2,400例急腹症任务中,Qwen-3.5达到83.8%,GLM-4.5-Air达到81.2%,高于此前该基准报告的70.5%开放权重模型结果。错误主要发生在临床表现本身容易重叠的疾病之间,例如胰腺炎与胆囊炎、阑尾炎与憩室炎。
医生盲法复核181个MIRA-v2病例后发现,81.8%的病例中AI诊断和电子健康记录标签都具有临床合理性;另有4.4%的病例虽然AI与数据标签不一致,但医生认为AI诊断本身仍然合理。这说明单纯使用行政诊断标签可能低估AI的实际临床表现。
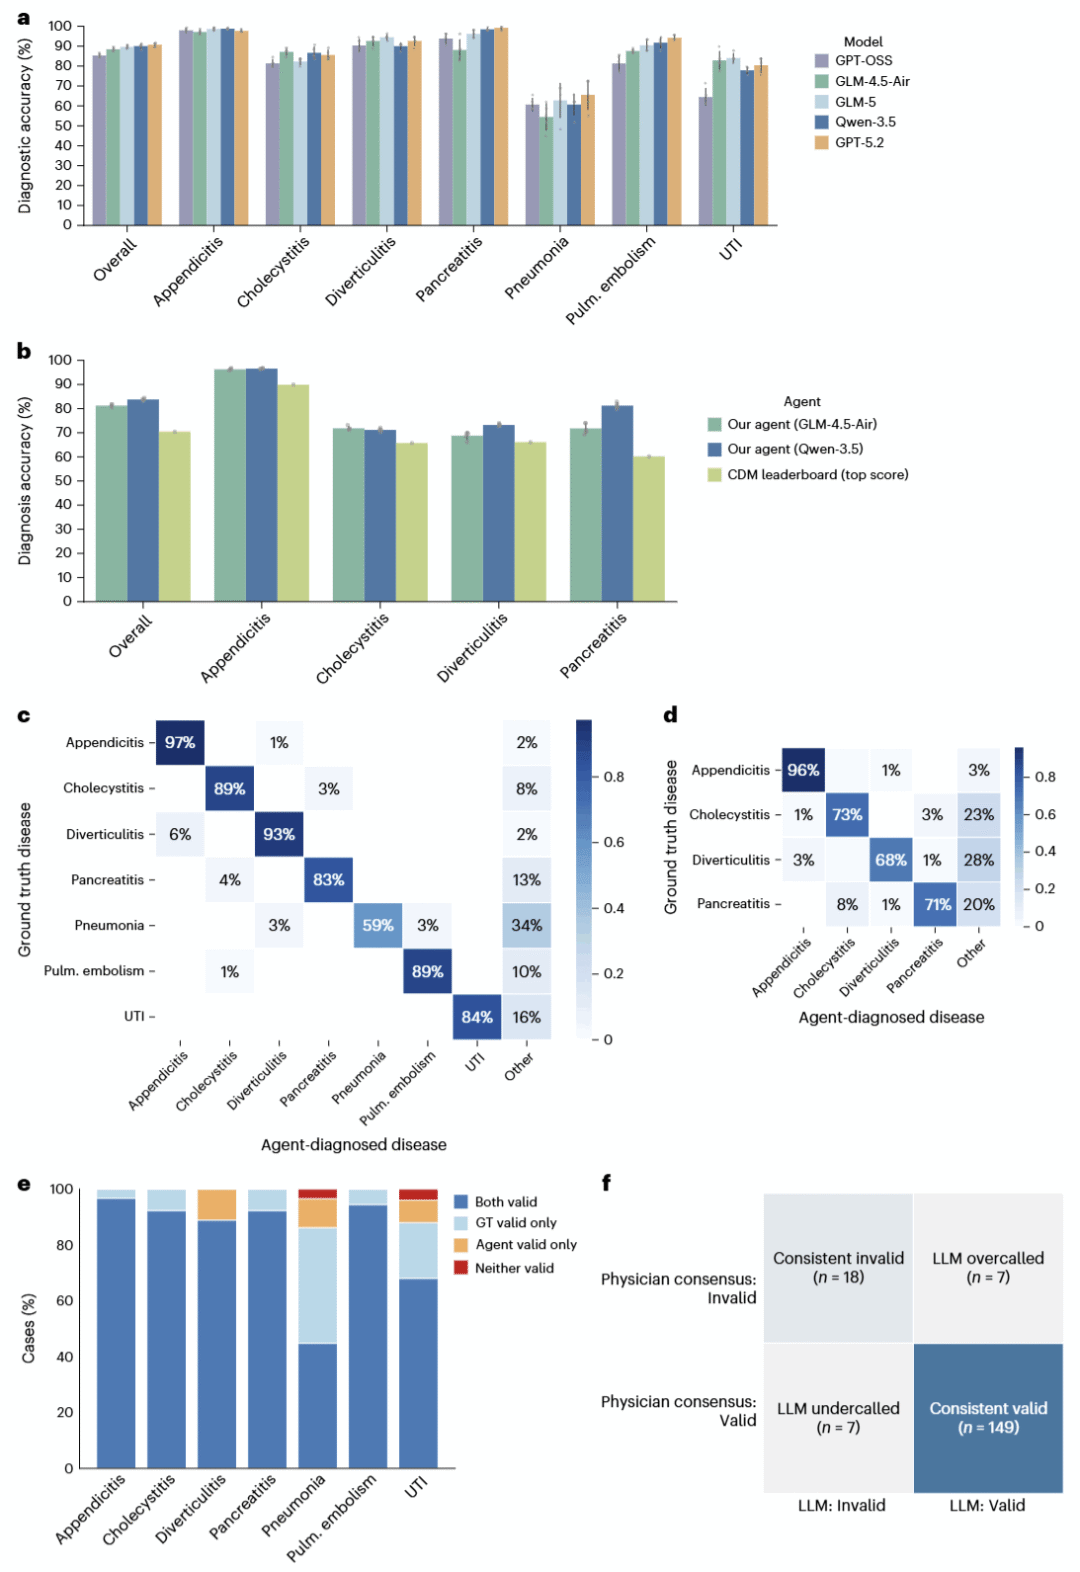
图2:四种本地开放权重模型与云端模型在MIRA-v2和CDM上的诊断性能、疾病混淆矩阵以及医生盲法复核。
“多次是否给出同一个答案”比模型概率更能预测正确性
研究人员随后比较不同可靠性指标。结果非常明确:诊断行为一致性ConsistencyDx是预测诊断正确性的最佳指标,AUC达到0.860,明显高于内部生成概率ProbScoreDx的0.747。
正确诊断高度集中于一致性接近1的区域,而错误病例更多分布于较低一致性区域。相反,模型内部概率存在明显的“高置信错误尾部”:部分错误诊断仍然具有非常高的生成概率。
语言层面的信号则更加复杂。在推理过程中,模型使用“可能”“提示”“似乎”等不确定性语言的程度具有一定预测价值,LingCertR的AUC达到0.792;但临床概念越丰富并不意味着推理越可靠,ConceptDensityR的AUC只有0.426。因此,一段充满专业医学术语的解释可能看起来非常专业,却并不代表它更正确。
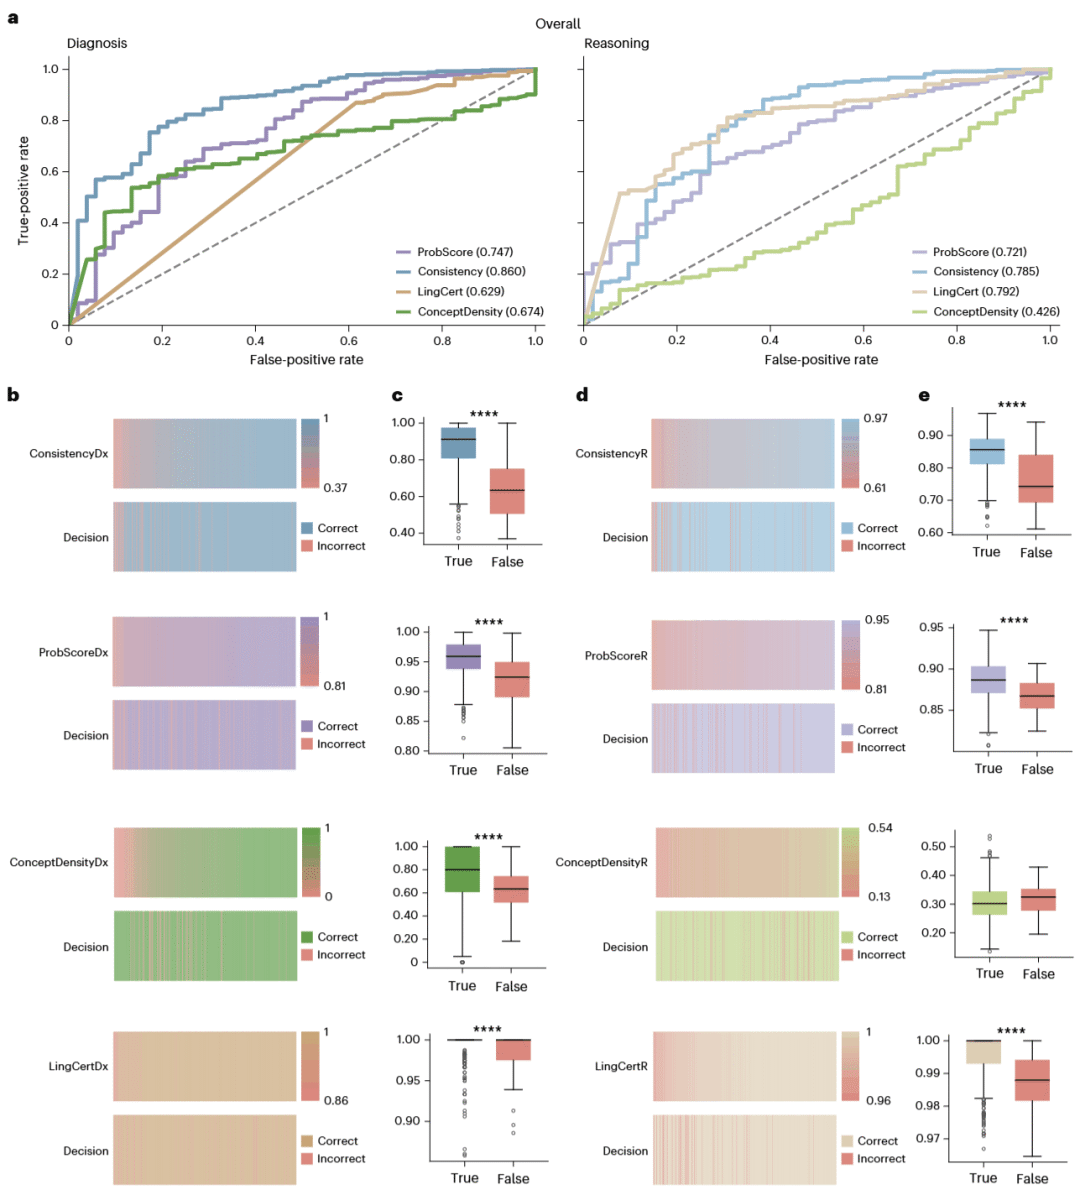
图3:内部概率、语言确定性、临床概念密度和跨运行行为一致性对诊断及推理正确性的预测能力。
高概率并不等于高可靠性
不同置信信号之间只有中等相关性。例如内部概率与诊断一致性的相关系数为0.51,说明它们反映的是不同层面的模型行为。
论文图4展示了一个非常重要的现象:当模型的重复诊断高度一致时,无论内部概率处于低、中还是高区间,诊断准确率都达到约99%–100%;而当行为一致性较低时,即使内部概率很高,错误仍明显增加。
病例分析进一步揭示两种情况。一些高一致性“错误”实际上来自基准标签限制,例如影像提示epiploic appendagitis,但数据集只能使用憩室炎作为代理标签;另一些则是真正危险的高置信错误。另一方面,某些AI虽然最终诊断正确,但由于关键检查缺失,会在五次运行中给出不同答案。这种不稳定性恰好反映了病例本身的信息不足。
因此,行为一致性并不是简单地判断“模型对自己有没有信心”,而是在观察:相同证据重新推理几次后,模型是否仍然坚持同一个临床结论。
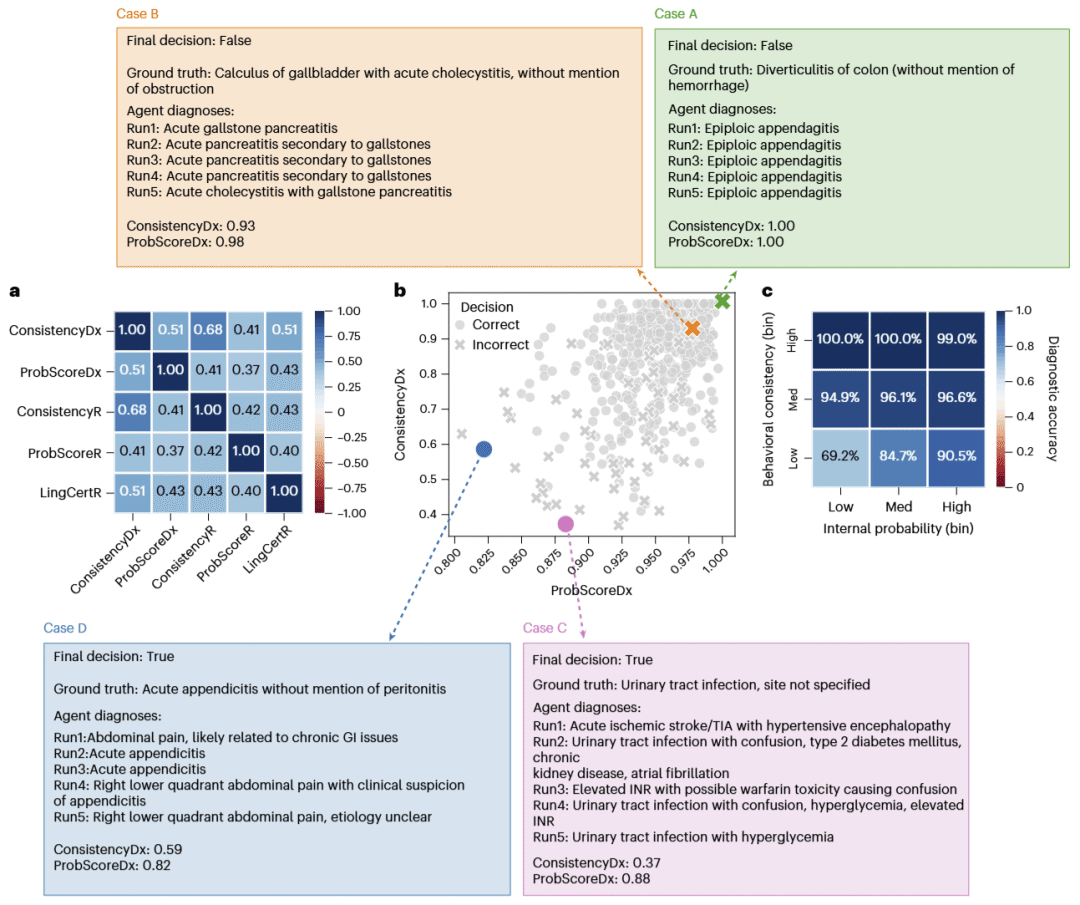
图4:内部概率与行为一致性的二维可靠性空间、高一致性安全区域以及高置信错误和低置信正确病例。
信息不足时,行为一致性比“自信语言”更敏感
为了模拟真实临床中病史缺失或患者信息不可靠的情况,研究人员故意移除Patient Agent的初始病史,使其产生不完整甚至不可靠的信息。结果总体诊断准确率从90.6%下降到70.2%。
此时不同可靠性指标出现明显差异。ConsistencyDx随着诊断性能下降而显著降低,说明模型开始表现出更大的决策不稳定性。相反,内部概率和语言确定性下降很少;在肺炎病例中,诊断准确率下降时,这两个指标甚至反而升高到0.90以上。换言之,模型可能在证据减少以后依然非常自信地表达错误答案。
更重要的是,ConsistencyDx在这种压力条件下仍然保持0.875的AUC。因此,行为稳定性不仅能够在正常条件下预测正确性,在信息质量下降时也能比较敏感地反映风险。
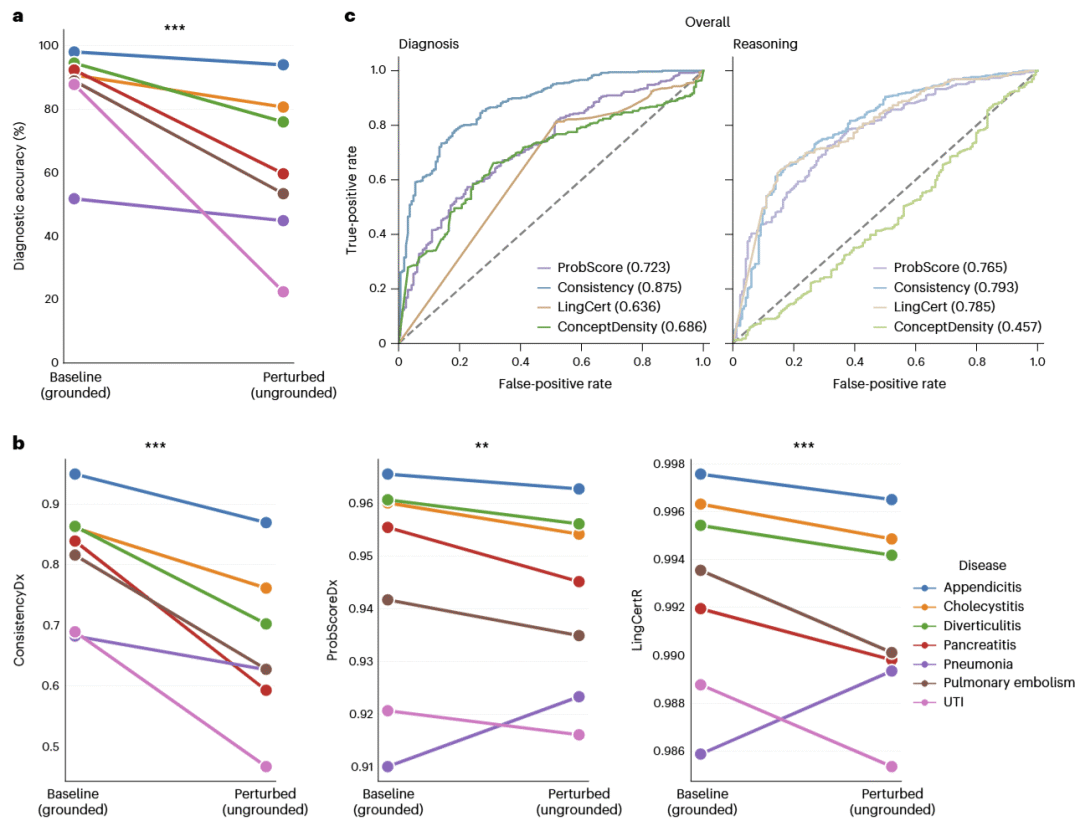
图5:移除真实患者病史后的信息不足压力测试——诊断准确率下降以及行为一致性、内部概率和语言确定性的不同响应。
行为一致性可以实现“选择性自主”
研究最后把可靠性评分真正转化为临床工作流,而不是停留在AUC比较。
当ConsistencyDx阈值设为0.90时,551个病例中有272例达到标准,占49.4%。这些病例如果交给AI自主处理,诊断准确率达到98.9%,仅留下3个错误;其余279例进入医生复核通道,其中集中包含49个错误病例。
相比之下,仅使用内部概率进行筛选效果明显较差。即使ProbScoreDx阈值提高到0.98,也只能保留22.5%的病例,准确率为97.6%。因此,行为一致性能够在相近风险水平下保留更多病例,从而更有效地减少人工工作量。
外部VivaBench验证得到相似趋势。虽然更复杂的跨专科病例使Qwen-3.5总体准确率下降到72.22%,ConsistencyDx仍是表现最好的可靠性指标,AUC为0.719。在一致性阈值0.85时,可以保留32.0%的病例,并将这一部分的准确率提高到89.9%。
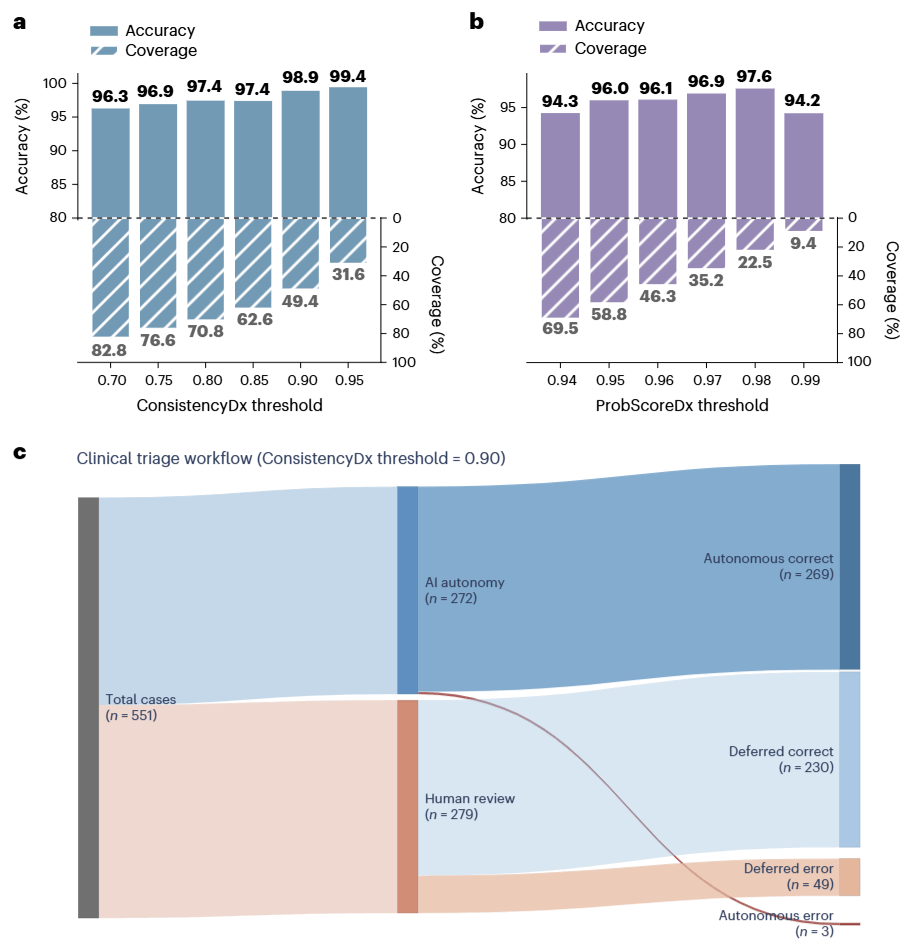
图6:基于行为一致性的准确率–覆盖率曲线及选择性自主临床分流——高稳定病例由AI处理,其余病例升级至医生复核。
讨论
这项研究最重要的贡献并不是证明本地模型可以达到约90%的诊断准确率,而是把医疗AI的“可信”拆成两个可以实际工程化的问题:数据和模型由谁控制,以及某一次具体决策是否值得相信。 本地部署解决前一个问题,决策时可靠性评估解决后一个问题。二者缺一不可。
研究结果也挑战了一个非常直观的假设——模型概率高就意味着答案可靠。实际情况并非如此。在信息不足的压力实验中,内部概率和语言确定性可以维持很高甚至升高,而诊断准确率已经明显下降。相比之下,多次独立推理能否得到相似结论更能反映模型是否处于稳定的决策状态。
因此,研究人员提出的不是“让AI完全取代医生”,而是一种更现实的选择性自主模式。AI首先完成诊断流程,同时进行多次独立推理。如果输出高度稳定,可以进入受机构治理的自主处理通道;如果结果不稳定,则自动升级给医生。这样做并没有消除不确定性,而是把不确定性集中到人工复核通道中。
不过,高一致性也绝不等于正确。VivaBench中仍然存在模型五次都稳定选择错误诊断的情况,其典型原因是过早锁定一个熟悉且逻辑连贯的疾病解释,却忽略真正能够区分疾病的关键证据。因此,一致性更适合作为风险分层信号,而不是安全保证。即使提高阈值,也无法完全消除自主通道中的错误。
行为一致性的另一个现实代价是计算成本。默认方案需要对同一病例运行5次完整的多轮智能体流程,token消耗约增加5倍。增加到10次能够进一步提高高一致性病例的准确率,例如阈值0.90时从5次运行的98.9%提高到99.6%,但覆盖率同时下降,而且GPU计算成本继续增加。 因此,真正部署时需要在安全、响应时间和计算资源之间权衡。
研究还发现,一致性阈值并不能直接跨模型和医院复制。重复次数、采样温度以及用于比较答案语义相似度的编码模型都会改变评分分布。因此“0.90”不是一个普遍适用的临床安全阈值,而只是当前实验配置下的工作点。每一种模型版本、硬件环境和临床任务都需要重新校准。
公平性同样值得关注。研究观察到,在MIRA-v2和CDM中,年龄较大的患者诊断准确率总体低于年轻患者,而性别差异相对较小。如果选择性自主系统对某些人群更容易给出高一致性,而对另一些人群更频繁要求医生复核,就可能形成新的医疗资源分配差异。目前这些结果仍是描述性的,尚不能判断来自病例复杂度、数据构成还是模型偏差,因此需要专门的偏倚审计。
更重要的是,目前所有实验仍属于回顾性模拟,并不是AI已经在医院真实自主诊断患者。两个主要基准都来源于MIMIC-IV,VivaBench虽然增加了外部跨专科验证,却来自发表病例;系统处理的也是文本化临床信息,没有直接解释CT、MRI、病理图像等原始医学影像。研究也没有评价真实临床部署后医生是否会因为AI的“高一致性”而产生过度依赖。
因此,这篇工作的临床意义应理解为提出并验证了一种部署框架,而不是证明自主AI已经可以安全替代临床医生。
总体而言,研究建立了一条清晰路线:**本地开放权重模型 → 自主多轮问诊与工具调用 → 多视角决策时可靠性评价 → 决策稳定性筛选 → 高稳定病例由AI自主处理 → 低稳定病例转交医生复核。 与追求一个能够对所有病例自主决策的“全自动医生”相比,这种框架更强调如何在模型能力尚不完美的情况下合理分配AI与医生的责任。
其中,“本地部署”与“选择性自主”实际上解决的是两个不同层次的问题。本地部署使医疗机构能够控制模型版本、数据流向、日志和计算基础设施,并使患者数据不需要发送给外部模型提供商;选择性自主则进一步解决“即使模型完全在医院内部运行,我们什么时候应该相信它”的问题。研究人员认为,真正具有临床可治理性的医疗AI需要同时具备这两种能力。
值得注意的是,研究没有发现简单增加一个“第二个AI医生”就一定能够提高安全性。研究人员加入了一个由医学模型驱动的鉴别诊断Critic Agent,让它作为“反方”检查主要Physician Agent的诊断,寻找遗漏的高风险替代诊断。然而加入Critic后总体准确率反而从88.4%下降至87.1%,只有肺炎等个别疾病出现部分改善。
这一结果对于当前流行的多智能体医疗系统具有启示意义。直觉上,让多个模型讨论、批判和投票似乎应该比一个模型更加可靠,但如果不同智能体共享类似知识和偏差,额外的讨论并不会自动带来更正确的判断。甚至一个错误的批评意见还可能扰乱原本正确的推理。因此,“增加智能体数量”本身并不是可靠性机制,真正重要的是能否获得具有判别能力的决策时风险信号。
本研究中表现最好的行为一致性恰恰采取了不同思路。研究人员不是让五次推理彼此讨论并最终投票,而是让模型在相同病例上独立运行多次,然后观察最终诊断在语义上是否稳定。也就是说,Consistency并不是答案选择算法,而是一种可靠性传感器。即使最终只采用其中一次诊断,其余重复运行仍然能够提供“这个模型面对该病例是否稳定”的信息。
这种区分非常重要。传统self-consistency通常通过多次生成后投票来提高最终答案正确率,而这里的目标不是利用重复运行“找出正确答案”,而是利用重复运行决定这个病例是否适合让AI自主处理。因此,行为一致性的临床价值主要体现在分流,而不是解码。
研究对高一致性错误的分析也提醒我们,稳定性存在两个完全不同的含义。一种是模型拥有充分证据,因此多次推理稳定收敛到正确答案;另一种则是模型形成了一个非常有吸引力但错误的解释,因此每次都稳定地犯同一个错误。后者是选择性自主最需要警惕的失败模式。
VivaBench中就出现了这种情况。一些模型持续锁定熟悉的综合征叙事,却没有充分利用真正具有鉴别意义的证据。例如在高钙血症病例中稳定判断为多发性骨髓瘤而非原发性甲状旁腺功能亢进,以及将另一病例稳定判断为POEMS综合征而非金属沉积症。这些不是随机幻觉,而是稳定、连贯且错误的临床推理。
因此,未来可靠性系统可能需要同时判断两个问题:模型的答案是否稳定,以及这种稳定答案是否得到足够证据支持。论文已经发现内部概率与行为一致性只存在中等相关,两者可以提供互补信息,但当前研究并没有建立一个已经可以消除高一致性错误的最终组合评分。
这也解释了为什么研究人员反复强调“选择性自主并不消除不确定性,而是重新分配不确定性”。如果将ConsistencyDx阈值设为0.90,551个病例中272例进入AI自主通道,其中269例正确、3例错误;279例被转交医生,其中包含49个AI错误和230个实际上正确但AI不够稳定的病例。
从工作流角度,这意味着系统牺牲了一部分自动化效率换取更高安全性。230个“AI其实答对、但仍然交给医生”的病例看起来像额外工作,但这是风险分层不可避免的代价。如果降低阈值,可以自动处理更多患者,但错误也会增加;提高阈值,则AI自主处理范围进一步缩小,但准确率继续提高。
论文第10页的图6非常直观地表现了这种关系:ConsistencyDx阈值从0.70提高到0.95时,自主覆盖率从82.8%逐步下降到31.6%,而保留病例的准确率则从96.3%提高到99.4%。因此,不存在唯一的“最佳阈值”,医院需要根据具体临床任务的错误代价决定自己愿意处于准确率–覆盖率曲线的哪个位置。
例如,对于低风险、标准化程度较高的任务,机构可能允许更大的AI自主覆盖;而对于漏诊后果严重的疾病,则可以提高阈值,让更多病例进入医生复核。这正是本地部署的另一个潜在优势:模型版本、阈值、升级规则以及验证流程都可以保留在医疗机构自身的治理体系中,而不是由外部服务统一决定。
但研究结果也表明,这些阈值必须动态校准。将重复推理次数从3次增加到5次再增加到10次,在ConsistencyDx≥0.90条件下,保留病例准确率从97.5%提高到98.9%和99.6%,与此同时覆盖率从51.7%下降到49.4%和46.3%,自主通道错误则从7例下降到3例和1例。
这实际上提供了另一个可调节的安全旋钮:不仅可以改变一致性阈值,还可以改变模型重复运行次数。对于特别高风险的病例,可以进行更多次独立推理;对于低风险场景,则可能减少重复次数以节约计算资源。不过,论文没有直接验证这种“根据病例风险动态决定重复次数”的策略,因此它仍然属于由结果自然延伸出的未来方向。
本地部署也并非没有代价。研究使用NVIDIA H200和RTX PRO 6000 GPU运行开放权重模型,而五次完整智能体重复推理使token使用量接近单次运行的五倍。虽然不同运行之间可以并行,但总GPU计算量不会消失。
因此,这篇文章并没有证明“本地AI一定比云端AI更便宜”。它证明的是,在研究所测试的诊断任务中,医疗机构可以通过开放权重模型获得接近云端基线的性能,同时换取更直接的数据、模型和部署控制;至于硬件采购、维护、电力、模型更新和IT人员成本,则需要每个机构根据规模单独权衡。
从临床评价角度,研究还揭示了一个经常被忽视的问题:基准答案本身并不总是等同于唯一正确的临床判断。 在181例医生复核病例中,有些AI被自动评分判错,但医生认为AI诊断同样具有临床合理性。例如数据集标签记录憩室炎,而影像实际上支持epiploic appendagitis;另一个病例以急性胆囊炎为主要标签,但AI根据明显升高的脂肪酶判断胰腺炎,而完整病历中确实记录了胰腺炎作为第二诊断。
VivaBench的问题更加明显。部分病例的基准答案是住院后经过进一步检查最终得到的病因诊断,而AI面对的是患者初次就诊时的信息。在这种情况下,AI可能正确识别当时最需要处理的急性综合征,却因为没有猜到几天后才确认的病因而被评分为错误。研究人员因此强调,临床AI评价不能简单把“与benchmark label不一致”完全等同于“不安全”。
这一点对未来自主医疗AI的评估非常关键。真正临床决策具有时间性:急诊医生面对患者入院第一小时应该作出的判断,与住院三天后结合病理、培养或进一步影像得到的最终诊断并不是同一个任务。因此,未来基准需要更加明确地定义AI在什么时间点、掌握哪些证据、需要做出哪一级别的临床决策。
同时,也不能因为基准存在标签问题就淡化AI真正的高置信错误。研究人员明确区分了“标签不合理导致的表面错误”和“模型稳定但真正推理错误”。后者仍然可能产生严重临床风险,也正是为什么即使Consistency达到很高水平,也不能取消持续的人类治理。
研究还揭示了“推理解释”本身的另一个风险。临床概念密度并没有与正确性正相关,在推理文本中甚至呈相反趋势。这意味着一段包含大量疾病名称、检查指标和医学术语的回答,可能只是看起来更加专业,而不是实际上更加可靠。
这对于医疗大语言模型尤其值得警惕,因为医生和患者可能自然地把详细、流畅、专业的解释理解为能力和确定性的信号。论文结果表明,这种表面特征不能作为可靠性依据。相反,真正有价值的可靠性信号可能需要来自模型行为本身,例如重复推理稳定性,以及未来可能加入的证据充分性、工具调用一致性和反事实稳定性。
从更长远的角度看,这项研究实际上把医疗AI部署问题从“哪个模型排行榜准确率最高”转向了“如何构建一个能够管理模型错误的临床系统”。即使未来基础模型的平均准确率继续提高,也很难保证所有病例都正确。临床真正需要的不是一个永远不犯错的模型,而是一个能够在受控环境中运行、识别自身风险并把困难病例交还给医生的系统。
这也是“选择性自主”比“完全自主”更加重要的原因。自主程度不必是一个固定属性,而可以成为病例级动态变量:同一个AI面对典型阑尾炎时可能拥有足够稳定的证据,可以承担更多工作;面对信息缺失、多个疾病高度重叠或者罕见复杂病例时,则自动降低自主程度。
当然,这距离真实临床应用仍有相当距离。研究使用的是回顾性数据和模拟Patient Agent,而不是真实患者;Physician Agent调用的是结构化文本工具,而不是直接操作医院电子病历系统;模型也没有原生读取影像、病理切片或实时生命体征。研究人员明确指出,医学影像理解是一个独立问题,不能认为在现有文本框架中简单增加一个工具就已经解决。
此外,研究没有直接测量选择性自主在真实医院中是否能够减少医生工作量。即使AI把约一半病例标记为可以自主处理,现实中医生是否愿意完全不复核这些病例、医院责任制度是否允许,以及高一致性评分是否会导致自动化偏见,都需要前瞻性临床研究回答。
因此,这项工作的价值更适合被理解为一个从模型能力走向临床治理的概念验证。它证明了三个关键点:开放权重模型可以在本地环境中保持具有竞争力的诊断能力;行为稳定性可以作为比单次模型概率更加有效的决策时可靠性信号;这种信号又能够进一步转化为明确的AI–医生分流规则。
总体而言,这项研究建立了一套较完整的医疗AI可信部署逻辑:机构内部运行模型和数据 → AI完成多轮临床推理与工具调用 → 在决策时评估模型行为稳定性 → 稳定病例进入受治理的自主处理 → 不稳定病例自动升级至医生 → 医疗机构持续校准阈值、审计偏差和监测错误。
其核心思想并不是证明AI已经能够独立成为医生,而是重新定义“可靠的医疗AI自主性”:自主权不应该因为模型平均准确率很高而一次性授予,而应该根据每一个病例的决策可靠性动态分配。
这也可能是文章最值得关注的临床意义。过去医疗AI通常被划分为“辅助医生”或“自主AI”两类,而这项研究提出了中间状态——选择性自主。AI可以承担一部分高稳定、低风险病例,把有限的医生注意力集中到真正困难和不确定的病例上。
如果未来能够在多中心真实临床数据中验证这一框架,并加入医学影像、多模态EHR、真实患者交互、前瞻性安全评价和系统性公平性审计,那么医疗AI的发展重点可能逐渐从追求“一个模型能答对多少病例”,转向更加临床化的问题:对于眼前这个患者,AI的判断到底有多可靠;如果不够可靠,它是否知道应该把决定交还给医生。 这正是本地治理与决策时可靠性评估结合后所试图建立的医疗AI工作模式。
整理 | DrugOne团队
参考资料
Zhang, L., Wölflein, G., Ferber, D. et al. On-premise medical AI agents for reliable clinical decision-making. Nat Med (2026).
https://doi.org/10.1038/s41591-026-04609-x
内容为【DrugOne】公众号原创|转载请注明来源
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢