

RAP:用滚动评测检验大模型的研究关注度预测能力
当智能体和科研工具不断缩短从想法到实验的距离,科研的比拼也在向上游移动:真正困难的,可能不再是把研究做出来,而是把 attention 押对——看了今天的论文,明天该做什么呢?
如果智能体真能做到这一点,它就不再只是帮人查资料、做分析的执行工具,能进一步参与研究选题和科研规划。这也让一个看似普通的任务变得越来越重要:
“搜索一下文献,判断这个领域未来半年会往哪些方向发展。”
这条指令很容易得到一份像样的答案。搜几轮论文,列出几个热点,再讲出一套听起来合理的变化逻辑。但预测的价值要到半年后才知道:模型指出的方向是否真的变得更活跃,必须交给真实投稿来检验。
为了回答这个问题,我们提出 Research Attention Prediction(RAP,研究关注度预测),把研究趋势预测转化为研究方向的活跃度预测问题,并构建了第一个评测基准。在每个预测时间点,模型可以查阅截至当前已经发布的论文,然后预测接下来半年新提交的论文中,八个预先设定的研究方向各占多大比例。评测时,我们把预测窗口内实际发生的投稿分布作为真实结果,核对模型的答案。整个评测基于 35 万余篇 人工智能/机器学习 论文,包含 278 个研究板块,覆盖 2024 年初到 2026 年初的五个预测时点。
RAP 给出的结论并不乐观。七个模型中,有六个能借助近期文献恢复一部分当前的研究活动,但没有一个模型稳定超过“最近趋势延续”这一简单基线。允许模型查阅更大范围的历史文献,也没有让预测变准:在较长历史中,模型更容易把注意力分给较早的文献,却没有因此获得更好的趋势判断。即使把各方向准确的历史份额直接交给模型,它对未来作出的调整也没有带来稳定收益。
这意味着,科研趋势预测至少要回答两个问题:模型能不能先把现在看清,以及看清之后能不能对未来作出有价值的判断。
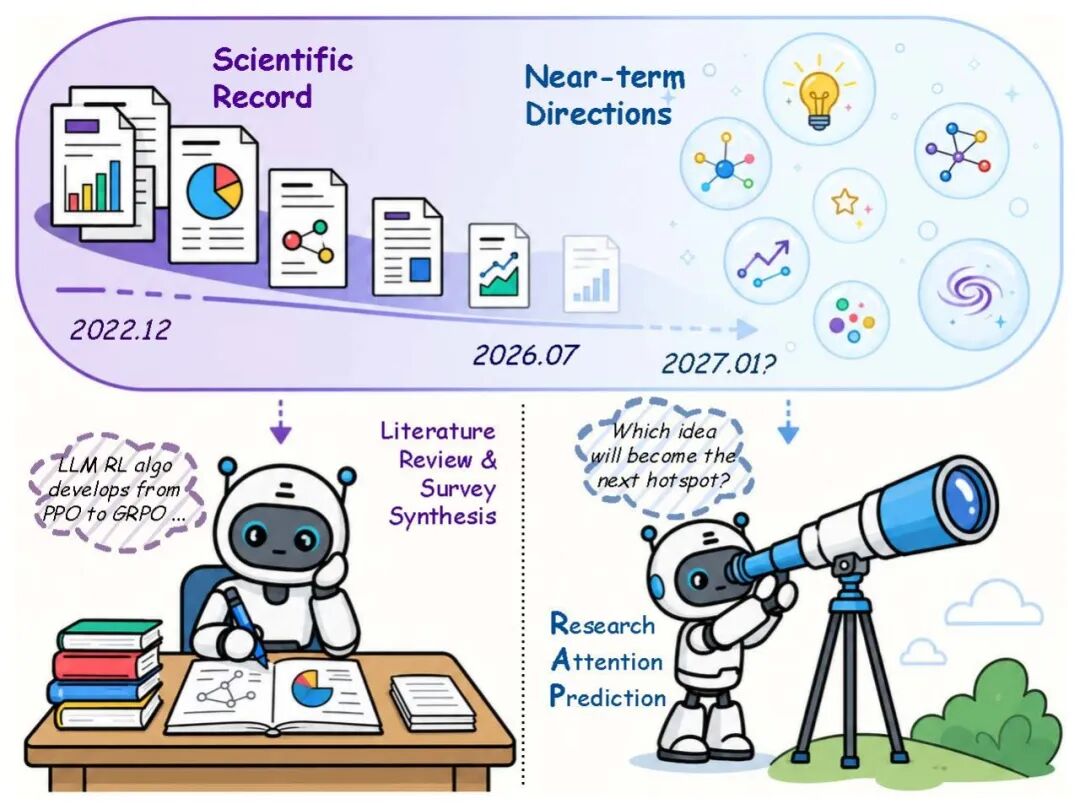
图 1:RAP 关注的是未来半年内,各研究方向在新提交 arXiv 论文中的相对份额。它测量研究活动的分布,不等同于科研价值、影响力或资源投入。
把“趋势判断”变成有后续答案的预测题
未来的研究趋势很难用某一位专家的答案来评判。即使面对同一个领域,不同专家也可能因为不同的观察时间和视角,给出截然不同的判断。因此,检验模型是否真的会预测,不能只看它与某个时期某位专家的观点是否一致,应该把问题变成一个能在半年后由真实结果揭晓的预测任务。
因此,我们在 RAP 中把问题聚焦为:
在未来半年首次提交到 arXiv 的相关论文中,八个预先确定的研究方向将分别占多大比例?
这里的“研究关注度”,指新提交论文在不同方向上的相对分布。它衡量的是研究活动转向了哪里,不代表论文质量、引用影响或科学价值,也不负责发现八个方向之外的全新路线。
我们从 356,357 篇 AI/ML 相关 arXiv 论文出发,构建了 278 个研究板块的评测样本。每个板块都有八个预先构建的研究方向,而且在整个评测期间保持不变。这样的设计,允许我们将不同时点的预测和真实结果放在同一把尺子上比较。
每个研究板块在 2024 年 1 月至 2026 年 1 月之间被连续考察五次,共形成 1,390 个“研究板块—预测时点”任务。在每个时点,模型只能搜索查看当时已经出现的论文,并预测随后半年的分布;评估时则用半年后的真实投稿结果揭晓答案。随着时间的滚动,我们也能观察模型是否会根据出现的新信息,动态更新对于某个板块的判断。
评测结果首先看八个方向排序的准确性,即模型能否把未来更活跃的方向排在前面。我们用斯皮尔曼相关系数衡量模型给出的方向排序与真实排序的一致性;作为补充,再检查模型给出的相对份额与真实分布有多接近。考虑到模型可能在训练中见过较早时期的结果,我们还单独分析了目标窗口完全晚于其知识截止时间或发布日期的预测。
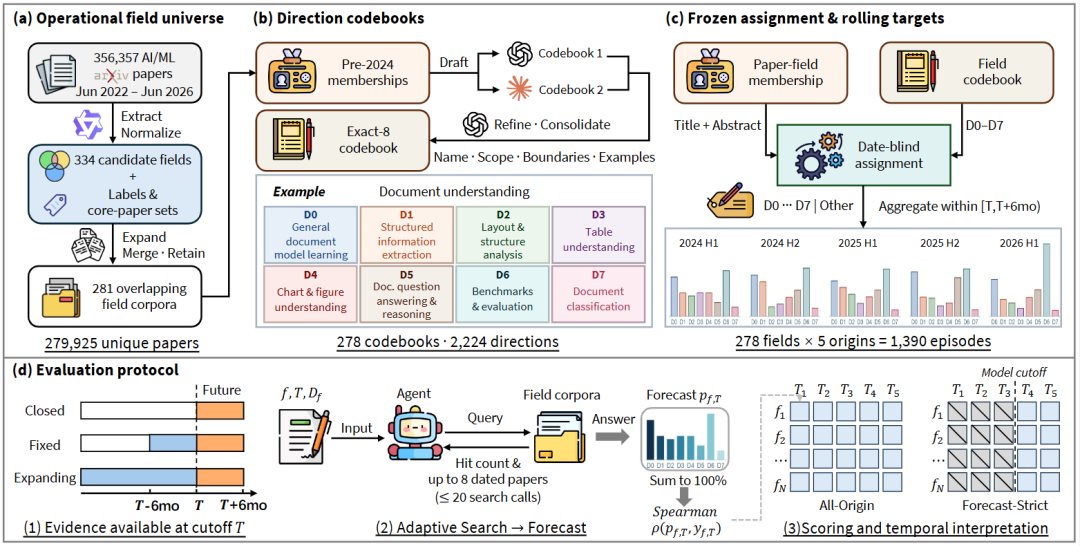
图 2:RAP 使用固定的研究板块定义、方向代码表和论文归类规则,在多个时间点重复进行“只看过去、预测未来半年”的评测。八个方向是操作性的测量坐标,并非具体领域的唯一或专家认可的完整分类。
能看的历史文献越多,预测就会越准吗?
我们让模型在三种条件下完成同一个预测任务:
不搜索(Closed):模型不进行论文搜索,凭借先验知识直接预测。
只看最近半年(Fixed):模型只能搜索预测时点之前六个月的在库论文,然后给出预测。
能看全部历史(Expanding):模型可以搜索预测时点之前的全部在库论文,然后给出预测。
后两种条件的搜索工具和轮数上限完全相同,区别只有能看的时间范围。在每个轮次里,模型将自行决定搜索词,每次会看到搜索的命中数量,以及最多八篇带日期的论文标题和摘要。
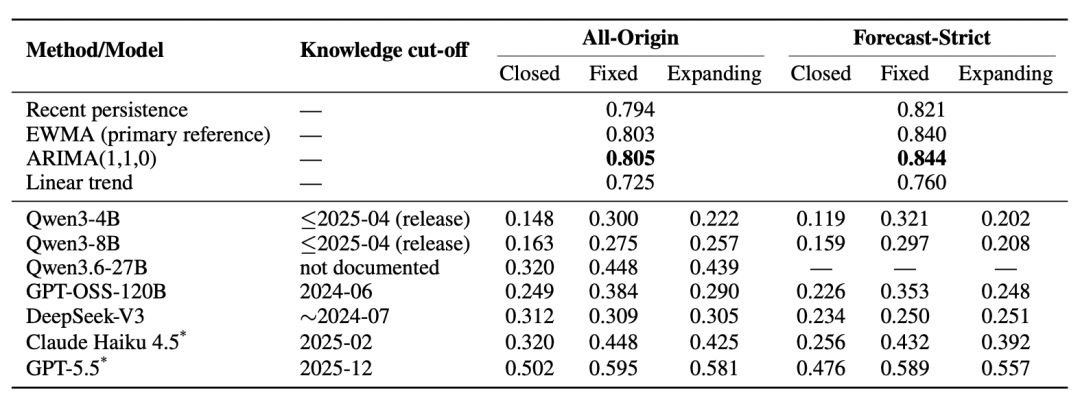
评测的结果很清楚:只让模型搜索最近半年的论文,七个模型中有六个比完全不搜索表现更好。近期文献通常确实能帮助模型判断接下来的研究趋势。
然而按照直觉,在能看到更长的历史时,模型应该更容易补全一个方向的发展脉络,再据此判断下一步。但结果正好相反:把搜索范围放宽到全部历史论文后,七个模型没有一个比只看最近半年更准,绝大多数反而下降。两种条件下,模型实际使用的搜索轮数几乎一致,而且都没有用满搜索预算。因此,这个下降不是搜索次数不够造成的,而是模型没有把更长的历史转化成更有用的证据。即便只看模型知识截止时间之后的预测,这一现象依然存在。
所以,问题并不是“搜索文献没有用”,而是:
能搜索更多历史文献,不等于模型能从中挖掘出对当前预测最有用的证据。
更扎眼的是,我们对比的几种传统基线都超过了表现最好的智能体:直接假设最近半年的趋势会延续的 Recent persistence、指数加权移动平均(EWMA)、根据历史变化规律向前推算的时间序列模型 ARIMA。这一结果在全部时间点都是如此,即使比较具体份额的误差,四个重点分析的模型也没能超过这些传统基线。
沿用近期状态,反而比直接预测未来更准?
模型会查文献、做调研,但在预测科研趋势时,它能把这些能力用好吗?我们设计了一组对照:让模型自己查文献、调研现状,再把这个现状直接延续到未来,看看是否比直接让它预测未来更准。
具体来说,我们选取四个模型,让它们分别完成两个任务:
预测未来 / Forecast:预测接下来半年的方向分布。
调研现状 / State:估计刚刚过去半年的方向分布。
State 更像经典的深度研究任务,模型要自己搜索文献、估计各方向的活跃程度,只是最终要回答的从“接下来会发生什么”变成了“已经发生了什么”。两种任务的其他设置都保持一致。
为了进行对比,我们把 State 的结果直接当作下一半年的预测——也就是假设最近的热度会延续。这样,我们就能以模型自己能够还原出的近期状态为参照,观察它从“理解现状”转向“预测未来”后,究竟是在原有基础上前进了一步,还是把原本能看清的信息弄丢了。
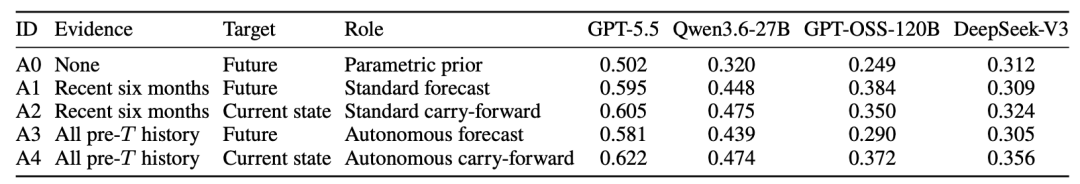
当模型可以检索全部历史文献时,在 GPT-5.5、Qwen3.6-27B、GPT-OSS-120B 和 DeepSeek-V3 上,“把现状延续到未来”都比执行直接预测未来这个任务的结果更准确。而当模型只能查看最近半年的文献时,这种差距明显缩小。也就是说,在较长历史记录中自主搜集证据并完成预测时,直接 Forecast 的端到端结果反而不如 State 的结果往前平推。更大的历史文献搜索范围,进一步暴露了模型不会做趋势预测任务的问题。
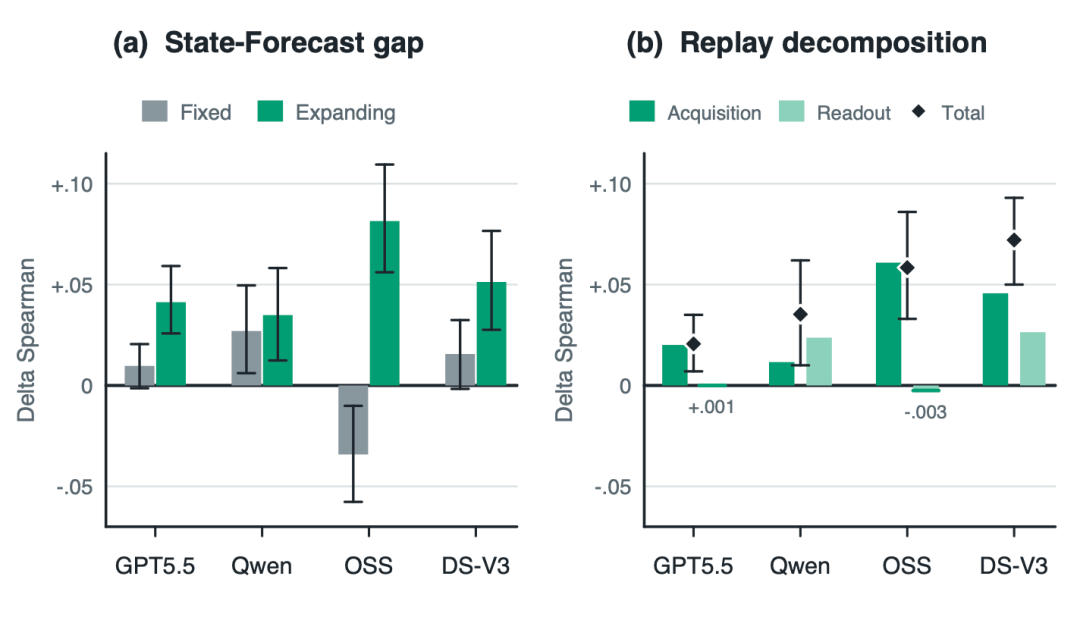
图 3:左图比较“把现状延续到未来”与直接预测未来;右图通过固定证据回放,检查差距来自找资料还是最后作答。图中数值是方向排序相关性的变化,不是百分比。
差距从哪里产生:找资料,还是作判断?
进一步的,我们把“找资料”和“作判断”拆开:将两类任务各自使用的搜索词和返回结果完整保留下来,再让模型分别根据这两套资料回答同一个问题——未来半年的研究趋势是什么?
如图 3(b) 所示,换上“调研现状”时找到的资料,四个模型的未来预测都更准确了。 对齐搜索次数后,其中三个模型仍有明显提升。这说明,模型在执行未来趋势预测时,对所需证据的搜集就已经出现了偏差。
它们究竟找了什么?如图 4(c) 所示,在可以检索全部历史文献时,模型预测未来时搜集的论文条目中,只有 47%–80% 来自最近半年,其余来自更早的研究。这引出了一个更具体的问题:模型是搜索词没选好,还是把时间范围放得太宽?
我们重放了四个模型的 86,284 次搜索调用,保留预测任务原本使用的搜索词,把检索范围限定在最近半年,并按相关性返回结果。结果发现,搜索词不变,收窄时间范围后,找到的论文在各研究方向上的分布就更接近未来的真实分布。 这说明,模型已有的搜索词能够找到有用的资料,但它在预测时没有充分聚焦最能反映近期状态的证据。
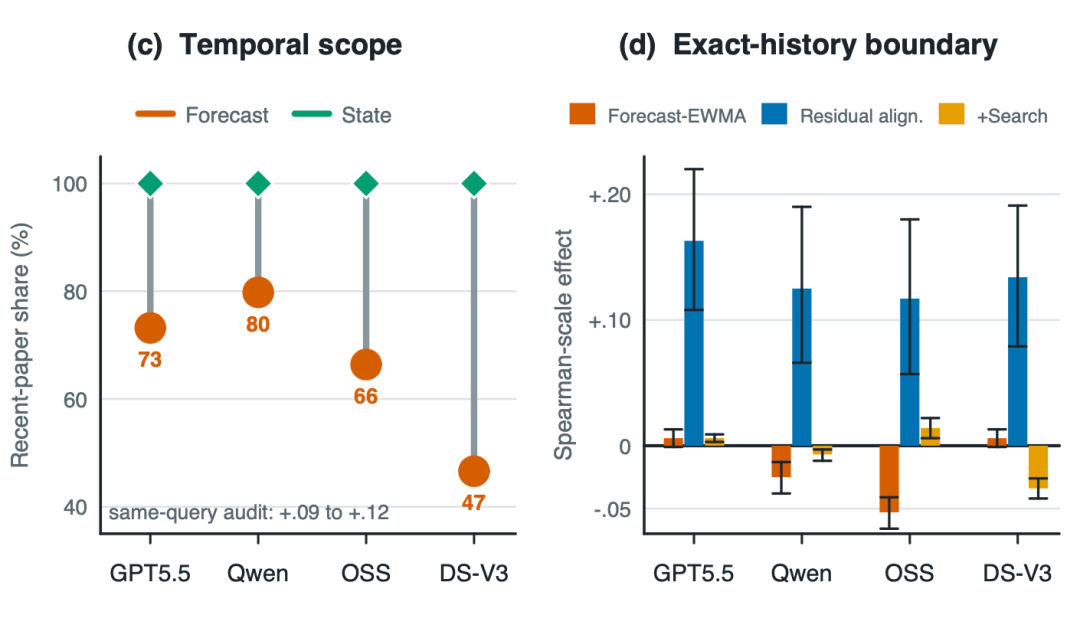
图 4:左图展示直接预测与调研现状时,返回结果中最近半年论文的占比;右图检验在直接提供准确历史分布后,模型能否作出有效的未来调整。
看清现状后,模型的预测调整有用吗?
为了绕过搜索和统计带来的误差,我们直接把历史上各方向的准确论文份额交给模型。这样,模型面对的是一个已经看清的现状,接下来只需要判断:未来半年哪些方向应该上调,哪些应该下调,相对顺序是否需要变化。
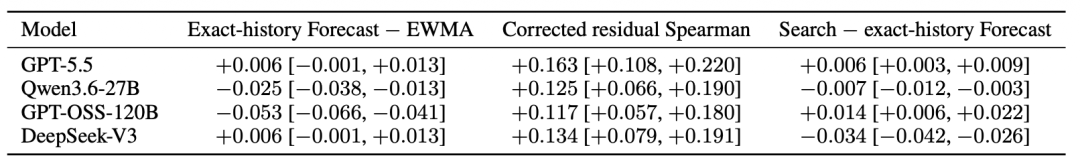
从结果来看,四个模型确实都使用了这些数据,也对哪些方向会上升、哪些方向会下降作出了判断,但这些主动调整并没有带来稳定收益。仅提供准确历史数据时,没有一个模型可靠地超过 EWMA;其中两个模型甚至表现得更差。换句话说,模型会对未来变化作出判断,这些判断却没能让预测变得更准。与其让模型主动调整,结果往往还不如按照历史惯性向前推。
在提供准确历史数据之后,我们进一步开放搜索给模型,看看它们的判断调整是否会在多轮搜索后变得有效。但最终,只有 GPT-5.5 略微超过 EWMA。把多个预测时点连起来看,没有一个模型能可靠地跟上每半年的趋势变化。模型的问题不只是没看清现在。即使现状已经准确给出,它对未来作出的调整也常常不如不调整。
能不能通过训练,让模型更会预测?
我们还做了一个小样本的探索性微调实验:用 90 条根据历史实际结果整理的完整预测轨迹,对 Qwen3-4B 进行监督微调。这些轨迹来自 45 个开发集板块;测试则放在测试集的 211 个板块、两个更晚的时间点上,让模型重新查文献、做预测。
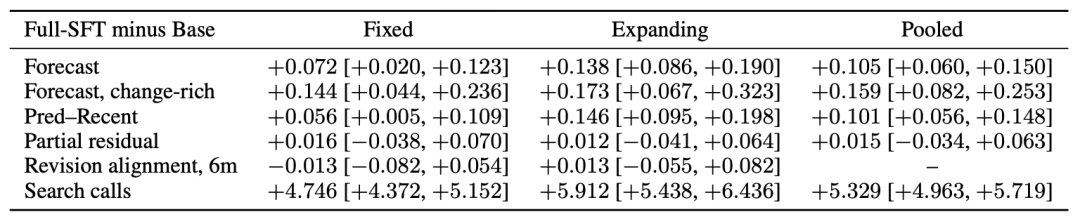
训练后,衡量方向排序准确性的相关系数平均提高了 0.105。在趋势变化较明显的子集中,提升达到 0.159。这说明,模型可以通过真实结果的反馈学会更好地完成 RAP 任务,而且这种提升能够延伸到训练之外的板块和更晚的时间点。至于它是否真的能学会更好地捕捉研究趋势变化,还需要未来工作进一步探究。
总结:科研智能体还需要补上什么能力?
RAP 显示,要让科研智能体真正具备趋势预测能力,至少需要强化两项彼此关联的能力。
第一项是在预测未来之前,准确重建当前的研究状态。模型需要从长时间跨度的文献中建立对于具体领域、具体研究方向的认知,收集最能反映当前状态的证据。现在的模型已经能完成一部分现状调研,但在预测未来时,它的行动策略仍然需要进一步校准。
第二项是在现状基础上,给出真正有效的未来判断。即使已经知道各方向的现状,模型仍需要判断未来哪些趋势会延续、哪些会改变。当前模型确实会基于现状作出调整,但这些调整并未带来更好的整体预测效果。
RAP 的结果表明,当前科研智能体在重建现状和判断未来这两件事上都还不够可靠。要让模型给出真正有效的未来预测,还需要后续工作在这两方面继续探索和优化。
复旦大学数据智能与社会计算实验室
Fudan DISC
联系方式:disclab@fudan.edu.cn
地址:复旦大学袁天凡、慧敏校园C栋

点击“阅读原文”跳转至Github
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢