



引入一万个Agent,确实能挖出很多洞。但背后的成本是巨大的——在多数真实业务场景里,这样挖出来的漏洞价值,其实和投入并不匹配。在我们真实的业务场景里,我们选择提前布局「安全智能性价比」,并已经在真实广泛的业务环境和CyberGym等国际榜单上,用一个27B模型跨尺寸领先。

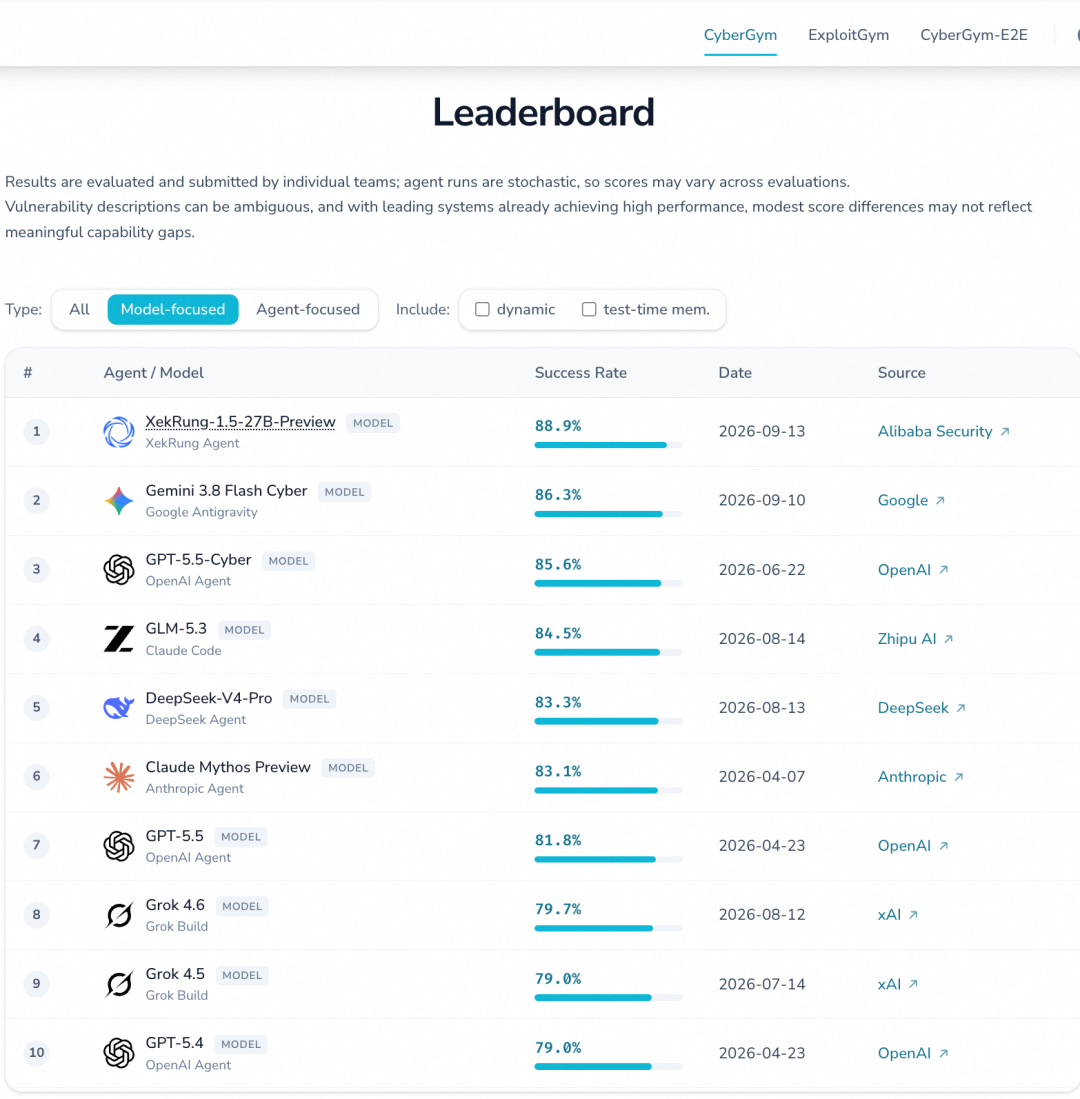
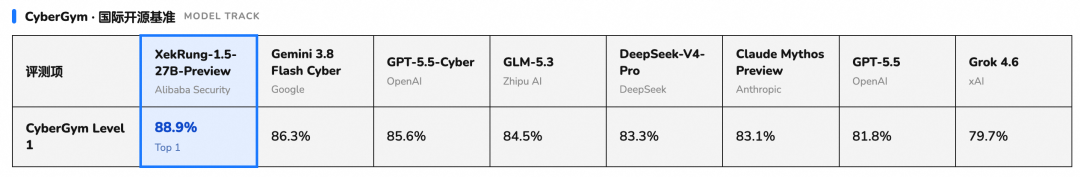
阿里巴巴集团安全AGI实验室自主研发的面向网络安全垂直领域的伏渊息壤大模型XekRung-27B,交出了一份「以小搏大」的成绩单:基于Qwen3.8-27B,经安全领域训练与极致的智能压缩,它在Cyber Gym Level 1上取得88.9%的成功率,击败参数量为其几十到几百倍的GPT-5.5-Cyber、Claude Mythos、
Gemini 3.8 Flash Cyber等国外顶级闭源模型,登顶模型榜单Top1。
这份成绩的含金量,在于榜单的纯粹:CyberGym的模型榜单(Model-Focused)不同于可以叠加fuzzing工具、动态知识库等外挂能力的智能体榜单(Agent-Focused),它只使用通用Harness,不设固定阶段、不挂任何外部工具与知识库,更加纯粹地反映模型的安全智能。而正是这个长期由国外巨头主导的榜单,如今正被DeepSeek、智谱、阿里等国产模型改写。
更关键的是,伏渊息壤不是只存在于榜单上的模型。它已在SDL、反入侵、DLP、数字资产管理、智能体安全等阿里安全内部业务场景规模落地,日均调用超3000万:参数极小、成本极低、智能密度极高,「安全智能性价比」在真实业务中已经产生收益。
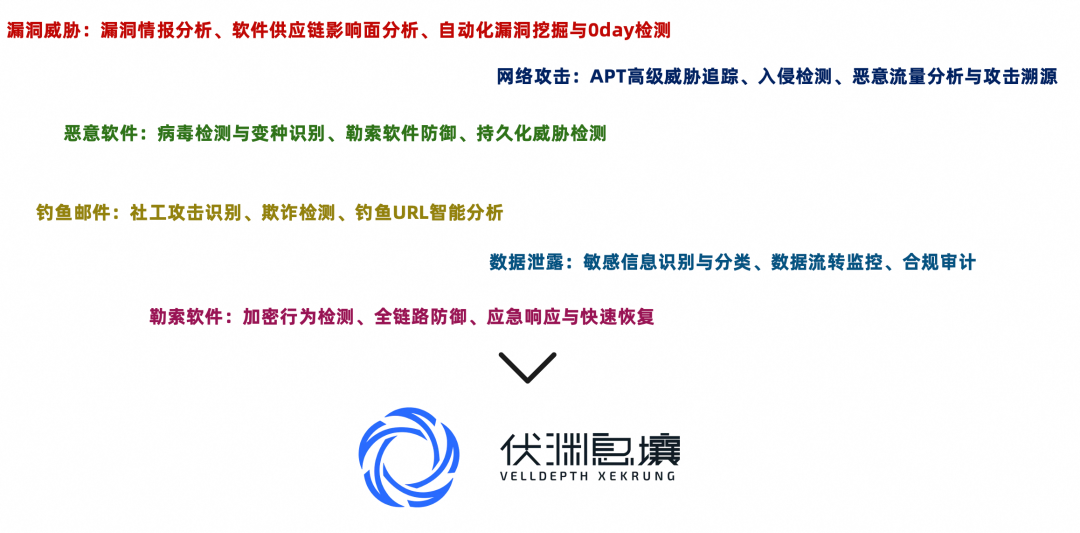
伏渊息壤大模型已经广泛落地在阿里巴巴集团内部网络安全、数据安全等一系列真实场景中,CyberGym所属的二进制漏洞PoC仅为伏渊息壤一部分能力的缩影。
领域知识的极致压缩,价值在于「以小搏大」:用更极致的算力与token成本,覆盖过去需要堆人力、堆资源才能完成的任务。在漏洞挖掘、全链路对抗演练这类重点且复杂的业务场景中,伏渊息壤同样具备优秀效果——从信息收集、漏洞定位,到PoC构造与验证,能够以Agentic的方式串起完整链路。
这正是「安全智能性价比」的含义:不是单纯追求无成本意识的参数Scaling,而是在真实业务的成本约束下,基于领域积累和对智能机理的深刻理解,把每个参数单位的智能都用在刀刃上。
极致的成本压缩,来自三个层面的协同。
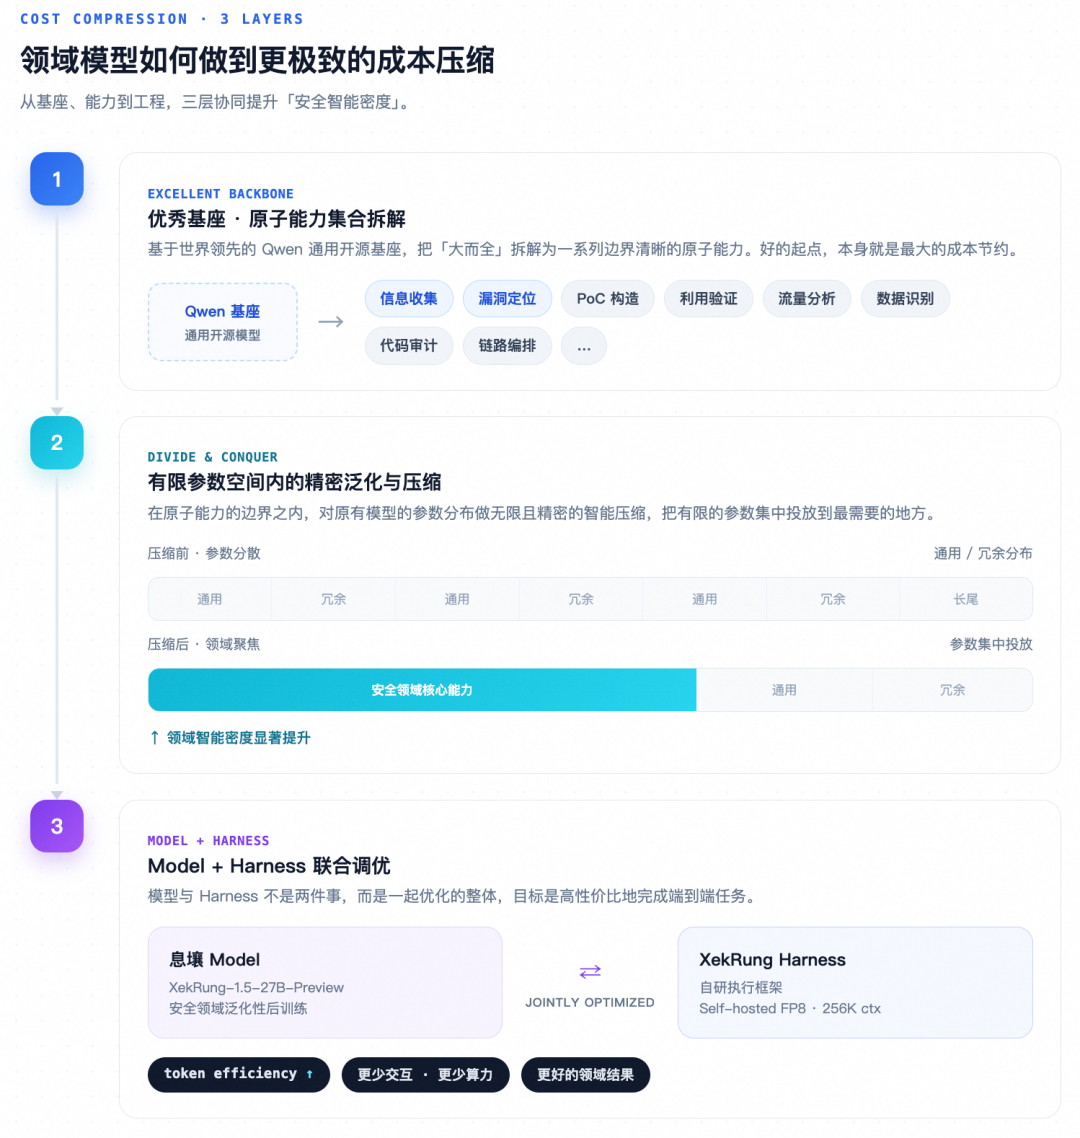
其一,优秀的Backbone。伏渊息壤基于Qwen基座训练。Qwen是世界上领先的通用开源模型,为领域能力的进一步生长提供了扎实的铺垫——好的起点,本身就是最大的成本节约。
其二,能力上的Divide-and-Conquer。我们不追求让一个模型能力「大而全」,而是把安全能力完整地拆解、沉淀为一系列原子能力集合。在这些明确的边界之内,可以对原有模型的参数分布做无限且精密的智能压缩,把有限的参数集中投放到最需要的地方,从而大幅提升领域智能密度。
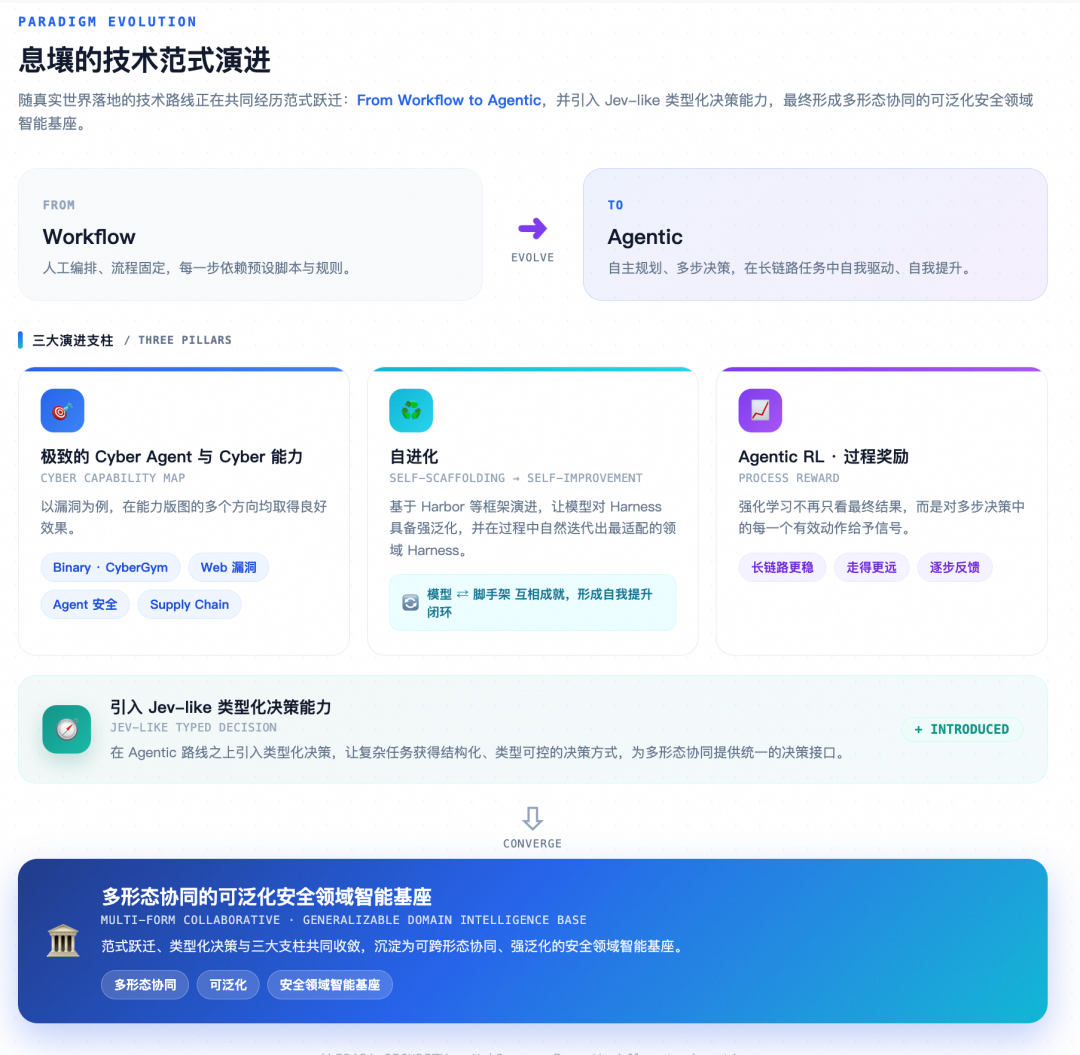
以漏洞为例,在多个技术方向我们进行总结归纳。宏观层面存在共性,微观层面以差异为主、但仍有部分共性可迁移:
✅ Binary:二进制漏洞发现、验证、利用、修复;
✅ Web:Web漏洞的发现、验证、利用、修复;
✅ Agent:面向智能体系统自身的安全;
✅ Supply Chain:供应链安全的检测与防御。
同时伏渊息壤随真实世界落地的技术路线,正在共同经历范式跃迁:From Workflow to Agentic,并引入Jev-like类型化决策能力,最终形成多形态协同的可泛化领域智能基座。
以能力项为基础,伏渊息壤模型同时深耕安全领域的精密训练:
✅ Security-trajectory SFT:使用经脱敏、过滤与合规的安全轨迹做监督微调;
✅ Agentic RL:以带工具调用的Agent式强化学习,训练多步决策能力,以Executable、Verifiable的Signal作为对齐反馈;同时RL不再只看最终结果,而是引入过程奖励,对多步决策中的每一个有效动作给予信号,让Agent在长链路任务中走得更稳、更远;
✅ Failure-sample utilization:把失败样本转化为「失败原因→纠正动作」的学习对,充分提升数据利用率。
其三,技术上的Model+Harness联合调优。模型与Harness不是两件事,而是一起优化的整体。目标是同一个:高性价比地完成端到端任务。因此我们通过适配加自进化的技术来实现联合调优。
Self-Scaffolding to Self-Improvement:在伏渊息壤模型的Harness适配上,我们除了利用常见Harness,还基于Harbor等框架,通过自进化的方式来使得模型对Harness具备强泛化能力。在这过程之中,自然迭代出最适配模型的领域Harness,同时通过Harness进行数据的Rollout和Verifiable的训练。模型与脚手架互相成就,形成自我提升的闭环。
以CyberGym评测为例,伏渊息壤模型搭配运行在自研的XekRung Harness上,配合自部署FP8推理与256K上下文,追求最高的token efficiency——用更少的交互与算力,拿到更好的领域结果。
我们从三个维度评估伏渊息壤,同时确保训练数据不含任何污染。
Internal Bench多项高质量内部业务基准:覆盖10余项真实业务场景的安全能力评测,包括Workflow和多种Harness的Agentic评测场景,验证伏渊息壤在实际环境中的效果。
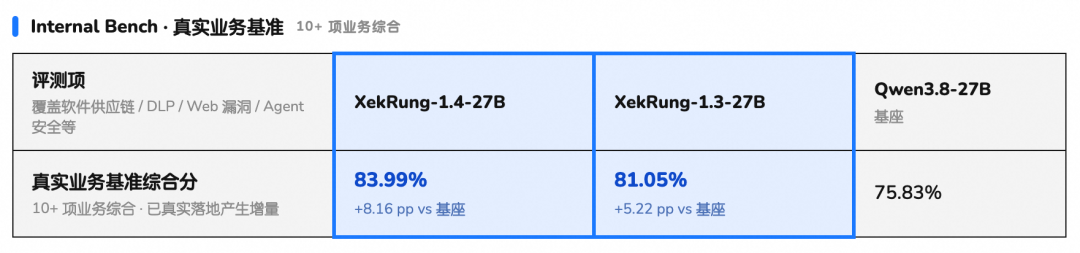
在覆盖供应链安全、数据泄漏防护、Web漏洞检测与修复、Agent安全等大方向的真实业务基准上,以Qwen3.8-27B为backbone,伏渊息壤带来了已经真实产生的效果增量。Bench数量一旦变多,综合分的提升愈发困难,而伏渊息壤能力提升在真实安全业务中持续兑现。
CyberGym等开源基准:XekRung-1.4等系列版本模型已在阿里各类安全业务中投入使用。而作为下一代旗舰模型的预览版,XekRung-1.5-27B-Preview让「“小”参数」的伏渊息壤击败了GPT-5.5-Cyber、Claude Mythos等国外顶级超大尺寸闭源模型,登顶Top1。这表明,在模型的安全能力项上做深做足,并通过Model+Harness联合自进化,可以在安全领域上达到非常好的效果。
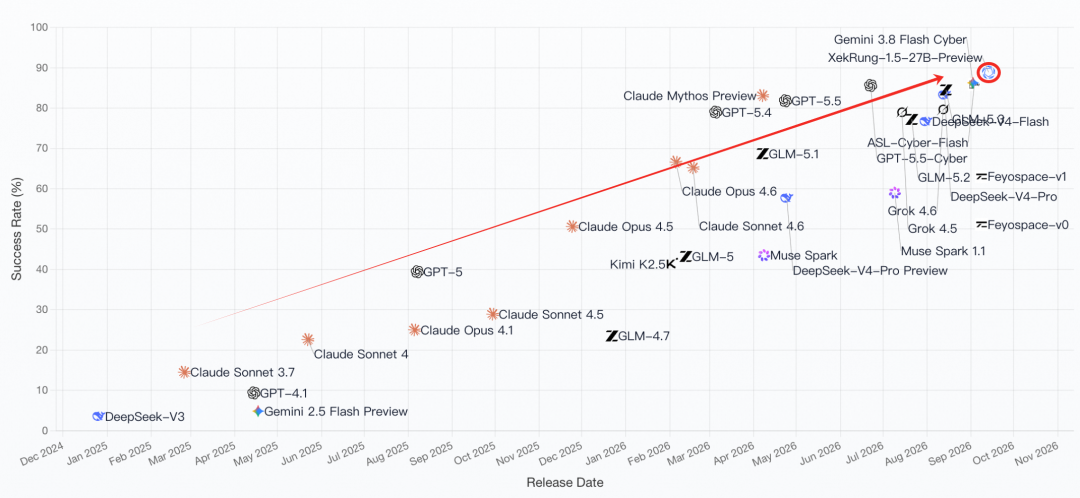
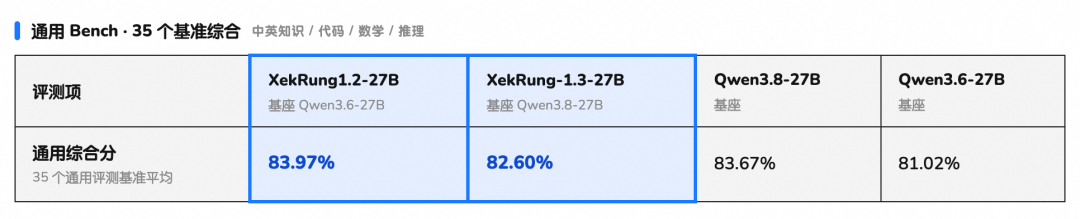
通用Bench:在涵盖中英知识、代码、数学、推理等方向的35个通用评测基准上,基于Qwen3.6-27B的XekRung1.2-27B综合分达83.97%,反超其基座2.95个百分点;基于更强基座Qwen3.8-27B的XekRung-1.3系列,在承载更强领域能力的同时,通用综合分与基座的差距控制在1个百分点左右——领域智能的极致压缩,并未以通用能力退化为代价。
伏渊息壤不是停留在榜单上的模型。我们与业务团队紧密协作,已把它落地到阿里集团内部的SDL、反入侵、DLP、数字资产管理、智能体安全等大型业务板块,日均调用量达3000万+,这是一个真正在生产环境里被高频使用完成复杂任务的安全模型。
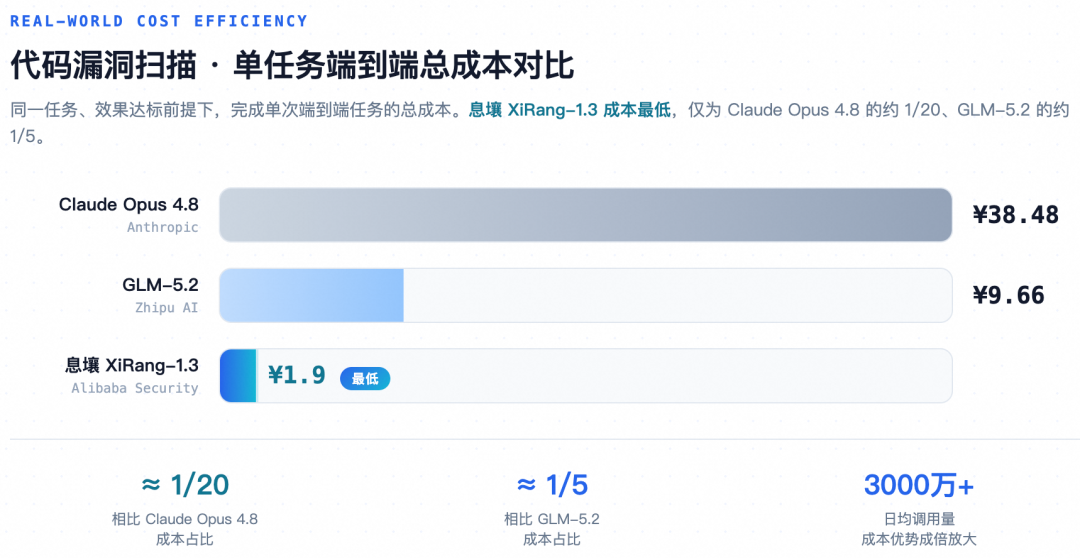
而「安全智能性价比」最直接的体现,是端到端完成同一个任务时的真实成本。以代码漏洞扫描为例,在单任务端到端完成、且效果达标的前提下,三个模型的总成本对比如下:
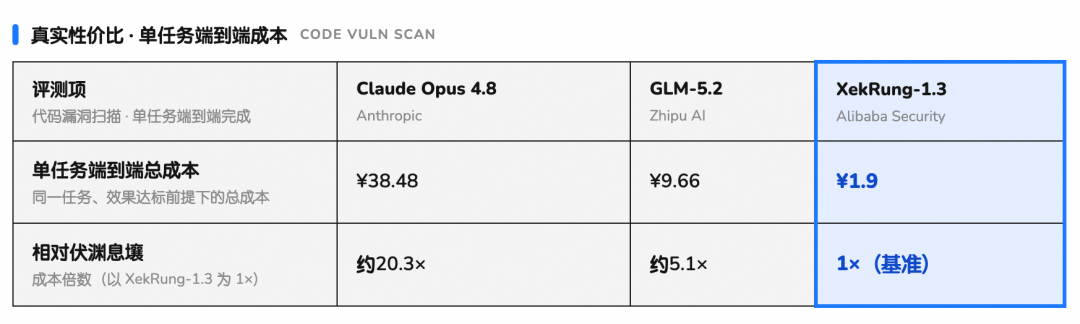
同样的任务、同样达标的效果,伏渊息壤的端到端成本仅为Claude Opus 4.8的约1/20、GLM-5.2的约1/5。当这个单价乘以日均3000万+的调用量时,「小参数+极致压缩」带来的成本优势会被成倍放大——这正是伏渊息壤在真实业务中的核心价值。
在CyberGym登顶第一,只是伏渊息壤阶段性成果的一个注脚。它真正想证明的是:安全领域的能力提升,讲究领域知识的极致压缩。
通过优秀的Backbone、Divide-and-Conquer的原子能力压缩、Model+Harness的联合调优,再加上可控可信的边界约束,伏渊息壤把「安全智能性价比」从理念变成了在真实业务与国际榜单上都能验证的结果。
未来,我们会继续在对抗智能、自进化、Agentic等方向迭代伏渊息壤,让强大的安全能力能以极致的性价比呈现,始终服务于防御、服务于善。
👇点击【阅读原文】查看伏渊息壤大模型1.0技术报告
📌往期推荐
AAIG课代表,获取最新动态就找她👇
关注公众号发现更多干货❤️
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢