

点击蓝字
关注我们
9月21日,美国《Foreign Policy》刊发文章《The Real Reason Chinese AI Is Winning the Global South》(《中国AI为何正在赢得全球南方》)。
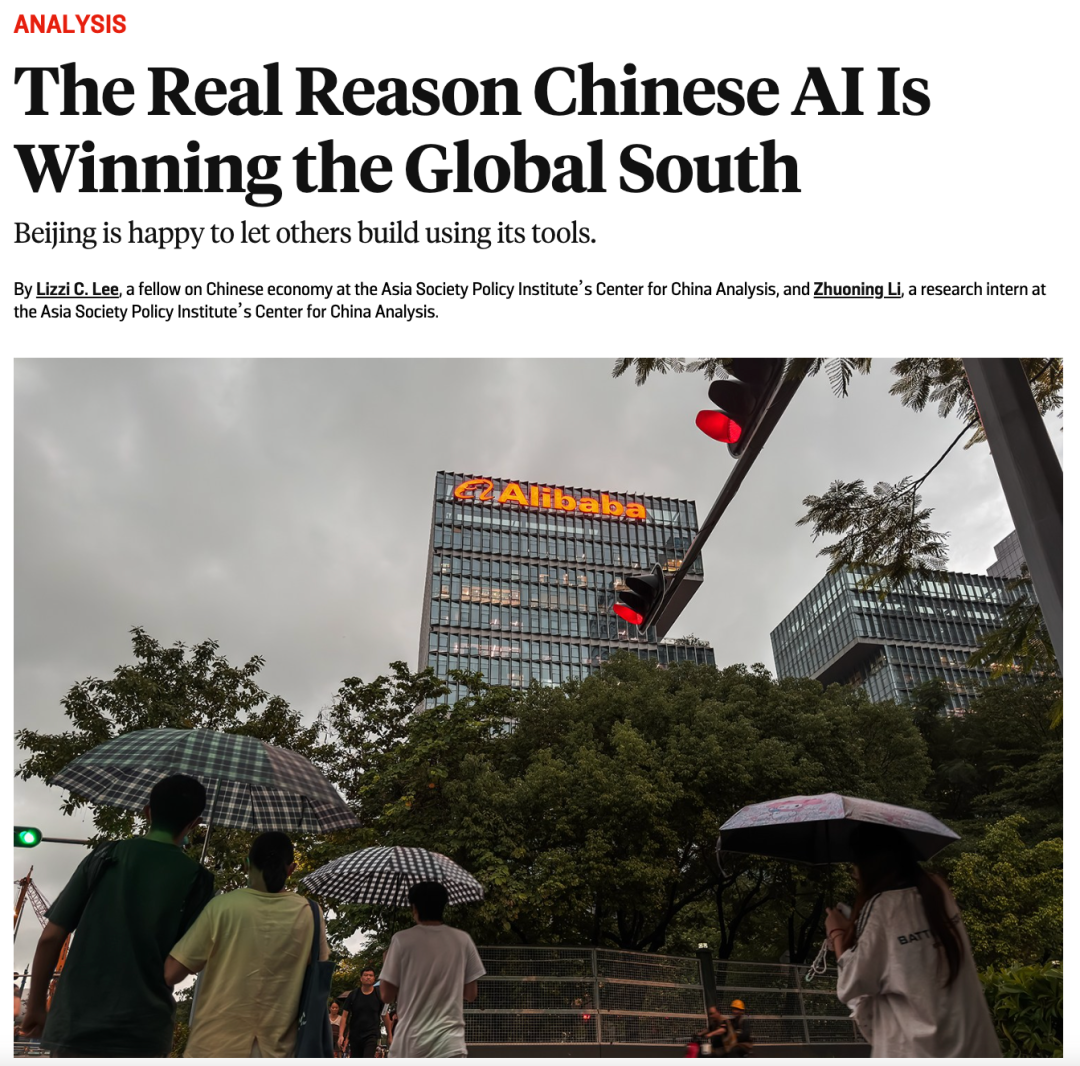
文章提出的判断很直接:全球南方采用中国AI,很多时候并非出于地缘政治表态,更多源于价格、灵活性、本地部署和语言适配等现实需求。
过去讨论中国AI出海,常常关注政府合作、基础设施投资和政策推动。这篇文章提供了另一种观察角度:一些国家的开发者和企业,可能先把中国模型当作便宜、灵活、能够本地运行的技术工具。随着这些工具进入应用、数据管道、硬件设备和服务体系,商业选择才可能逐步产生地缘政治影响。
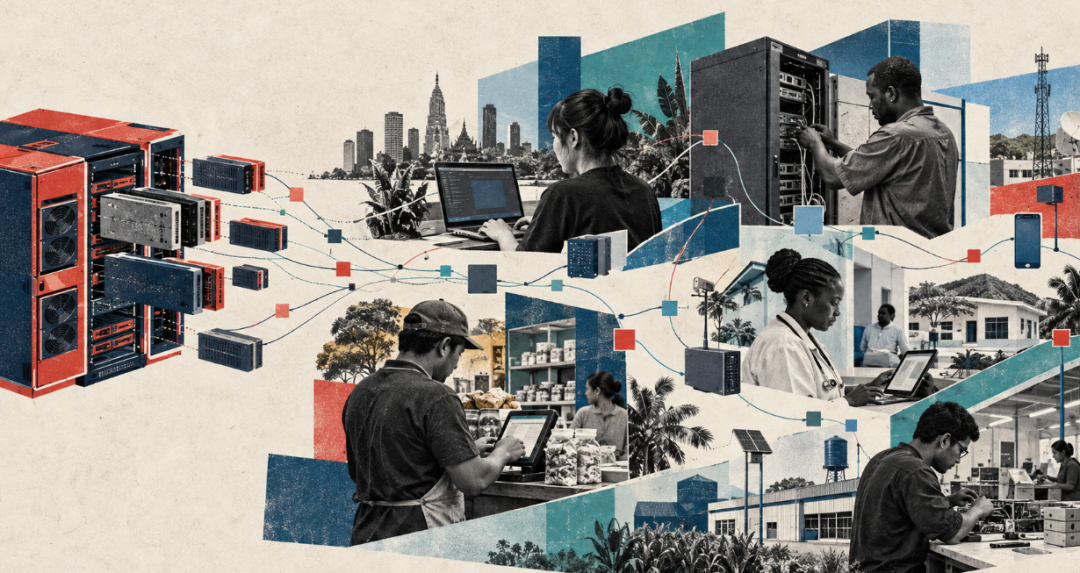
Qwen在开发者社区中的表现,是这篇文章最重要的证据之一。
根据Foreign Policy援引的数据,Qwen在Hugging Face上已经拥有151448个衍生模型,相关衍生规模约为Llama的4.7倍,接近Gemma的两倍。适合本地硬件运行的GGUF(一种用于保存和运行大模型的文件格式)格式中,Qwen月下载量约3960万次,远高于Llama的750万次。Hugging Face发布的开放模型报告,也将Qwen描述为当前开发者社区的重要基础模型。
这些数字不能直接等同于一个模型的政府采购规模或终端用户数量。衍生模型数量和下载量,主要反映开发者使用、修改和二次开发的活跃程度。它们至少说明,Qwen正在成为大量开发者搭建本地应用时的一种基础选项。
这同美国头部AI企业的商业模式存在明显差别。OpenAI和Anthropic等公司仍然主要通过API和订阅服务提供模型能力,用户需要持续支付调用费用,也需要把部分数据和计算任务交给云端平台。对于资金有限、网络条件不稳定、数据敏感度较高的全球南方市场,这种模式会增加使用门槛。
开放权重模型提供了另一条路径。开发者可以下载模型参数,进行微调、量化和本地部署,也可以根据具体需求搭建自己的产品。对小型企业和地方开发者来说,选择中国模型未必需要经过复杂的政策谈判,很多时候只需要回答三个问题:成本是否可承受?模型是否好用?能否满足本地需求?
全球南方选择中国模型,首先受到基础设施条件的影响。
中国企业长期在算力和硬件受到约束的条件下开发模型,更重视算法效率、模型压缩和本地运行能力。GGUF等轻量化格式,可以帮助模型在相对普通的设备上运行。这对电力供应有限、数据中心不足、云服务成本较高的地区具有现实意义。
语言适配也是一个重要因素。文章提到,中国模型在缅甸语、印尼语、马来语、菲律宾语、泰米尔语、泰语和越南语等多字节、非拉丁文字语言上的表现,为当地开发者训练区域语言模型提供了基础。开发者可以围绕本地语言、教育、客服、金融和政务需求进行微调,不需要完全从头训练一套模型。
数据主权同样不可忽视。开放权重模型允许政府和企业将模型部署在本地服务器,减少敏感数据长期流向外国云平台的需要。对于担心关键数据受美国法律、云服务商和跨境数据规则影响的国家来说,本地部署不仅是技术问题,也涉及数字主权和政策自主性。
这里需要区分一个概念:开放权重不等于完整开源。模型参数公开,并不代表训练数据、训练方法、代码、服务体系和安全评估全部公开。开放权重主要降低了开发者获取和修改模型的门槛,能否形成可靠的本地应用,还取决于硬件、人才、数据和维护能力。
从这个角度看,中国模型的优势并不只在模型本身,也在于它更容易成为一种“积木”。开发者可以拿到基础模型,再结合当地语言、产业需求和服务网络,搭建出符合本地市场的产品。
Foreign Policy将中国AI与“一带一路”基础设施合作进行了对比。文章认为,中国AI在全球南方的扩散,并不完全需要中央政府提前设计一套完整的对外推广方案。很多开发者先使用模型,企业随后围绕模型开发产品,政府再将其纳入本国的数字化和主权AI计划。
这条路径的关键,在于技术采用早于政治表态。文章指出,相关使用在7月上海世界人工智能大会之前,已经开始出现。政策仍然会影响硬件、资金和国家级项目,但模型进入当地市场的入口,可能来自开发者社区和企业的实际需求。
新加坡推出的SEA-LION,就是一个典型案例。该项目面向东南亚地区,目标是建设更适合本地语言和区域需求的AI基础模型,其表现最好的版本基于Qwen。马来西亚也在评估一项约4.94亿美元的主权AI计划,计划使用华为昇腾910C芯片,以增强对本国数据和计算资源的控制。
这种趋势还扩展到南美。文章提到,巴西政府今年8月宣布在里约热内卢建设超级计算项目,项目由华为和科大讯飞参与,金额约2.51亿美元;里约市政信息技术公司发布的Rio-3.5-Open-397B,也基于Qwen 3.5。
这些案例不意味着全球南方已经形成统一的对华技术选择。很多开发者并不会把模型采用理解成地缘政治站队。一个企业可以在不同任务中同时使用美国闭源模型、中国开放权重模型和本地模型。开发者选择的通常是工具,国家才会进一步考虑供应链、数据安全和战略依赖。
对中国来说,关键变化在于:AI影响力的形成,可能不再完全依靠政府项目推动。只要模型持续被开发者使用,衍生应用不断增加,技术生态就可能在社区层面完成扩散。
这篇文章最值得重视的判断,是技术依赖往往不是通过一次政府协议形成的。
当一个国家的企业围绕某种模型开发应用,数据管道围绕该模型进行配置,本地硬件针对该模型完成适配,技术人员也围绕该生态接受培训,后续更换模型的成本就会不断上升。
届时,依赖的对象已经不只是一个模型参数文件,还包括软件工具、开发框架、数据处理流程、芯片环境、维护团队、人才体系和服务标准。今天看似普通的商业选择,可能逐渐变成明天的基础设施依赖。
文章作者认为这也是美国需要警惕的地方。即使美国通过Pax Silica等机制推动伙伴使用美国主导的技术供应链,只要中国开放权重模型在价格、灵活性和本地部署方面持续具备吸引力,开发者依然可能从实际需求出发使用中国模型。出口管制可以限制芯片和设备流动,却很难完全阻止一个开发者下载模型、进行微调,并在本地部署应用。
对中国来说,模型出海也不能只看下载量和衍生模型数量。下一步更重要的工作,是把社区热度转化为本地基础设施、行业应用、人才培训、售后服务、安全评估和长期合作机制。只有模型进入当地的产业组织和数字服务体系,生态影响才会更稳定。
对全球南方国家来说,开放权重模型带来了更多自主选择空间,也需要警惕新的单一依赖。保留多模型兼容能力、加强本地人才培养、完善数据安全和独立评估机制,才能避免从依赖美国云平台转向依赖另一套外部技术生态。
【原文信息】Lee, Lizzi C., and Zhuoning Li. “The Real Reason Chinese AI Is Winning the Global South.” Foreign Policy, September 21, 2026. https://foreignpolicy.com/2026/09/21/the-real-reason-chinese-ai-is-winning-the-global-south/
编辑|肖易
终审|梁正 王净宇

内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢