

高质量三维结构数据的稀缺性以及核酸构象的灵活性,长期限制着核酸折叠与蛋白–核酸复合物结构预测的发展。如何利用更易获得的二级结构信息,帮助全原子模型理解核酸折叠规律?英灵殿科技团队提出 OFoldNA,将二级结构信息融入全原子扩散模型,使模型既能够学习碱基配对规律,也能够利用已有结构信息指导三维结构生成,统一支持核酸单体折叠和蛋白–核酸共折叠。
全原子结构预测模型正在推动生命分子结构研究进入新的阶段。以 AlphaFold 3 等模型为代表的方法,在统一框架下建模蛋白质、核酸及其复合物。随着结构预测技术不断拓展到更复杂的分子体系,如何准确理解核酸的折叠规律,成为结构预测模型进一步发展的重要方向。
同样是结构预测,核酸难在哪里
相比蛋白质,核酸结构预测面临许多独特的困难。一方面,核酸三维结构数据相对有限,使模型难以充分学习其复杂的空间规律;另一方面,核酸分子具有高度动态的构象特征,其功能往往依赖碱基配对、堆叠以及非经典相互作用等多层次结构关系。因此,仅依靠序列信息准确恢复核酸三维结构仍然十分困难。
在序列与三维结构之间,二级结构提供了一个连接两者的重要桥梁。碱基配对关系决定了核酸折叠的基本拓扑,并为三维结构形成提供关键线索。相比完整原子结构,二级结构信息更容易通过实验测量和计算方法获得:RNA 可以通过 SHAPE、DMS 等实验方法获得结构线索,DNA 的部分配对模式也可以通过序列互补关系推断。如何将这些可获得的结构信息有效融入全原子模型,成为推动核酸结构预测发展的重要方向。
尽管二级结构提供了连接序列与三维结构的重要信息,但如何将这类中间层次的结构知识有效融入全原子模型,仍然是核酸结构预测中的关键问题。过去的方法通常仅将二级结构信息作为 RNA 单体结构预测的约束,而对于 DNA 以及蛋白–核酸相互作用的复杂体系,如何统一利用不同来源和不同完整程度的结构信息仍然具有挑战。
此外,二级结构信息本身具有高度异质性。实验探测方法通常提供核苷酸分辨率的反应性信息,而序列分析和计算预测方法则给出具有不同置信度的候选配对模式。当这些信息进一步转换为配对关系后,其覆盖程度可能从完整配对图,到部分解析区域。因此,通用结构预测模型不能依赖固定形式的二级结构输入,而需要能够统一表示不同状态的结构信息,并在二级结构缺失、部分可用或完整可用的情况下保持稳定预测能力。
让二级结构不再只是约束,而是模型的一部分
围绕这些问题,英灵殿科技团队提出 OFoldNA,将二级结构信息融入全原子扩散模型框架。与仅将二级结构作为外部限制条件的方法不同,OFoldNA 同时学习核酸中的碱基配对规律,并利用已有配对信息指导三维结构生成,使二级结构信息从辅助约束转变为模型理解核酸折叠规律和生成三维结构的重要组成部分。
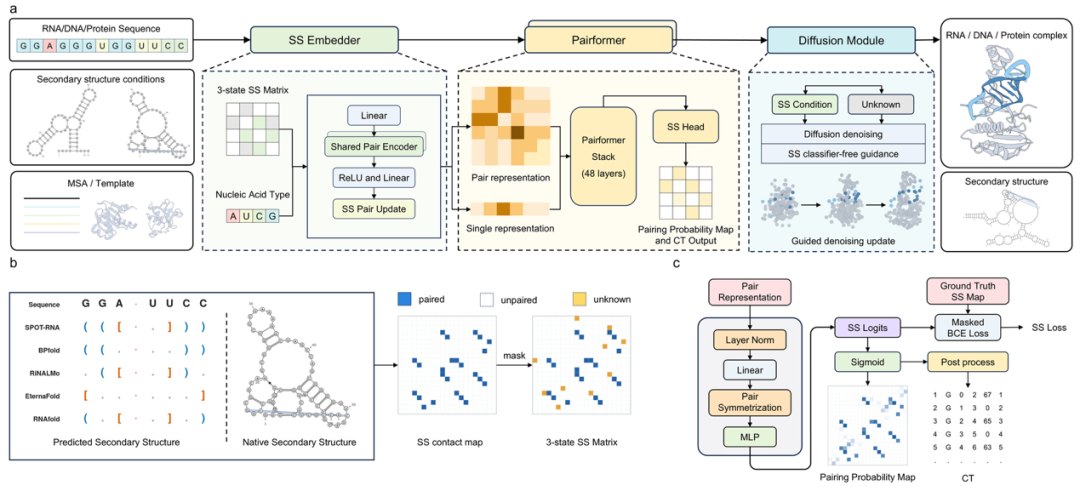
图 1|OFoldNA 总体框架。统一表示的碱基配对关系经 SS Embedder 注入 Pairformer,辅助 SS 预测头输出配对概率,推理时可选用二级结构指导的cfg guidance。
为了让二级结构信息能够被全原子模型有效利用,OFoldNA 将二级结构信息编码为统一的表示,将核苷酸之间的配对关系表示为已知配对、已知非配对和未知状态,并在训练过程中引入二级结构信息随机遮蔽策略。这样的设计使模型能够适应不同完整程度的二级结构条件,并在结构信息不完整时保持稳定预测能力。
在利用外部二级结构信息的同时,OFoldNA 还通过辅助预测任务学习核酸内部的碱基配对规律。模型根据内部结构表示预测核苷酸之间形成配对的概率,使二级结构知识融入模型自身的表示能力中。
基于这一设计,OFoldNA 形成了一个统一的核酸结构建模框架。在无外部二级结构输入时,模型完成全原子结构预测;在提供二级结构条件时,OFoldNA-SS2TS 利用这些信息增强三维结构生成;同时,模型内部的辅助分支 OFoldNA-SS 可以独立预测 RNA 二级结构。通过将二级结构学习与三维结构建模结合,OFoldNA 在同一框架中连接了不同层次的核酸结构信息。
从核酸单体,到蛋白–核酸复合物
OFoldNA 的目标不仅是提升单一核酸结构的预测精度,而是建立一个能够连接核酸折叠与复合物建模的统一建模框架。在核酸单体结构预测中,模型需要从序列信息恢复复杂折叠模式;在蛋白–核酸复合物中,则需要进一步理解核酸构象、结合方向以及分子界面之间的相互作用关系。
在 FoldBench 基准测试中,OFoldNA 展现出领先的核酸结构建模能力。在不提供外部二级结构信息的情况下,OFoldNA 在 DNA 单体预测中取得平均 TM-score 0.329,相比 AlphaFold 3 的 0.243 提升约 35%;在核酸链长度超过 20 nt 的蛋白–DNA 界面预测中,OFoldNA 的平均 DockQ 达到 0.286,相比 AlphaFold 3 的 0.238 提升 20.2%。这些结果表明,模型不仅能够恢复核酸整体折叠,还能够捕捉影响蛋白-核酸共折叠的关键空间关系。
当进一步提供二级结构信息时,OFoldNA-SS2TS 能够将已有配对关系转化为更有效的三维结构约束。在核酸单体任务中,加入准确配对信息后,DNA 和 RNA 的平均 TM-score 分别提升约 19.6% 和 12.2%;在长链蛋白–DNA 界面预测中,平均 DockQ 相比 OFoldNA 进一步提高 22.9%。这些结果说明,OFoldNA 能够将二级结构中的配对关系转化为三级折叠拓扑以及多组分复合物的空间组织关系。
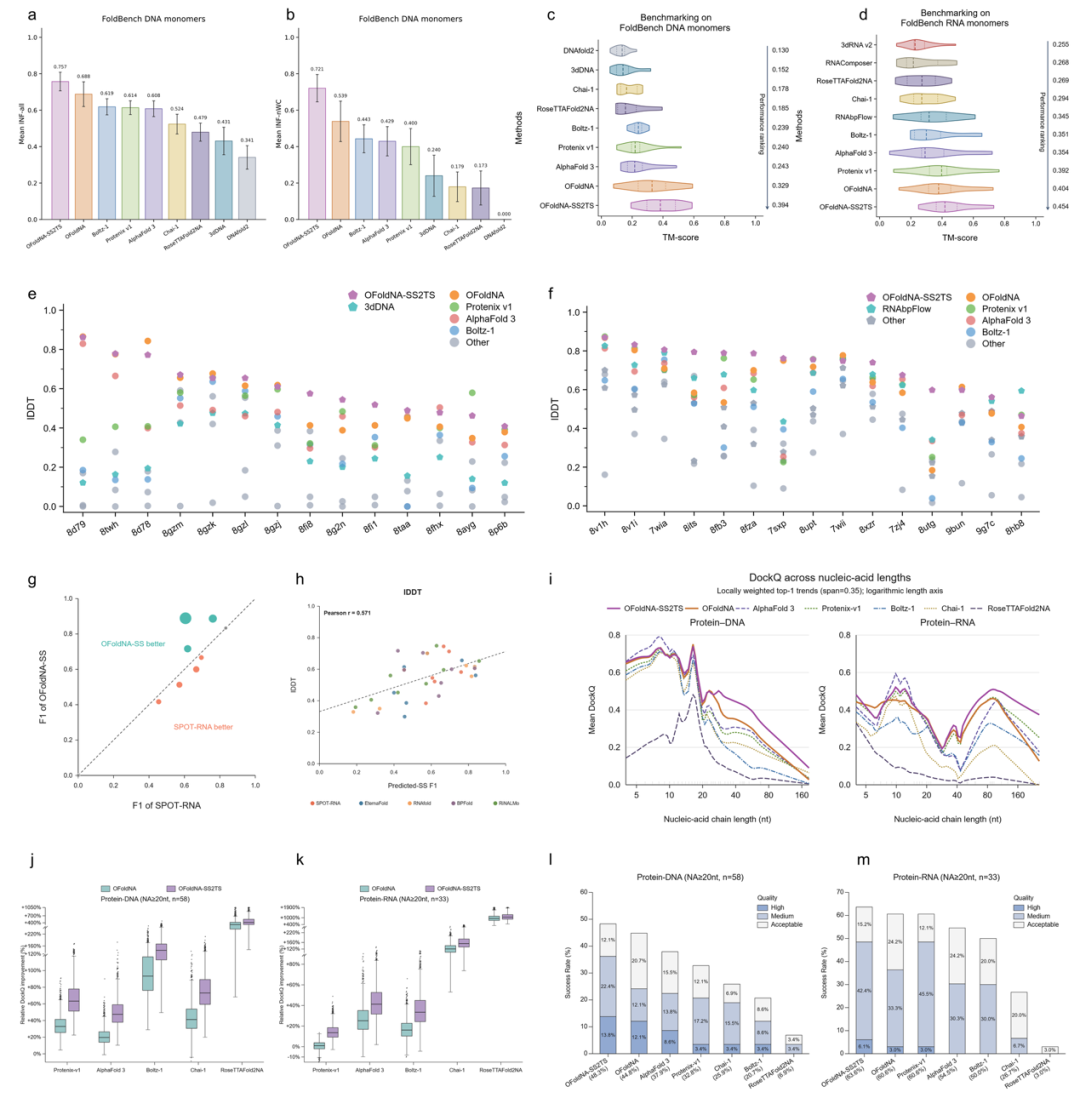
图 2|OFoldNA 在 FoldBench 上的评测结果。
从非经典折叠,到多组分复合物
除了经典双链结构,核酸还能够形成多种复杂的非经典折叠形式,例如由 G-四联体堆叠和非 Watson–Crick 配对共同稳定的特殊拓扑结构。在来源于 NRAS mRNA、含 G8U 替换的 G-四链体结构(PDB ID: 7SXP)中,OFoldNA 在无需外部二级结构信息的情况下,恢复了参考结构中的关键非经典配对关系以及核心堆叠模式,预测结构的 lDDT 达到 0.750,而最佳基线 Boltz-1 为 0.395。这表明 OFoldNA 学习到的结构表示能够捕捉非经典碱基配对的核酸折叠规律。
从核酸单体结构预测到蛋白–核酸共折叠,模型需要进一步理解分子之间的空间匹配关系。在拟南芥 LSH3 转录因子的 ALOG 结构域–DNA 复合物(PDB ID: 8P5Q)中,OFoldNA 恢复了 DNA 双链的结合方向以及蛋白与不同 DNA 链之间的特异性接触模式,在两个蛋白–DNA 界面上的平均 DockQ 达到 0.517。基线方法虽然能够预测接近的整体空间位置,但未能恢复正确的 DNA 取向和界面接触关系。这说明 OFoldNA 不仅能够预测分子的整体空间构象,还能够恢复决定蛋白–核酸识别的关键界面关系。
对于具有复杂拓扑结构的核酸三级结构,OFoldNA-SS2TS 能利用二级结构信息恢复整体折叠拓扑。在 53 核苷酸 Lettuce C20G DNA aptamer(PDB ID: 8FI1)中,模型利用外部配对信息恢复了四路连接结构、中心 G-四链体以及螺旋区域之间的空间排列,使预测结构达到 TM-score 0.481。这表明 OFoldNA 能够将局部碱基配对信息整合到整体三维结构预测过程中,恢复更高层次的折叠模式。
当体系扩展到蛋白质、RNA 和 DNA 共同参与的多组分复合物时,OFoldNA-SS2TS 能够利用二级结构信息预测不同分子之间的空间关系。在包含蛋白质、桥接 RNA 和多条 DNA 链的 IS621 重组酶复合物(PDB ID: 8WT6)中,模型恢复了多个蛋白–DNA 界面以及蛋白–RNA 界面的空间组织,重现了不同分子组分之间的相互作用模式。这表明,OFoldNA 不仅能够利用二级结构信息预测单个核酸的折叠,还能够将这些结构线索进一步用于复杂复合物的空间建模。
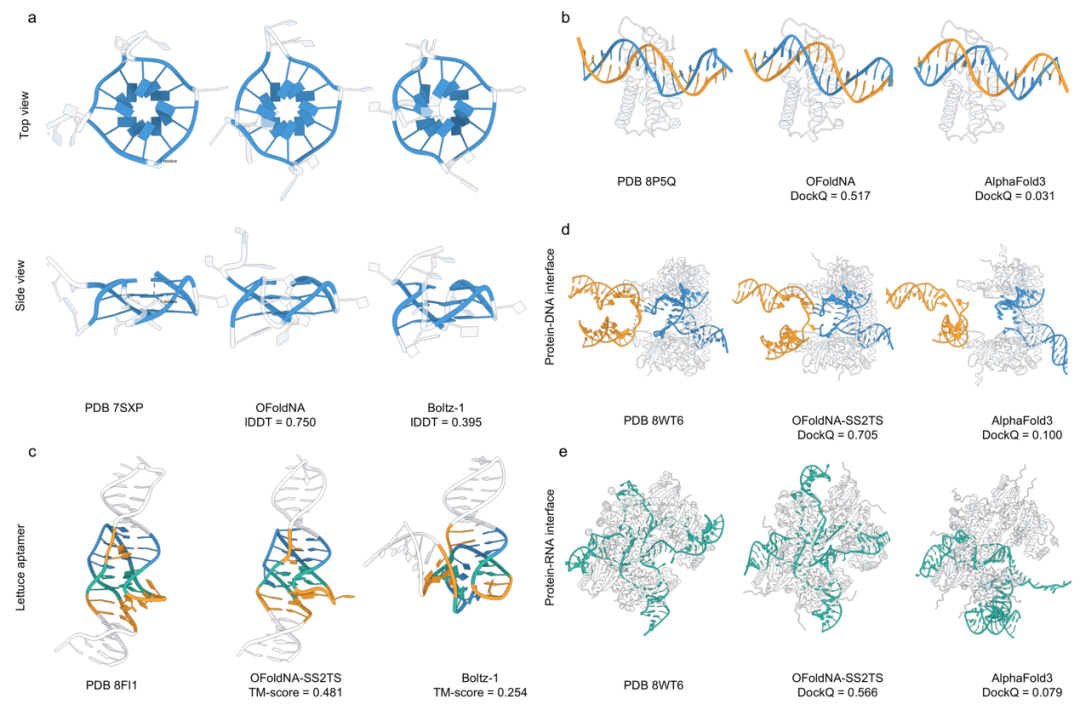
图 3|代表性案例:G-四链体(7SXP)、ALOG–DNA 复合物(8P5Q)、Lettuce DNA 适配体(8FI1)与 IS621 复合物(8WT6)。
同一个模型,也能独立预测二级结构
除了利用二级结构信息指导三维结构预测,OFoldNA 还从内部结构表示中学习了核酸碱基配对规律。通过辅助预测分支 OFoldNA-SS,模型可以独立输出 RNA 二级结构预测结果。
在 CHANRG 基准测试中,OFoldNA-SS 在所比较方法中取得最高平均分布外(OOD)表现,平均 base-pair F1 达到 0.3898,相比 BPfold 提升约 8.0%。这一结果表明,OFoldNA 学习到的二级结构表示不仅能够服务三维结构建模,也具备独立预测 RNA 二级结构模式的能力。
二级结构不完整,模型还能用吗
在实际研究中,二级结构信息往往并不是完整可获得的。为了评估 OFoldNA 对不完整结构信息的利用能力,研究团队进一步测试了不同二级结构覆盖程度下的三维结构预测表现,通过逐步增加已知配对区域,分析模型如何利用有限结构线索改善结构预测。
结果显示,OFoldNA-SS2TS 能够有效利用部分二级结构信息,并随着结构信息覆盖范围增加持续提升预测精度。在 FoldBench 核酸单体测试中,当已知配对信息覆盖 25% 的核苷酸时,平均 GDT-TS 已从无外部二级结构条件下的 0.545 提升至 0.596;随着覆盖程度进一步增加,模型的整体结构预测表现持续提高。
二级结构信息覆盖范围的增加,不仅改善了三维结构预测,也进一步提升了模型对碱基配对规律的恢复能力。随着二级结构覆盖程度提高,OFoldNA 的二级结构预测性能同步提升:平均 base-pair F1 从无外部二级结构输入时的 0.724,提高至配对信息覆盖25% 时的 0.807,并在 75% coverage 时达到 0.871。 这一结果说明,OFoldNA 能够在二级结构信息利用和内部结构表示学习之间建立联系,使已有结构线索既可以指导三维折叠,也能够进一步强化模型对核酸结构规律的理解。
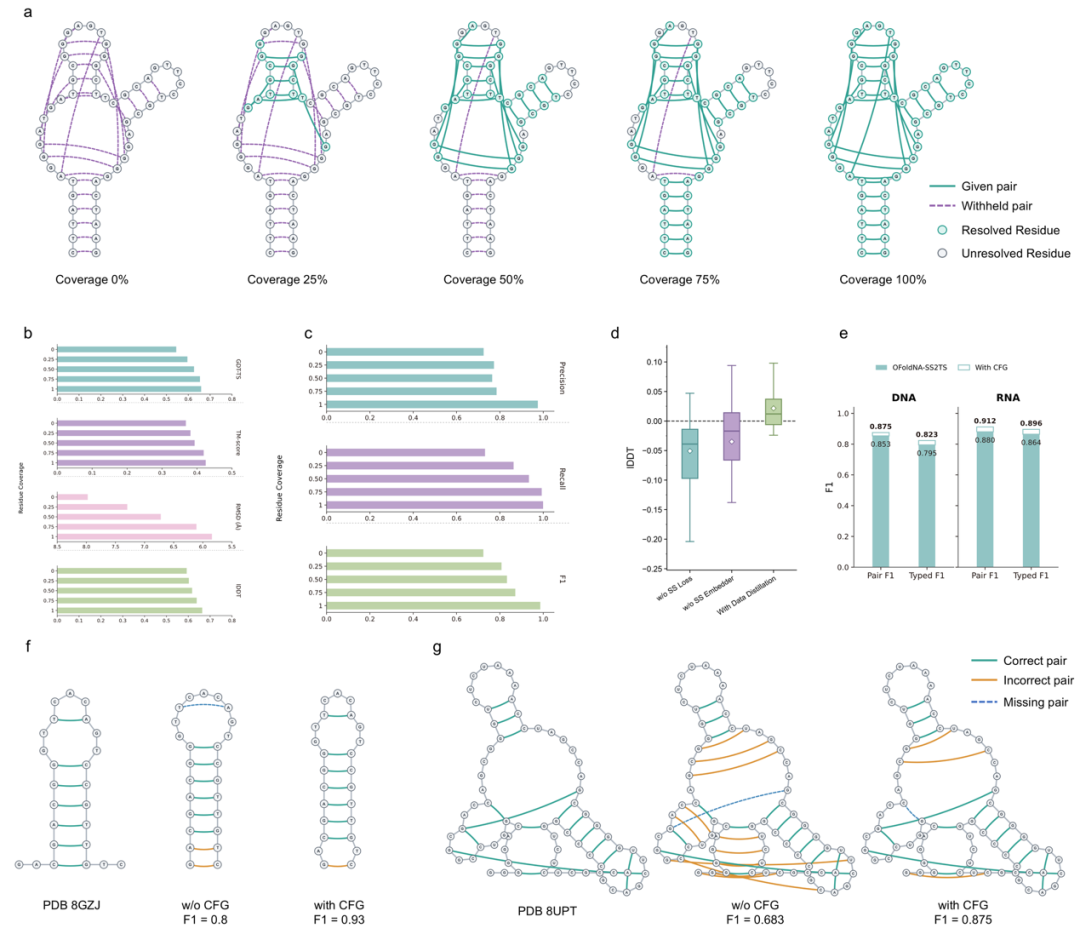
图4:OFoldNA能利用不同完整度的二级结构。
从二级结构出发,走向更完整的全原子结构预测
核酸三维结构数据的有限性,使得仅依赖已有原子级结构进行模型学习仍然面临挑战。OFoldNA 探索了一种利用中间层次结构信息增强全原子结构预测的方法,通过将二级结构信息融入模型学习与结构生成过程,使碱基配对关系深度参与三维构象预测,并帮助模型更充分地理解核酸折叠规律。
二级结构作为连接序列与三维结构的重要信息,为核酸结构预测提供了比完整原子结构更容易获得的结构线索。未来,更多实验测量得到的结构信号以及其他形式的分子约束,有望进一步融入全原子结构预测框架,使模型能够利用更加丰富的结构信息,提升对复杂核酸体系空间构象的预测能力。
参考资料
https://github.com/OTeam-AI4S/OFoldNA/blob/main/paper/OFoldNA.pdf
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢