

如果把生命比作一本多层级的书——基因是字母,通路是词语,细胞是句子,而一个人,是整本书。过去十年,单细胞测序让我们第一次能“逐字”阅读这本生命之书,但如何把散布在数以亿计细胞里的信息,从分子、细胞一路拼到个体层面,始终缺少一套统一的方法。
近日,北京大学陈语谦团队联合香港城市大学(东莞)陈观兴团队、中山大学由林麟团队,在 Science Advances 发表题为“scProtoTransformer: Scalable reference mapping across molecules, cells, and donors”的研究论文。团队提出原型驱动的 Transformer 架构 scProtoTransformer,用一套模型同时完成分子、细胞、供体(个体)三个尺度的“参考映射”,并让模型的判断过程可解释——它“看”一个细胞时,我们能知道它激活了哪些生物学通路。
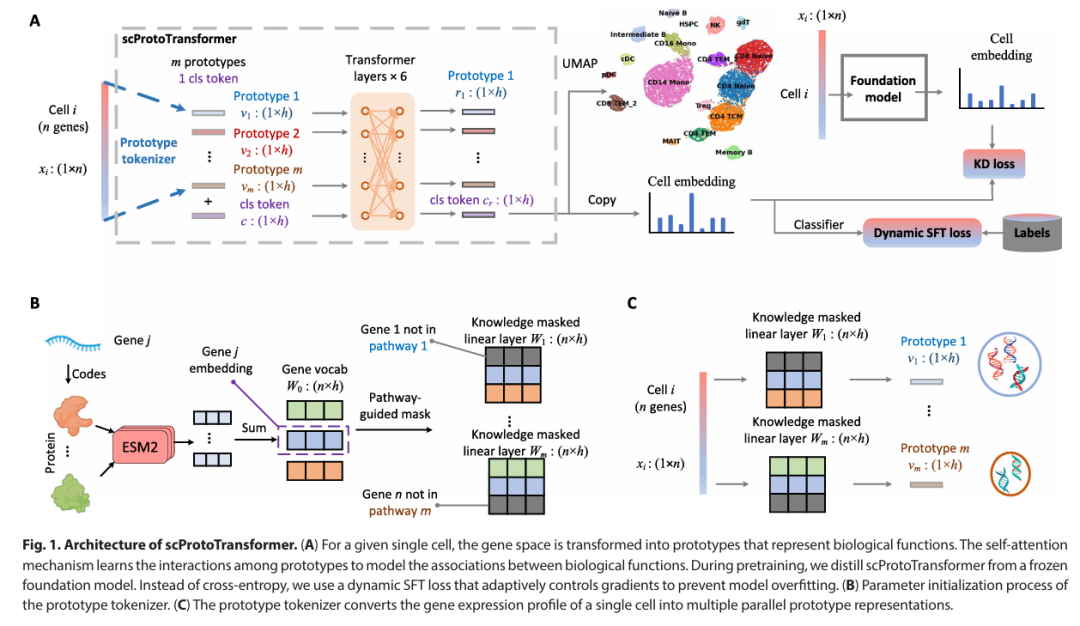
细胞、通路与个体,在同一个模型里被连成一张图谱。scProtoTransformer架构图。A. 原型分词器将单细胞基因表达转化为通路原型token,6层Transformer建模原型交互,并以冻结基础模型为教师进行知识蒸馏、以动态SFT损失监督学习;B. 原型分词器的参数初始化流程;C. 原型分词器将基因表达转化为多个并行的原型表征。
单细胞数据越来越多,为什么跨尺度“参考映射”仍是难题?
参考映射可以通俗地理解为“导航找路”:拿一份已知标注的参考数据当“地图”,把新测出来的查询数据“对”到地图上,自动获得细胞类型、状态等标签。单细胞数据近年的积累,理论上已经足够支撑从分子、细胞到个体三个层次的系统性刻画,但现实中有两大瓶颈。
第一,批次效应。不同实验、不同平台、不同实验室产生的数据,数值“口味”各不相同,直接拼接会互相干扰。现有整合方法大多需要人为指定“批次”信息,可现实中批次来源常常说不清,主观指定甚至可能动摇研究结论。
第二,现有方法大多只做细胞层面的参考映射。大型基础模型(如 scGPT、Geneformer)在细胞注释上很强,但预训练成本高、语料库维护复杂,而且几乎没有框架能同时在分子、细胞、供体三个尺度做表示学习和参考映射。生物系统本质上是分层的:基因之间的相互作用形成通路,不同的基因组合刻画细胞异质性,而细胞群体的表型又构成个体之间的差异。
三个设计:既“懂生物学”,又足够轻
scProtoTransformer 的核心思路,是不直接“啃”原始基因表达数值,而是先把它们翻译成生物学上有明确含义的“通路原型”,再交给 Transformer 建模。论文的三大创新设计如下。
第一:知识引导的原型分词器(Prototype Tokenizer)。借鉴计算机视觉中的原型建模思想,团队用 Reactome 通路知识初始化投影矩阵,把基因表达向量投影到默认 300 条通路原型(外加 1 个兜底节点,覆盖未被注释的基因)。这相当于给模型配了一本“生物学词典”:细胞表达先被“翻译”成规范的通路词汇,批次带来的“数值漂移”被天然削弱,生物学语义却完整保留;同时每个原型对应一条真实通路,模型天然可解释。
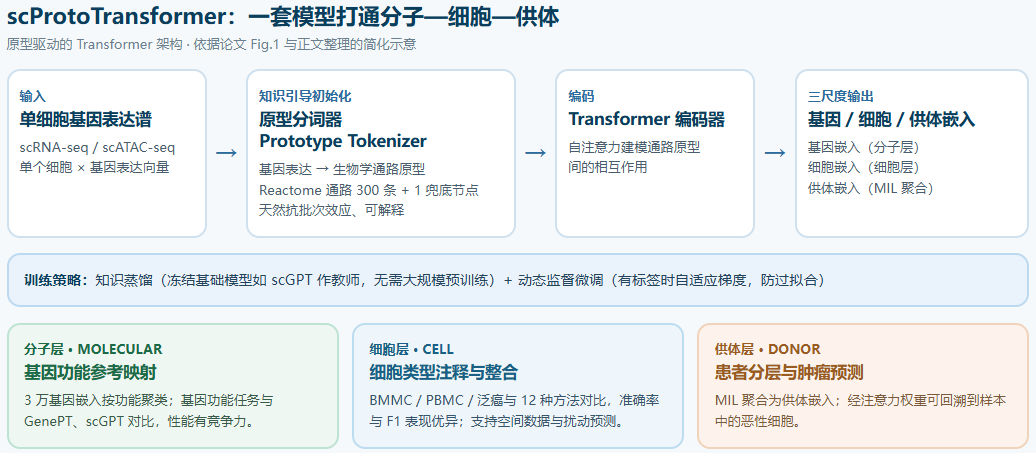
从输入到三尺度输出:一套模型完成分子、细胞、供体层面的参考映射。
第二:知识蒸馏(KD)。团队冻结一个大型基础模型(如 scGPT)作为“教师”,用它的细胞嵌入监督 scProtoTransformer 的学习,把基础模型花大成本学到的知识“蒸馏”过来——自己不需要大规模预训练,也能继承其表示能力。
第三:动态监督微调(动态 SFT)。当标签数据可用时,自适应地控制梯度更新,避免在小数据上过拟合,让标签的判别信息真正参与表示学习。
一套框架,分子、细胞、供体三个尺度逐一验证
分子层:基因嵌入按功能自然聚类。团队提取模型学到的约 3 万个基因嵌入做 UMAP 可视化,基因按功能类别形成清晰聚类,功能分群比基础模型更明显;在 Geneformer 基准的 4 个基因功能任务(长程/短程转录因子、剂量敏感转录因子、二价基因、H3K4me1 甲基化等)上,与 GenePT、scGPT 相比取得有竞争力的结果。
细胞层:与 12 种主流方法对比,表现突出。在 BMMC(scRNA-seq,13 个批次、22 种细胞类型)、PBMC(scATAC-seq,2 个批次、6 种细胞类型)和泛癌(13 种癌症、23 种细胞类型)三个数据集上,与 Seurat、CellTypist、scGPT 等 12 种方法对比,细胞类型注释的准确率与 F1 表现优异。模型还自带批次整合能力,无需人工指定批次;在空间转录组数据(如 DLPFC 的 12 个切片)上,切片间批次混合、细胞类型聚类清晰;在“虚拟细胞”方向的扰动响应预测任务上,也能提供有竞争力的细胞表示。
供体层:从患者诊断,回溯到单个恶性细胞。团队把同一供体的细胞嵌入用多实例学习(MIL)聚合成“供体嵌入”,用于患者层面的肿瘤预测;更有意思的是,通过注意力权重可以“回溯”——指出该样本中哪些细胞被判为恶性,实现从个体诊断回到单细胞证据的可追溯分析。
轻量、普通算力即可训练
相比需要大规模预训练的基础模型,scProtoTransformer 的训练硬件只需一张 NVIDIA RTX A6000(48 GB),从 scBaseCamp 人类子集采样 200 万细胞即可完成训练;不需要维护庞大的语料库,也不需要每个数据集从头训练。
参考资料
scProtoTransformer: Scalable reference mapping across molecules, cells, and donors. Science Advances, 2026, 12: eaef0286. DOI: 10.1126/sciadv.aef0286
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢