

论文链接:https://arxiv.org/abs/2609.16804
Github 仓库:https://github.com/SII-fkchen/SOTER
模型权重:https://huggingface.co/SII-fkchen/SOTER
引言:可穿戴设备记录的为什么不只是几条波形?
跑步时,我们会看一眼手表上不断跳动的心率;睡觉后,腕带仍在默默记录脉搏、呼吸和体动;当人感到紧张、疲惫,或从静坐转为运动时,心电、血容量脉搏、皮肤电等信号也会随之发生变化。这些数据看起来只是屏幕上几条上下起伏的曲线,实际上更像身体持续写下的一份“运行日志”——心脏、呼吸和神经系统并不是彼此孤立地工作,而是在不同时间尺度上相互影响,共同留下身体状态变化的痕迹。
许多传统方法习惯把这些信号拆开处理:一条心电是一条序列,一条脉搏又是另一条序列;预测未来、识别状态和补全缺失数据,也往往需要分别训练不同的模型。在数据完整、采样规整的环境中,这种方式或许已经足够。但真实生活从来不是一间安静、规整的实验室——跑步时的手腕晃动、传感器贴合状态的变化,都可能带来噪声;设备可能漏掉部分观测,不同信号的采样速度也不一致;当模型被换到新的使用者、设备或采集场景时,原本熟悉的数据规律还可能随之改变。
如果每增加一种设备、一个数据集或一项分析任务,都需要重新收集大量标注数据,再从头训练一套模型,持续健康监测就很难真正走向低成本、可复用的应用。因此,一个更值得探索的问题是:能否让模型先阅读足够多的生理信号,学习一套可以迁移的“身体语言”,再把这种能力用于新的数据和任务?它不仅要看懂每一条曲线本身,还要理解不同信号之间的联系;不仅要适应快慢不同的生理节律,还要面对间隔不齐、部分缺失的真实记录。
围绕这一问题,上海创智学院联合复旦大学,浙江大学和华中科技大学,提出了面向可穿戴生理信号的生成式时序基础模型 SOTER。它不再把生理数据视为一组等待拟合的孤立曲线,而是将其还原为一个由多路信号共同作用、不同节律彼此交织,并随时间连续演化的动态过程:模型先分别理解每一路信号的变化,再让不同信号在高层表示中相互“对话”;根据数据中不同的频率特征,将不同节律交给更合适的专家处理;最后通过连续时间建模,在不规则甚至不完整的记录中预测未来或估计缺失信息。
研究团队在五个公开生理数据集、约 2260 亿个时间点上对 SOTER 进行预训练,并探索使用同一个预训练主干支持生理信号预测、状态分类和缺失值补全。其目标是为持续健康监测建立一种能够跨数据、跨场景和跨任务复用的基础建模能力。
模型设计:通道、频谱与连续时间的协同建模
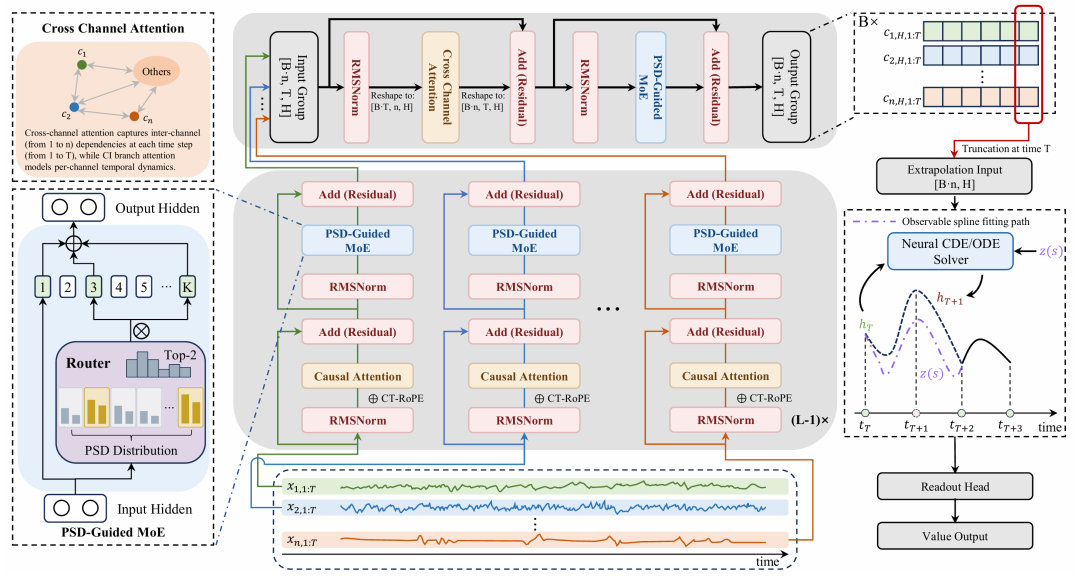
图1:SOTER整体架构。包括多通道建模、显式频谱引导的MoE路由分配和连续时间动力推演。
先理解单个通道,再建立跨通道联系
SOTER采用先分别建模、再高层交互的主干结构。L层网络中的前(L-1)层,独立建模各通道的历史动态。随后通过最高层在同一时间戳上聚合不同通道的抽象表征。这既保留了各通道自身的变化模式,也让跨通道交互建立在已经提炼的时序特征之上。
将不同频谱特征的信号交由不同专家处理
SOTER通过功率谱密度(Power Spectral Density,PSD)引导的混合专家(Mixture of Experts,MoEs)模块,从历史潜在表征计算因果频谱统计,根据预先划分的谱带选择两个专家,并结合共享专家完成特征变换。这里使用的是潜在序列的归一化频谱特征。专家选择由确定性规则完成,不需要额外的可学习路由器和负载均衡损失,为模型内部的专家分工提供了可检查的依据。
同一个连续时间解码器支持预测与补全
SOTER参考神经受控微分方程(Neural Controlled Differential Equations,Neural CDEs)进行解码。这使得SOTER能够从历史末端的潜在状态出发,演化至目标时间戳。未来预测时,没有新的观测可作为控制输入,解码器通过将控制路径置零,转为Neural ODE模式;因果补全时,则利用查询点之前的可用观测构造控制路径。两种模式共享网络参数,使同一套预训练模型能够适配到未来预测和不同时间位置的缺失值估计两种任务。
实验结果:同一预训练主干,迁移到三类任务
SOTER在MIMIC-III Waveform、Sleep-EDF、PTB-XL、WESAD和Chapman-ECG五个公开、去标识化生理数据集上预训练,语料规模约为2260亿个时间点。模型总参数量为49.79M,单次推理激活20.29M参数。我们在下述三种任务上对SOTER进行了性能评估:
(1)多尺度预测下的零样本评估;
(2)类别不均衡条件下的冻结表征分类;
(3)不同缺失率情况下的流式因果补全。
零样本预测:在多数数据集与指标上取得最优结果
SOTER在HeartRate、MIT-BIH、ScientiSST MOVE、IEEE PPG、MMASH和WDD六个分布外数据集上对未来预测能力进行评测,评测加入了多组输入、输出窗口以检验迁移表现。结果显示,SOTER在4个数据集上取得最优RMSE、5个数据集上取得最优MAE。
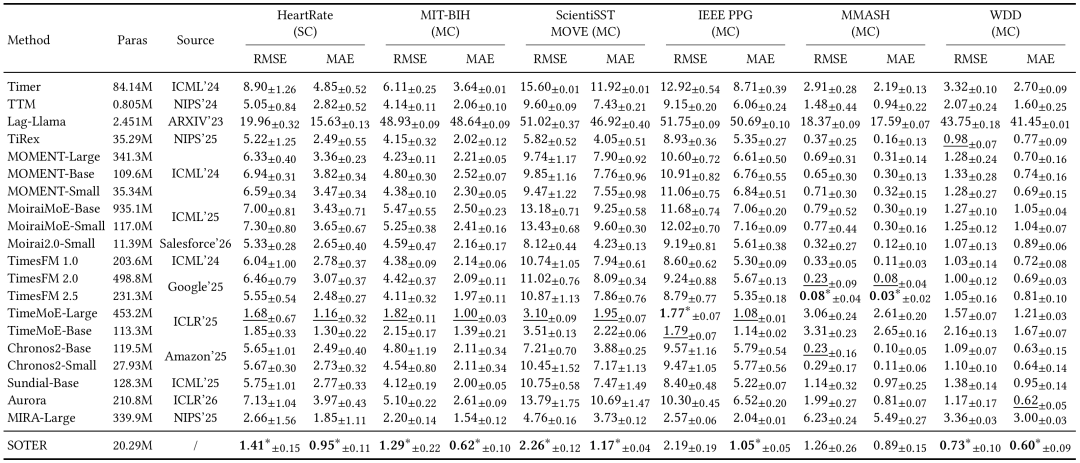
表1:针对六个分布外(OOD)可穿戴设备数据集的零样本(zero-shot)预测结果。“Paras”表示单次推理步骤中激活的参数量(单位:百万),“SC”和“MC”分别代表单通道和多通道数据集。最优结果以加粗并标有星号(*)的形式显示,次优结果则加下划线标示。
冻结表征分类:无需微调主干,仍保留判别信息
在WDD、ScientiSST MOVE和MMASH三个分类数据集上,SOTER的平均Macro-AUROC达到80.79,高于TF-C的77.08、NormWear的76.34和MIRA-Large的76.24,以上数值均按百分制表示。SOTER也在三个数据集上分别取得最高Macro-AUROC。
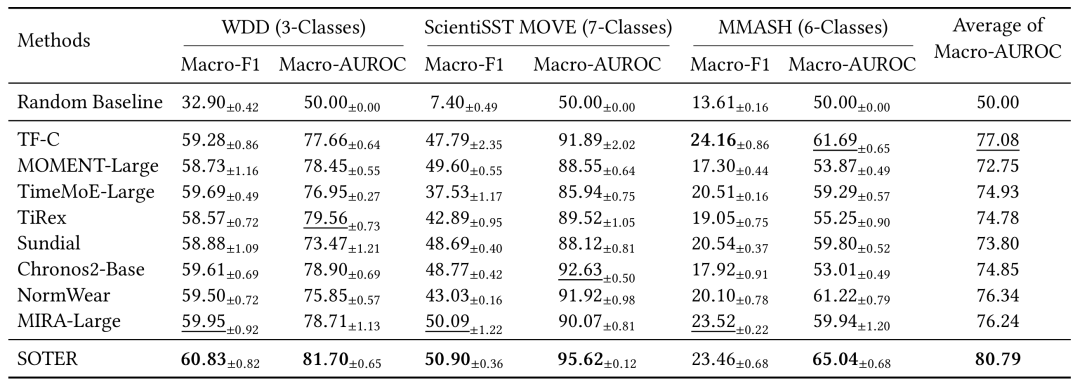
表2:下游分类任务上的性能表现。我们报告了三个可穿戴设备数据集上的 Macro-F1 (%) 和 Macro-AUROC,以及跨数据集的平均 Macro-AUROC。数据为三次运行的平均值与标准差。最优结果以粗体标示,次优结果加下划线标示。
因果补全:75%缺失率下,六个数据集均取得最低误差
对于缺失值补全,研究采用在线因果协议:估计一个缺失点时,模型只能使用它之前的观测,不能读取未来信号。这与利用前后两侧数据的离线双向重建有所不同。在25%、50%和75%三种缺失率下,SOTER无需针对补全任务进一步优化,即可完成迁移。尤其在75%缺失率下,SOTER在六个数据集上的RMSE和MAE均为所比较方法中的最低值。
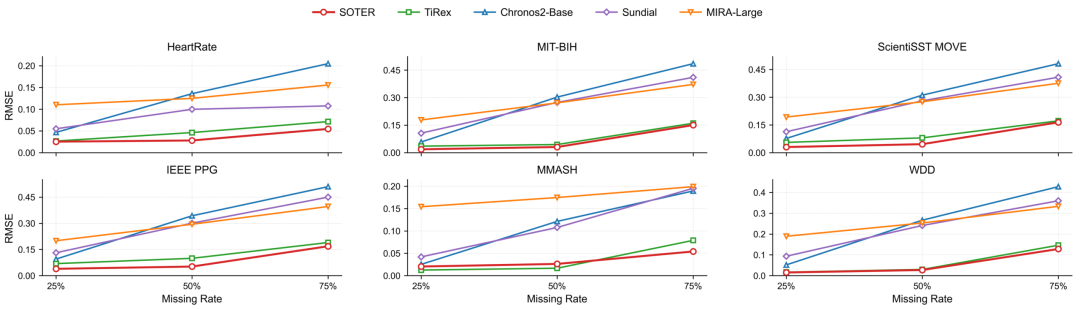
图2:缺失率递增情况下的连续时间插补。在相同的因果前缀协议下,针对六个分布外可穿戴设备数据集,在25%、50%和75%缺失率时的RMSE结果。数值为三次运行的平均值。
性能提升来自哪里?
为了区分预训练语料与模型设计的作用,研究在相同生理语料、相同一轮训练预算和优化日程下,对MIRA-Large分别进行从零预训练(scratch)和继续预训练(continued)。两种方式都改善了MIRA-Large的预测表现,但SOTER在MIT-BIH和ScientiSST MOVE上的四项比较指标仍然更优。这说明,在该对照范围内,SOTER的优势不能仅由预训练语料进行解释。
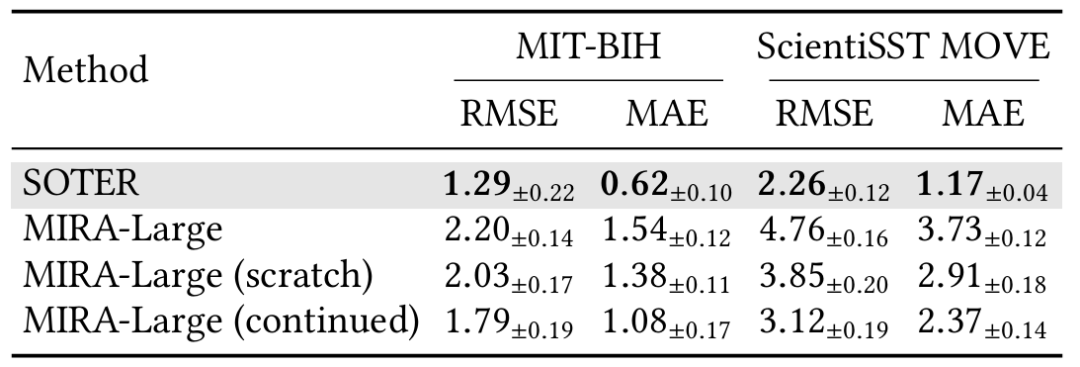
表3:零样本预测任务中基于语料库匹配的对比结果。SOTER 与两个基于语料库匹配的 MIRA-Large 变体在相同的生理数据语料库上,且在相同的训练预算下,均进行了完整的一个 Epoch 的训练。
组件消融也提供了SOTER架构上的补充证据。
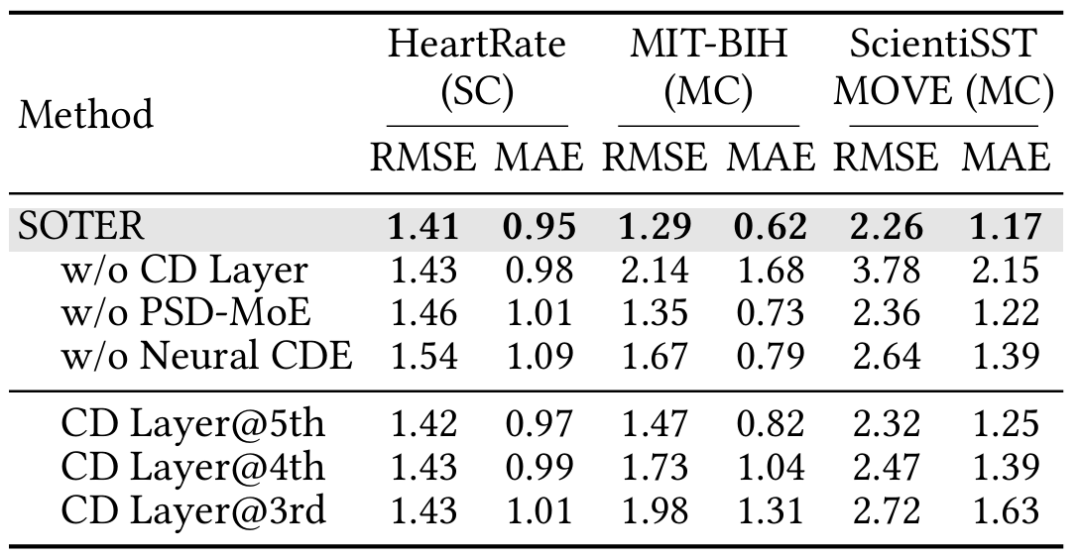
表4:SOTER 在一个单通道数据集和两个多通道数据集上的组件消融实验结果。
SOTER探索了面向可穿戴生理信号的领域统一建模新范式。SOTER从生理信号的固有特点出发,将通道关联、频谱差异与连续时间演化纳入统一的预训练框架。我们希望SOTER能够为面向可穿戴生理信号的建模提供一种行之有效的新思路。
复旦大学数据智能与社会计算实验室
Fudan DISC
联系方式:disclab@fudan.edu.cn
地址:复旦大学袁天凡、慧敏校园C栋

点击“阅读原文”跳转至Github
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢