

生成式人工智能正在快速扩展可探索的化学空间,但大量由模型生成的分子仍存在一个现实瓶颈:它们在计算上可能具有优异的结合能力或性质评分,却难以真正合成。传统解决方案通常采用事后过滤,直接丢弃不可合成分子,或者把候选结构投影到预先定义的可合成化学空间中。然而,这些策略往往牺牲分子新颖性,并可能破坏关键药效团。研究人员提出 SynCraft,一种利用大语言模型推理能力优化分子可合成性的框架。其核心思想不是让大语言模型重新生成完整SMILES,而是把可合成性优化重新定义为一个精确的结构编辑问题:模型首先识别分子的合成瓶颈,再输出一系列可执行的原子级编辑操作,例如删除原子、替换原子、增加键或改变键级,随后由确定性的化学信息学工具执行这些操作并检查化学有效性。
SynCraft进一步提出“合成悬崖”概念,即某些看似难以合成的分子只需非常局部的结构变化,就可以获得显著提高的合成可行性。大规模基准结果显示,SynCraft在保持较高结构相似性的前提下,比ChemProjector、SynFormer和ReaSyn等方法更容易找到可合成类似物,并且这一优势能够在多种商业或开放权重大语言模型后端上复现。通过引入蛋白–配体相互作用约束,SynCraft还能够在优化合成可行性的同时尽量保留关键药效团和结合模式。研究人员进一步在PLK1抑制剂、RIPK1候选物以及SARS-CoV-2主蛋白酶生成分子中验证了这一能力,显示大语言模型可以从“分子生成器”转变为“分子编辑策略专家”。
AI驱动的分子生成模型已经能够在极其庞大的化学空间中快速提出新结构,并围绕结合亲和力、药效、理化性质等目标进行优化。但在许多生成任务中,优化目标相对单一,模型往往缺乏对真实化学规则和实验可执行性的充分理解。因此,一些计算评分很高的结构可能包含高张力环、非常规连接方式、难以控制的立体中心或缺乏合理合成路线的复杂骨架,使这些虚拟候选难以进入实验阶段。
目前常见的处理方式之一是利用逆合成工具对生成分子进行筛选,仅保留具有可行路线的结构。这种方法能够保证最终候选的合成可能性,但代价是大量高评分分子被直接淘汰。另一类方法则在生成过程中限制分子只能由已知反应模板和商业构件组成,或者将不可合成分子投影至附近的可合成结构。虽然这些方法提高了成功率,却同时限制了生成模型探索新颖化学空间的能力,也可能通过较大的结构变化破坏原本优化好的药效团。
研究人员注意到,可合成与不可合成之间并不总是存在巨大结构差异。许多不可合成候选实际上距离一个可合成结构非常近,可能只需要替换一个原子、调整一条键或消除一个不必要的立体中心。这与药物化学中的“活性悬崖”类似:极小的结构变化能够引起性质的显著变化。研究人员因此提出“合成悬崖”,并将问题从“重新生成一个可合成分子”转变为“寻找最小修改,使当前分子跨越合成悬崖”。
大语言模型为这一任务提供了新的可能性。它们从科学文献和化学语料中学习了大量反应和结构知识,也表现出一定的化学推理能力。但直接要求大语言模型生成完整SMILES容易出现语法错误和不合理结构。SynCraft因此避开了这一薄弱环节:大语言模型只负责判断“哪里需要改、为什么要改、应当怎样改”,而具体分子图的修改则交由确定性的化学工具执行。
方法
研究人员首先从LIGAN、3D-SBDD、Pocket2Mol、DiffSBDD和ResGen等三维分子生成模型中收集虚拟候选,并使用SimpRetro结合Enamine商业构件库评估其合成可行性。对于被判定为不可合成的结构,再从约2300万个可购买分子中寻找结构和药效团相似的可合成近邻,最终构建3332对“不可合成–可合成”分子,作为合成悬崖参考库。SynCraft在推理时从该库中检索与目标分子最相近的5个案例,向大语言模型提供对应的结构变化、编辑序列和化学解释。模型首先以自然语言分析合成瓶颈,再输出JSON格式的原子级编辑操作,包括删除、替换或增加原子,增加、删除或修改化学键,以及调整手性和双键立体化学。所有编辑由RDKit逐步作用于分子图,并进行价态、芳香性、连通性和立体化学检查,无效结构被自动剔除。对于需要保留生物活性的任务,系统进一步利用AutoDock Vina获得结合构象,通过PLIP识别氢键、盐桥、π堆积和疏水作用,并将这些相互作用转化为自然语言约束写入提示词,使模型在改善可合成性的同时尽量保留关键相互作用。
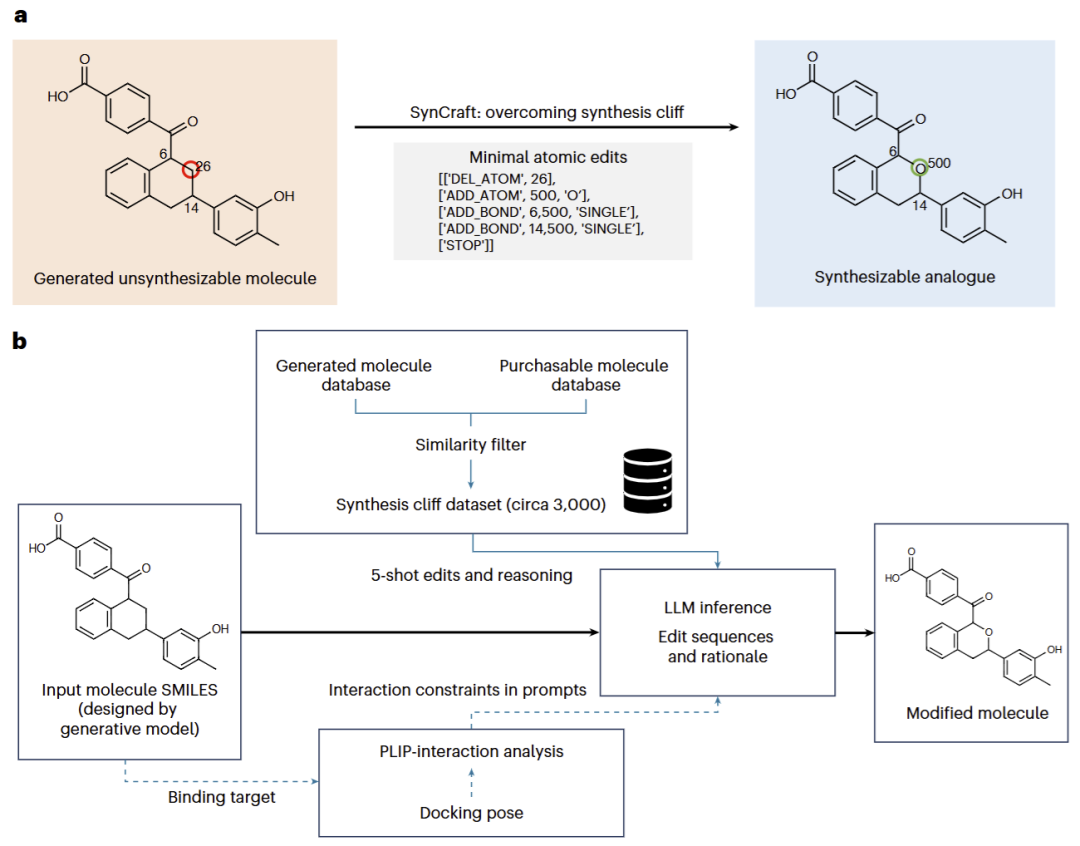
图1|SynCraft总体框架:从合成悬崖参考数据构建、相似案例检索和大语言模型化学推理,到原子级编辑执行及蛋白–配体相互作用约束。
结果
SynCraft通过原子级编辑更有效跨越“合成悬崖”
研究人员首先在Pocket2Mol和ResGen生成、且被SimpRetro判定为不可合成的分子上进行大规模测试,并与ChemProjector、SynFormer和ReaSyn比较。评价标准要求输出分子不仅必须通过同样的逆合成检查,而且还需要与原始分子保持足够高的Tanimoto相似度。
在Pocket2Mol数据中,当相似度阈值设为0.5时,基于Gemini-2.5-Pro的SynCraft成功率达到42.7%,而最强基线约为30%;当阈值提高到0.6时,SynCraft仍达到28.4%,接近SynFormer和ReaSyn的两倍。在ResGen数据中也观察到类似趋势,SynCraft在中等和较高相似度区域保持明显优势。更换GPT-5.2、DeepSeek-V4-Pro和DeepSeek-V4-Flash后,这种改善仍然存在,说明效果并不依赖单一大语言模型。
消融实验进一步表明,“预测编辑序列”优于“直接生成完整SMILES”。后者更容易产生结构幻觉或不必要的大幅改动,而原子级编辑使模型更容易保持原始骨架,并集中处理真正影响合成可行性的局部结构。
局部生物电子等排编辑在提高可合成性的同时保留药效团
SynCraft的优势在于能够进行类似药物化学家的“外科手术式修改”。一个代表性分子包含复杂的稠合碳环,特定取代模式使其难以构建。SynCraft只将饱和环中的一个亚甲基替换为氧原子,将全碳体系转化为更容易通过C–O键构建的含氧杂环,而其余骨架基本保持不变。相比之下,投影类方法为了寻找数据库中最近的可合成结构,生成了拓扑差异更大的稠合四元环体系。
药效团保留也体现出明显差异。在含氮环体系中,基线方法为了简化合成直接删除氮原子,而SynCraft通过芳构化生成吡啶环,在提高稳定性和可合成性的同时保留了潜在氢键作用位点。对于另一个稠合双环结构,投影方法直接拆解核心骨架,而SynCraft仅调整键级以满足价态要求,从而尽量保持三维形状和原有骨架。
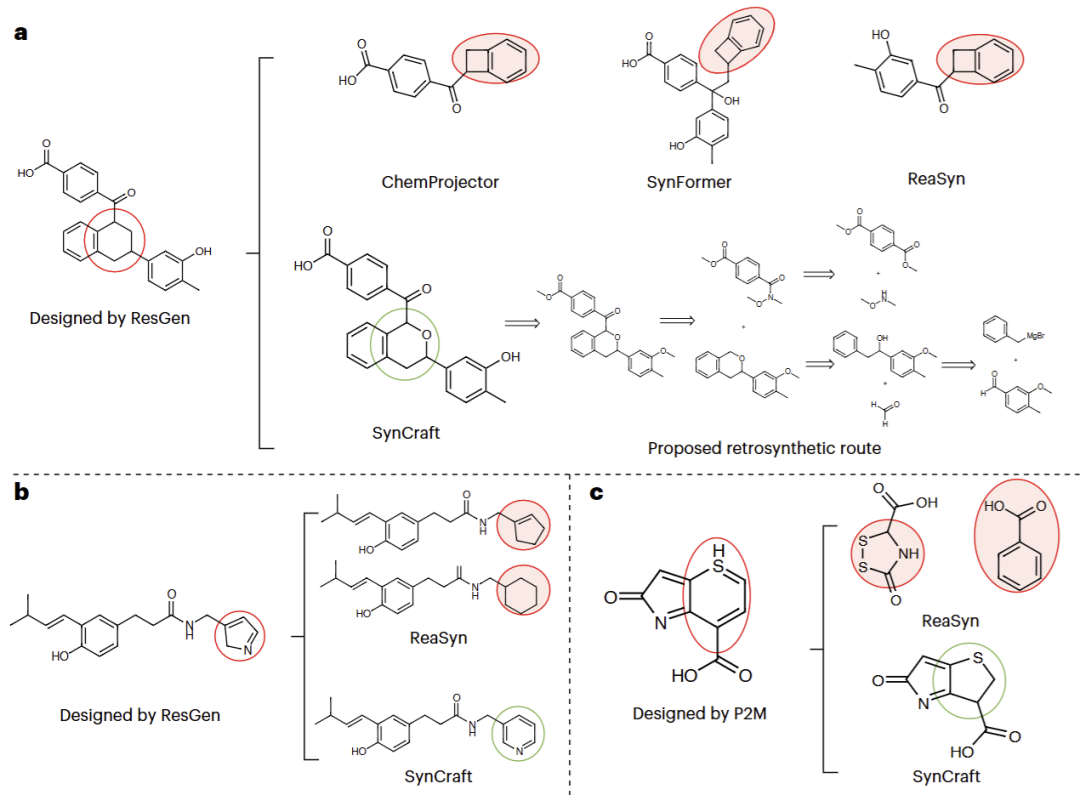
图2|SynCraft通过生物电子等排和局部结构编辑跨越合成悬崖,并与投影式可合成性优化方法比较药效团和骨架保持能力。
SynCraft能够复现药物化学家的人工优化策略
为了判断模型的编辑逻辑是否真正接近药物化学专家,研究人员利用一个已发表的PLK1抑制剂案例进行回顾性验证。原始生成分子lig-886含有2,5-二甲基哌嗪片段,因此引入两个手性中心,实际合成时可能产生多种立体异构体,需要额外的拆分或不对称合成步骤。原研究中的化学家因此对该片段进行了手工简化。
SynCraft在输入相同分子并结合蛋白相互作用信息后,自主指出该二甲基哌嗪是主要合成负担,并给出删除两个甲基取代所对应碳片段的编辑方案,将其转化为无手性的对称哌嗪骨架。值得注意的是,这一策略与原研究人员最终实际合成的IIP0944高度一致。模型虽然没有完全复制人类最终结构中的所有细节,但核心判断——通过消除不必要立体中心解决可开发性问题,同时保留关键含氮药效团——与人工药物化学优化方向一致。
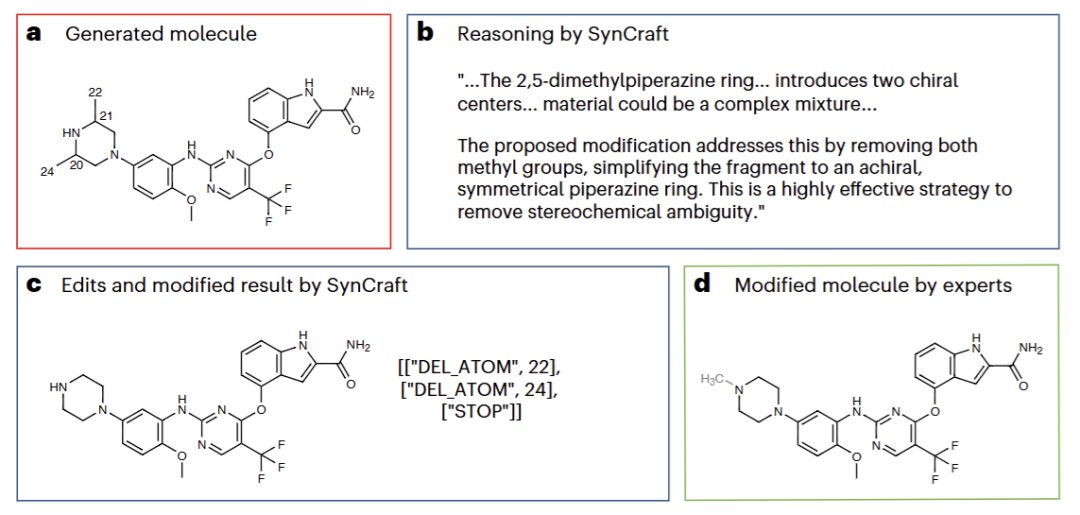
图3|SynCraft对PLK1生成分子的回顾性优化:模型识别2,5-二甲基哌嗪的立体化学负担,并复现人类药物化学家的去甲基化策略。
相互作用约束帮助挽救被放弃的高评分RIPK1候选物
生成式药物设计中经常存在大量“孤儿设计”:它们具有很高的对接或模型评分,却因为合成困难而被放弃。研究人员从一项RIPK1抑制剂研究中选取42个高评分但未进入合成阶段的分子,使用interaction-aware SynCraft进行优化。
对全部候选物系统重对接后,81%的分子至少有一个编辑结果能够保留原始分子50%以上的蛋白–配体相互作用,50%的候选可以保留70%以上;74%的候选拥有至少一个编辑结果,其Vina得分不差于原始结构,平均变化为−0.34 kcal mol⁻¹。说明可合成性改善并不必然以结合模式损失为代价。
其中一个案例包含两个电子缺陷芳环之间直接形成的C–C键,模型判断这一连接在空间位阻和电子效应上都不利于常规偶联,因此在两部分之间插入氧原子,将困难的C–C偶联转化为更可靠的C–O键形成。新分子的对接评分由−10.7变为−10.2 kcal mol⁻¹,同时保持与Asp156的关键氢键和Leu23等位点的疏水作用。
另一个候选具有复杂、非平面的稠合多环核心。SynCraft直接进行较大尺度的骨架替换,将其转换为更易合成的2,4-二取代嘧啶,同时用杂环氮模拟原有氢键受体,并重新安排取代基方向以保持空间相互作用。优化后Vina评分仍达到−9.9 kcal mol⁻¹,与原始−10.2 kcal mol⁻¹接近。这表明模型不仅能执行小修小补,在必要时也可以进行带有药效团约束的合理骨架迁移。
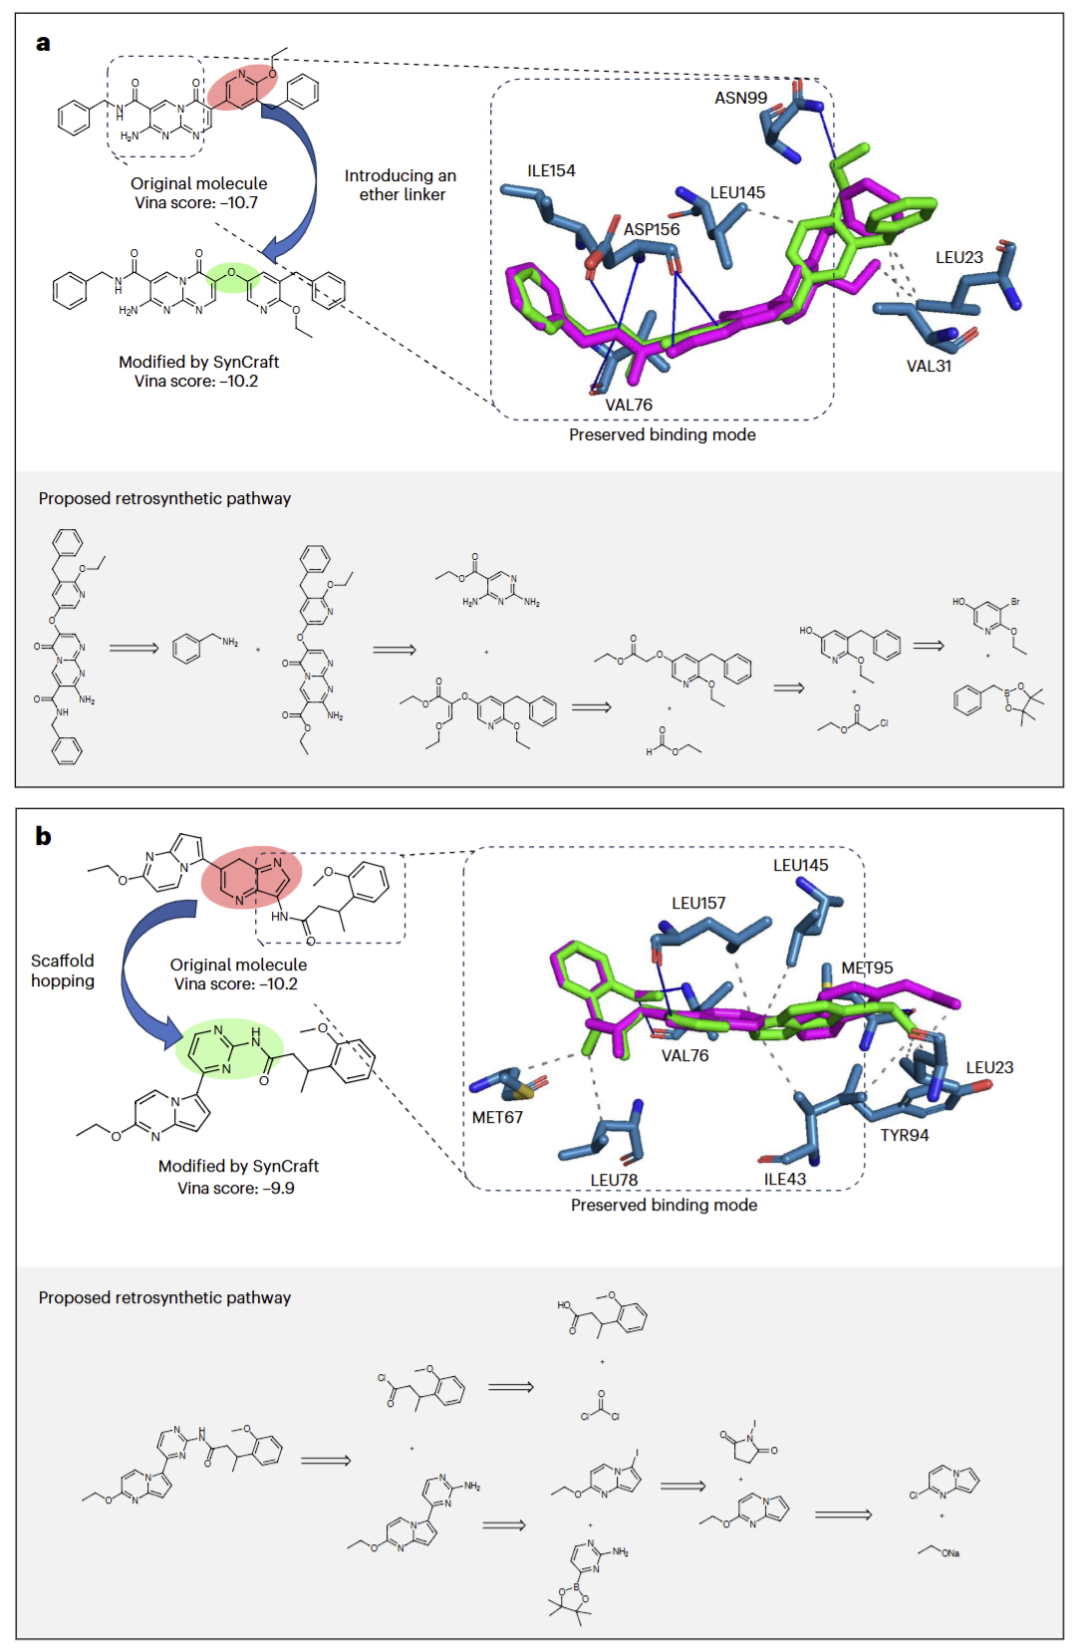
图4|SynCraft对RIPK1高评分但难合成候选物的前瞻性挽救,包括醚桥替换和受相互作用约束的骨架迁移。
Agent化SynCraft实现从三维生成到可合成候选的端到端修复
研究人员进一步将SynCraft封装成一个可调用的agent skill,使其接收分子SMILES和蛋白PDB结构后,自动完成合成问题识别、编辑、逆合成检查、重对接和评分,并返回候选结构及推理记录。
研究以TargetDiff针对SARS-CoV-2主蛋白酶生成的47个候选物为例。在原始结构中,仅1个能够直接通过既定逆合成流程。对于剩余46个不可合成分子,SynCraft分别采用“最大化挽救”和“优先保持相互作用”两种模式,每个模式生成10个候选编辑。两种模式的并集最终成功挽救32个分子,成功率约70%。
更重要的是,修复并未明显牺牲预测结合能力。对于具有成对对接数据的成功候选,最佳编辑分子与原始结构的平均Vina差值仅为+0.14 kcal mol⁻¹,大部分变化落在±1 kcal mol⁻¹范围内,两组得分分布基本重合。也就是说,SynCraft在显著改善合成可行性的同时,整体保留了原始三维生成模型已经优化得到的结合优势。
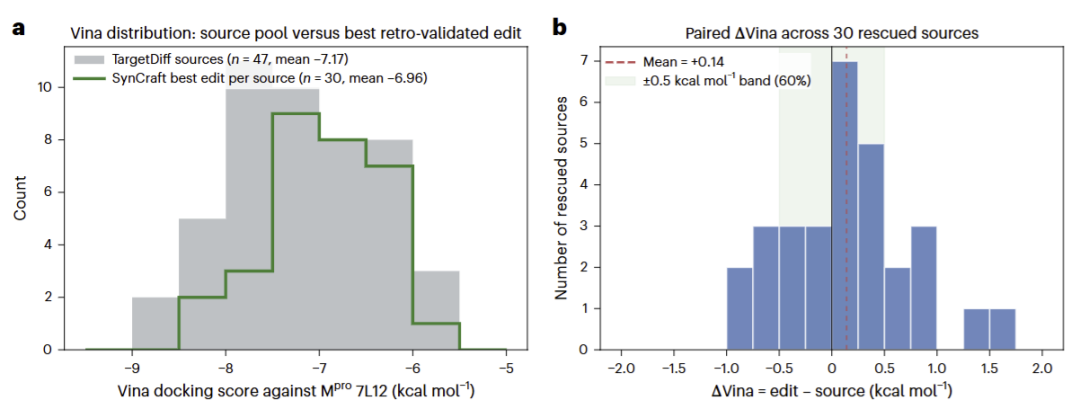
图5|SynCraft agent skill在SARS-CoV-2 Mpro生成候选中的端到端修复效果,以及修复前后分子对接评分的保持情况。
讨论
SynCraft所解决的问题并不是如何生成更多分子,而是如何让已经生成的高价值分子真正进入实验。其关键设计是把“大语言模型擅长推理但不擅长严格化学语法”这一特点转化为优势:模型负责识别合成风险并提出结构修改策略,而真正的分子图操作和合法性验证则由确定性工具完成。这样既保留了大语言模型的化学知识和推理能力,也避免了直接生成SMILES时常见的语法和结构幻觉。
这一工作也提出了一个值得关注的分子优化范式。传统可合成性优化通常把问题理解为“寻找附近可合成分子”,而SynCraft将其理解为“找出导致不可合成的局部原因并精确修复”。这种思想更接近真实药物化学实践:化学家往往不会因为一个局部合成问题放弃整个高活性骨架,而会尝试生物电子等排替换、消除不必要手性中心、改变连接基团或在必要时进行受药效团约束的骨架迁移。
不过,SynCraft仍有明显局限。当前最大失败来源并非无效编辑,而是修改后的分子仍无法在30分钟的SimpRetro搜索预算中找到路线,因此更强的逆合成覆盖仍可能进一步提升成功率。其次,interaction-aware模式只是把PLIP相互作用以文本标签传递给大语言模型,并未直接让模型理解完整三维几何。例如,环尺寸改变可能保留所有被标记的相互作用原子,却改变其实际空间方向。研究人员因此认为,将分子编辑与三维打分循环更紧密地耦合,是下一步的重要方向。
总体来看,SynCraft展示了一种从“LLM生成分子”转向“LLM指导分子编辑”的思路。它尤其适合生成模型之后的高价值hit优化阶段:在尽量保留原始骨架、药效团和结合模式的同时,用少量有针对性的修改跨越合成悬崖。随着逆合成、三维结构评价和多智能体药物设计流程进一步整合,这类推理驱动的分子编辑器有望成为连接虚拟分子设计与真实实验化学的重要中间层。
参考资料
Li, J., Lai, L. Guiding large language models to predict edit sequences for molecular synthesizability optimization. Nat Mach Intell (2026).
https://doi.org/10.1038/s42256-026-01304-x
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢