

DRUGONE
噬菌体因其能够选择性杀伤特定细菌,被视为应对耐药菌感染和开展精准微生物组工程的重要工具。然而,噬菌体的宿主范围通常具有高度菌株特异性,即使属于同一物种,不同细菌菌株对同一噬菌体的敏感性也可能完全不同。现有噬菌体筛选仍高度依赖逐一实验验证,而且许多计算方法依赖特定物种、已知受体或系统发育信息,难以推广到新的细菌和噬菌体。研究人员提出一种系统发育无关的机器学习框架,仅利用细菌和噬菌体基因组信息,在菌株水平预测二者是否发生感染。该框架整合6个公开数据集,共覆盖115,037个相互作用、949个细菌菌株和518个噬菌体,并通过超过1,320万次模型训练系统优化基因组表示、特征选择和机器学习算法。
最终模型使用蛋白家族存在–缺失特征,通过递归特征消除筛选稳定的预测因子,再利用CatBoost梯度提升决策树预测感染概率。在不同数据集中,对未见菌株的AUROC达到0.67–0.94,与针对特定物种开发的方法相当。研究人员进一步实验测试52个训练中未见的噬菌体与25个大肠杆菌菌株之间的1,240个明确相互作用,模型AUROC达到0.84。全基因组RB-TnSeq实验还显示,68.6%的实验确认感染相关基因能够与模型预测特征直接或间接对应。将预测结果用于噬菌体组合设计后,5噬菌体组合可覆盖最高97.5%的目标菌株,说明该方法能够把全基因组机器学习预测进一步转化为实际的噬菌体选择策略。
噬菌体和细菌长期处于共同进化的“军备竞赛”中。细菌不断改变表面受体、细胞壁结构和抗噬菌体防御系统,噬菌体则通过改变受体结合、注入以及反防御机制维持感染能力。正因为这种高度特异的共同进化关系,噬菌体通常能够精准攻击特定菌株,而较少影响其他共生菌。这种特性使其具有替代广谱抗生素的潜力,尤其适合耐药菌治疗和微生物群精准调控。
但高度特异性同时也是应用瓶颈。面对一个新分离的临床菌株,研究人员往往需要从数十甚至数百个噬菌体中逐一测试感染能力。随着噬菌体库规模不断扩大,这种实验筛选越来越难以满足快速临床决策需求。已有计算方法可以根据基因组预测噬菌体宿主,但许多方法主要解决属或种水平的宿主分类,并不能回答“这个噬菌体能否感染这个具体菌株”。菌株水平预测则更加困难,因为感染受到受体、荚膜、脂多糖、防御系统、前噬菌体以及大量调控因子的共同影响。
另一个挑战来自数据维度。一个完整细菌或噬菌体基因组可产生数千至数万个蛋白、基因片段或k-mer特征,而可获得的噬菌体–宿主实验数据却通常较少且严重不平衡,部分数据集中真正发生感染的组合只占2%–5%。模型因此很容易记住特定菌株谱系,而不是学习真正决定感染的遗传因素。为避免这一问题,研究人员希望建立一种不依赖预先定义受体、特定基因位点或系统发育距离的通用框架,使模型直接从全基因组中选择与感染相关的信息。
方法
研究人员收集6套具有明确感染/不感染结果的噬菌体–宿主矩阵,并将细菌和噬菌体基因组转换为多种候选表示,包括完整蛋白家族、氨基酸k-mer以及二者组合。整个流程系统比较8种机器学习算法、6类特征选择策略以及多种类别平衡、数据划分和特征过滤方案,总计训练超过1,320万个模型。最终流程使用MMSeqs2将蛋白按照序列相似性聚类为蛋白家族,并把每个基因组表示为蛋白家族是否存在的二进制向量;随后利用递归特征消除寻找在不同数据划分中反复出现的稳定特征,并采用带有噬菌体特异类别权重的CatBoost预测感染概率。为严格评价泛化能力,研究人员分别设置“新菌株–已知噬菌体”“已知菌株–新噬菌体”和“新菌株–新噬菌体”三种测试场景,并确保测试对象在整个特征选择和训练阶段均不可见。模型预测还通过SHAP进行解释,并进一步结合RB-TnSeq、基因邻域以及蛋白相互作用网络验证预测基因的生物学意义。
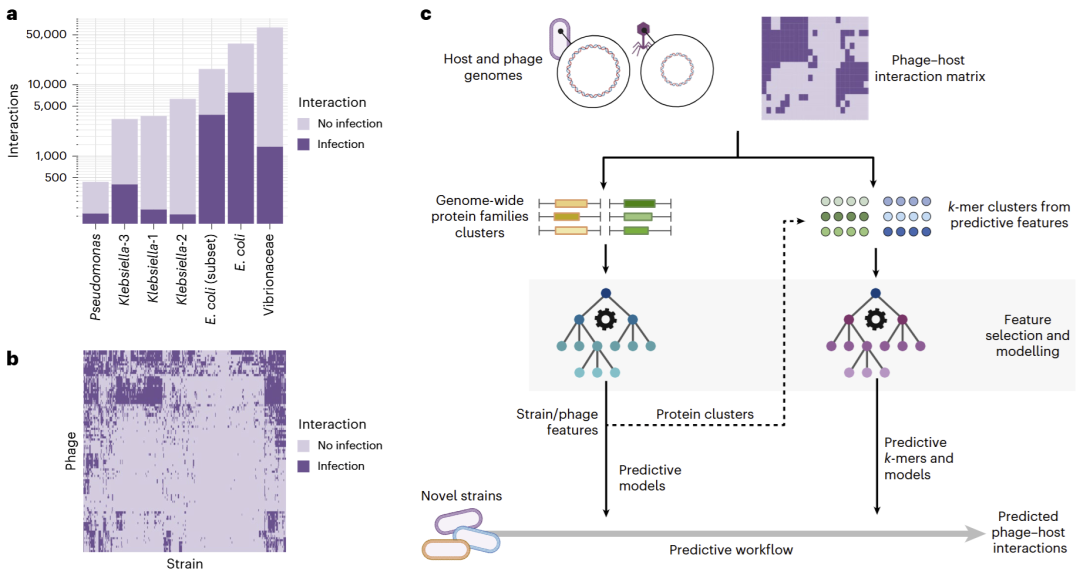
图1|噬菌体–宿主相互作用数据集及系统发育无关机器学习流程,包括基因组特征构建、特征筛选和菌株水平相互作用预测。
结果
全基因组特征能够支持跨菌株的噬菌体感染预测
研究人员首先比较不同基因组表示策略。除最短的3-mer表示明显较差外,蛋白家族、较长k-mer以及混合表示之间整体差异有限,说明多种全基因组表示都能提取足够的感染相关信息。考虑计算成本和可解释性后,最终选择蛋白家族作为主要特征。
在最贴近实际应用的“新菌株–已知噬菌体”场景中,不同数据集AUROC约为0.67–0.94。其中Vibrionaceae达到0.941,Klebsiella-2为0.878,大肠杆菌为0.869,Pseudomonas为0.745。大肠杆菌模型的表现与此前针对大肠杆菌专门开发、依赖已知感染机制的方法基本相当,但新框架并未预先限定任何受体或特定基因。
模型性能与数据集规模呈明显正相关。总相互作用数量越多,AUROC和MCC越高且不同交叉验证轮次之间的波动越小。表现最低的Klebsiella-1仅包含3,658个相互作用,而且阳性比例不足5%,提示当前限制更多来自训练数据数量和类别不平衡,而不是模型完全无法学习菌株级规律。
研究人员还尝试合并不同数据集。同属Klebsiella的两个独立数据集合并后性能得到一定改善,说明不同实验室产生的数据可以共同增强模型。然而跨属合并并未带来类似收益,而且把整个属完全留出后预测性能明显降低,说明噬菌体感染机制仍具有较强的属特异性。
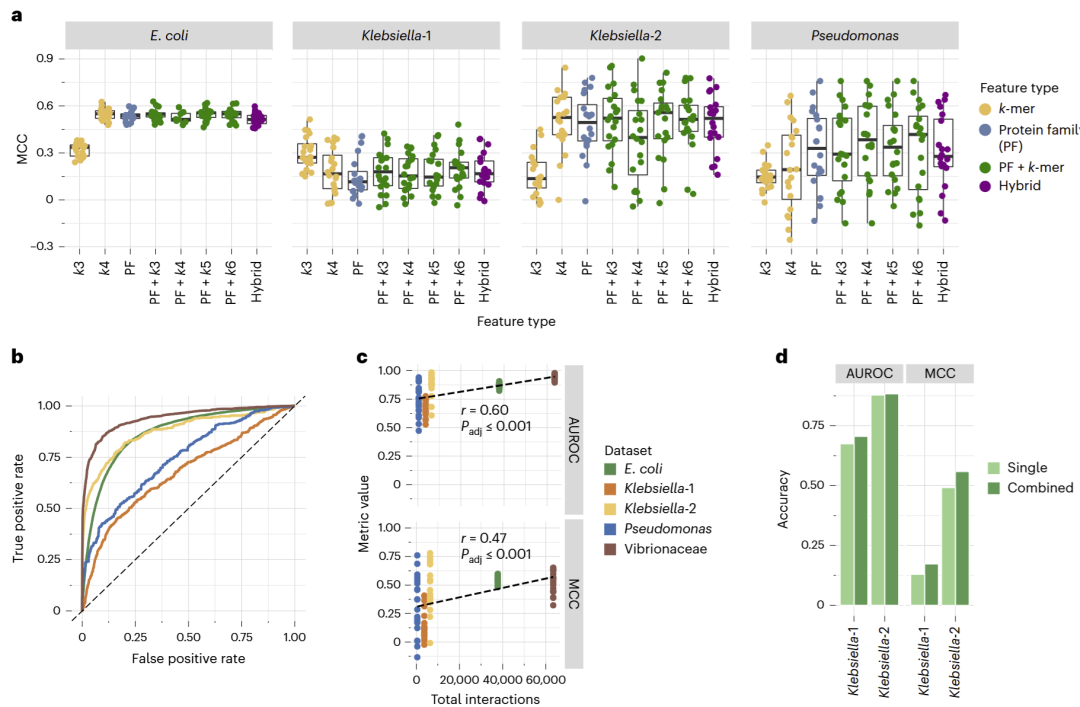
图2|不同基因组表示、数据集规模及数据合并策略对菌株水平噬菌体–宿主预测性能的影响。
模型预测能够直接指导噬菌体组合设计
获得感染概率后,研究人员进一步测试这些预测是否能用于实际噬菌体选择。噬菌体治疗往往不会只使用单个噬菌体,而是构建由多个具有不同感染机制的噬菌体组成的组合,以扩大宿主覆盖并降低细菌同时产生耐药的概率。
研究人员首先按照噬菌体宿主谱和预测特征对噬菌体进行聚类,形成不同“活性组”,随后针对目标菌株从不同组中选择预测感染概率最高的噬菌体,从而同时兼顾预测活性与机制多样性。与简单选择历史上宿主范围最广的“高泛化噬菌体”相比,模型指导的组合在三个最大数据集中均表现更好。
仅选择1个噬菌体时,模型即可为66.9%的大肠杆菌菌株、66.7%的Klebsiella菌株和39.4%的Vibrionaceae菌株找到有效噬菌体。对于Klebsiella和Vibrionaceae,这分别相当于比基于宿主广谱性选择提高3.1倍和2.7倍。扩展到5噬菌体组合后,大肠杆菌覆盖率达到97.5%,Klebsiella达到87.8%,Vibrionaceae达到57.5%。
这意味着模型的价值并不只是提高一个分类指标,而是能够把庞大的噬菌体库快速缩减为少数值得优先实验验证的候选,从而直接减少筛选规模。
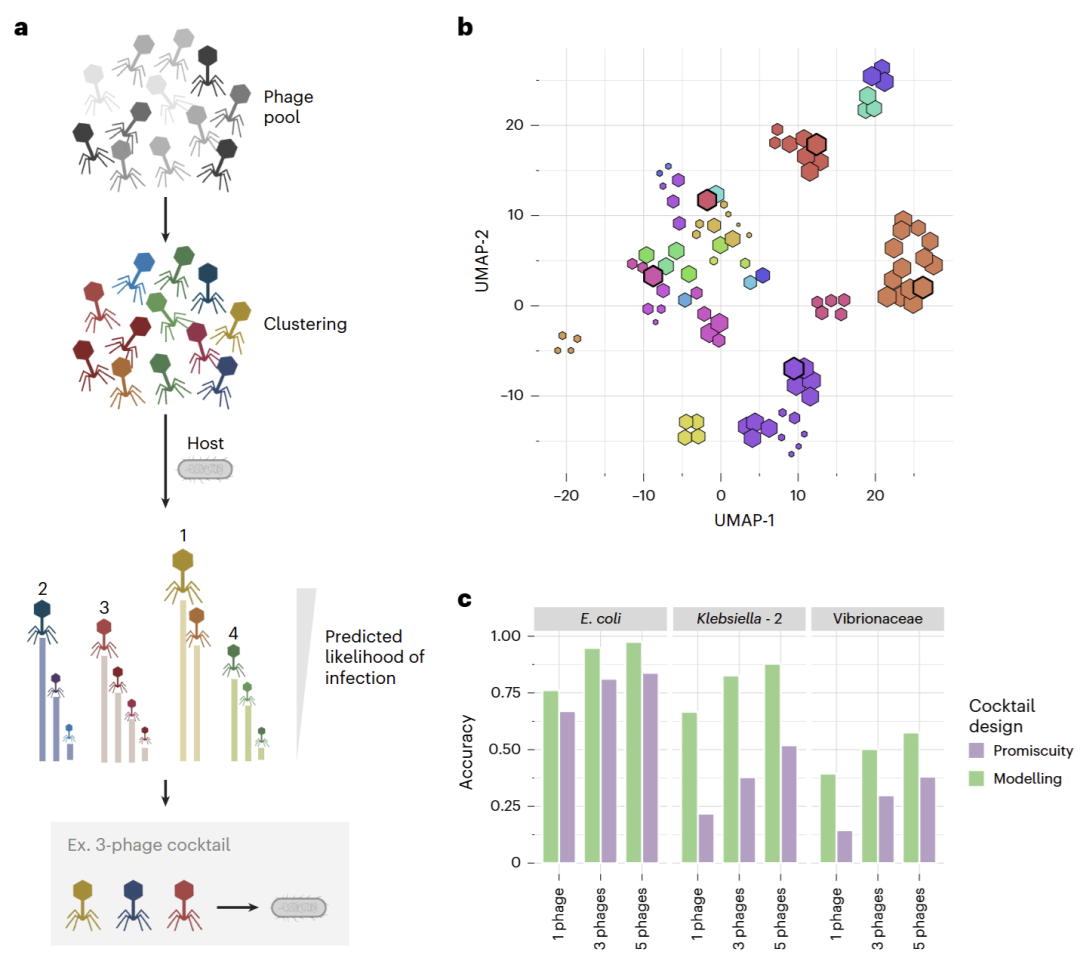
图3|基于预测感染概率和噬菌体功能多样性的噬菌体组合设计,以及与传统广谱噬菌体选择策略的比较。
独立实验验证模型能够泛化到从未见过的噬菌体
交叉验证仍可能受到已有数据分布影响,因此研究人员进一步进行完全独立的前瞻实验。他们选择52个训练数据中从未出现的BASEL噬菌体,与25个已在模型数据集中出现的大肠杆菌ECOR菌株构建1,300个相互作用矩阵。排除60个表型不明确的组合后,最终获得1,240个明确感染或不感染结果。
模型在这些新噬菌体上的AUROC达到0.84,仅略低于交叉验证中的0.87。更重要的是,这些实验由不同实验条件和独立噬菌体集合生成,说明模型并非简单记忆训练集中某些噬菌体序列特征,而能够在新的实验背景中保持较好的宿主预测能力。
为了验证模型特征是否真正对应感染机制,研究人员又在E. coli ECOR27中构建全基因组随机条形码转座子文库,并使用19个噬菌体进行筛选。实验共鉴定51个对感染具有重要作用的宿主基因。将这些基因与机器学习筛出的预测特征比较后,12个可以直接对应,10个位于预测基因邻近区域,13个则通过蛋白功能关联网络与预测特征相连,合计35个,即68.6%的实验感染决定因素可与模型特征建立联系。
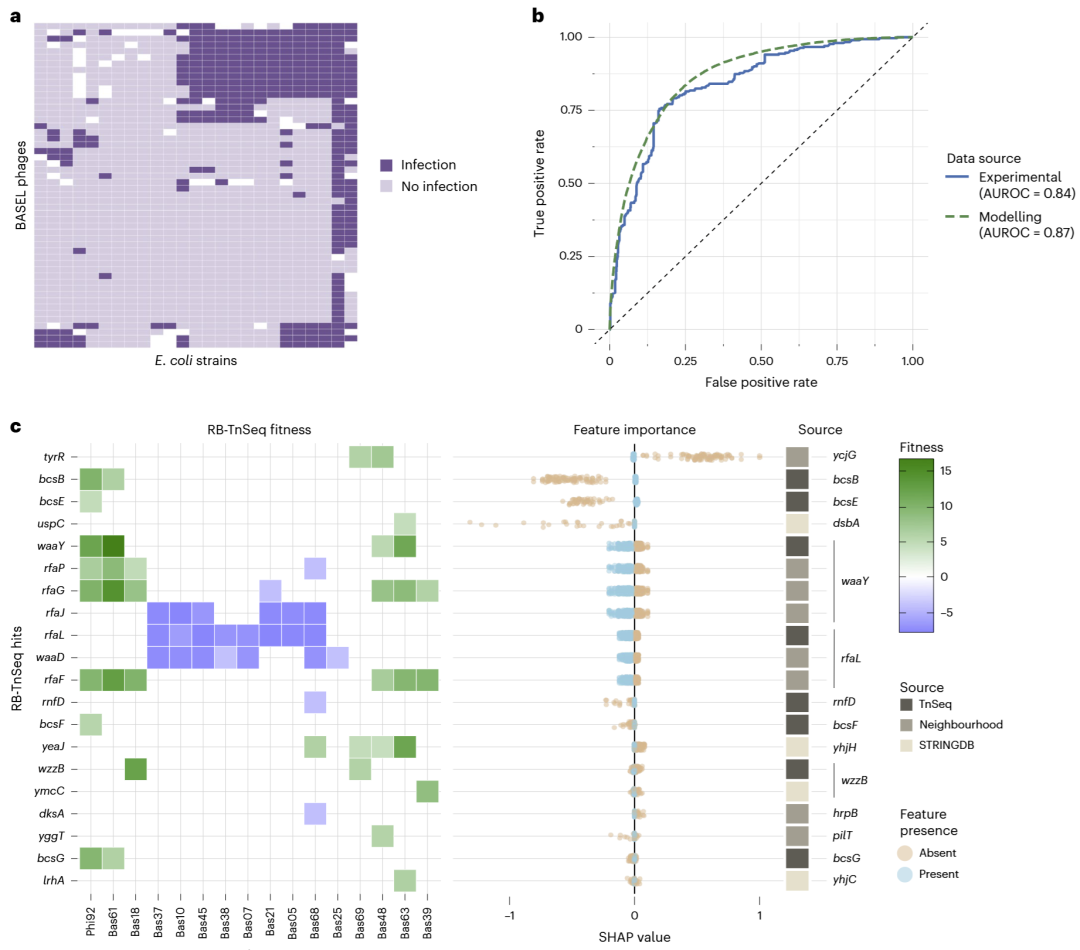
图4|新噬菌体–大肠杆菌相互作用的独立实验验证,以及机器学习特征与RB-TnSeq感染决定基因之间的对应关系。
可解释特征揭示已知和潜在的新型感染决定因素
蛋白家族表示的一个重要优势是,每一个机器学习特征都可以直接回溯到具体基因。研究人员使用SHAP分析某一蛋白家族的存在或缺失如何提高或降低感染概率,并对预测特征进行功能注释。
在大肠杆菌中,高重要性特征覆盖细胞壁和细胞表面生物合成、可移动遗传元件、限制修饰系统、病毒来源基因和转运系统等多个已知噬菌体感染机制。防御系统通常与较低感染概率相关,而反防御系统则更倾向提高感染概率,与预期生物学规律一致。
模型同时发现一些尚未明确与噬菌体感染联系的候选特征。例如,对预测基因进行STRING网络分析后,提示腐胺代谢途径可能参与感染调控;基因邻域分析还发现预测特征ybdK与已知噬菌体受体fepA在多个菌株中相邻,提示模型可能捕捉到受体调控或局部基因组背景,而不仅仅是受体基因本身。
另一个有趣现象是,在同一个功能通路中,RB-TnSeq可能检测到多个成员,而模型往往只选择其中一个代表性调控因子作为高重要特征。这表明机器学习可能是在识别整个通路或操纵子状态的代理信号,而不一定需要把所有真实因果基因全部选入模型。
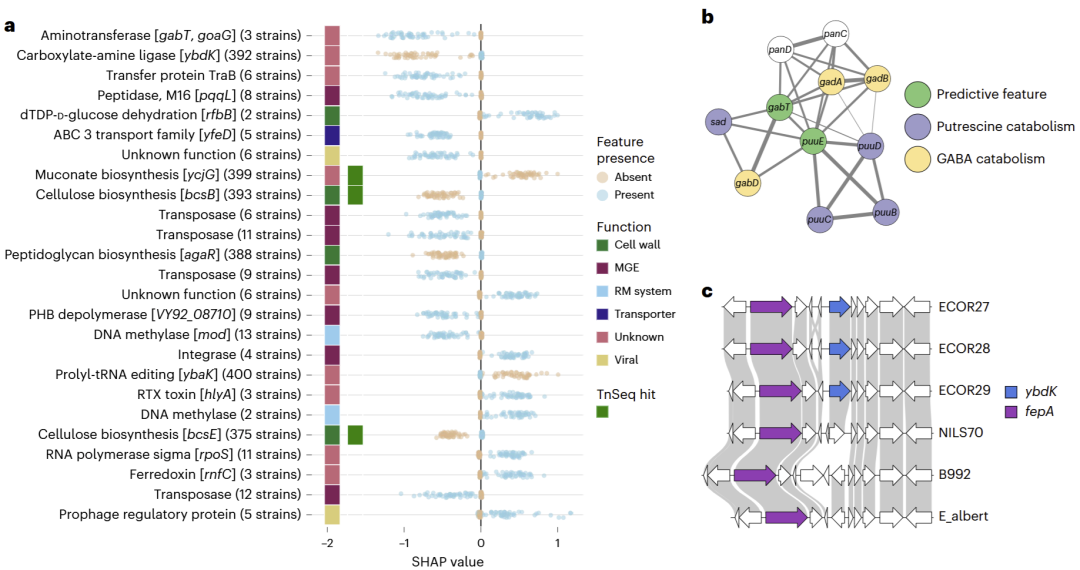
图5|模型高重要性蛋白家族的功能解释,包括细胞壁、防御系统、移动遗传元件以及潜在的新型噬菌体感染调控机制。
讨论
这项研究试图解决噬菌体精准应用中的一个现实问题:面对一个新菌株,仅凭其基因组能否从已有噬菌体库中快速挑出最可能有效的候选。与依赖物种特异受体知识的方法不同,该框架从整个宿主和噬菌体基因组中自动选择特征,因此既可以恢复已知感染机制,也有机会发现此前未被关注的遗传因素。
研究还表明,模型算法和特征筛选策略对最终性能的影响甚至大于采用蛋白家族还是k-mer等基因组表示方式。换句话说,这类任务真正困难的部分并不是“如何把基因组编码成数字”,而是如何从极高维、稀疏且严重不平衡的数据中找到稳定且可迁移的感染信号。
不过,“系统发育无关”并不意味着模型可以完全跨越任意细菌类群。属内泛化表现较好,但跨属预测仍然明显困难,说明不同细菌属的噬菌体可能依赖不同受体、防御系统和细胞表面结构。此外,不同公开数据集使用固体或液体培养体系,对“感染”的定义也并不完全一致,这种实验差异会限制跨数据集学习。未来若建立标准化、大规模的社区噬菌体–宿主矩阵,并引入蛋白语言模型或结构信息,跨属预测仍有进一步提升空间。
RB-TnSeq验证同样存在边界,它主要能够发现非必需且突变后产生明显适应度变化的基因,因此无法完整评价所有模型特征,尤其是必需基因。研究人员提出未来可结合CRISPRi等方法验证这些候选机制。
总体而言,该工作将噬菌体宿主预测从依赖特定受体和特定物种知识的模型,推进到面向全基因组的菌株级预测,并进一步连接实验验证和噬菌体组合设计。它并不能完全替代感染实验,但可以显著缩小需要测试的候选范围,使噬菌体治疗和精准微生物组工程逐渐从“逐一筛选”走向“模型优先、实验确认”的设计模式。
整理 | DrugOne团队
参考资料
Noonan, A.J.C., Moriniere, L., Rivera-López, E.O. et al. Phylogeny-agnostic strain-level prediction of phage–host interactions from genomes using machine learning. Nat Microbiol (2026).
https://doi.org/10.1038/s41564-026-02482-5
内容为【DrugOne】公众号原创|转载请注明来源
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢