

DRUGONE
大多数新发传染病具有动物源性,而野生哺乳动物是重要的病毒储存宿主。然而,目前已知的哺乳动物–病毒关联只覆盖真实网络中的很小一部分,且现有数据受到显著采样偏倚:某些宿主类群、病毒家族和地理区域由于公共卫生事件、研究便利性或既往关注而被反复研究,而大量缺乏记录的宿主–病毒组合并不能被简单视为“真实不存在”。针对这一问题,研究人员提出 动态正例–未标记学习(Dynamic Positive–Unlabeled learning,DPU) 框架,将未知宿主预测明确建模为正例–未标记问题,而不是传统的正负二分类。
DPU同时建立两个相互补充的模型:一个分类器预测某一哺乳动物–病毒关联真实存在的概率;一个倾向得分模型预测如果这一关联确实存在,它被当前科学研究发现并记录下来的概率。前者学习生物学上的宿主适配关系,后者显式描述研究力度和采样偏差。研究人员进一步让这两个模型都动态依赖当前已知宿主–病毒网络,使新发现能够不断改变后续推断。该框架被应用于全球5,330种陆生哺乳动物和33个病毒家族,整合宿主系统发育、地理分布、生活史特征、病毒遗传特征以及已有宿主–病毒网络。模型对训练时期尚未发现、后来被实验确认的新关联给出的中位预测概率达到0.82,并推测真实哺乳动物–病毒家族关联数量可能是当前记录的约8.6倍。
动物源性病毒溢出是全球公共卫生的重要威胁。现有研究认为,大量哺乳动物病毒仍未被发现,而真正具有潜在人兽共患风险的病毒数量也存在很大不确定性。与疫情暴发后的应对相比,提前识别潜在宿主并开展有针对性的病毒监测成本更低,因此一个核心问题是:在有限资源下,应优先对哪些野生动物和病毒类群开展调查。
近年来,机器学习被越来越多地用于推断缺失的宿主–病毒关联。基本思想是从已有宿主关系、物种性状、系统发育和地理信息中学习规律,再预测哪些未记录组合最可能真实存在。但现有方法面临两个根本困难。第一,已有数据库并不是随机抽样得到的。蝙蝠、啮齿动物、灵长类以及具有重要人畜共患风险的病毒通常受到更高研究关注;资源丰富地区也往往拥有更多病毒监测数据。因此,“记录多”既可能意味着真实病毒多,也可能只是被研究得更多。第二,病毒宿主研究几乎没有可靠的“负样本”。一次PCR或测序阳性即可确认宿主关联,但没有检测记录并不能证明宿主真的不会感染该病毒。
传统模型常把所有未记录组合直接当作负例,即假设数据库之外的关联都不存在。这种“封闭世界”假设会把尚未被发现的真实宿主错误地作为负样本训练模型。已有改进方法有时会选择部分未标记样本作为伪负例,或者对类别不平衡进行修正,但本质上仍然把问题转化为普通二分类。
研究人员认为,未知宿主预测更适合建模为正例–未标记学习:已观察关联是确认的正例,而未标记数据则混合了真正不存在的关系和尚未发现的真实关系。更进一步,某条关联是否被观察到本身也具有动态性。随着某个病毒在某类宿主中被发现,相关宿主和相邻地区往往会获得更多后续研究,使其他真实关联被发现的概率上升。因此,DPU不仅区分“是否真实存在”和“是否被研究发现”,还让两个过程随着已知网络不断更新。
方法
研究人员从VIRION数据库收集已知陆生哺乳动物–病毒关联,并将病毒统一到家族层级,以降低病毒物种层面数据极度稀疏造成的影响。最终数据包含5,330种哺乳动物、33个病毒家族和4,968个已知关联,另从后续GenBank记录中提取686个训练时期尚未出现的新关联用于独立验证。每种哺乳动物使用18项特征,包括体重、寿命、繁殖特征、营养级及系统发育特征;病毒使用核酸类型、单链/双链、基因组结构、是否分节段和是否具有包膜等7项特征。宿主之间还建立系统发育网络和基于地理分布重叠的生物地理网络。DPU由两个部分组成:分类器使用图神经网络,在已知哺乳动物–病毒网络、宿主系统发育和地理网络之间传播信息,预测真实关联概率;倾向得分模型使用层次贝叶斯框架,根据宿主分类、已有病毒记录数量、地理研究强度和病毒家族等因素估计真实关联被发现的概率。训练过程中,每个待预测关联自身的标签都会被屏蔽,以防信息泄漏。最终,两类概率联合用于判断一个未记录组合究竟更可能是真实缺失关联,还是在高研究强度下仍未发现、因而更可能真实不存在的关系。
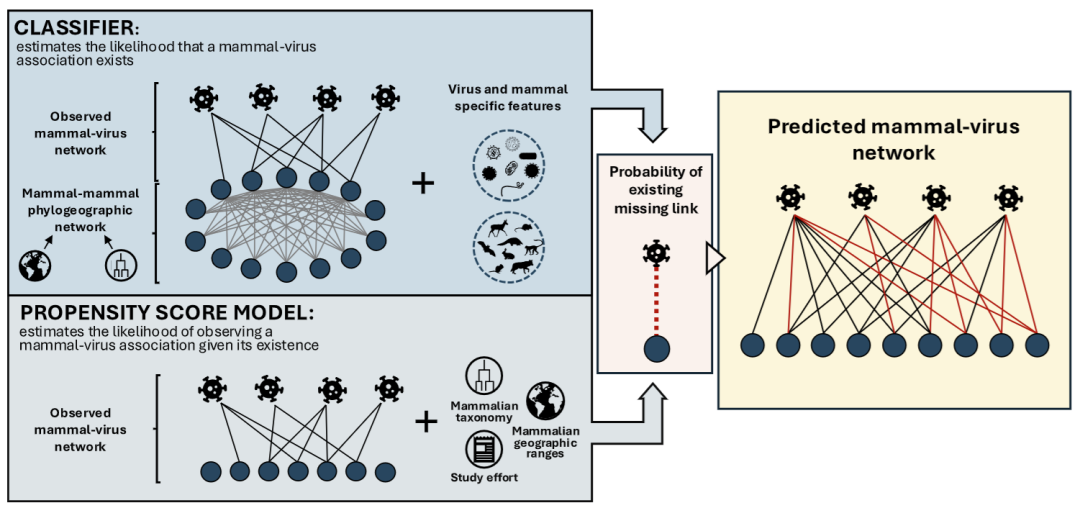
图1|动态正例–未标记学习框架:图神经网络预测真实宿主关联,层次贝叶斯模型估计采样倾向,并联合推断尚未记录的哺乳动物–病毒关系。
结果
DPU能够从大量未标记关系中识别后来被证实的真实宿主
研究人员首先进行10折交叉验证。在把未标记关系暂时按负例计算的保守评估下,测试集ROC-AUC约为0.91,召回率约为0.88。由于未标记集合本身包含未知正例,这些指标实际上低估了模型真实表现。更重要的是,无论宿主已经有很多病毒记录还是几乎没有记录,模型对已知阳性关系都能保持较高预测概率,说明结果并未完全偏向研究最充分的宿主。
更具有现实意义的验证来自“未来新发现”。研究人员利用2022年至2024年GenBank新增数据,找出686条在模型训练时还属于未标记状态、后来被PCR证实的哺乳动物–病毒家族关联。DPU对这些新发现的中位预测概率达到0.82,而持续未标记关系的中位概率低于0.01。将新发现与仍未发现关系进行排序比较后,SUPNLSC曲线AUC达到约0.81,表明模型能够在真正发现之前把真实关联优先排到前面。
研究人员还构建了两个具有完整真值的合成病毒家族。第一个模拟病毒主要感染Musteloidea,并扩展至近北界部分犬型类群;第二个则限定为非洲热带区的Laurasiatheria宿主。DPU在两个任务上分别达到ROC-AUC 0.90和0.81,并能够恢复宿主系统发育和地理限制。即使某些哺乳动物目在训练中没有任何阳性样本,模型仍可依赖系统发育和空间关系推断潜在宿主。
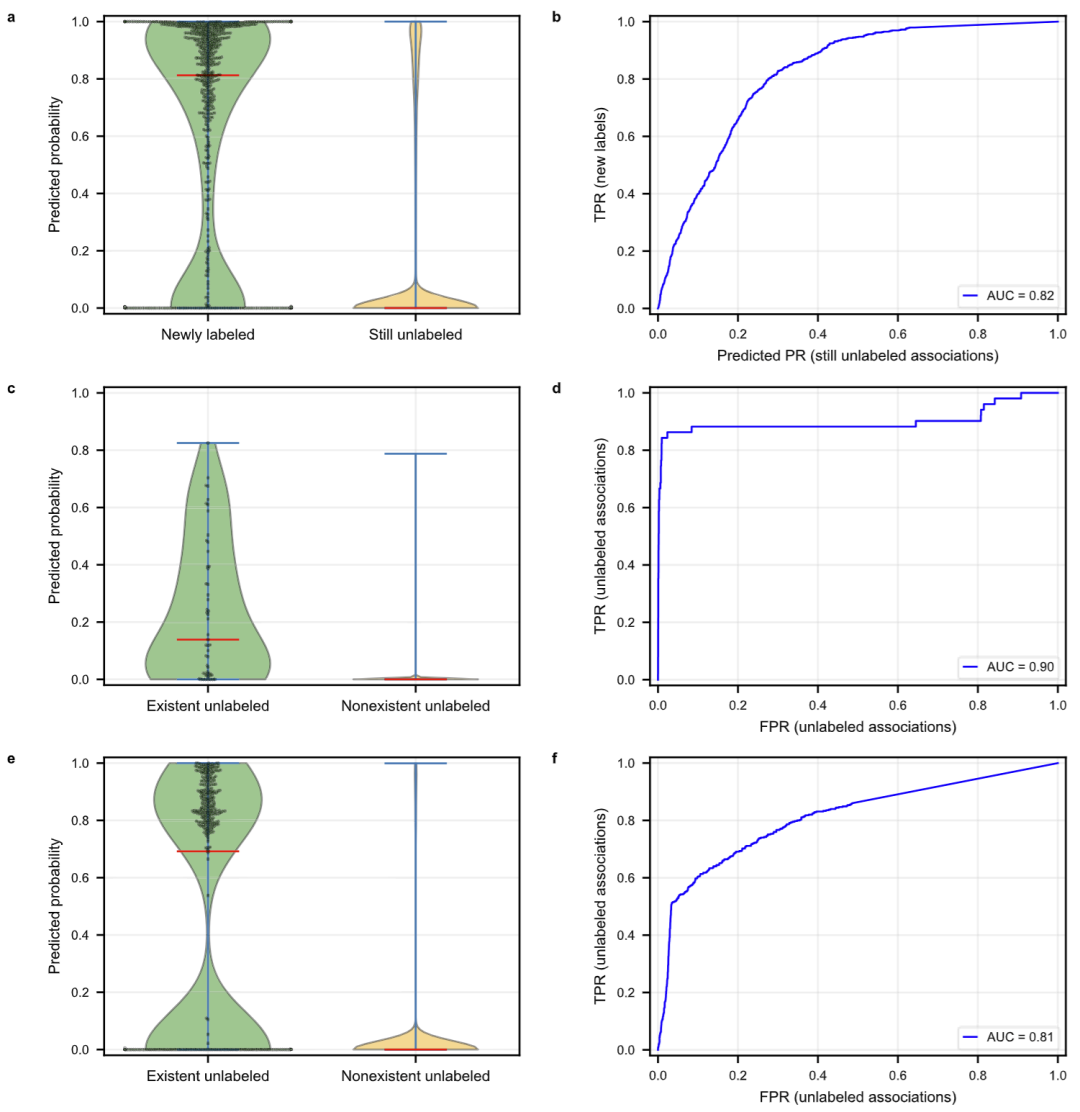
图2|DPU对后来新确认宿主关系以及合成真值数据的预测性能,包括新标签与持续未标记关系的概率分布和ROC分析。
图网络能够外推至缺乏既往病毒记录的宿主
传统宿主预测方法往往只分析已有至少一个病毒记录的物种,这会系统性排除全球大多数尚未充分研究的哺乳动物。DPU则将全部5,330种目标哺乳动物纳入统一图网络,通过与近缘物种以及地理共存物种的信息传播,允许没有任何已知病毒记录的宿主获得预测。
合成实验清晰展示了这种能力。例如,Pholidota在训练阶段没有任何与Syn2的已知关联,但模型依然给其中一个真实阳性物种约0.998的概率。模型偶尔也会在系统发育孤立、样本数量很小的类群中产生较高假阳性,例如Tubulidentata,但多数错误预测仍符合模拟数据设定的地理约束,说明模型更像是在合理边界附近过度扩展,而不是随机产生宿主。
进一步分析发现,DPU对宿主关系的推断同时依赖网络拓扑、系统发育和生物地理信息。例如,如果某病毒家族集中分布于一个哺乳动物支系,模型既可以通过宿主–病毒网络捕获病毒共现,也可以沿系统发育图和地理图将信号传播至近缘或空间重叠物种。因此,它不仅使用宿主“自身有什么性状”,还利用“与哪些已知宿主相似、共存,以及在整个病毒网络中的位置”。
全球哺乳动物病毒宿主网络可能远比当前记录丰富
在完成验证后,研究人员训练100个DPU模型组成集成,并让每个模型采用不同的倾向得分和网络子图,以反映研究努力分布的不确定性。结果预测中位约42,838条新的哺乳动物–病毒家族关联,约占当时所有未观察组合的25.2%。加入这些预测后,整个关联矩阵的稀疏度从96.8%下降至约72.4%,总关联数量相当于现有记录的约8.6倍。
预测的知识缺口并不只集中在经典高风险宿主。部分物种较少、研究不足的哺乳动物目表现出非常高的潜在病毒多样性,例如Afrosoricida的预测总关联数量约为当前记录的52倍;Hyracoidea约34倍,Cingulata约19倍。啮齿目和翼手目虽然已经被大量研究,仍存在大量潜在缺失宿主关系。
从病毒家族看,Flaviviridae、Paramyxoviridae和Herpesviridae拥有最多潜在新增宿主,其中Flaviviridae中位预测新增约3,507条关联,Paramyxoviridae约3,378条。某些当前记录较少的病毒家族则显示更高相对增长,例如Hepeviridae、Astroviridae和Circoviridae,预测宿主范围可增加约10倍以上。
经典人兽共患病毒家族也出现明显扩展。对于冠状病毒,模型除再次确认蝙蝠等典型宿主外,还预测奇蹄目和偶蹄类等宿主中存在大量未记录关联。对于副黏病毒,约87%的蝙蝠物种和85%的灵长类物种被预测可能至少与该病毒家族存在关联。这意味着如果这些预测得到进一步实验证实,全球病毒宿主分布和潜在监测重点可能需要显著调整。
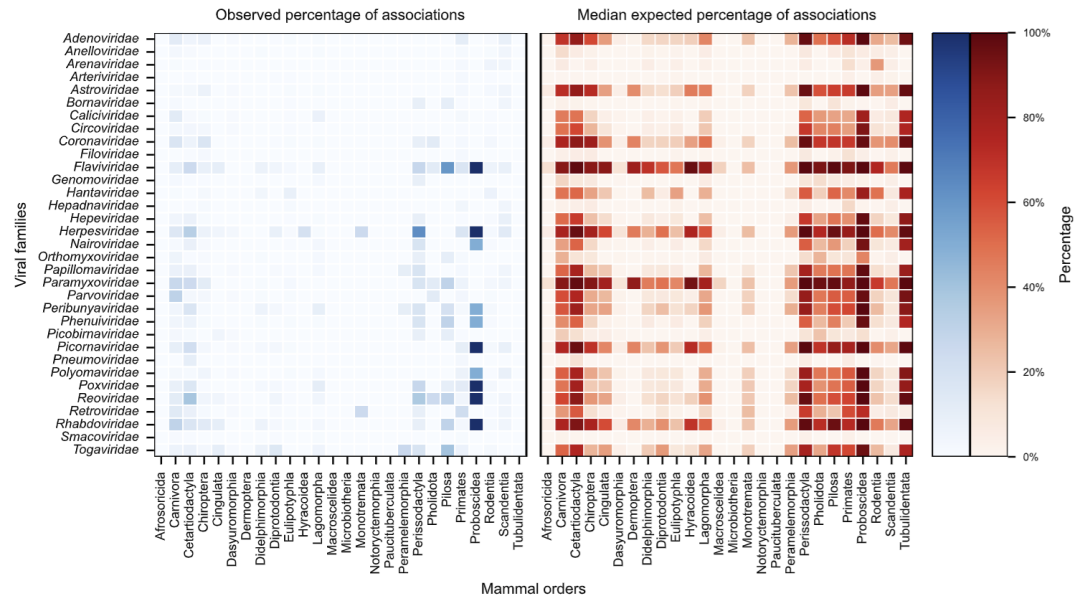
图3|不同哺乳动物目与病毒家族之间当前已知关联和DPU预测总关联的热图比较,显示潜在宿主网络的大幅扩展。
讨论
DPU最重要的方法学贡献,是把“真实不存在”和“只是没有被发现”明确区分开来。传统机器学习容易把数据库中的空白当作负样本,但在病毒宿主研究中,空白往往首先反映研究力度不足。DPU通过同时建模真实关联概率和观察倾向,把生物学信号与采样过程拆分,再利用两者联合判断未知关系。例如,一个生物学上看起来合理、但所在宿主几乎从未被研究的关联,应当被视为值得进一步调查的缺失关系;相反,如果一个宿主已经被大量研究,却始终未发现某病毒家族,那么“不存在”的证据会相对更强。
“动态”也是该框架区别于传统PU学习的重要特点。随着新宿主不断被发现,既有网络结构和研究努力都会改变,模型会重新计算其他组合的概率。这样,预测并不是一次性的静态结果,而可以随着病毒监测数据积累持续更新。这种设计与真实科研过程较为吻合:新发现往往会带动对近缘宿主和相邻地区的后续调查。
研究结果进一步提示,当前病毒宿主数据库可能严重低估真实关联广度,尤其是在长期被忽视的哺乳动物类群中。DPU并不能证明某个预测宿主确实携带某种病毒,而更适合作为监测优先级工具:有限的采样资源可以优先投入那些生物学概率高、但研究倾向得分低的宿主–病毒组合。研究人员指出,真鼩形目等长期采样不足的类群中,约76%的后来新增关联此前已经被模型赋予超过0.5的概率,体现了这种前瞻排序价值。
该方法仍存在限制。首先,100模型集成给出的区间主要反映不同研究努力估计带来的变化,并不是完整的预测不确定性;聚合到某个类群后的置信区间可能低估真实误差。其次,DPU仍倾向于从已有正例向相似宿主外推,因此对于网络中极度孤立、几乎没有邻近信息的物种,模型可能低估真实关联及其不确定性。第三,当前研究只预测到病毒家族层级,这提高了统计稳定性,却无法直接指出具体病毒种。
未来可以将DPU扩展到病毒属甚至病毒种,并加入鸟类以及蚊、蜱等重要媒介。当监测结果不断反馈给模型后,还可以形成主动学习闭环:模型决定下一批最值得采样的宿主,新增数据再更新网络,从而逐步减少全球病毒宿主知识盲区。
总体而言,这项研究并不是简单地用深度学习“猜测”未知宿主,而是重新定义了宿主预测中的数据缺失问题。通过同时考虑真实生物学联系、系统发育、地理关系以及“为什么这条关系可能还没有被发现”,DPU为不完整且严重偏倚的宿主–病毒网络提供了一种更符合现实的数据建模方式,也为从被动疫情响应转向主动、数据驱动的病毒监测提供了新的计算工具。
整理 | DrugOne团队
参考资料
Pignalberi, G., Tonelli, A., Giagu, S. et al. Predicting unknown mammalian viral hosts with Dynamic Positive–Unlabeled learning. Nat Commun (2026).
https://doi.org/10.1038/s41467-026-76416-4
内容为【DrugOne】公众号原创|转载请注明来源
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢