

2026年9月18日,华东师范大学李诗良/张凯/贺欢团队与郑州大学刘康栋教授和空军军医大学王哲教授,在药物化学《Journal of Medicinal Chemistry》期刊发表题为“Contrastive Learning for Metabolite-Aware Oral Drug Design”的研究论文。药物代谢性质不佳是导致候选药物研发失败的重要原因之一,尽管人工智能技术正在逐渐应用于药物代谢预测,但现有方法仍面临假阳性率较高、复杂代谢转化识别能力不足等问题。针对这一挑战,研究团队构建了包含11,665条人源特异代谢反应的数据库,并开发了融合化学特征交互与对比学习的代谢预测模型——Mettle。Mettle通过学习真实“反应物—代谢物”与大量结构相似但错误的候选代谢物之间的差异,提升对真实代谢转化的识别能力。针对前期发现的RSK4抑制剂口服生物利用度仅 0.99% 这一关键成药性瓶颈,利用Mettle成功识别其主要代谢热点,并据此指导分子结构优化,最终获得候选化合物 R636。R636在保持纳摩尔级RSK4抑制活性的同时,大鼠口服生物利用度达到 63%,较原先导化合物提高约 63倍,并在两种食管鳞状细胞癌(ESCC)患者来源异种移植(PDX)模型中表现出显著的口服抗肿瘤活性。该研究建立了一条从“人源代谢数据—AI代谢预测—代谢位点识别—分子生成与优化—实验验证—候选药物发现”的完整技术链条,为利用人工智能主动解决药物代谢瓶颈、提高先导化合物成药性提供了新的研究范式。
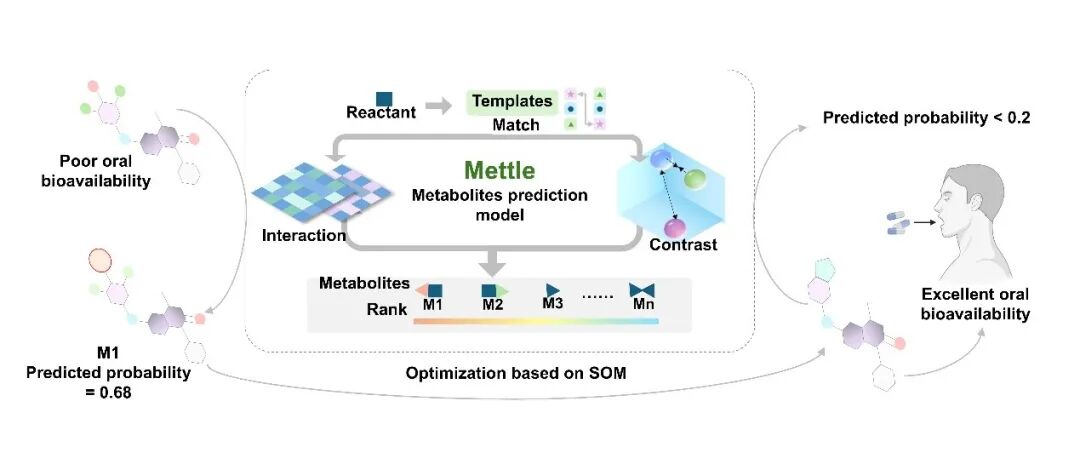
药物代谢性质是决定候选化合物能否顺利进入临床开发的重要因素之一。对于口服药物而言,过快代谢及显著的首过效应可能导致体内暴露不足和口服生物利用度降低,进而限制药效发挥。传统药物化学优化通常通过识别代谢位点(site of metabolism,SOM)并进行针对性的结构修饰来提高代谢稳定性,但这一过程在很大程度上依赖药物化学家的经验,需要经历反复的“设计—合成—测试—再设计”循环,同时还受到临床前种属与人体代谢差异等因素的影响。
1. 构建11,665条实验验证的人源代谢反应的数据集
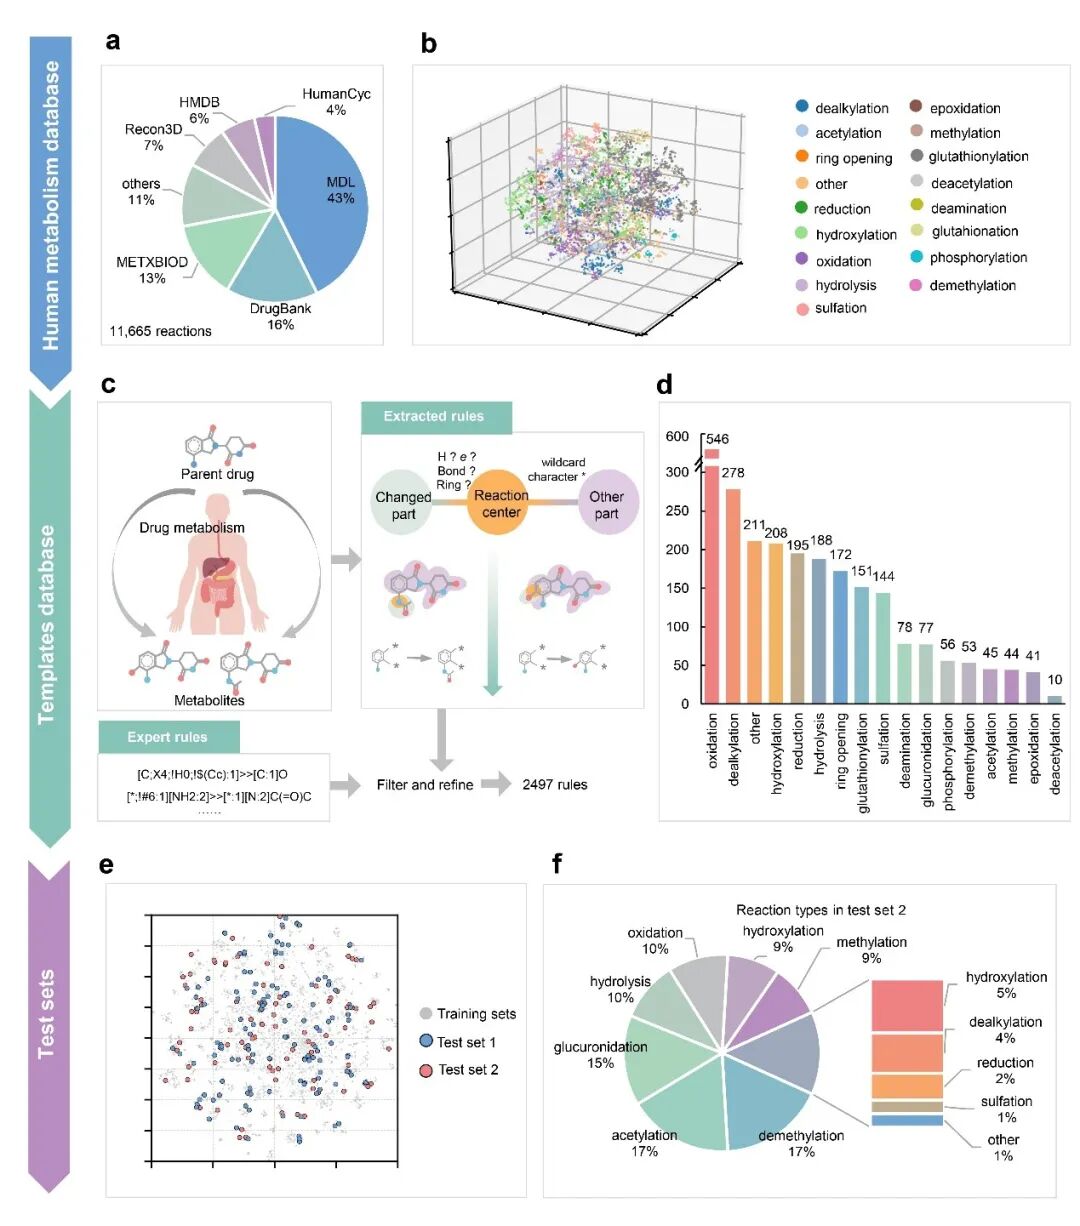
高质量数据是AI模型准确预测的基础。研究团队首先采取以人为中心的数据构建策略,整合MDL、DrugBank、MetXBioDB、GLORYx、Recon3D、HMDB和HumanCyc等多个数据来源,建立了包含11,665条经实验验证的人源代谢反应的大规模数据库,并将其系统划分为17类不同的代谢反应。
在此基础上,研究团队进一步建立反应模板提取流程,利用正向枚举算法结合RDKit系统提取代谢反应规则,并通过自动化过滤与专家人工校正进行严格筛选,最终获得2,497条高质量、非冗余的代谢反应规则。这些反应规则可以看作人类药物代谢过程中的“化学语法”,为模型学习不同化学结构如何发生代谢转化提供了重要的数据基础。
为系统评价模型的预测能力,研究团队进一步建立了两个独立测试集。其中,Test Set 1采用已有的GLORYx基准数据集,以便与现有代谢预测方法进行直接比较;Test Set 2则从2019—2023年发表的文献中构建,包含来自32个母体分子的102条记录,用于进一步评价模型面对较新药物化学结构时的预测能力。通过化学空间分析,研究团队确认两个测试集均较好地分布于训练数据覆盖的化学空间范围内,为后续模型评价奠定基础(图1)。
2. 开发用于精准代谢物预测的对比学习框架Mettle
代谢物预测的核心挑战不仅是生成可能发生的代谢反应,更重要的是从大量结构相似、化学上合理但实际并不会形成的候选产物中准确识别真实代谢物。针对这一问题,研究团队开发了融合化学特征交互与对比学习的深度学习模型Mettle。
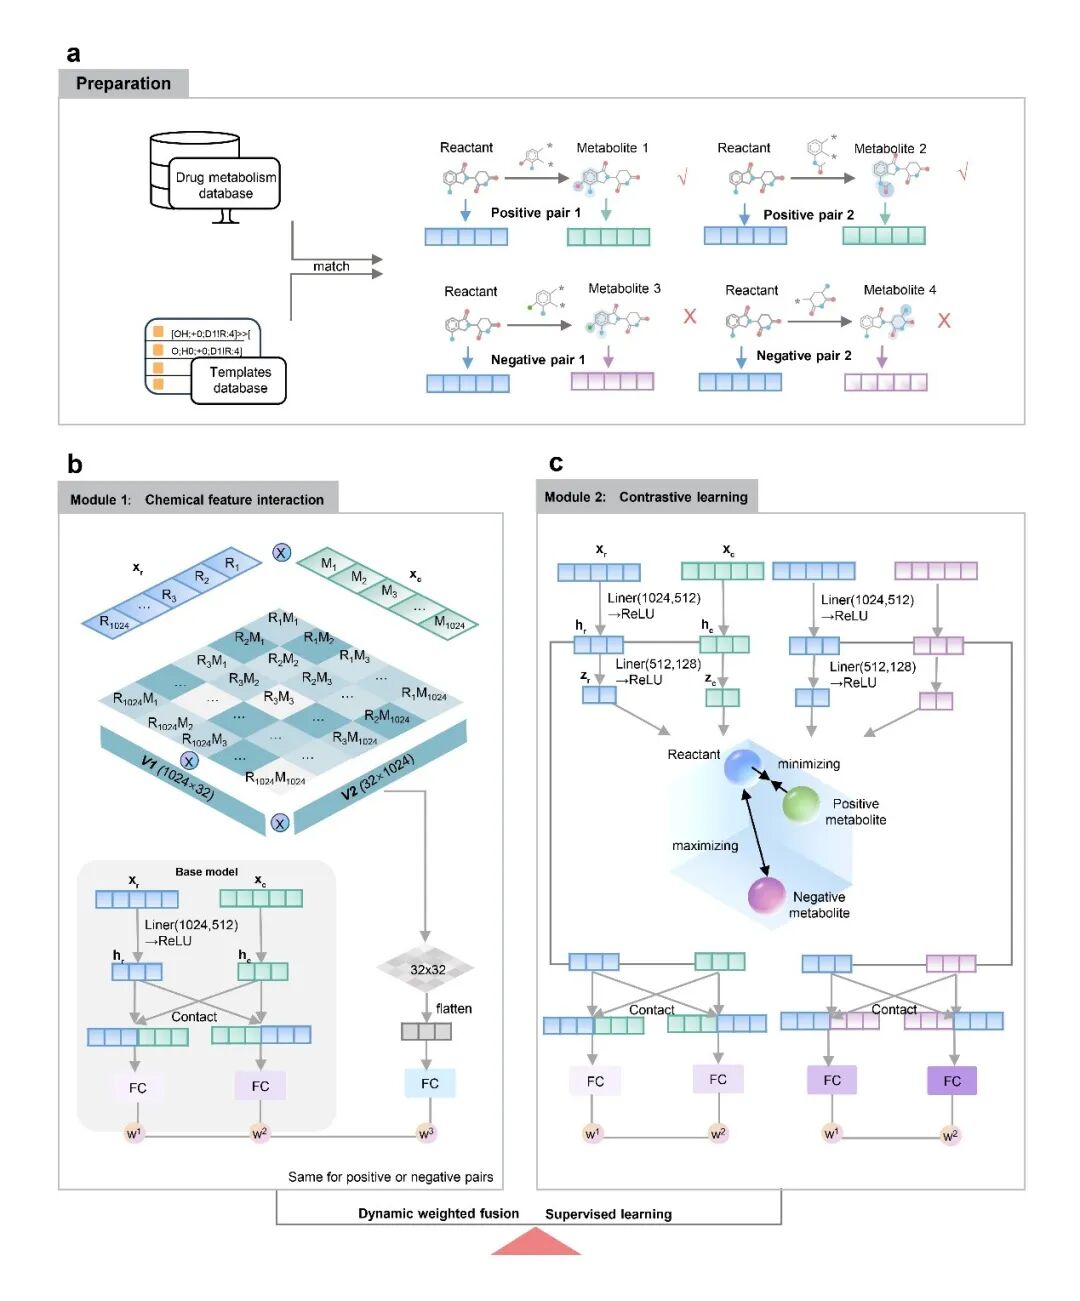
在训练过程中,研究团队首先利用整理后的代谢反应规则生成真实的“反应物—代谢物”阳性样本,同时通过将反应物与错误的反应模板进行匹配,在保证生成产物化学有效性的基础上构建大量具有挑战性的阴性样本。模型不仅需要学习“什么是真实代谢物”,还需要不断学习如何将真实代谢物与大量“结构相似但错误”的候选代谢物区分开来。
在模型架构上,Mettle采用双流网络设计。第一条信息流为化学特征交互模块,用于显式描述反应物与代谢物之间发生的结构变化;第二条信息流为对比学习模块,通过在特征空间中拉近真实“反应物—代谢物”对,同时推远错误候选对,提高模型识别真实代谢转化的能力。两类信息最终通过可学习的权重机制进行动态融合,从而实现对候选代谢物的概率预测和排序(图2)。
3. 模型性能验证与应用
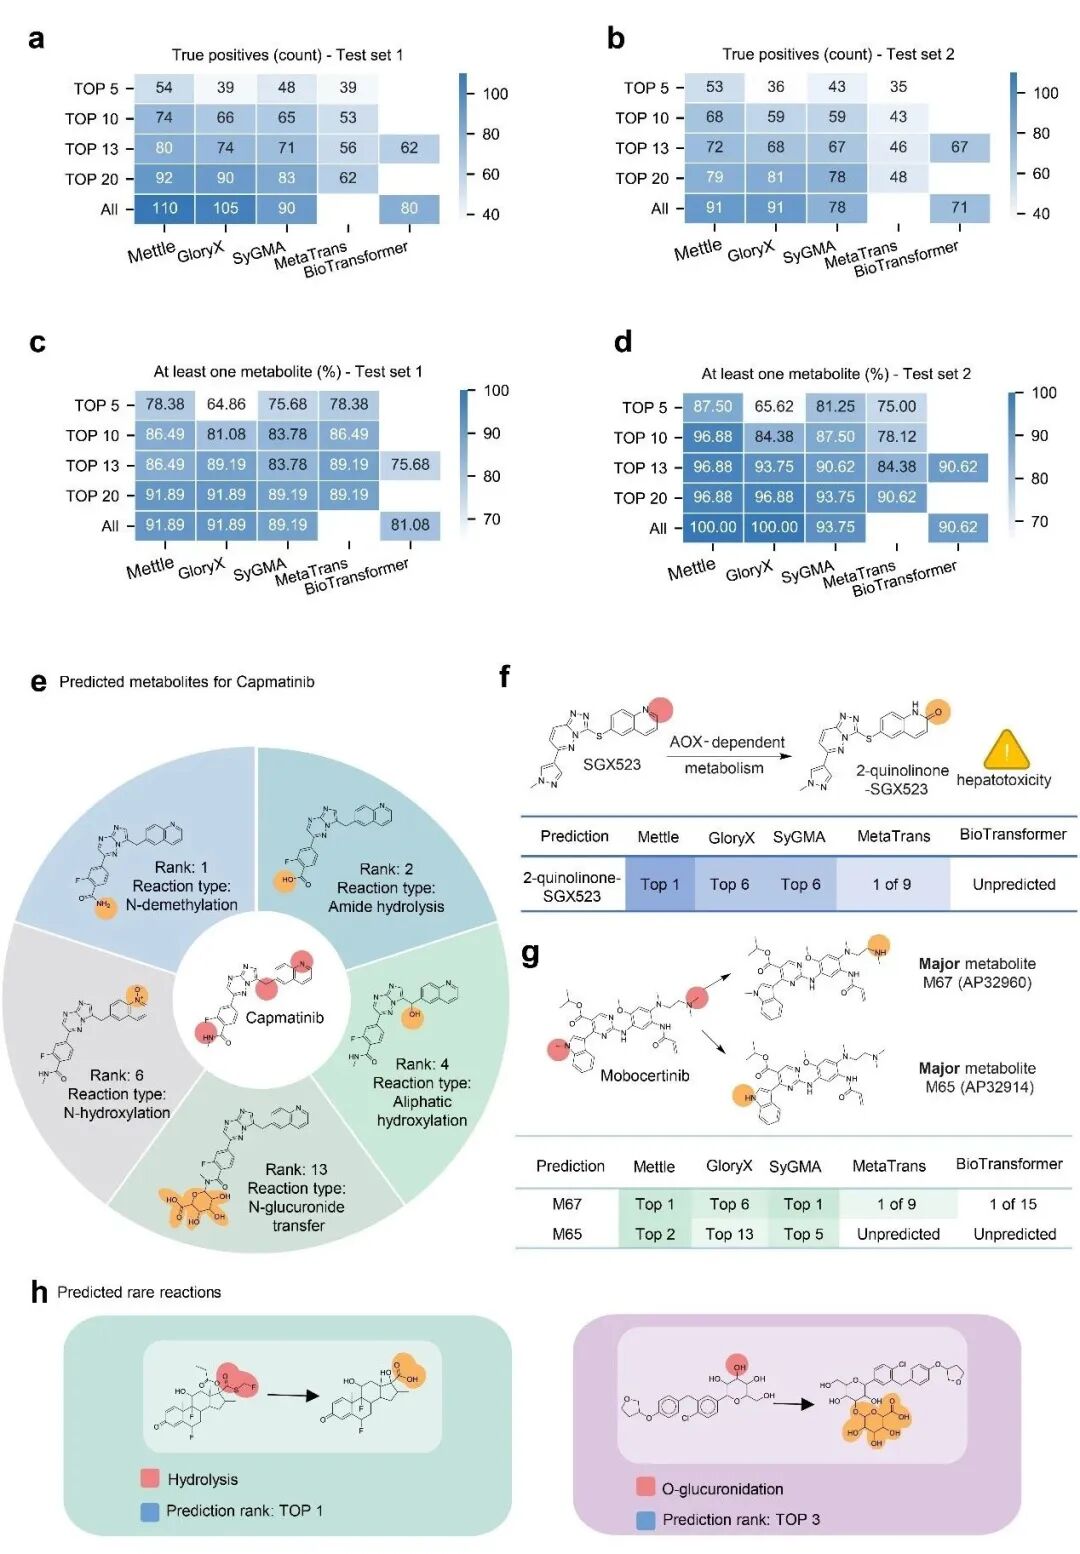
为严格评估Mettle性能,研究团队将其与GLORYx、BioTransformer、MetaTrans和SyGMa在测试集1和测试集2上进行对比。Mettle在识别真阳性代谢物方面均表现出显著优势,Top-5预测中比次优工具分别多识别出12.5%和23.3%的真阳性;在Top-5中至少识别出一种主要代谢物的准确率分别为78.38%和87.50%,Top-10准确率分别达86.49%和96.88%,远超现有方法(图3)。
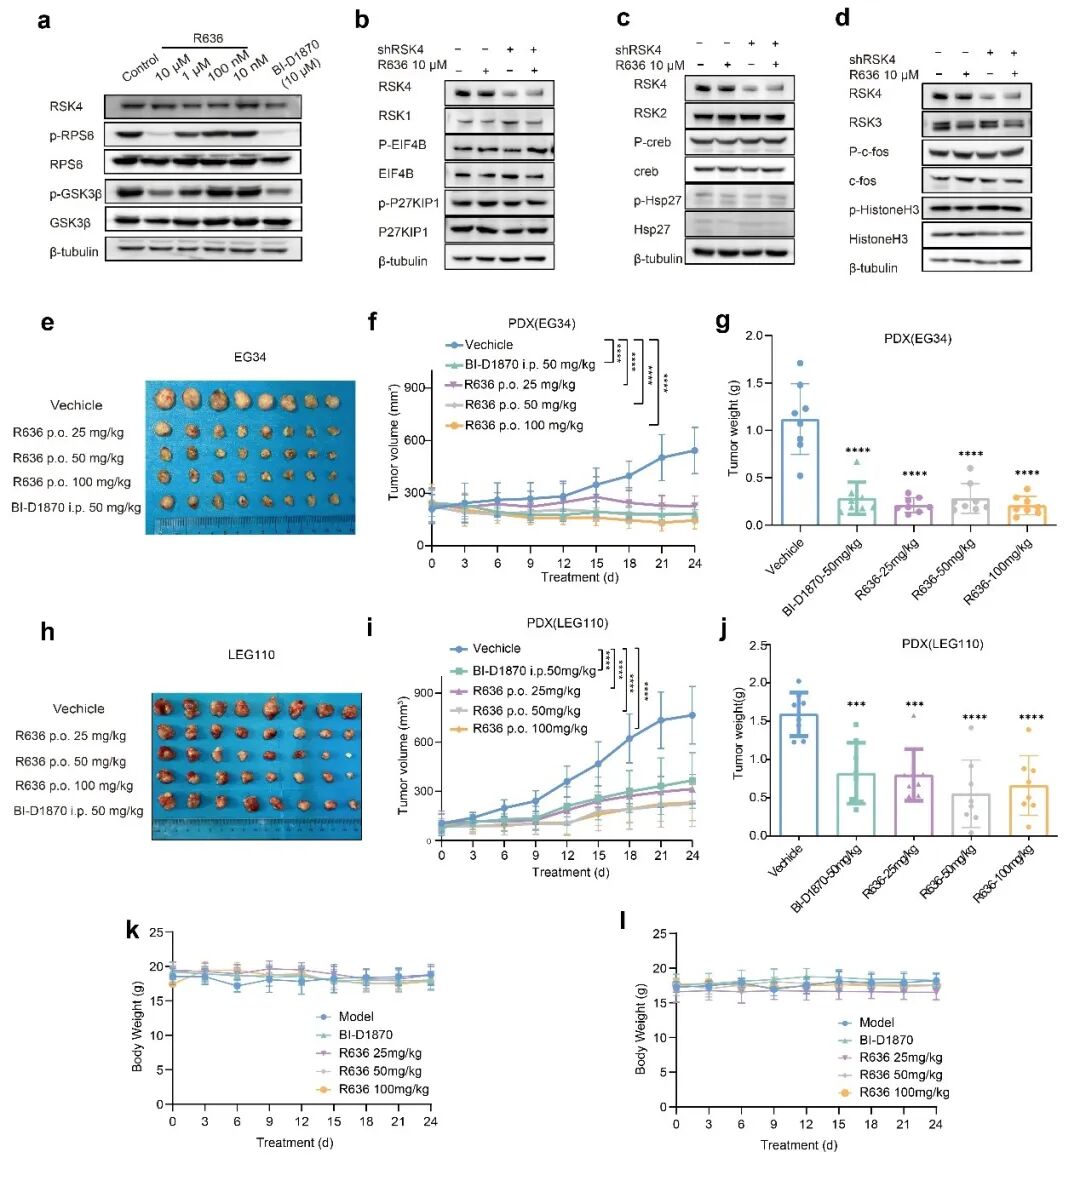
研究团队前期将RSK4鉴定为食管鳞癌(ESCC)的潜在治疗靶点,并获得高活性先导化合物14f,但其口服生物利用度极低(F = 0.99%),常规骨架跃迁获得的R632亦未能显著改善(F = 1.2%)。针对这一成药性瓶颈,团队利用Mettle开展代谢位点(SOM)预测,识别出二氟苯酚和环戊烷基团为主要代谢不稳定区域,并通过人肝S9代谢物鉴定实验验证了预测结果。在此基础上,团队建立了融合de novo分子生成与Mettle代谢预测的代谢感知设计策略,最终获得高活性化合物R636(IC50 = 13.75 nM),其通过吲唑替换代谢不稳定的二氟苯酚,并对环戊烷基团进行二氟取代,实现了活性与代谢稳定性的协同优化。大鼠药代动力学研究显示,R636口服生物利用度提高至63%,较14f提升约63倍。同时,在两种ESCC患者来源异种移植(PDX)模型中,R636口服给药均表现出显著且剂量依赖的抗肿瘤活性,验证了该代谢感知设计策略在提升候选药物成药性方面的有效性(图4)。
代谢性质优化一直是药物发现过程中最重要、也最具挑战性的环节之一。一个具有高靶点活性的化合物,如果存在严重的代谢不稳定性和较低的体内暴露,仍然难以发展成为真正具有临床潜力的候选药物。传统药物化学通常需要依靠大量经验和反复试错解决这一问题,而如何更加准确地识别代谢风险,并在分子设计阶段主动规避这些风险,是提高药物研发效率的重要方向。该研究将计算代谢预测从传统的被动风险评估进一步推进到前瞻性的理性药物设计,为利用人工智能解决候选化合物代谢稳定性瓶颈、减少药物化学反复试错并加速高质量候选药物发现提供了新的技术路径。
长按扫码可关注
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢