

2026年9月,哈佛医学院、牛津大学、哈佛大学等机构研究人员在《Cell》发表观点文章“World models for biomedicine”。文章提出,生物医学人工智能的下一步,不应只是在已有数据上完成分类、生成或单步预测,而应建立能够表征生物状态、接收可控干预、模拟未来状态,并从预测状态继续推演的“世界模型”。
这一设想对应生物医学研究中一个长期存在的矛盾:可实施的实验远少于可能的干预组合。基因、药物、剂量、时序、疾病阶段和个体背景共同构成庞大的实验空间,但现有知识只覆盖其中极小部分。人类参考相互作用组估计仅覆盖二元蛋白互作的2%—11%;ClinVar仅标注约7100万种可能人类基因组变异的0.1%;最大的组合扰动筛选也只测试了名义蛋白编码基因两两组合空间的2%;已获批药物作用于652个基因,不到估计可成药基因组的15%。世界模型试图把有限实验转化为可分支、可迭代的模拟空间,再把最有价值的候选送回真实实验。
生物医学世界模型的定义
生物医学世界模型是生成生物系统在不同动作下如何演化的概率分布,并能够从自身预测的状态继续模拟的AI系统。这里的“状态”可以是细胞、组织、胚胎、患者或实验系统在某一时点的综合表征;“观察”是转录组、影像、空间组学、蛋白组、波形、病历等可测量信号;“动作”则包括基因扰动、化合物处理、环境暴露、临床治疗和实验操作。
其关键并非一次性给出答案,而是建立动作条件下的状态转移:从当前状态出发,比较不同干预的未来分布;也可以从目标状态反向搜索干预;在多步任务中,还要将预测状态重新作为下一轮推演的起点。因此,模拟、干预设计和序列规划构成三类核心能力。
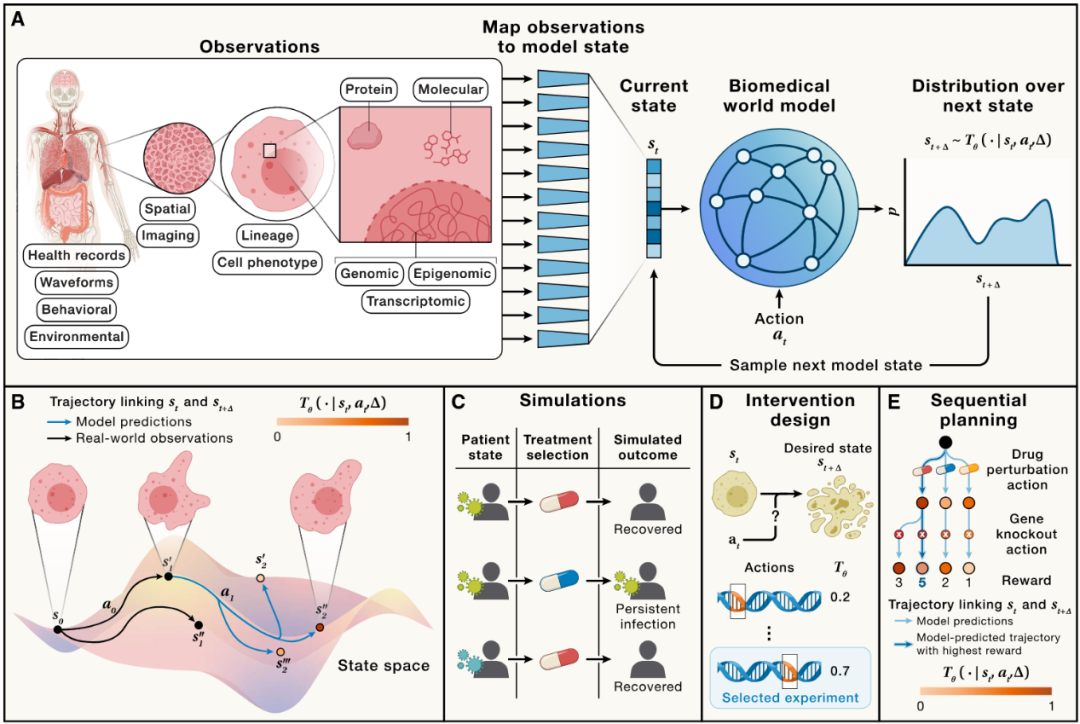
图1|生物医学世界模型模拟动作条件下的生物轨迹
虚拟细胞、虚拟胚胎与虚拟患者
虚拟细胞是当前最接近这一目标的方向之一。GEARS、CellFlow、STATE、TxPert、STACK、X-Cell和MORPH等模型利用单细胞RNA测序或Perturb-seq图谱,预测特定扰动对细胞群体转录状态的影响。但现阶段的泛化仍不稳定:在训练数据覆盖不足的细胞背景中,复杂模型常被简单线性基线超越。原因不仅是样本量有限,还包括扰动效应高度依赖细胞类型、剂量、时长和实验条件,而蛋白丰度、定位、表观遗传、信号通路、形态和细胞间相互作用又常未被同时观察。
虚拟胚胎需要连接发育过程中的转录、形态、空间结构和谱系信息。现有发育图谱覆盖多个阶段,却大多来自破坏性测量:不同时间点观测的是不同细胞,无法直接确认同一细胞如何分化、分裂或死亡。拟时序、RNA velocity、向量场和最优传输可重建部分动态,但结果依赖建模假设;只凭转录状态也不足以唯一确定真实发育祖先关系。
虚拟患者拥有最长的时间跨度,也面临最强的混杂。电子健康记录记录了真实诊疗轨迹,却只覆盖临床流程中被选择性测量的变量;治疗并非随机分配,疾病严重程度、合并症、资源可及性和医生判断都会同时影响治疗选择与结局。模型因此可能学到“医疗如何被提供”,而不是“患者在某项干预下将如何变化”。
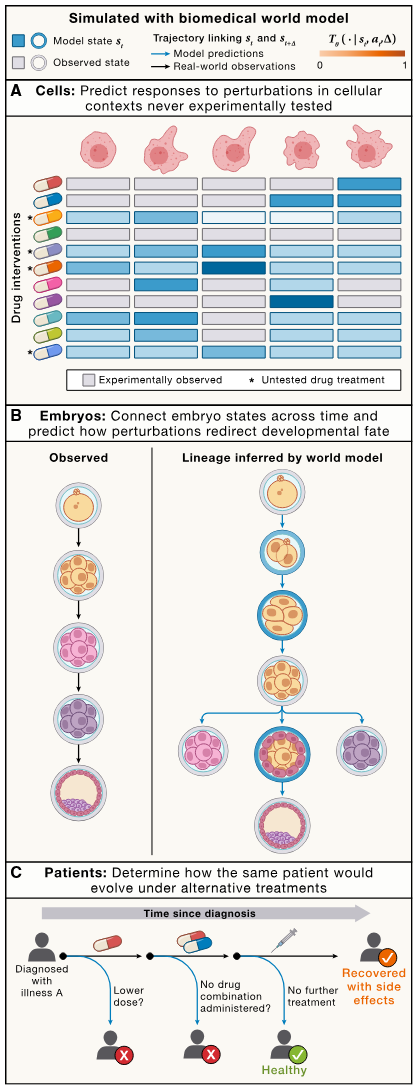
图2|细胞、胚胎和患者三个尺度上的动作条件推理
生物医学世界模型所需的数据
训练世界模型需要同时知道系统处于什么状态、施加了什么干预、随后发生了什么变化,以及这一转移发生于何种背景。现有数据源各自只提供其中一部分:观察性数据覆盖状态更广,却难以建立干预因果;扰动实验提供较强因果证据,却只覆盖少量状态和动作;纵向记录连接了时间,却可能观测稀疏、动作混杂;高维终点检测信息丰富,却常以破坏样本为代价。
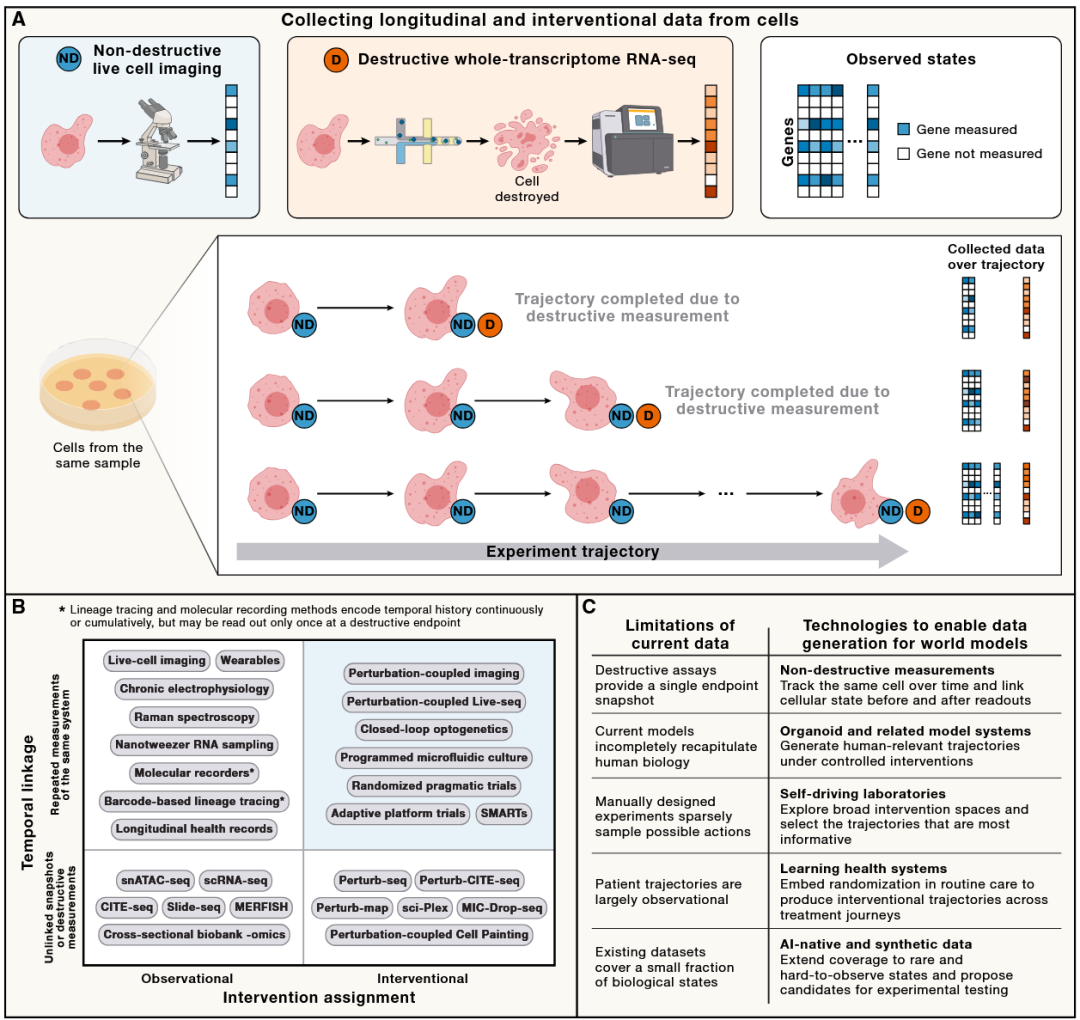
图3|生物医学世界模型的数据基础
模型训练与动作泛化
文章并未把世界模型限定为单一架构。可行路线包括:利用基础模型初始化多模态状态编码器,再以扰动和纵向数据学习动态;使用模块化架构分别表示状态、动作和转移;把反应网络、守恒约束、解剖结构或药代动力学嵌入学习系统;通过不确定性建模保留同一观测对应多个潜在真实状态的可能性。核心要求是预测充分性,即模型状态应保留所有与未来结果有关的信息,而不是只追求对当前样本的重建。
训练数据也不能简单混合。观察性数据适合学习状态空间与自然演化,随机或受控实验用于识别干预效应,纵向与重复测量用于连接时间。对未观测动作的预测,还需要能够利用化学结构、序列、靶点、剂量和暴露方案等信息形成可泛化的动作表示。若模型只记住扰动标签,而没有学到动作结构,面对新分子、新组合或新机制时就难以外推。
世界模型的评估
世界模型首先要通过严格的分布外测试:把新状态、新动作、新“状态×动作”组合,以及新的多步序列分别留出,而不是随机拆分高度相似的样本。其次,应与控制组、平均效应、加性/线性模型、最近邻和插值等强基线比较。当前扰动预测模型经常无法稳定超过这些简单方法,说明模型复杂度本身不能替代可验证的动态学习。
一步预测仍不足以证明模型能长期模拟。自由运行时,微小误差会逐步累积,造成状态漂移、多样性坍缩或违反生物约束。评估因此需要覆盖更长时间和更多干预步骤,并检验时间可组合性:直接预测48小时后的状态,应与两次连续24小时转移得到的分布相容。不同模态与尺度也应保持一致,例如由转录组和影像初始化的预测不能导向互相矛盾的细胞组成。
最终评估标准是模型是否改善干预和实验选择。预测误差较小不一定带来更好的决策:决策阈值附近的误差可能改变候选排序,而不影响选择的大误差可能没有实际后果。世界模型规划可与单步预测、贪心或贝叶斯优化、无模型强化学习和专家启发式方法在相同目标与实验预算下比较,并以命中率、富集度、信息增益、遗憾值以及安全和可行性违反衡量。
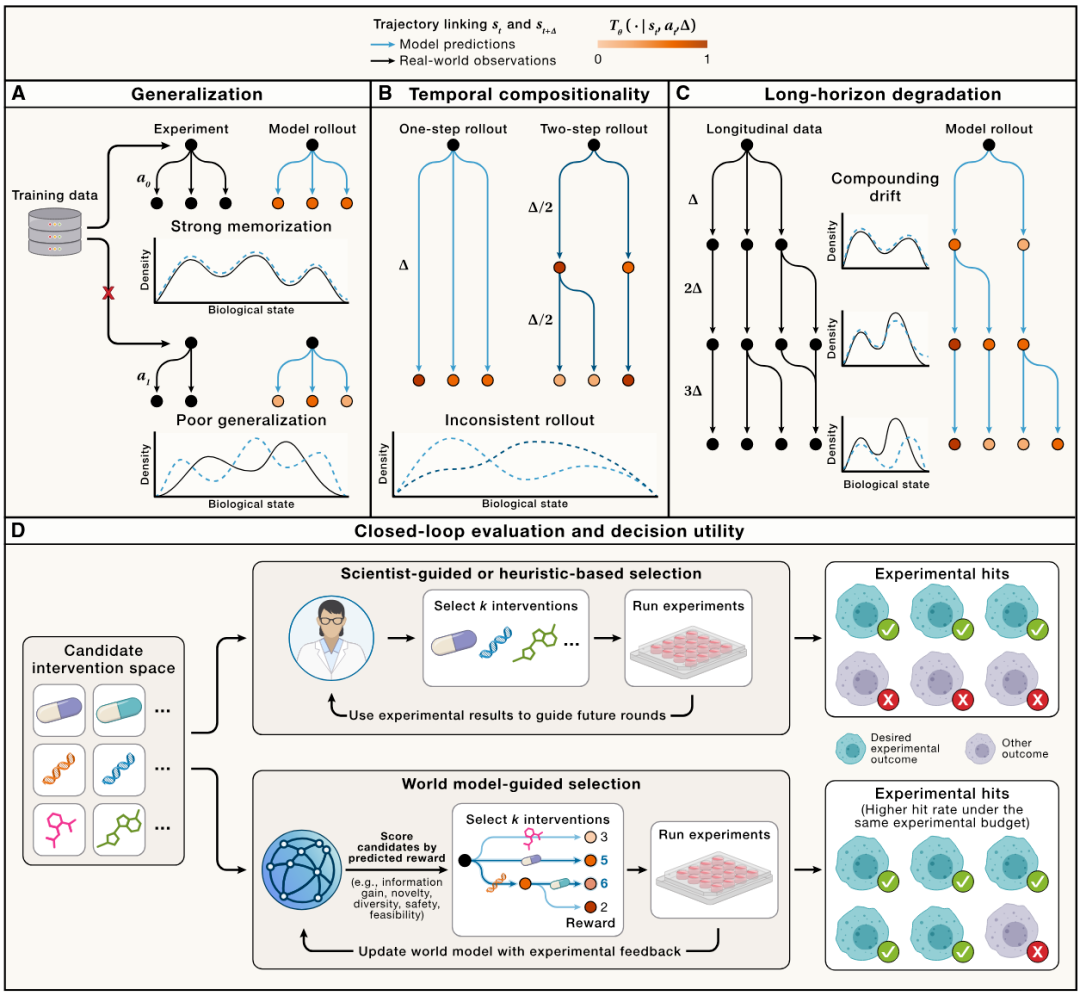
图4|生物医学世界模型的评估框架
研究模式:模拟、逆向设计与序列规划
第一类是反事实模拟。给定干预,观察系统如何变化。虚拟胚胎可模拟遗传扰动如何改变细胞命运轨迹,组织模型可追踪损伤后系统走向再生、纤维化或慢性损伤的过程,空间模型可研究衰老或年轻化干预如何改变邻近细胞和组织结构。
第二类是逆向干预设计。给定目标状态,搜索最可能实现目标的基因扰动、转录因子组合、药物、剂量或联合方案。它可缩小数百万种组合构成的实验空间,但也容易利用模型漏洞,即优化器可能偏爱模型误判为有效的动作。因此,生物学、安全性和分布外不确定性必须成为显式约束。
第三类是序列规划。细胞重编程取决于因子加入的顺序和时间,肿瘤治疗也会因前序用药改变细胞群体构成和耐药性。若每个决策点有K种干预、共H个决策步,穷举空间按K的H次方增长。实际系统需要用树搜索、价值函数、分层规划和滚动时域控制缩小搜索:先模拟若干步,只执行一步,测量真实新状态后重新规划,以限制长程误差累积。
总结
生物学已经积累了大量状态和过程记录,而更大的潜在干预空间仍未被探索。建立生物医学世界模型,需要能够产生分子、细胞和组织纵向测量的实验平台,需要覆盖相关背景的干预数据,也需要整合长时间历史和多模态观察的模型。生物医学数据仍将是不完整且异质的,模型必须跨批次效应、不同细胞系、实验室方案、人群差异以及其他生物和技术变化实现泛化。
评估同样需要大规模协作。基准测试应使用未泄漏到训练数据中的真实信息,多轮实验应在计算模拟与模型规划、真实实验检验之间反复迭代。此类工作往往超出单个学术或产业实验室的能力,需要学术实验室、公益资助方、制药企业和人工智能企业共同开发、评估和使用世界模型。
世界模型可用于靶点发现、细胞重编程和治疗规划,也可生成训练其他人工智能模型的合成数据,为专用模型提供初始表征,并为人工智能科研智能体提供闭环环境。其作用不是替代实验,而是在更大的状态和干预空间中进行模拟、筛选和规划,再通过真实实验检验预测并更新模型。
参考链接:
https://doi.org/10.1016/j.cell.2026.08.032
--------- End ---------
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢