

随着深度学习研究的迅速普及,基础模型(foundation models)受到了广泛关注。基础模型之所以成为研究的重点,主要归功于其在零样本(zero-shot)和少样本(few-shot)任务中的出色表现。例如,像 CLIP 这样的图像标注模型能够在零样本情况下将分布外(out-of-distribution)图像与分布外标签进行匹配;而针对目标检测训练的模型,也能以极低的成本适配用于执行图像分割任务。这种惊人的迁移与泛化能力,不仅解释了为何它们在从机器人技术到医疗保健等广泛领域内备受青睐,也构成了 AI 智能体(AI agents)的基石。然而,并非所有的迁移效果都相同,归纳偏置(inductive biases)依然在很大程度上影响着基础模型的性能表现。因此,尽管基础模型已取得显著成功,但如何以及何时使用这些模型,仍是一个亟待解决的课题。本论文旨在应对实验室在应用视觉与语言基础模型时所面临的挑战。过去,模型选择往往依赖于反复试验(trial and error);而本论文则试图通过刻画基础模型的行为特征与训练机制,阐明理解其在下游任务中运作方式的正确路径。
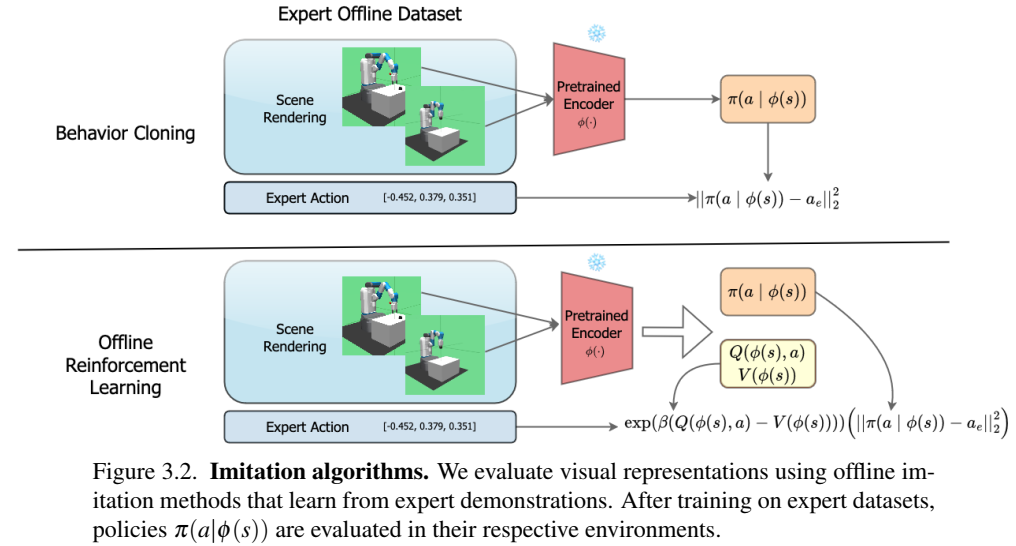
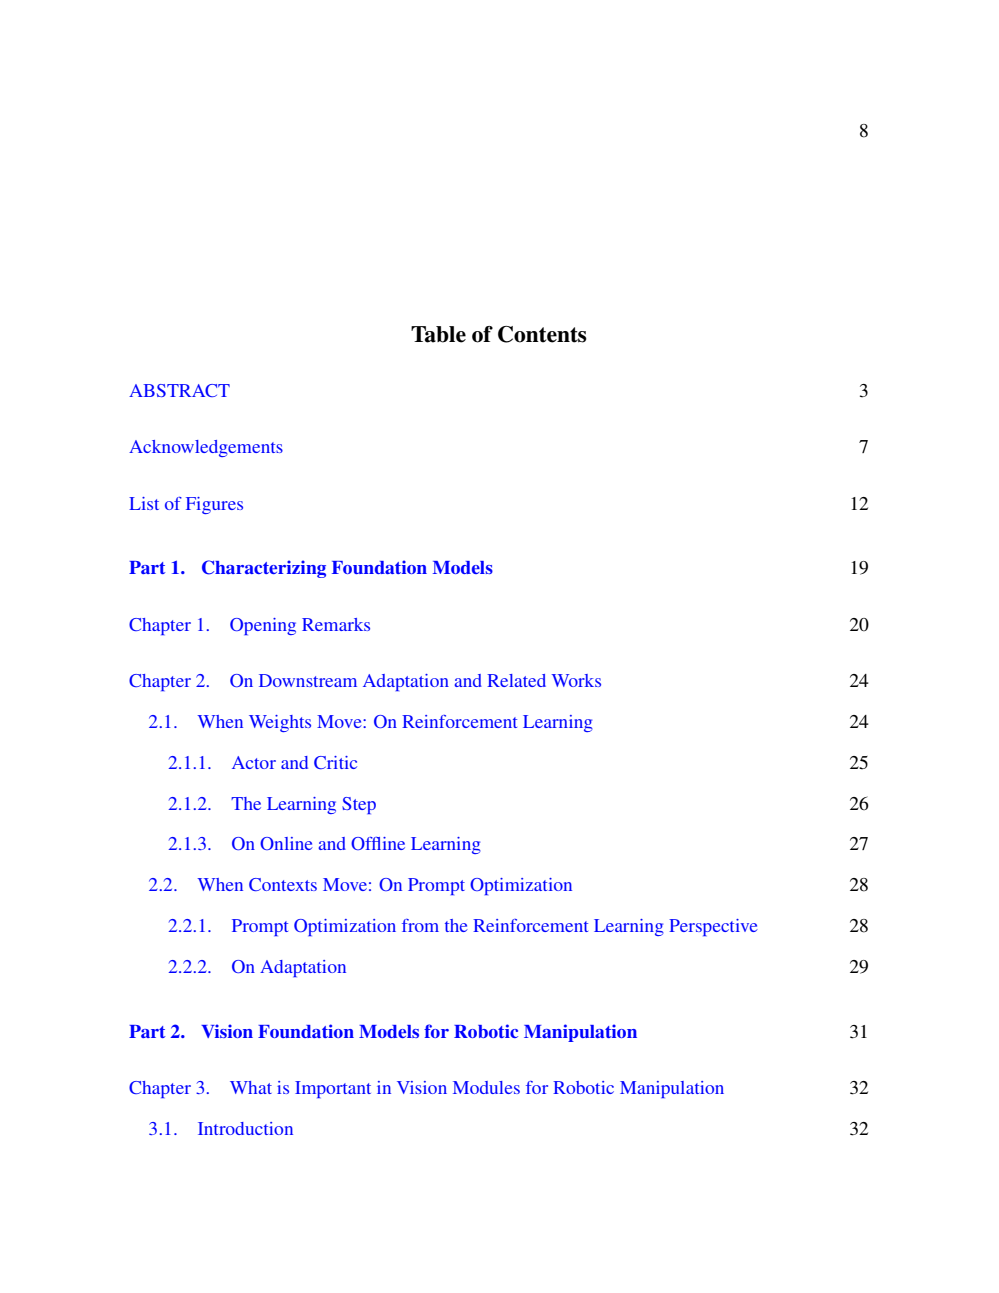
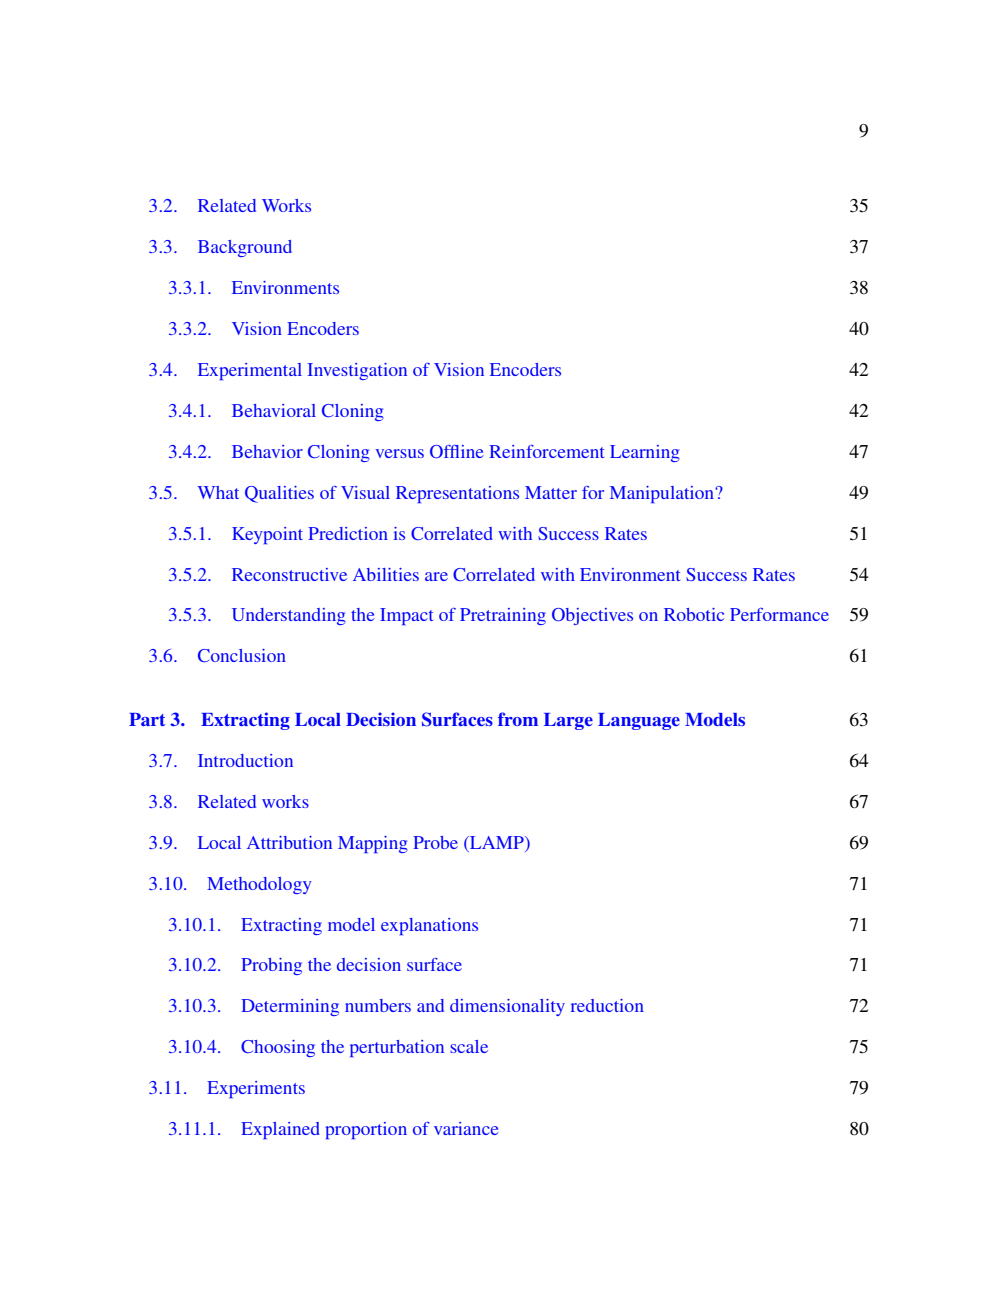
我们研究的首要问题源于利用状态空间的图像表征进行机器人控制的场景。尽管已有大量关于联合训练感知模块与控制模块的研究,但越来越多的应用开始受益于利用预训练的基础模型(foundation models)来预初始化感知模块。归纳偏置(inductive biases)能够有效降低训练在时间、算力和数据方面的成本。然而,目前尚不清楚哪些归纳偏置对视觉机器人控制真正有效。我们发现,具备关键点预测和重构归纳偏置的基础模型在机器人任务中表现最佳。随着新型基础模型的不断涌现,这些相关性可作为一种评估手段,用于判断模型在机器人任务中的有效性。此外,我们还发现,相比于基于自编码(auto-encoding)目标训练的模型,基于判别式(discriminative)目标训练的基础模型更适合用于机器人控制。
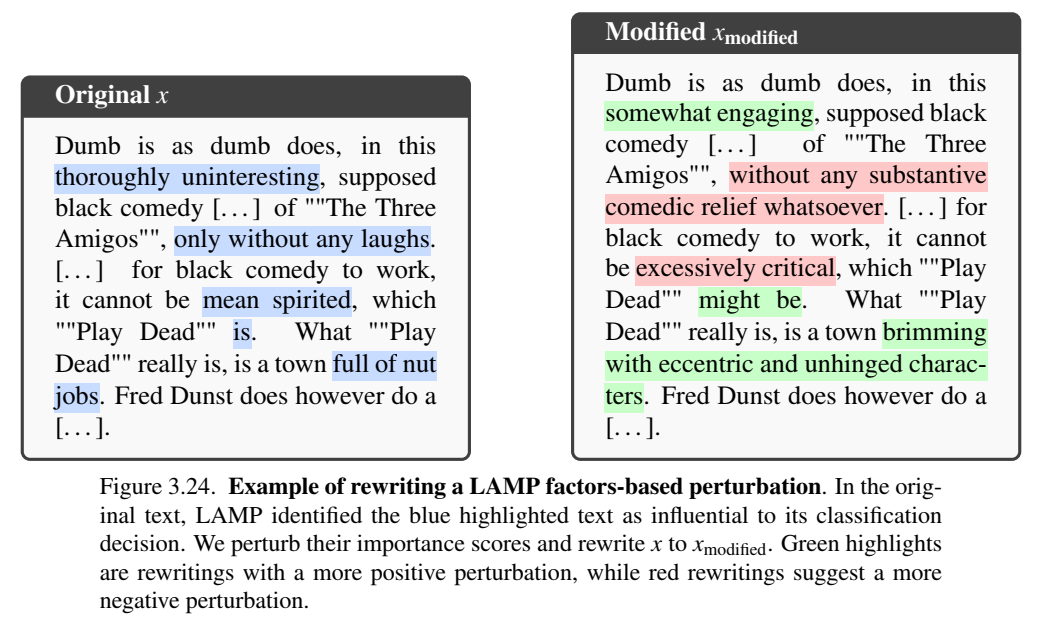
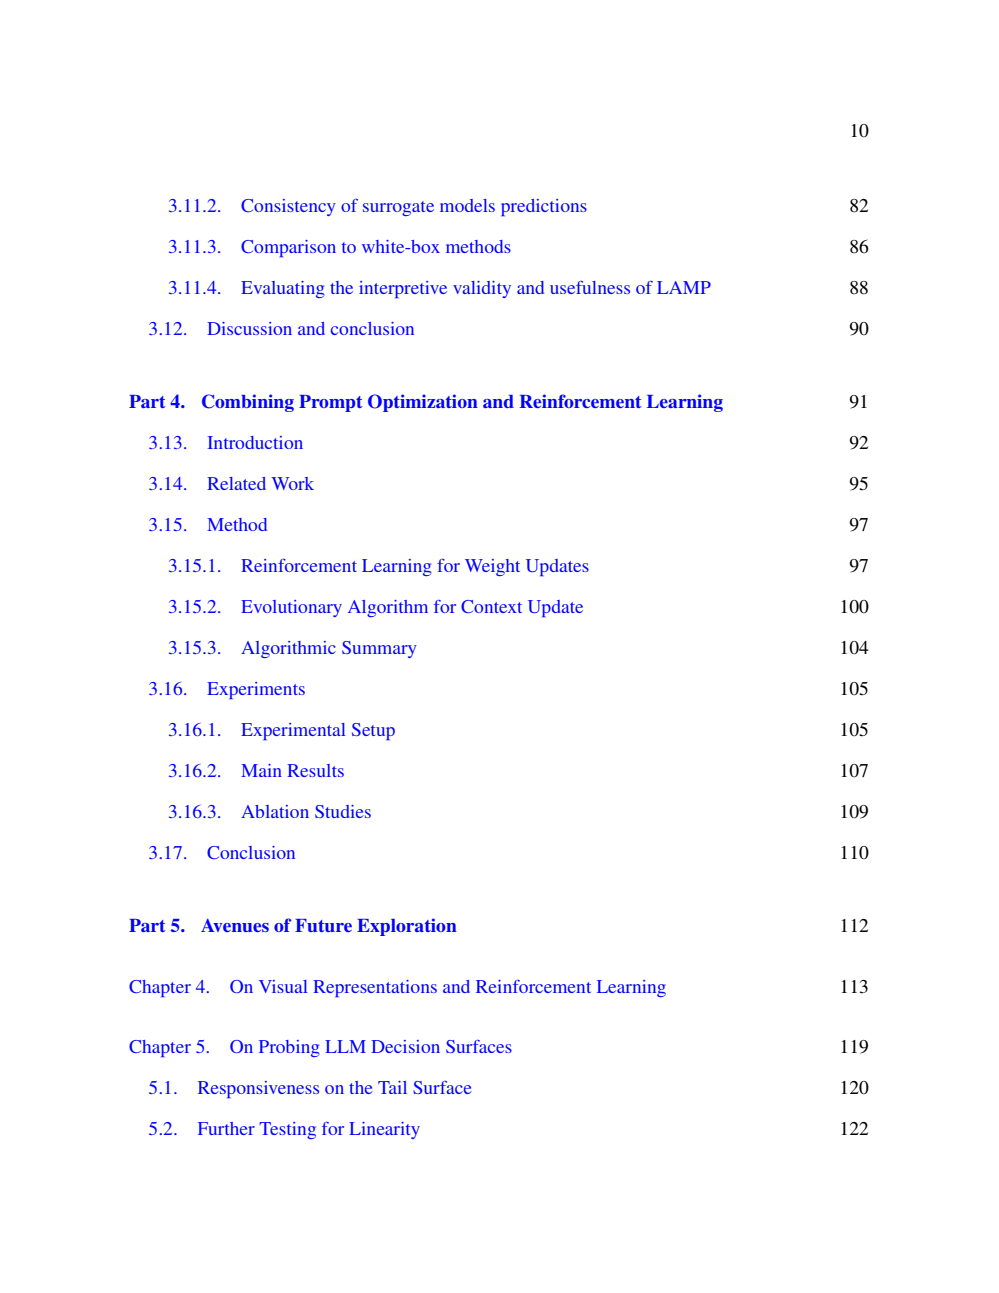
我们要探讨的第二个问题是:如何通过探测语言模型来理解其做出决策的方式。尽管语言模型已被用于解释自身的决策,但如何判断这些“自我解释”是否可信,仍是一个悬而未决的难题。如果尚无法确定语言模型的内部运作机制是否与其自述的行为相一致,那么下一个关键问题或许在于:语言模型的实际响应是否至少在表象上与其自述的解释相符。换言之,我们着重探讨的是“自洽性”问题。研究发现,语言模型确实表现出一定程度的自洽性;我们可以利用其自述的解释来评估用户是否应当信任模型的输出。此外,我们还提出了一种线性模型,能够针对语言模型自身的自述解释,对其响应曲面进行近似拟合。
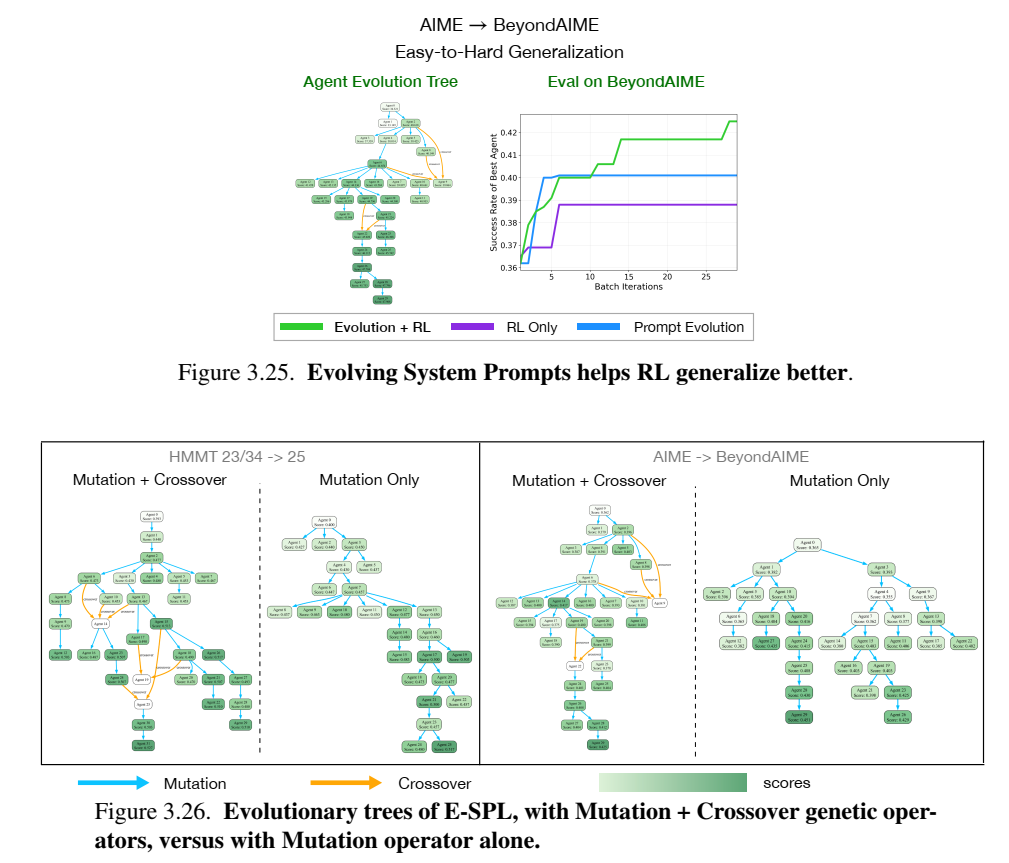
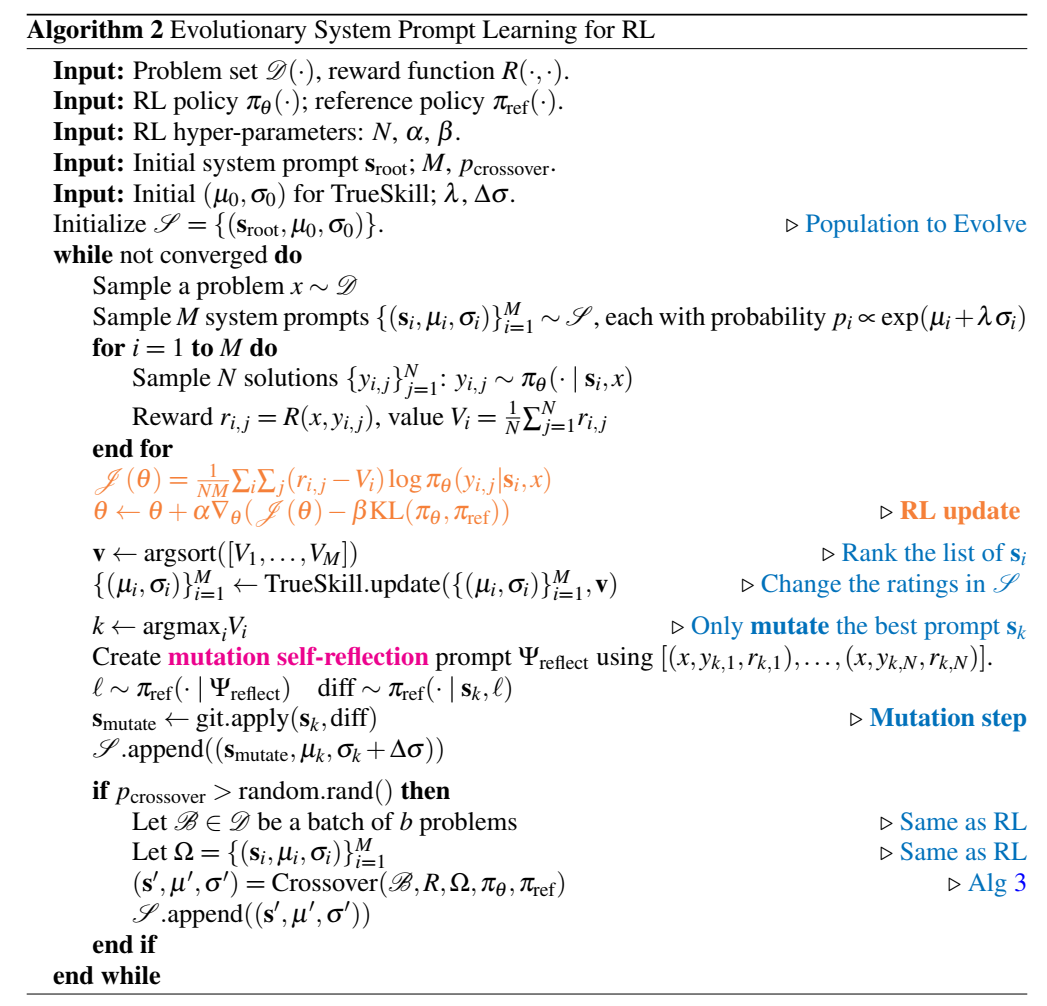
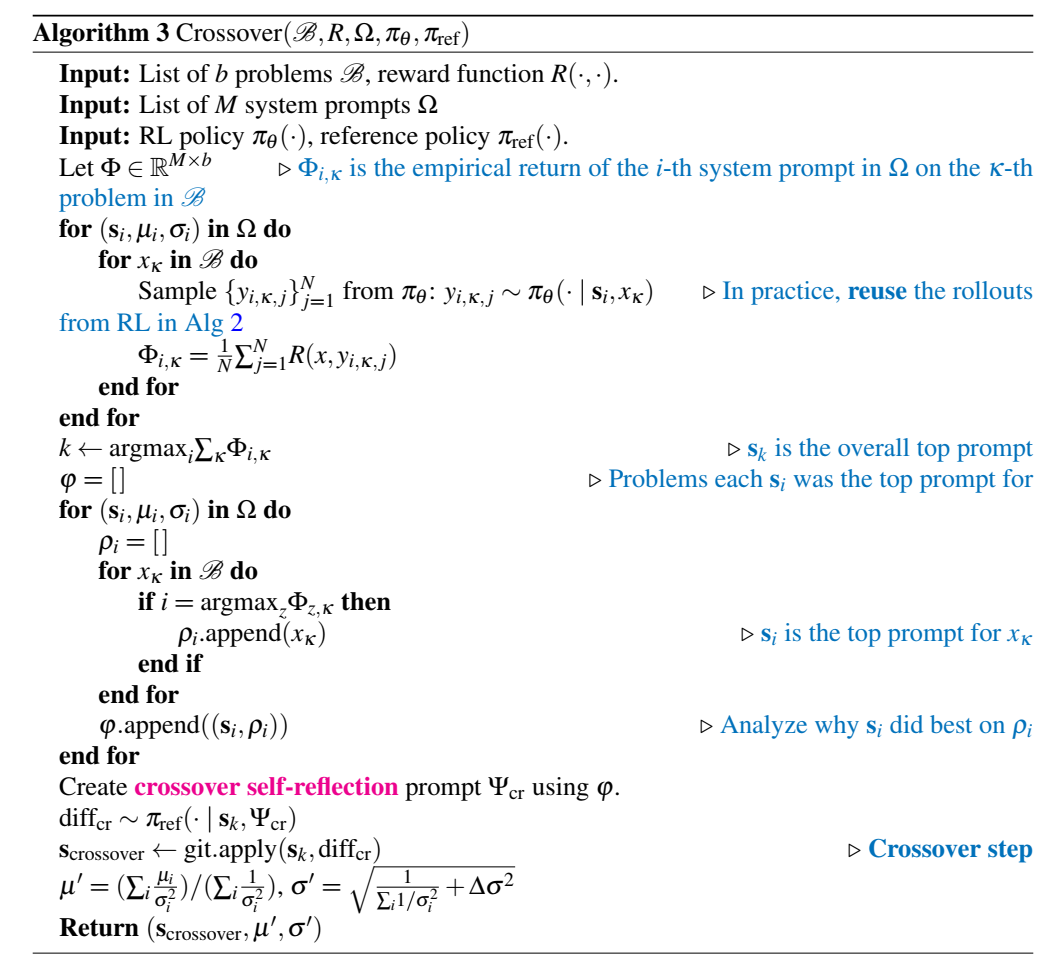
在第一个问题中,我们拥有模型权重,并可随心所欲地操控模型。在第二个问题中,模型权重被忽略,模型被视为一个“黑盒”,无法获取其激活值、梯度或 Logits。我们探讨的最后一个问题放宽了前两个问题的限制条件;在允许同时更新权重和修改提示词(prompt)的情况下,我们利用提示词工程与模型权重微调相结合的方式,来提升模型在下游任务中的性能。
综合来看,这些问题指向一个核心议题:基础模型在不同的适应机制下表现如何?我们又该如何系统地刻画这些行为?我们不侧重于探究内部机制,而是考察在具备不同干预手段时,模型的可观测性能会发生怎样的变化。在视觉-电机控制任务中,我们针对支持表征与参数层面适应的场景进行了研究,结果表明预训练视觉模型的归纳偏置会对下游微调性能产生实质性影响。在访问受限的语言建模场景下,当仅能进行上下文适应时,我们利用“自我解释”来近似刻画局部的决策结构。最后,在能够联合优化上下文修改与程序化学习的场景中,我们发现结合这两种适应模式所带来的迁移效果,优于单独优化其中任一维度的效果。跨领域的研究表明,适应机制的可行性从根本上决定了模型的下游性能。
本论文将模型选择与评估建立在行为特征分析而非单纯的试错实验之上,从而提出了一种更具原则性的基础模型应用方法。研究表明,无论是在视觉还是语言领域,系统地考察模型如何响应结构、上下文及干预措施,都能揭示其性能表现与局限性中存在的可靠规律。这一视角无需获取模型内部激活状态或寻求完整的机制性解释,而是将模型行为本身视为具有研究价值的对象。由此,本研究构建了一个实用框架,有助于理解基础模型在何种情况下能够实现稳健泛化,以及在何种现实应用场景下其假设与归纳偏置可能失效。
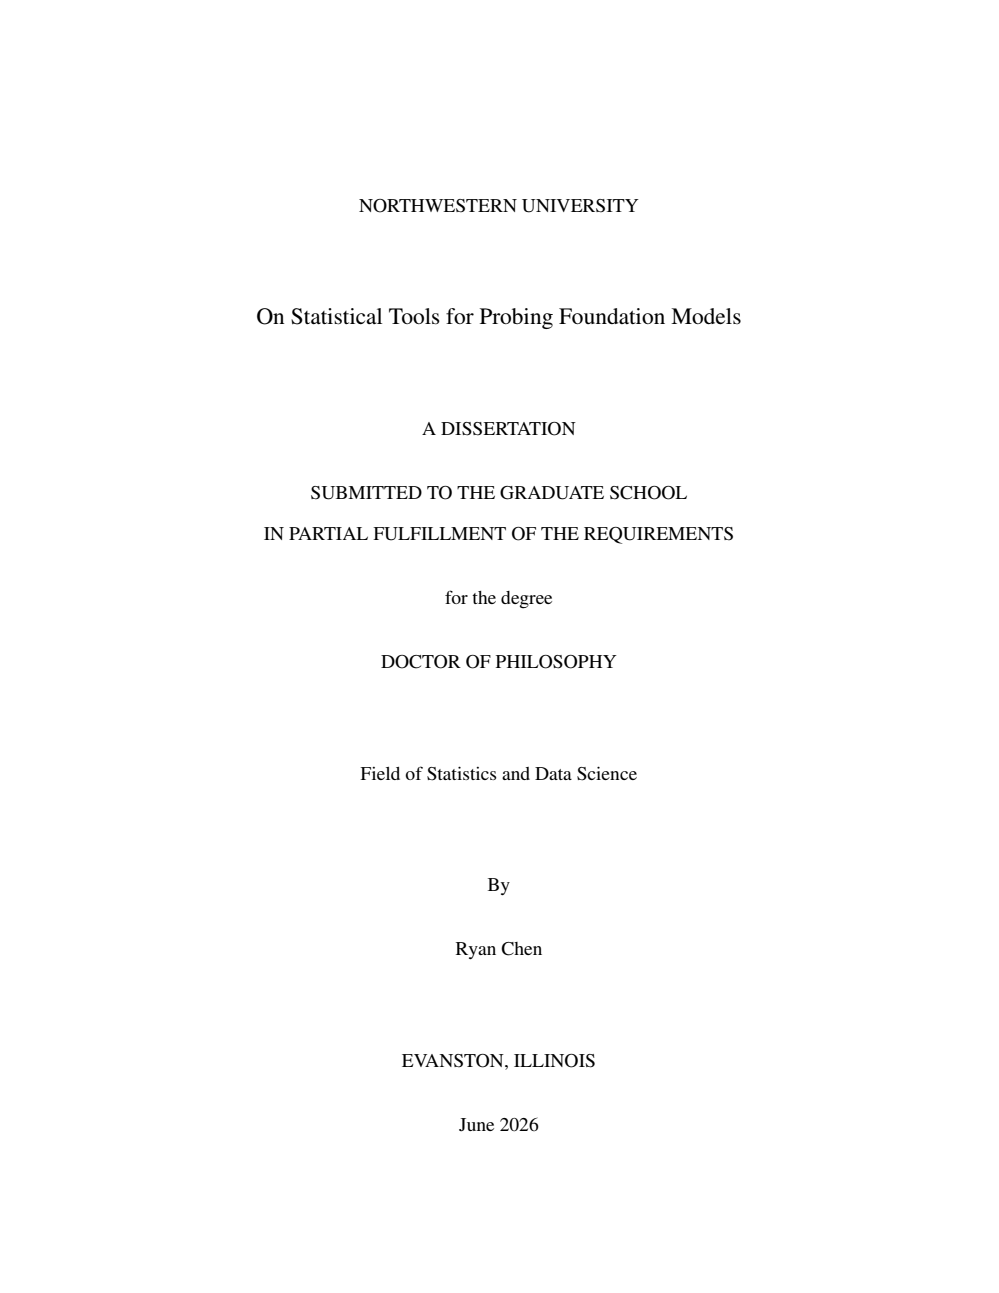
论文题目:On Statistical Tools for Probing Foundation Models
作者:Ryan Chen
类型:2026年博士论文
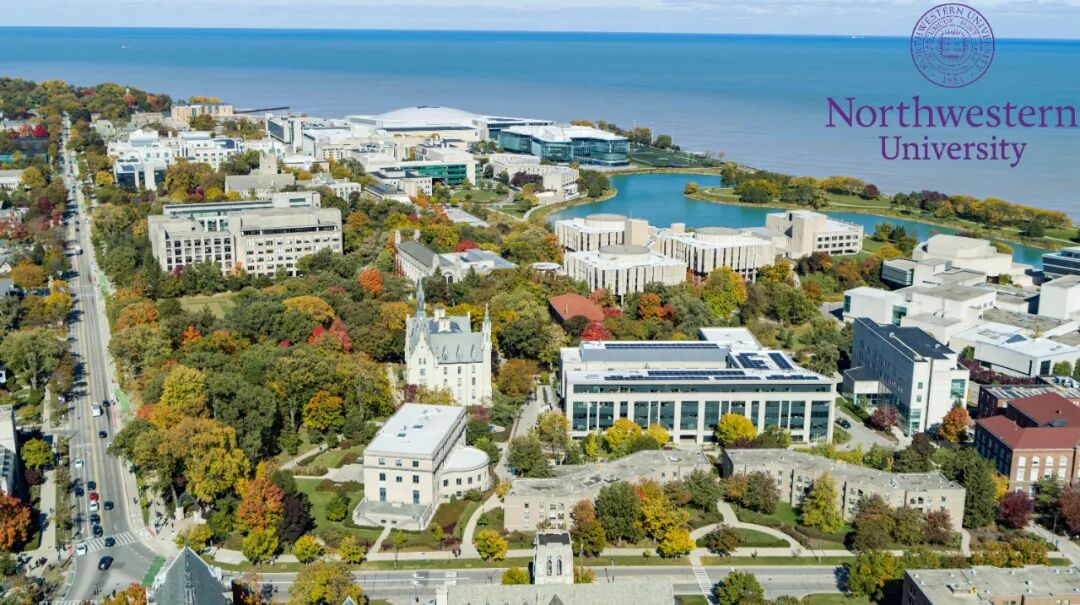
学校:Northwestern University(美国西北大学)
请索引第154篇博士论文
 |  |

内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢