

2026年9月21日,Microsoft Research AI for Science牵头,诺华、葛兰素史克、剑桥大学、雅盖隆大学和伍珀塔尔大学的研究团队在《Nature》发布论文预览版本,题为“Chemist-aligned retrosynthesis by ensembling diverse inductive bias models”。论文提出逆合成模型RetroChimera,将图神经网络编辑模型NeuralLoc与生成模型R-SMILES 2通过学习排序进行集成,并在公共反应数据、Novartis与GSK内部数据、化学家盲评和多步路线搜索中检验模型表现。
RetroChimera代码仓库:
https://github.com/microsoft/retrochimera
背景
小分子药物、材料和精细化学品的发现与生产都依赖化学合成。逆合成规划从目标分子出发,预测可以生成该分子的反应物和化学转化,再通过搜索算法把单步反应串联成多步路线,直到目标分子被拆解为可获得的起始原料。多步规划中的错误会逐步累积,因此模型不仅需要在常见反应上保持较高准确率,还要能够识别样本较少但具有策略价值的反应,并避免生成化学上不成立的结果。
现有机器学习逆合成模型主要存在两类建模方式。基于反应模板或分子编辑的方法,只改变与反应相关的局部结构,预测通常更接近训练数据,但对训练中少见或没有出现的反应覆盖有限。从头生成模型直接生成完整反应物结构,面对训练分布之外的分子时更灵活,却更容易出现结构复制错误和反应幻觉。此前方法往往只沿其中一条路线改进,仍难同时兼顾常见反应、罕见反应、分布外泛化和化学家认可度。
方法
RetroChimera由两个独立训练的子模型组成。NeuralLoc以分子编辑为核心,利用数据中提取的反应模板定位需要改变的化学键和基团;R-SMILES 2采用Transformer结构,从头生成反应物。编辑模型受到已知反应规则约束,生成模型则具有更大的输出空间。研究团队希望利用两者不同的归纳偏置,让一个模型补充另一个模型容易遗漏的反应类型。
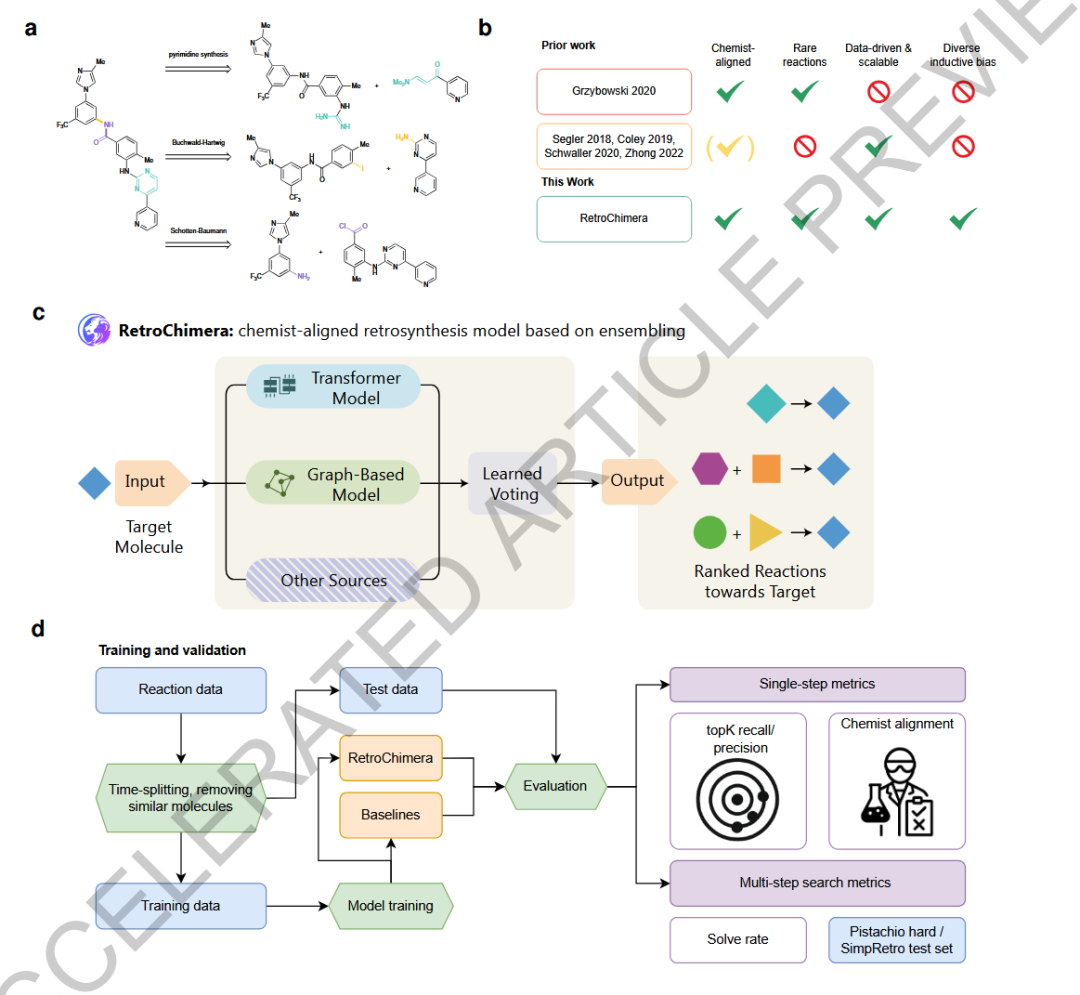
图1|RetroChimera的整体框架、训练策略和评估任务
传统模板分类器通常把每个反应模板对应的权重视为独立参数,难以在结构相似的模板之间迁移知识。此外,同一个模板可能在目标分子的多个位置匹配,直接应用后会产生多个候选反应物,而普通模板模型无法有效区分这些结果。NeuralLoc分别使用图神经网络编码产物和反应模板。模型先根据产物整体表示与模板表示选择高分模板,再计算产物原子与模板原子之间的匹配概率,判断模板应当应用在什么位置。模板分类分数与位点定位分数随后合并,用于重新排列所有候选反应物。这样,模型既学习采用哪一种反应规则,也学习把规则用在分子的哪个位置。
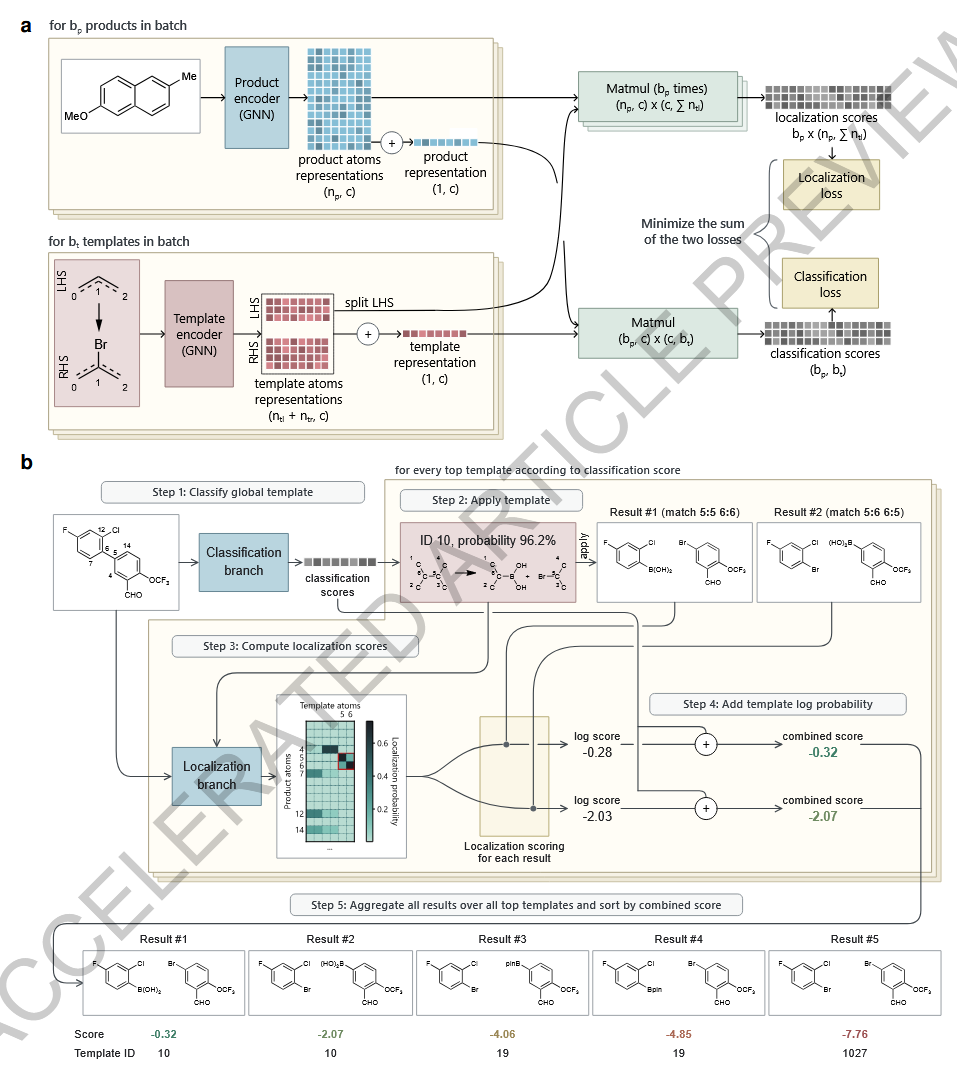
图2|NeuralLoc的模板分类、反应位点定位和候选结果排序流程
R-SMILES 2建立在序列到序列的Transformer框架上,并采用root-aligned SMILES。一个分子可以从不同原子开始遍历,因此同一结构能够写成多种化学等价但字符串顺序不同的SMILES。研究利用原子映射,让产物和反应物尽量从相互对应的原子开始书写,使反应前后没有变化的结构片段在字符串中的位置更加接近。这个处理不改变分子和反应,只调整SMILES的书写顺序,使模型把学习重点放在真正变化的化学键和基团上。在模型结构上,研究加入分组查询注意力、RMSNorm预归一化和SwiGLU前馈层,并调整束搜索的终止条件,以提高预测准确率和推理效率。由于NeuralLoc的计算成本较低,RetroChimera整体推理成本与单个从头生成模型大致相当。
两个子模型分别输出排序后的候选反应物集合。RetroChimera为每个模型在不同预测名次上的结果学习一个投票权重;如果两个模型提出相同反应,该反应的得分会累加。集成权重在验证集上优化,目标是让真实反应尽可能靠前。权重会随候选名次变化,因此系统不是简单地固定偏向某个模型,而是根据两个模型在不同排名位置上的可靠性合并结果。
结果
公共数据上的单步预测
研究首先在USPTO-50K和USPTO-FULL数据集上测试模型,以top-k准确率衡量数据集记录的真实反应物是否出现在前k个候选中。NeuralLoc和R-SMILES 2在各自模型类型中达到或超过已有先进方法。RetroChimera在两个数据集的k大于1时取得新的最佳结果,top-10准确率分别提高1.7和1.6个百分点。
随后,研究使用Pistachio中截至2023年6月的反应训练模型,并以2024年新增的反应构建测试集。经过质量控制和结构相似性过滤,测试集包含146393条在时间和结构上均与训练数据分离的反应。RetroChimera只需返回10个候选结果,就能达到R-SMILES 2返回50个候选时的准确率。
按训练数据相似度和反应模板频次分析后,两个子模型表现出明显差异。距离训练数据较远时,从头生成模型的性能下降较慢;对于训练中未出现或只有一个样本的模板,R-SMILES 2优于NeuralLoc。当一种反应模板已有少量训练样本时,NeuralLoc能够更有效地使用该模板。按反应类型划分时,R-SMILES 2在杂环形成、多反应中心和未被NameRxn分类的反应上更有优势,NeuralLoc则更擅长氧化和官能团互变反应。RetroChimera在各类反应中通常接近表现更好的子模型。
Novartis和GSK内部数据上的迁移
研究在Novartis内部数据库的10444条反应上进行零样本测试,没有额外训练模型,也没有重新学习集成权重。RetroChimera仍然优于两个子模型,说明从Pistachio数据中学习到的能力可以迁移到不同来源的药物化学数据。GSK数据按时间切分,并过滤与训练集过于相似的结构,得到约61.3万条训练反应、2.2万条验证反应和3.2万条测试反应。无论重新训练还是微调,加入GSK数据都能改善结果;从Pistachio检查点开始微调优于只使用GSK数据从头训练,计算成本也更低。两个子模型同时微调后的RetroChimera表现最好。
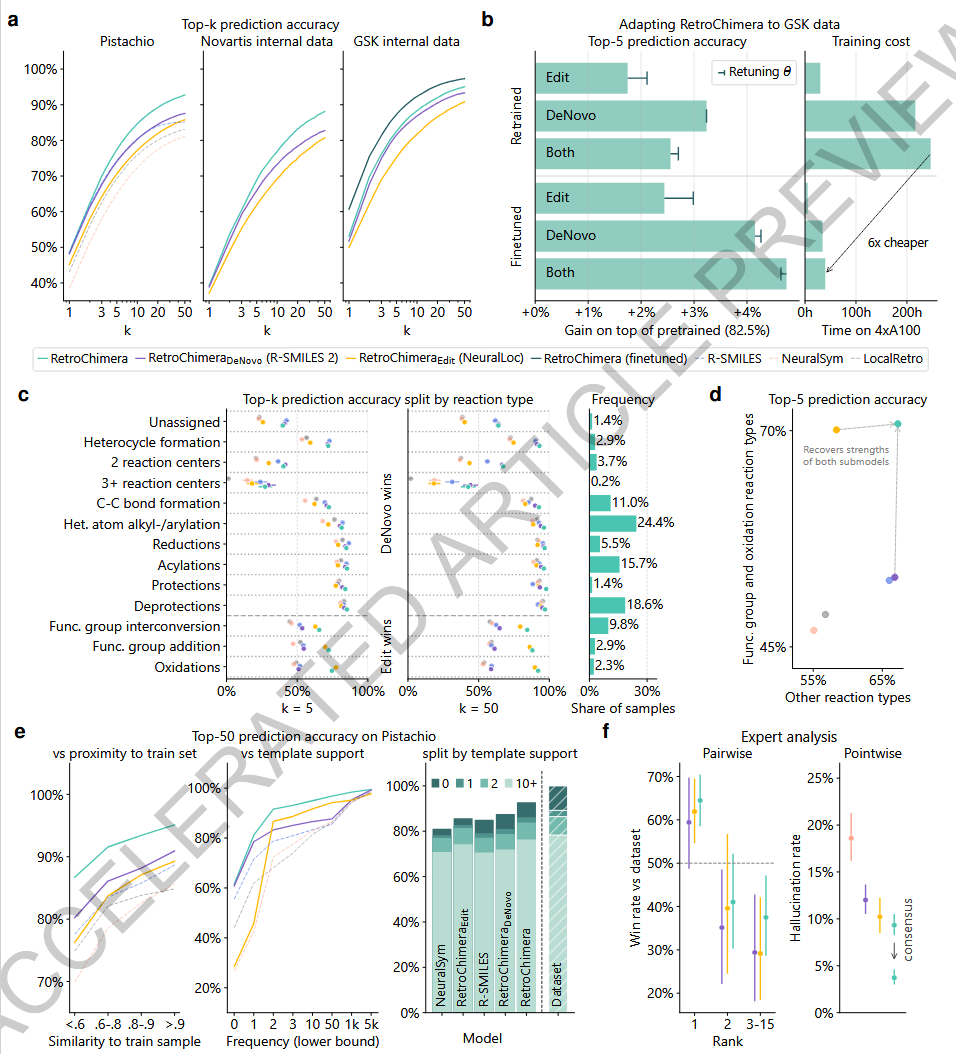
图3|Pistachio、Novartis和GSK数据上的单步预测、反应类型分析和化学家评估
化学家盲评中的偏好和幻觉率
top-k准确率只能判断模型是否复现数据集记录的反应,但同一个目标分子通常存在多种合理合成方法。研究因此邀请博士水平的有机化学家开展成对比较和单项判断。成对比较共收集9位专家的599次评价。当RetroChimera的第一名预测与数据集记录不同时,化学家显著更偏好模型给出的反应,平均偏好率约为64%,P值小于0.05。
在单项判断中,5位评审者把模型预测标记为合理、边界情况或幻觉,共产生6045个评分,覆盖2555个独立反应。RetroChimera及其两个子模型的幻觉率明显低于NeuralSym,RetroChimera又略低于两个子模型。如果只保留两个子模型都曾提出的共识预测,幻觉率会进一步下降。对于由多名专家重复评价的540个反应,评审者一致率超过90%。
多步路线搜索和专家路线审查
在SimpRetro药物分子基准上,研究把模型接入syntheseus搜索框架,并沿用相同的搜索算法、起始原料、GPU类型和时间限制。RetroChimera的求解率持续高于SimpRetro,并在最长时间限制下接近100%。研究还从Pistachio测试集中选择750个结构复杂且远离训练数据的目标,构建PistachioSim数据集,并使用正向预测模型和可行性模型过滤单步候选。过滤器可以拒绝75%的幻觉,同时损失约15%被专家判断为合理的反应。
研究又在PistachioHard上取消过滤器。RetroChimera、R-SMILES 2、NeuralLoc和NeuralSym分别求解91%、94%、87%和82%的目标。三位化学专家进一步审查10个包含困难转化的目标。剔除受数据质量影响的步骤后,RetroChimera预测步骤的291次评分中有96.9%被接受,高于R-SMILES 2的89.2%、NeuralLoc的91.8%和NeuralSym的78.5%。按完整路线计算,RetroChimera为10个目标中的9个给出没有不合理步骤的路线,两个子模型分别为4至5个,NeuralSym为2个。
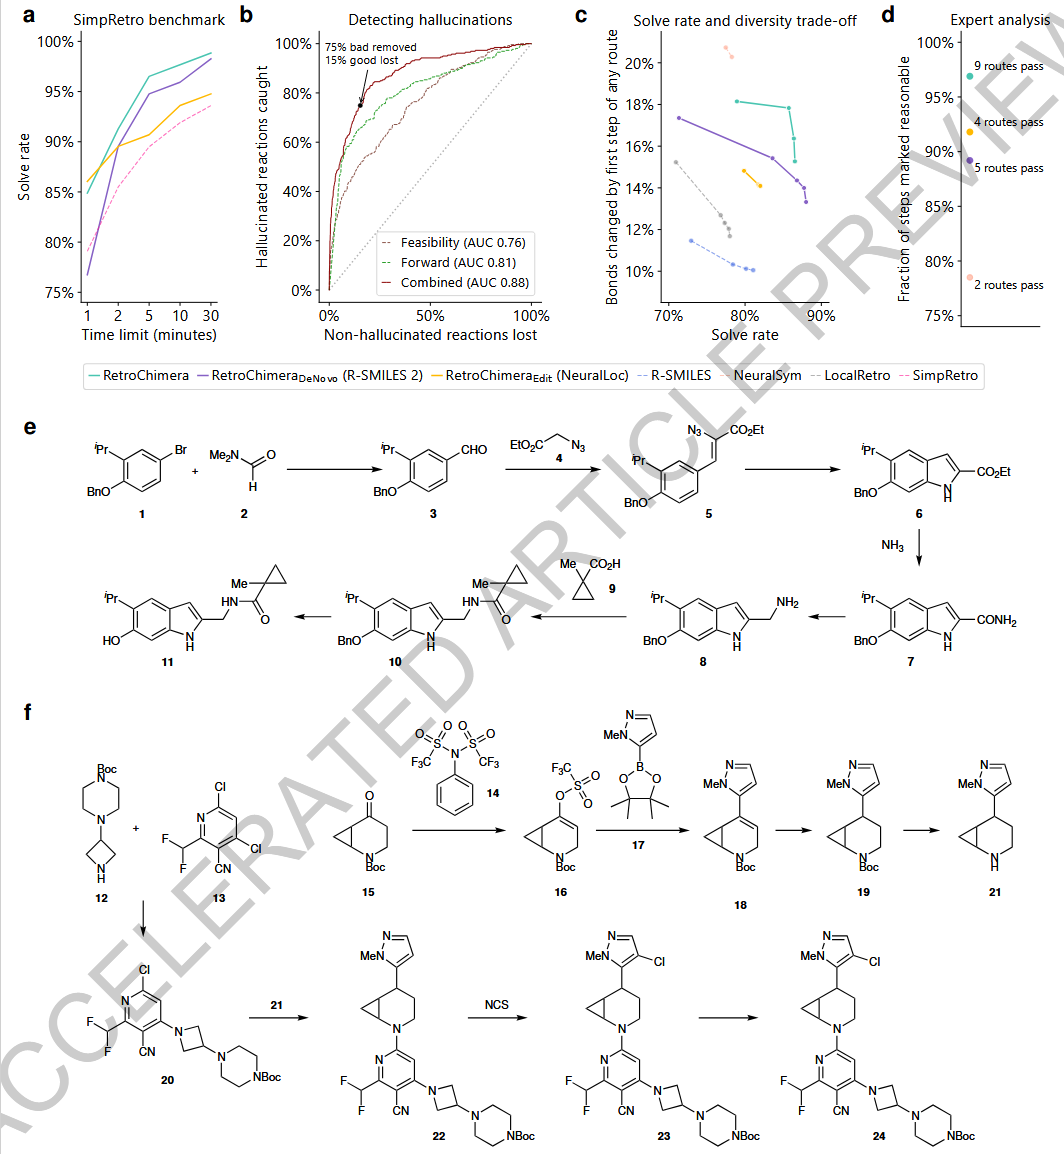
图4|多步搜索求解率、幻觉过滤、路线多样性和化学家路线评价
局限性
RetroChimera仍未完全消除反应幻觉,尤其是在目标分子远离训练分布时。例如,以专利反应训练的模型处理天然产物,可能面对训练数据未覆盖的反应类型和结构环境。正向预测模型和可行性模型能够过滤部分错误,但也会同时删除一部分合理反应。
立体化学预测仍受到文献标注不完整的限制,训练数据中的系统性错误也可能被模型继承。研究没有预测试剂、溶剂和具体反应条件,因此当前输出主要描述反应物和结构转化,还不能直接作为完整实验方案。要进一步判断反应性并支持实际执行,还需要更可靠的反应条件预测、数据整理和有针对性的实验数据生成。
此外,Pistachio以及Novartis和GSK内部数据并非全部公开,GSK内部数据训练的模型也未开放。部分药企场景中的结果因此难以由外部研究者完整复现。化学家评估虽然覆盖了数千次评分,但多步路线的详细专家审查集中在10个困难目标上,仍需要在更多分子类型和真实实验条件下继续验证。
总结
RetroChimera将基于反应模板的图神经网络模型与从头生成的Transformer模型进行集成。NeuralLoc利用已知反应规则并学习模板的具体作用位置,R-SMILES 2借助根原子对齐的SMILES和改进的Transformer结构扩展候选反应,两者再通过学习排序合并。实验显示,两个子模型在不同反应类型、不同模板频次和不同训练数据距离下各有优势,集成模型能够利用这种互补性。在公共数据和两家制药公司的内部数据上,RetroChimera提高了单步逆合成预测表现;在化学家盲评中,其预测获得更高偏好并降低幻觉率;在多步搜索中,它为复杂目标给出了更多被专家接受的完整路线。研究结果表明,逆合成模型的改进不能只依赖单一架构或扩大训练数据,还可以通过组合不同归纳偏置,提升预测准确率、化学合理性和分布外迁移能力。
参考链接:
Maziarz, K., Liu, G., Pultar, F. et al. Chemist-aligned retrosynthesis by ensembling diverse inductive bias models. Nature (2026).
https://doi.org/10.1038/s41586-026-11160-9
--------- End ---------
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢