

从头蛋白质设计通常采用两阶段流程:先生成满足目标功能的蛋白质骨架,再通过逆折叠为骨架设计氨基酸序列。这种方法将结构生成和序列设计拆成两个相对独立的步骤,流程清晰,也已经成为当前蛋白质设计中的常见范式。但序列和结构本身并不是两个独立的问题。氨基酸类型决定了局部相互作用、侧链堆积和界面化学环境,而这些因素又会反过来影响蛋白质能够形成什么样的三维结构。先固定骨架、再寻找能够适配它的序列,意味着模型在结构生成阶段并不知道最终会由哪些氨基酸来实现这些相互作用。因此,近年来越来越多的方法开始探索 sequence–structure co-design:在同一个生成过程中同时建模氨基酸序列和三维结构,让序列选择与结构变化彼此影响。但同时生成序列和结构,并不意味着二者天然一致。一个合理的设计结果需要满足两个方向的一致性:给定氨基酸序列,它应该能够稳定形成生成的结构;反过来,给定这个结构,其中的局部几何和相互作用也应该与对应的氨基酸类型相匹配。换句话说,模型不仅需要同时生成两个模态,还需要让它们描述的是同一个蛋白质。这也带来了 co-design 中一个容易被忽略的问题:序列–结构不一致既可能来自训练数据,也可能在生成过程中逐渐积累。训练数据中,如果同一个序列对应的结构本身不够可靠,模型会接收到相互矛盾的跨模态监督;而在扩散去噪过程中,早期确定的氨基酸类型,也可能随着后续结构不断变化而逐渐变得不再匹配。因此,co-design 真正的难点不只是“同时生成序列和结构”,而是如何从训练数据到整个生成过程,持续保持序列与结构之间的一致性。
围绕这一问题,英灵殿科技(Valhalla Technology)联合香港中文大学、华盛顿大学等高校团队提出 CODesign,一个以一致性为核心的全原子蛋白质 binder 协同设计模型。研究团队首先通过一致性蒸馏构建了约 105,000 个蛋白质二聚体,提高训练数据的一致性。其次,CODesign 通过多模态联合流匹配进一步促进一致性,该模型能够捕捉序列、主链结构和局部原子构象的联合分布,并结合一致性感知联合重采样策略,对序列和侧链进行迭代优化。实验表明,CODesign 在蛋白质靶点和小分子靶点的 binder 设计任务中均取得了最高的 in silico 成功率,超越 RFDiffusion3 和 Proteína-Complexa,达到了当前最先进的水平。
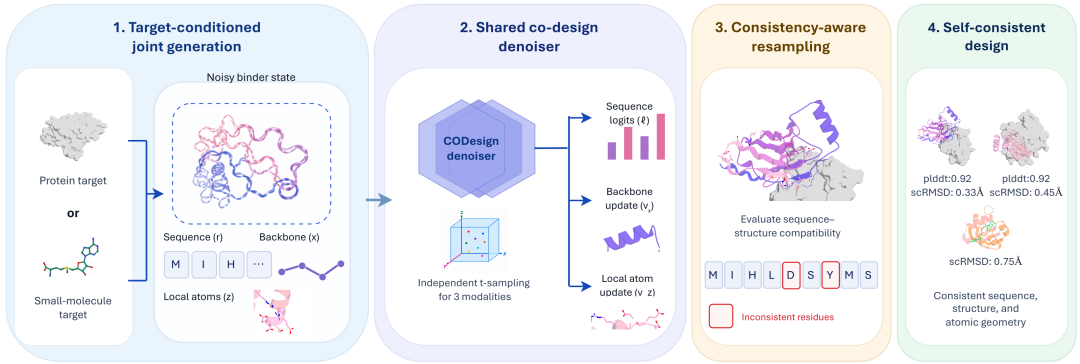
图 1|CODesign 整体框架:以蛋白质或小分子为靶点,联合生成序列、骨架与局部原子状态,并通过一致性感知联合重采样改善序列–结构一致性。(原文图 1)
先让训练样本中的序列与结构相互匹配
实验解析的蛋白质复合物在数量和结构多样性上仍然有限。现有方法利用 AlphaFold Database(AFDB)的预测单体进行预训练,或利用预测单体中的结构域-结构域相互作用构建伪复合物,以扩大数据规模。然而,这些方法都没有显式确保配对序列与相应的几何构象相兼容。预测得到的结构本身可能是合理的,但将其序列重新折叠后,却可能无法恢复相同的几何构象。这一问题也出现在已有的高置信度预测复合物中。论文发现,AFDB 高置信度异源二聚体中,仅有 8.49% 的样本能在 ESMFold2-Fast 重新折叠后,将复合物 Cα 骨架偏差控制在 2 Å 以内。因此,预测置信度高,并不等于序列与结构相互一致;扩大数据规模的同时,还需要改善配对质量。
为此,团队构建一致性蒸馏二聚体数据集 Codimer。参考结构来自 AFDB、HumanPPI 和 PINDER,覆盖预测与实验解析的复合物。对每个参考结构,先使用 ProteinMPNN 联合重新设计两条蛋白链,生成 4 组候选序列;再用 ESMFold2-Fast 将每组序列共同折叠成全原子复合物。前一步提升序列对参考结构的适配,后一步检验重新设计的序列能否恢复该结构。
随后,在满足整体结构与界面置信度要求的候选中,选择复合物 Cα 骨架最接近参考结构的一组,保留其序列和共折叠得到的全原子结构。经过筛选,191,836 个参考复合物最终产生 104,528 对蒸馏样本。Codimer 的重点不只是增加数据量,而是把“什么序列适合这一结构”和“这些序列能否恢复这一结构”联系起来,为协同设计提供更一致的学习目标。
让双向一致性,成为模型自身的能力
CODesign 采用多模态流匹配,将氨基酸序列、Cα 骨架和相对于 Cα 的局部原子坐标放在同一条采样轨迹中共同演化。靶点作为固定条件,可以是蛋白质,也可以是小分子。生成中,序列预测与结构预测持续相互影响。
网络将残基级 Transformer 与原子级编码器—解码器耦合在一起。残基网络结合靶点信息与骨架几何,原子网络处理局部原子结构,两者通过交叉注意力交换信息,将整体空间关系与原子细节联系起来。模型还使用自条件机制,将已有的序列和骨架预测反馈给后续生成。
为了学到两个方向的条件关系,训练时独立采样三个模态的时间,使它们可以处于不同的去噪阶段。当骨架接近清晰、序列仍被大量遮蔽时,模型需要根据结构预测氨基酸类型,形成类似逆折叠的能力;当序列较明确、坐标仍有较多噪声时,模型则需要根据序列恢复结构。部分训练还会额外提供真实骨架或真实序列作为条件,进一步强化这两种能力。同一去噪网络由此学到双向条件关系,也为采样时的一致性评估提供了依据。
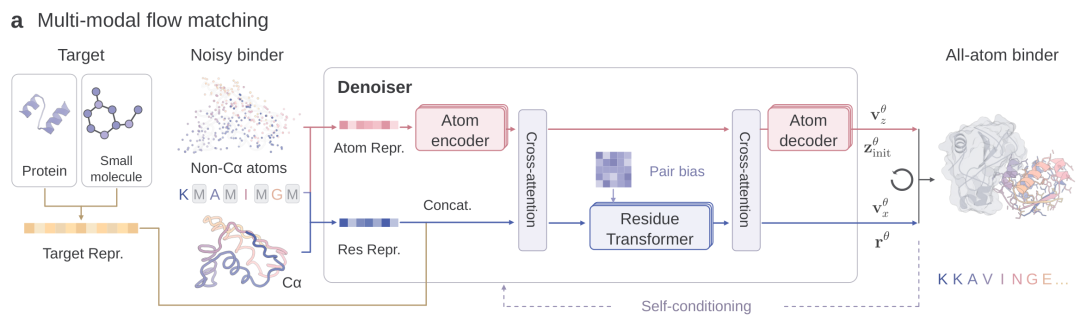
图 2|序列与全原子结构的联合生成网络,耦合残基级与原子级去噪。(原文图 2a)
在结构逐渐成形时,重新审视早期的序列选择
即使模型从具有一致性的序列–结构配对中学习,也不能保证其在采样过程中选择的氨基酸始终与结构兼容。CODesign 因此引入一致性感知联合重采样(Consistency-Aware joint Resampling, CAR),利用生成模型自身的逆折叠能力识别不兼容的残基选择,并联合重置这些残基的序列身份和局部原子状态,以便进行重新采样。
具体而言,模型先根据当前预测获得较清晰的骨架,再暂时遮蔽序列输入及可能暴露残基身份的局部原子信息,进行一次结构到序列的评估。同时,已生成序列通过自条件保留为上下文。由于差异很大的序列也可能折叠成相似结构,保留这一上下文能让评估围绕当前设计展开,而不是仅凭骨架提出一条无关的新序列。
CAR 比较每个已选位置上,模型最偏好的氨基酸与当前类型的预测概率,优先选择偏好差距较大的不匹配位置。改变氨基酸也会改变对应的原子组成,因此这些位置的序列与局部原子状态会一起重置;更合适的类型建议则写入自条件,引导后续重新采样,而不是直接替换为指定氨基酸。
骨架坐标不会被直接重置,但更新后的序列信息会影响下一次骨架预测,使骨架轨迹也能响应修正。这样,CAR 不只是修改序列,而是让序列、骨架与局部原子几何协同调整。整个过程发生在同一条采样轨迹中,不依赖外部逆折叠模型或结构预测 reward。
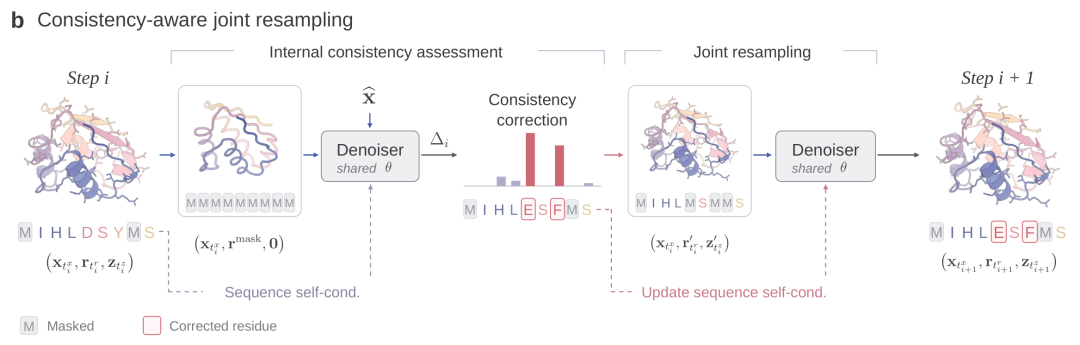
图 3|CAR 利用模型自身的预测评估残基选择,并联合重采样序列与局部原子状态。(原文图 2b)
蛋白质靶点:获得更多结构不同的成功 binder
研究首先在包含 19 个蛋白质靶点的基准上评估 CODesign。每种方法在每个靶点上生成 200 个 binder,并用 5 个随机种子重复实验。评价同时考察模型原生序列(Self),以及每个骨架经 ProteinMPNN 重新设计 1 条或 8 条序列的情况(MPNN@1 和 MPNN@8)。各序列通过 AlphaFold2-Multimer 与靶点共同折叠,进行后续评价。
评价的重点不只是有多少候选通过筛选,还包括这些候选是否结构重复。“非重复成功设计数”(Unique Successes)统计通过界面置信度、结构置信度与重新折叠一致性筛选后,经结构聚类得到的不同类别数量。自一致性偏差 scRMSD 则比较生成结构与根据设计序列重新预测的结构,数值越小表示两者越接近。
在 Self、MPNN@1 和 MPNN@8 三种设置下,CODesign 的平均 Unique Successes 分别达到 9.84、10.32 和 18.81,均为对应设置中的最高值。使用原生序列时,复合物骨架重新折叠后偏差不超过 2 Å 的比例达到 41.64%,高于 Proteína-Complexa 的 35.06%,体现出所比较协同设计方法中最强的自一致性。这些提升同时伴随着较高的结构多样性与新颖性。CODesign 的平均结构类别数为 73.92,能够在更丰富的结构空间中获得成功候选,而不只是反复生成相似的高一致性骨架。结果表明,模型在一致性、多样性和新颖性之间取得了更好的综合表现。
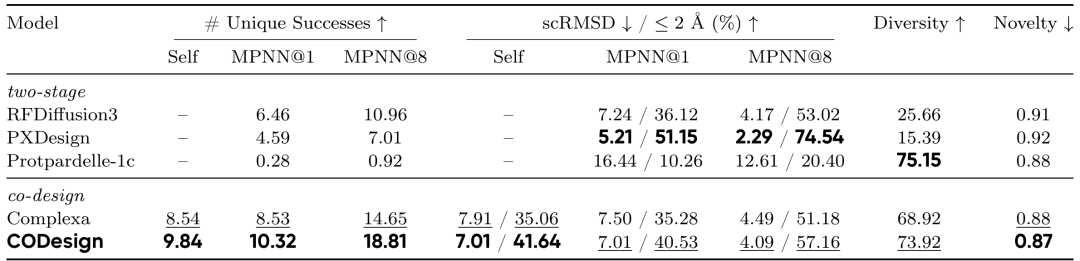
表 1|蛋白质靶点设计结果。scRMSD 衡量重新折叠与设计结构的偏差;Diversity 越高表示结构类型越丰富;Novelty 越低表示与已知结构的相似度越低。(原文表 1)
小分子靶点:更多成功设计,兼顾生成效率
在蛋白质靶点之外,团队进一步通过LoRA微调,将模型适配到小分子靶点。在 SAM、OQO、FAD 和 IAI 四个靶点上,模型使用原生序列取得平均 20.8 个非重复成功设计,高于 DISCO 的 15.7 和 RFDiffusion3 的 14.0;在 OQO、IAI 上排名第一,在 FAD 上排名第二。
在获得更多成功候选的同时,CODesign 的单样本生成时间为 39.90 秒,明显低于 DISCO 的 181.77 秒。模型还保持了协同设计方法中第二高的结构多样性,以及有竞争力的新颖性。这表明,CODesign 能够有效泛化至小分子靶点,兼顾设计质量、多样性与计算成本。
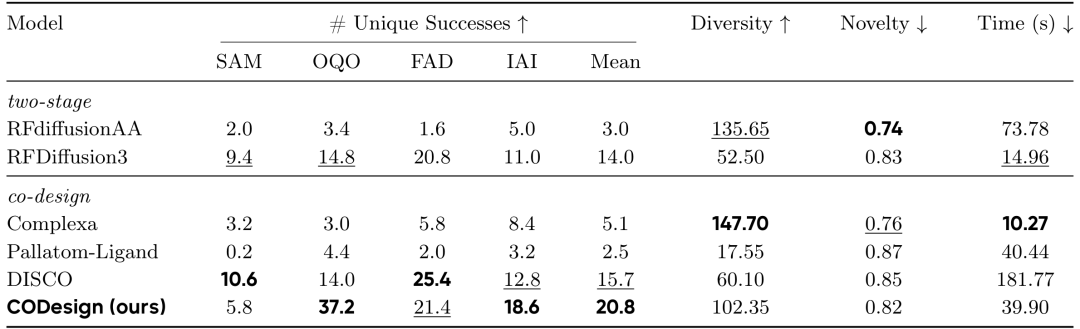
表 2|小分子靶点设计结果。协同设计方法使用原生序列,两阶段方法使用 LigandMPNN 设计序列;时间为单 GPU、批量大小为 1 时的单样本生成耗时。(原文表 2)
数据与生成过程中的一致性,各带来多少提升
在关闭 CAR、使用原生序列的对照中,加入 Codimer 后,平均 Unique Successes 由 5.54 提升至 9.46,增幅约 70.9%,19 个靶点中有 12 个得到改善。指标分布进一步显示,提升主要来自更合理的界面与局部结构,以及更好的复合物级一致性。
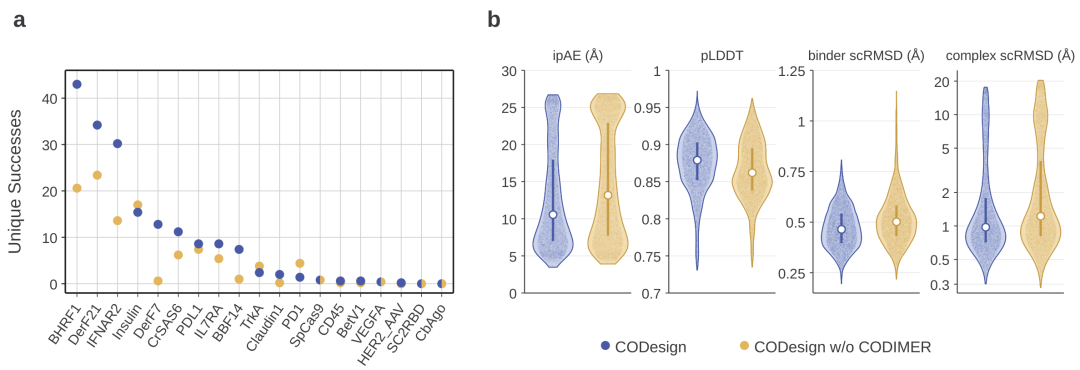
图 4|Codimer 的消融结果。左:各靶点的 Unique Successes;右:各指标分别选取每个靶点最优 100 个值后的分布。两组均关闭 CAR。(原文图 3)
在同一个已使用 Codimer 训练的模型上,保持其它采样设置不变,仅开启 CAR,平均 Unique Successes 进一步由 9.46 增加到 9.84,提升约 4%;单样本生成时间从 27.96 秒变为 28.41 秒,仅增加 0.45 秒。
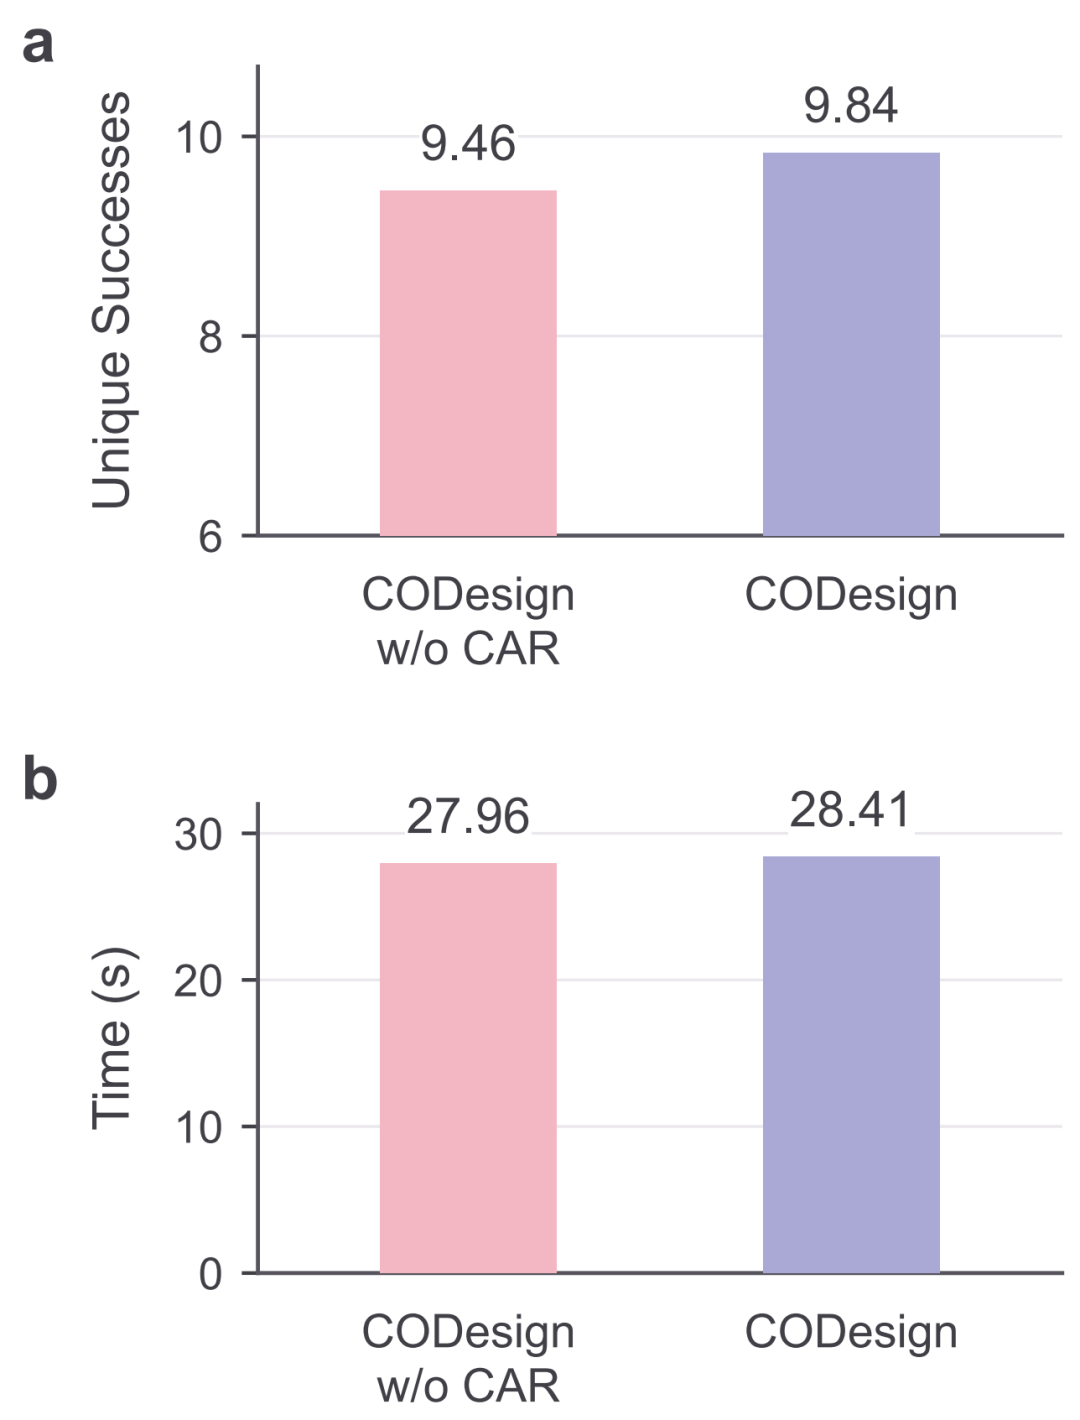
图 5|CAR 的消融结果。上:19 个蛋白质靶点上的平均 Unique Successes 从 9.46 提升至 9.84;下:单样本生成时间从 27.96 秒变为 28.41 秒。两组均使用 Codimer 训练及模型原生序列。(原文图 4)
这说明,CAR 能够利用模型自身的纠错能力,在几乎不增加计算负担的情况下进一步改善设计表现,而不需要依赖外部 reward。数据层面的一致性监督带来主要提升,采样过程中的针对性修正则在此基础上继续改善生成结果。
从计算一致性,走向真实的结合验证
CODesign 强调的并非仅仅把序列与结构放在同一个模型中输出,而是让二者的一致性成为数据构建、模型训练与生成过程共同遵循的设计原则。通过一致性蒸馏与模型内部纠错,研究将这一思路用于蛋白质和小分子靶点条件下的全原子 binder 设计。
当前结果仍局限于计算评价。重新折叠的一致性和预测的界面置信度,不等同于真实的结合亲和力;这些评测也依赖结构预测与逆折叠工具,可能放大一致性优化的表观收益。计算指标的改善能否转化为更高的真实结合成功率,仍需要湿实验验证。
研究团队将开放代码、模型权重与 Codimer 数据集,为后续复现与方法研究提供基础。从“共同生成”走向“相互一致”,CODesign 为蛋白质 binder 设计提供了一条贯穿数据与生成过程的路径。
参考资料
论文题目:CODesign: Consistency from Data to Trajectory in All-Atom Protein Binder Co-Design
原文链接:https://arxiv.org/abs/2610.01773v1
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢