

在上一篇《让隐私计算从“能算”到“好算”》里,我们提到分析套件已经和 SecureID 打通:对已经完成映射、满足使用条件的 ID,组件可以直接走明文 Join 提速;对未完成映射的场景,继续走密文 PSI。同一个组件,明密文兼顾。
这就引出一个问题:为什么一批 ID 可以“明文”匹配,却不泄露原始 ID?明文 Join 的前提到底是什么?这一篇,我们就把 SecureID 的原理和落地讲清楚。
SecureID 是 SDH 明密文混合计算的底座。它把跨域协作里开销高昂的 ID 加密匹配,从“每次任务都要重算”挪到了“一次预处理、多次复用”。
一、跨域 ID 匹配,慢在哪
广告主和平台做联合分析,首先要回答一个问题:广告触达的人中,哪些后来到店浏览、加购或购买了?这需要把广告主的投放记录与平台上的用户行为关联起来,同时保护双方的用户信息。在此基础上,才能看清广告带来了哪些转化、吸引了什么样的人群,为后续投放提供依据。
实现这种关联,传统方案的技术核心是隐私集合求交(PSI):它帮助双方在不交换完整用户名单的前提下,找出共同触达或服务的用户。但如果每次分析都要对全量数据重新匹配,就会带来两个实际代价。
重复分析,重复求交。 哪怕两边的底表一个月没怎么变,下周再跑一次分析,仍要重新执行全量加密求交。数据量到十亿、百亿级,这一步就可能成为整个链路的性能瓶颈。
增量数据,难以轻量处理。 广告主每来一批新的触达数据,就要判断能不能补进交集。如果每批都触发一次全量 PSI,就很难满足流式业务的时效要求。
问题在于,这种方式把加密求交的开销放在了每一次在线任务里。SecureID 的思路是把加密映射和在线匹配拆开:已经完成映射的 ID,后续可以反复匹配,而且匹配时走的是明文。
二、SecureID 是什么
一句话定义:SecureID 让多方把各自持有的 ID 映射成一组伪随机标识符 SID,并且满足两个核心性质。
对齐性。 在同一映射体系下,多方数据里相同的 ID 会得到相同的 SID。后续任务可以直接拿 SID 做明文 Join,不必重复执行全量 PSI。
安全性。 在协议的安全假设下,任何一方都不能仅凭 SID 反推出自己未知的原始 ID。对己方没有的那个 ID,看到的是一个伪随机标识,而不是它对应的真实身份。
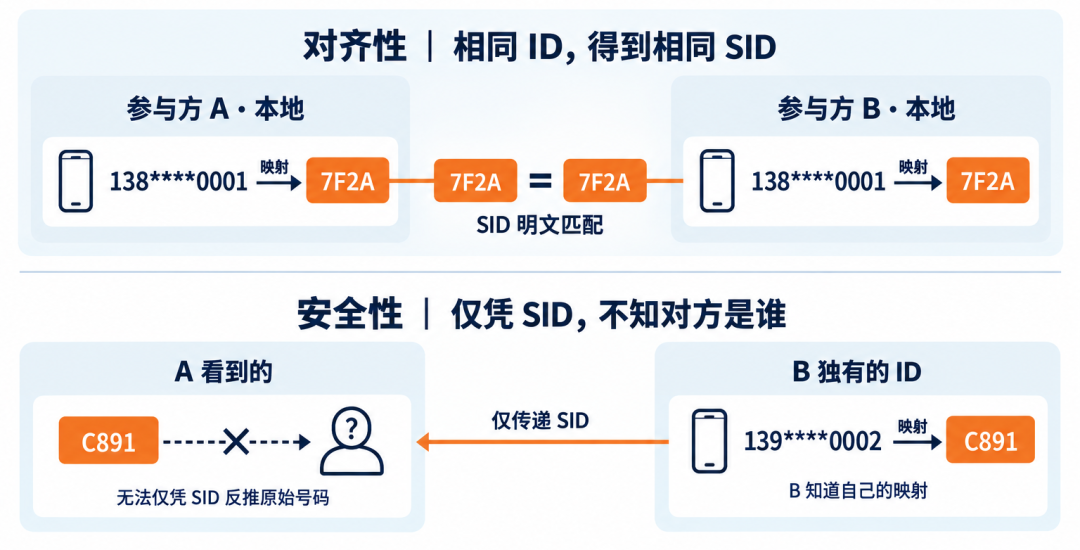
SecureID 的技术思路来自学术界对 Private-ID(PID)的研究。在这条技术路线中,先为各方的 ID 映射生成可对齐的随机标识,再通过隐私集合求并(PSU)形成覆盖各方数据的统一标识集合。
我们目前落地的是其中的映射环节,也就是 SecureID:让各方持有的相同 ID 映射到一个相同的 SID,后续匹配提供可复用的基础。
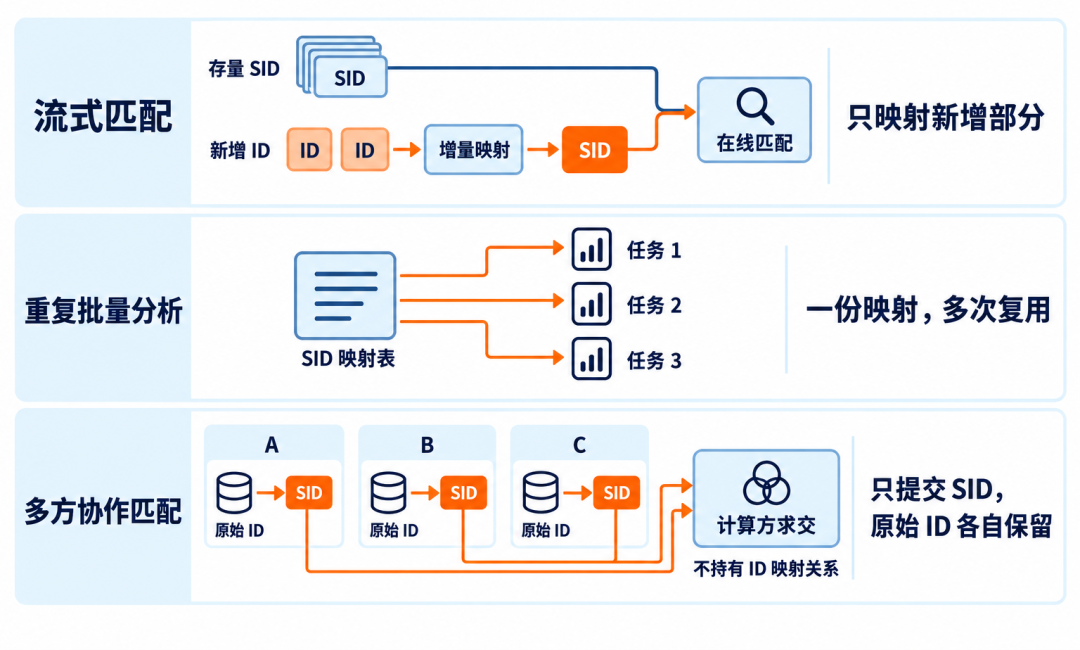
这项能力的价值,主要体现在三个场景:
流式匹配。 双方先完成存量 ID 的 SID 映射。新数据到来时,只需为新增 ID 生成 SID,再进入在线匹配,无需因每批增量重复处理全量数据。
重复批量分析。 SID 可以复用。同一份底表反复参与分析时,已有映射直接使用,仅对新增部分补充映射,减少重复计算。
多方协作匹配。 多方完成 SID 映射后,可以将 SID 交给不持有原始 ID 映射关系的计算方求交。计算方在伪随机标识上完成匹配,无需接触各方原始 ID。
三、原理与架构:加密前置,匹配在后
SecureID 的核心是把 ID 映射成伪随机数,这一过程在密码学里常用 PRF(伪随机函数)实现。但 SecureID 的难点不在“映射”,而在“如何让双方对同一个 ID 映射到同一个值,同时又谁都拿不到对方的密钥”。
如果双方直接共用一把已知密钥,对齐性是有了,却存在枚举攻击的风险:持有密钥的一方可以为猜测的 ID 计算映射,再与收到的 SID 比较,从而拿到除了交集 ID 外的其他 ID 信息。
SecureID 的做法,是让双方各自持有密钥,通过协议共同生成一致的映射结果。每一方通过交互,让对方的密钥“盲”地作用在自己的数据上,再结合本地密钥的计算结果。两方构造可以概括为:
SID(id) = OPRF(对方密钥, id) + PRF(己方密钥, id)
其中,OPRF 是不经意伪随机函数:一方在不向对方暴露输入 ID、也不获取对方密钥的情况下,得到对应的计算结果;PRF 那一项则可以完全本地计算。这里的“+”表示该构造中约定的组合运算。双方对相同 ID 得到相同的 SID,但任何一方都不单独持有生成映射所需的全部密钥。
整个流程分两个阶段。
预处理阶段:生成可复用的 SID 映射。
双方各生成一把密钥,互不知道对方的密钥。以一方为例,它先把自己的 ID 映射到椭圆曲线上,并加上一层随机掩码,这一步叫“盲化”;对方用自己的密钥完成评估后返回结果;发起方去掉掩码,得到 OPRF 值,再结合本地计算的 PRF 值,生成 SID。另一方对称执行同样的流程。
最终,相同 ID 得到相同 SID,各方在本地保存自己的 ID→SID 映射表,供后续任务使用。
在线阶段:直接在 SID 上匹配。
双方通过映射表,将业务数据中的 ID 换成 SID,再按任务授权交换 SID、执行明文 Join,得到交集。这个阶段无需重复执行 ID 映射所需的密码学运算,匹配可以使用普通 Join 的处理能力。
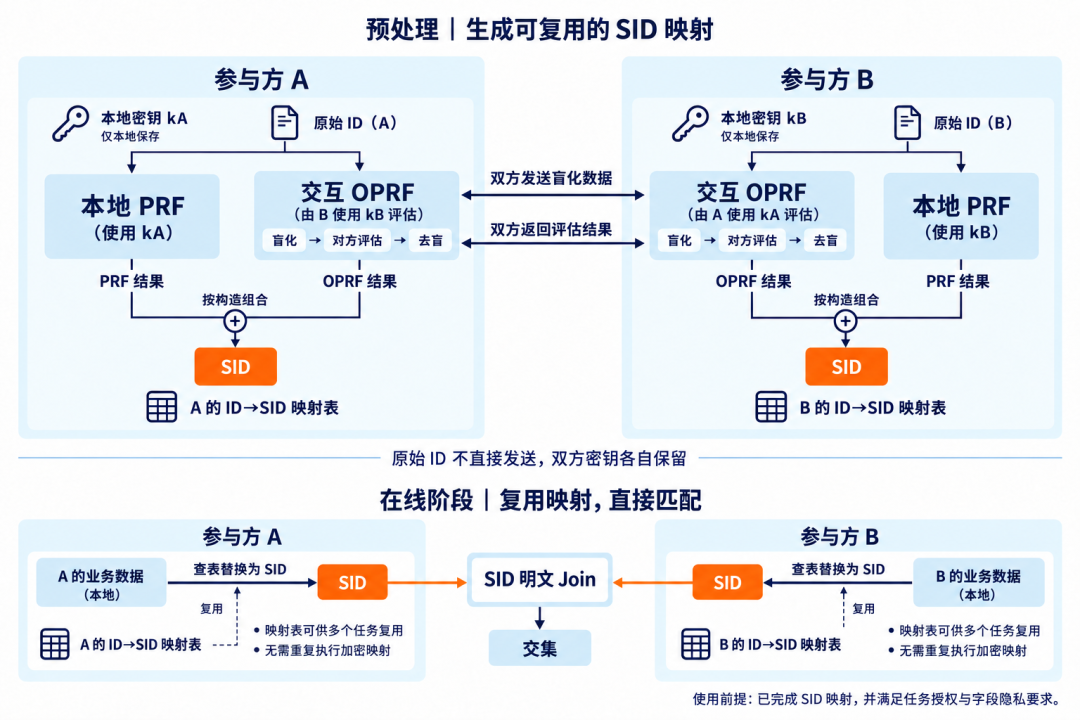
这里要强调一点:明文 Join 同样遵循平台的隐私保护要求。能走明文的前提,是这批 ID 已完成 SID 映射,并满足任务授权和字段级隐私属性要求。明文处理的是 SID,原始 ID 并不因此开放。
这套技术思路有明确的学术来源。Facebook 在 2020 年公开介绍并开源了 Private-ID,利用椭圆曲线密码技术实现记录对齐。2021年,Garimella 在此基础上基于 OPRF 设计了更加高效的 PID 方案。我们沿用了 OPRF 路线,并采用椭圆曲线对 OPRF 落地,我们复用了 SDH 现有的 ECC 能力,同时将 OPRF 抽象为独立原语,为后续进一步的实现升级留下了统一接口。
四、从两方到多方
真实业务里的数据协作,往往不止两方。随着多方联合分析等需求增加,SecureID 也需要让更多参与方在同一套 SID 上完成数据对齐。
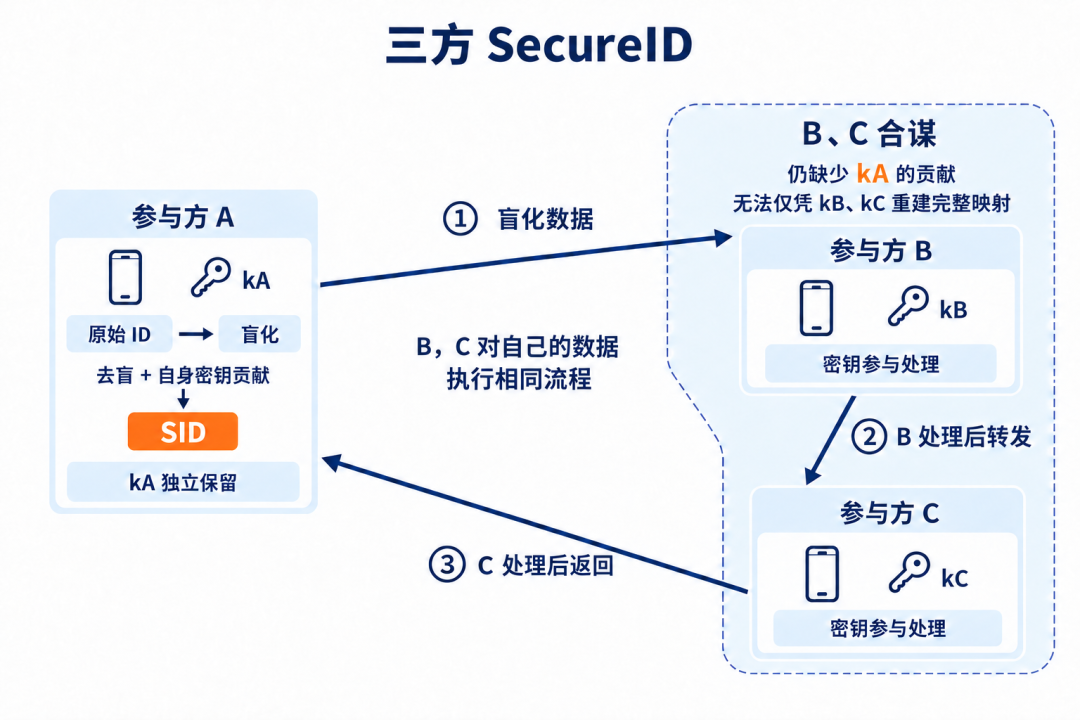
从两方扩展到多方,关键是让各方的密钥贡献共同参与 SID 生成。对齐我们采用环形通信网络实现:一方将自己的 ID 盲化后,沿环依次交给其他参与方处理,最后回到发起方,完成去盲及后续计算,生成 SID。各方按同样的流程处理自己的数据,就能为相同 ID 生成一致的标识,为后续多方匹配提供基础。
参与方增加后,还需要考虑一个问题:如果其中几方联合起来,能否推断其他方的原始 ID?SecureID 在构造上让每一方的密钥都参与 SID 生成。即使部分参与方合谋,只要仍有一方未参与合谋,合谋方就缺少这一方的密钥贡献,无法仅凭已掌握的密钥重建完整映射,也就无法据此反推出该方独有的原始 ID。
目前,我们已将这套机制落地到三方 SecureID 中,在实现三方数据对齐的同时,支持任意两方合谋场景下的隐私保护。
五、性能与落地
我们对 SecureID 的性能提升效果也进行了实验/落地验证。在相同的实验环境/数据集下,密文 PSI 匹配与基于 SID 的在线明文匹配耗时对比数据如下:
这里比较的是匹配阶段耗时,SID 以已完成映射为前提,首次映射成本需单独考虑。
可以看到,在线匹配耗时基本减半。而且,映射复用的价值会随着任务次数增加进一步体现:在相同的参与方下,已有数据的 SID 可以持续使用,新增 ID 按业务时效要求补充映射。任务跑得越频繁,省得越多。
在 SDH PaaS 平台上,接入 SecureID 分为三步,都可以通过 SDH 表单配置执行,不需要理解底层协议。
存量映射表生成。 双方将全量 ID 表注册到平台,通过 SID 动态更新组件完成首次映射,得到各自的 ID→SID 映射表。
增量映射表更新。 对新增 ID 生成 SID,并追加到映射表中。更新频率按业务需求配置,例如现有批量分析场景可以按周执行。
业务任务执行。 将数据中的 ID 替换成 SID 后提交任务。目前,分析套件的模板同时支持“用 SID”和“不用 SID”两种模式,根据映射情况和隐私要求选择明文或密文路径。
至此,回到开头那个问题:为什么一批 ID 可以明文匹配,却不暴露原始 ID?因为它们已经在预处理阶段被映射成可对齐、难以反推的 SID。明文匹配的是随机标识,而不是原始 ID。加密映射的成本前置,匹配的成本被反复摊薄。这正是 SecureID 让隐私计算从“能算”走向“快算”的关键一环。
展望
下一步,我们将围绕更多业务场景扩展安全计算能力,包括 PSI-Card、PSI-Card-Sum、PCSI,以及联合统计中的中位数、方差计算等,让多方数据协作从安全匹配进一步走向丰富的统计分析,支持更深入的人群洞察与业务决策。
在底层技术升级上,我们后续也将考虑引入基于 VOLE 的高性能 OPRF 技术,持续优化PSO相关技术,降低大数据量下的计算和通信开销,进一步落地应用于更多场景。
“SDH PaaS 3.0”系列后续还会陆续展开联邦学习技术等篇章,欢迎行业伙伴与我们交流合作。
🏷️ 关于我们
阿里妈妈 SDS(Strategic Data Solutions)团队致力于用数据让商家和平台的增长战略更加科学有效。我们为阿里妈妈全线广告客户提供营销洞察、营销策略、价值量化、效果归因及隐私计算等技术服务。
我们将持续推进营销场景下隐私增强技术、可信数据协作体系和解决方案的探索与建设。
📮 联系邮箱:alimama_tech@service.alibaba.com
🔗 专题查阅:隐私计算专题
也许你还想看
关注「阿里妈妈技术」,了解更多~
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢