2026年10月,英国Shift Bioscience公司、加拿大多伦多大学等机构的研究团队在《Nature Biotechnology》发表了题为“Deep learning perturbation models can outperform baselines on calibrated metrics”的研究论文。研究通过分析14个基因扰动数据集和18种评估指标,发现广泛使用的均方误差和基因表达变化相关性等指标可能无法充分反映模型的真实预测能力,并提出基于正负对照的指标校准框架,证明深度学习模型能够在经过合理校准的评估体系下超越简单基线方法。
背景
近年来,随着单细胞转录组数据规模扩大,scGPT、GEARS等深度学习模型被用于预测基因扰动引起的表达变化。然而,多项基准评测对这些模型的实际预测能力提出质疑。相关研究发现,在多个数据集上,复杂深度学习模型的表现往往无法超过简单的平均基线,甚至在均方误差(MSE)、平均绝对误差(MAE)及基于对照细胞的表达变化Pearson相关系数等指标上表现更差。平均基线不区分具体扰动,而是直接利用训练集中所有扰动的平均基因表达谱进行预测。由于没有针对不同基因扰动生成特异性响应,这一方法原则上无法准确反映不同扰动的生物学作用。如果复杂模型始终无法超越这种缺乏扰动特异性信息的基线,就意味着现有深度学习方法可能尚未学习到具有实际价值的扰动规律。研究团队认为,这一结论存在重要前提:用于比较模型性能的评估指标,首先必须能够有效区分具有生物学意义的预测结果与缺乏信息的预测结果。
此前研究已经发现两类可能影响扰动模型评估的因素。第一类是对照偏差,即对照细胞与扰动细胞之间存在系统性差异,使基于对照细胞计算的相关性指标被人为抬高。第二类是信号稀释,即某些扰动只影响少数基因,而大量未受影响基因在整体误差计算中占据主导地位,导致具有重要生物学意义的表达变化被掩盖。模型表现不佳既可能源于预测能力不足,也可能源于评估指标对扰动特异性信号缺乏足够敏感性。为区分这两种情况,研究团队引入实验科学中常见的正负对照思想,建立了评估指标校准框架。
方法
构建用于评估的正负对照基线
研究首先构建能够代表不同预测能力水平的基线方法。其中,平均值基线作为负对照,代表缺乏扰动特异性信息的预测方式。研究还引入对照细胞平均表达谱作为另一种简单基线,并在部分预测任务中采用线性模型和加性模型进行比较。在正对照方面,研究使用技术重复基线。该方法将同一基因扰动条件下的细胞随机分成两组,使用其中一组细胞的平均表达谱预测另一组。由于两组细胞受到相同的基因扰动,理论上包含共同的扰动特异性信号,因此能够估计在实验噪声条件下可达到的较好预测水平。然而,研究发现,技术重复基线并非在所有数据集上都优于平均值基线。尤其是在扰动较弱的数据集中,平均值基线利用更多训练数据估计未发生明显改变的基因表达水平,反而可能获得更低的整体预测误差。
为解决这一问题,研究进一步提出插值重复基线,将技术重复基线和平均值基线按基因分别加权组合。其核心思想是根据差异表达分析得到的统计显著性确定权重。对于受到扰动显著影响的基因,预测更加依赖技术重复基线;对于未发生明显变化的基因,预测更加依赖平均值基线;对于介于两者之间的基因,则采用加权插值。这种设计结合了技术重复基线的扰动特异性信息与平均值基线对未受影响基因的稳定估计能力,使其能够作为更加可靠的正对照。
提出动态范围比例评估指标校准程度
在建立正负对照后,研究提出动态范围比例(DRF),用于衡量某个评估指标识别真实模型性能提升的能力。DRF比较两个性能差距:一是正对照与负对照之间实际可观察到的性能差距,二是完美预测与负对照之间理论上能够达到的性能差距。两者的比值反映评估指标能够捕捉多少真实的性能改善空间。当DRF较高时,说明该指标能够较好地区分有信息的预测与无信息的预测;当DRF接近零时,说明即使预测结果包含真实扰动信号,指标也可能难以反映模型的性能优势。
研究将这一框架应用于14个基因扰动数据集,覆盖9项研究、10种细胞系及不同类型的基因激活和抑制实验,并系统评估18种指标的校准表现。这些指标主要覆盖直接重建误差、基于参考表达谱的变化指标,以及基于检索和排序的指标。
在校准指标下重新评估深度学习模型
完成指标校准后,研究进一步评估不同模型在两类基因扰动预测任务上的表现。第一类是未见过的单基因扰动预测,即模型在训练阶段学习部分基因扰动产生的表达响应,在测试阶段预测此前未出现的基因扰动。研究主要使用Replogle22 K562和Nadig25 HepG2数据集。第二类是未见过的基因组合扰动预测,即模型在训练阶段获得单基因扰动数据及部分双基因组合数据,随后预测未参与训练的基因组合所产生的转录组响应。研究使用Norman19和Wessels23数据集。
研究共比较9种深度学习模型,包括scGPT、GEARS、PRESAGE、scLambda、CellFlow,以及使用Geneformer、ESM2、scGPT和GenePT嵌入表示的四种基础模型多层感知机探针(fMLP)。此外,研究设置了平均值基线、对照细胞基线、线性基线,以及组合扰动任务中的加性基线。加性基线通过组合两个单基因扰动的表达变化预测双基因扰动结果,用于衡量深度学习模型是否能够学习超越简单加性关系的基因相互作用。
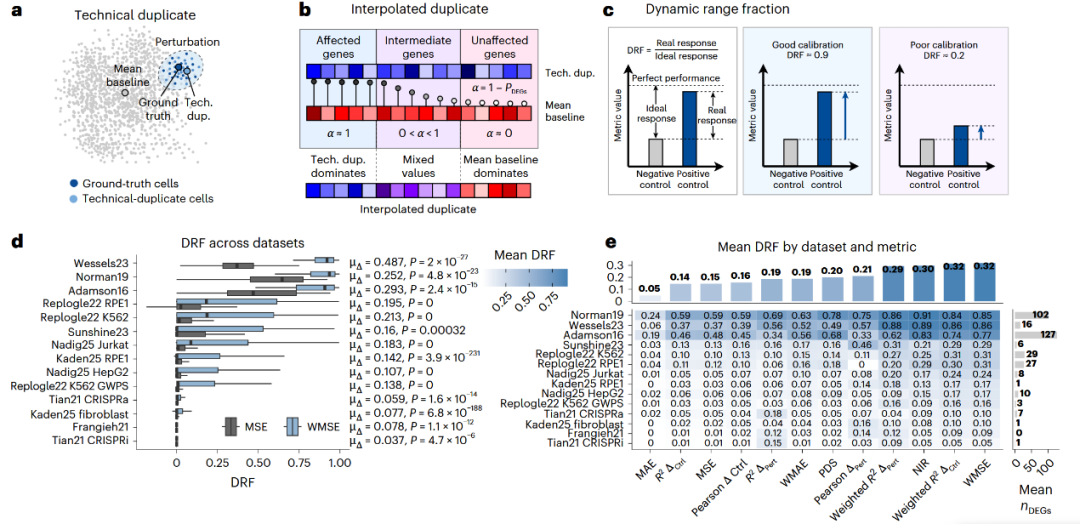
图1 基准评估指标校准程度的评价
结果
常见评估指标存在明显校准不足
研究首先发现,MSE和基于对照细胞表达变化的Pearson相关系数,在多个数据集上表现出较低的DRF,尤其是在平均差异表达基因数量较少的弱扰动数据集中。进一步的基因集富集分析表明,对SP2转录因子的抑制能够识别出与SP2结合相关的基因集合,但常规MSE未能有效体现这些扰动信号。这意味着模型即使捕捉到真实的生物学响应,也可能因为评估指标不敏感而得不到相应的性能提升。
相比之下,WMSE、加权表达变化决定系数及归一化逆排序等指标,在多个数据集中表现出更高的校准程度。特别是在扰动较弱、测序深度较低或细胞数量较少的条件下,这些指标仍能够较好地区分正负对照。
研究还发现,仅针对每种扰动中排名靠前的100个差异表达基因进行评估,通常也能够提高指标的校准程度。这些结果表明,扰动预测评估不能仅关注整体表达谱的重建误差,还需要充分考虑真正受到扰动影响的基因信号。
深度学习模型能够超越缺乏信息的基线
在重新评估未见过的单基因扰动预测任务时,研究发现,早期模型scGPT和GEARS在MSE或常规Pearson指标下未能稳定超越简单基线,这与此前多项基准研究结论一致。然而,当评估指标换为WMSE、加权表达变化决定系数等校准表现更好的指标时,这些模型在多数情况下能够优于缺乏扰动特异性信息的基线。这一结果说明,部分早期深度学习模型实际上已经学习到一定的扰动特异性信号,只是这些信号未能通过此前使用的指标充分体现。较新的PRESAGE和scLambda表现更加突出,在部分传统指标下也能够超越简单基线。研究进一步发现,在所评估的每一项指标上,至少存在一种深度学习模型能够优于所有相关的简单基线。这一结果还在独立的Nadig25 HepG2数据集中得到验证。
在基础模型嵌入表示的比较中,使用GenePT和ESM2嵌入的fMLP模型总体表现更好。研究通过缩小模型参数规模进行补充分析,发现这一优势在不同探针容量下仍较为稳定。这些发现表明,扰动表示方式及其所包含的信息,是影响模型预测性能的重要因素。
基因组合预测性能受到训练数据覆盖度影响
在未见过的基因组合预测任务中,研究首先分析了广泛使用的Norman19数据集。该数据集包含100种单基因扰动和124种双基因组合扰动,但研究使用的训练集只覆盖4950种潜在双基因组合中的31种,比例约为0.63%。
由于此前研究表明Norman19中约96%的组合效应具有加性特征,简单加性基线已经能够捕捉相当大比例的可预测信号。研究发现,在校准表现最好的指标下,加性基线能够覆盖理想性能差距的约88%,接近利用测试扰动重复数据构建的插值重复正对照水平。在这种情况下,复杂模型可进一步提升的空间十分有限。虽然深度学习模型在18种指标中的6种上超越加性基线,但总体而言,Norman19难以充分检验模型学习非加性基因相互作用的能力。
随后,研究使用具有更高组合覆盖度的Wessels23数据集进行评估。该数据集包含28种单基因扰动和157种独特组合扰动,训练集覆盖约10.3%的潜在组合空间。在这一数据集上,多种深度学习模型能够在WMSE及加权表达变化决定系数等指标上超越加性基线。其中,PRESAGE在18种评估指标中的15种上优于加性基线,包括基于对照细胞的Pearson相关系数。研究认为,当训练数据能够覆盖更大比例的组合扰动空间时,深度学习模型更有机会学习超越简单加性关系的复杂响应模式。
校准后的指标与生物学任务表现具有相关性
为了判断校准指标是否具有实际生物学意义,研究进一步评估模型在两个下游任务中的表现。第一个任务是通路恢复,即比较模型预测的扰动效应与真实扰动效应所得到的基因集富集分析结果。第二个任务是邻域结构恢复,即比较预测与真实扰动表达变化构建的近邻网络是否一致。
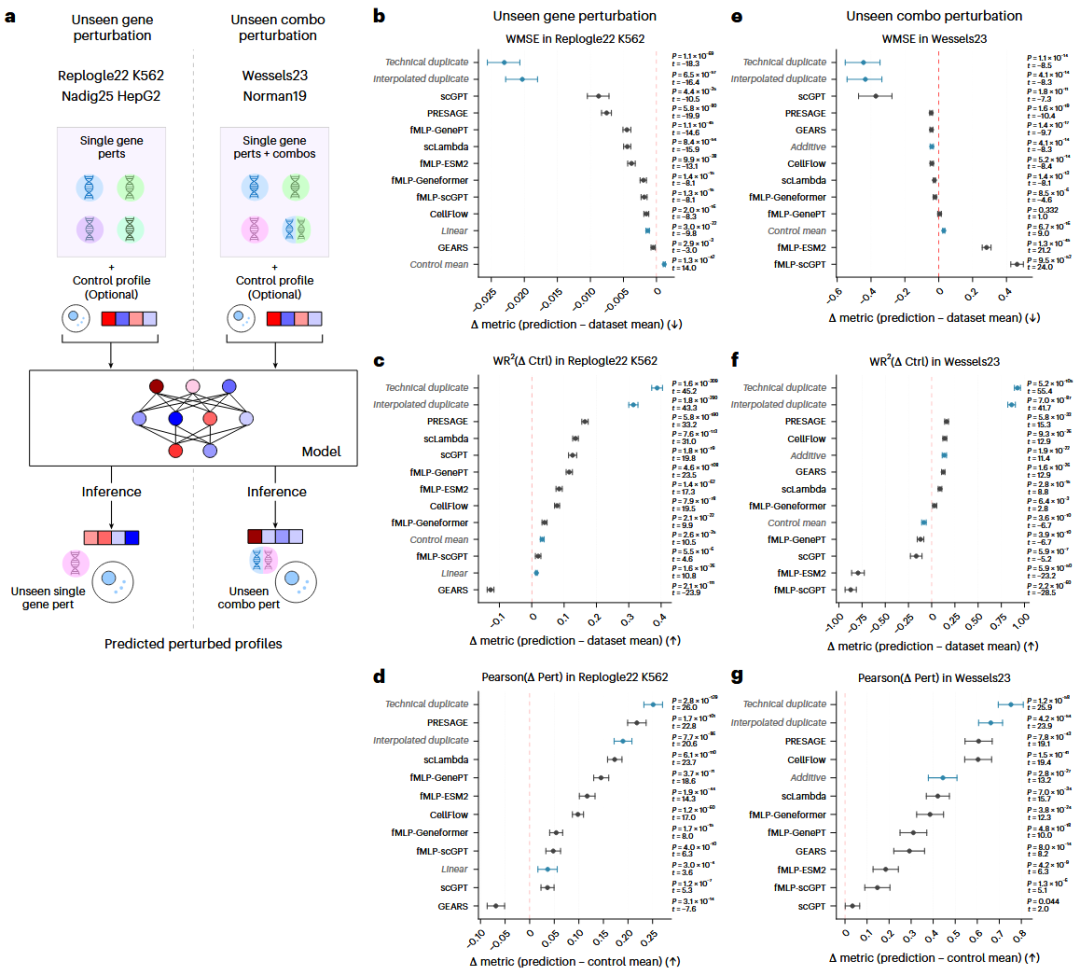
图2|采用经过良好校准的指标,对未见过的基因扰动预测及未见过的组合扰动预测进行基准评估。
结果发现,在校准指标下表现较好的模型,通常也能够取得更好的通路恢复结果。在Replogle22 K562和Wessels23数据集中,模型指标排名与通路恢复排名的平均相关系数分别达到0.76和0.84。邻域结构恢复也表现出类似趋势,两组数据中的平均相关系数分别为0.77和0.58,但不同模型之间的差异更加明显。这些结果说明,校准表现较好的指标不仅能够识别模型在数值预测上的改善,也能够在一定程度上反映模型恢复生物学通路及扰动关系的能力。
不过,不同指标衡量的模型能力并不完全相同。例如,scGPT在Replogle22 K562数据集上取得最低WMSE,并在差异表达基因上的Pearson相关性方面表现突出,但在全部基因的另一类表达变化相关性指标上仅略优于平均值基线。因此,即使某项指标经过良好校准,也不应将其视为模型能力的唯一判据。
总结
这项研究针对基因扰动预测领域长期存在的模型评测争议,提出基于正负对照的指标校准框架,并利用动态范围比例定量衡量不同指标识别有效扰动信号的能力。通过14个数据集、18种评估指标及9种深度学习模型的系统分析,研究表明,部分传统评估方法可能掩盖模型已经学习到的扰动特异性信息,导致深度学习模型的真实预测能力被低估。研究进一步证明,当采用校准表现较好的指标时,早期模型和近年来发展的新模型均有机会超越简单基线,而模型在组合扰动预测上的表现还受到训练数据覆盖度及加性效应占比的明显影响。研究同时强调,指标校准并不意味着可以完全放弃传统误差指标。直接重建误差、表达变化相关性、加权指标和排序指标分别反映模型预测行为的不同方面,应当共同构成综合评估体系。此外,研究尚未覆盖未见过的细胞类型、供体或实验条件下的扰动预测,更多组合扰动数据集仍有待验证。总体而言,该研究表明,判断虚拟细胞模型是否真正取得进展,不仅需要提升模型本身的预测能力,也需要建立能够识别真实生物学信号的可靠评估体系。对基因扰动预测模型而言,模型性能与评估指标的有效性必须同时得到验证,才能形成具有科学意义的比较结论。
参考链接:
Miller, H.E., Mejia, G.M., Leblanc, F.J.A. et al. Deep learning perturbation models can outperform baselines on calibrated metrics. Nat Biotechnol (2026).
https://doi.org/10.1038/s41587-026-03307-w
--------- End ---------
内容中包含的图片若涉及版权问题,请及时与我们联系删除
评论
沙发等你来抢