

点击蓝字关注我们
NeurIPS (Conference on Neural Information Processing Systems) 是机器学习与人工智能领域的顶级国际会议之一。NeurIPS 2026 将于 2026 年 12 月 6 日至 12 日在澳大利亚悉尼举办,另于 12 月 9 日至 13 日在美国亚特兰大和法国巴黎设置卫星会场。
PKU-DAIR实验室的论文《Tree-Structured Synergy of Large Language Models and Bayesian Optimization for Efficient CASH》和《PolySplat:Workload-Regime-Aware Rasterization for 3D Gaussian Splatting》 被 NeurIPS 2026 录用。
作者:Beicheng Xu, Weitong Qian, Lingching Tung, Yupeng Lu, Bin Cui
Github链接:https://github.com/PKU-DAIR/open-box
arXiv链接:https://arxiv.org/pdf/2601.12355
研究解读
问题背景与动机
面对一个新的机器学习任务,开发者通常需要同时回答两个问题:应该选择哪一种算法,以及应该如何设置它的超参数。AutoML 将这一联合优化任务称为 CASH(Combined Algorithm Selection and Hyperparameter Optimization)。例如,在 SVM 与 XGBoost 之间做选择时,两者需要调节的参数并不相同,选择算法也就决定了接下来进入哪个超参数空间。
贝叶斯优化(BO)通过代理模型学习配置与性能之间的关系,适合利用已有评估结果指导数值搜索。但在历史观测较少时,代理模型尚不可靠,搜索容易面临冷启动困难。大语言模型(LLM)能够利用任务描述和机器学习知识提出初始配置,为缓解这一问题提供了新的可能。
然而,把 LLM 用于 CASH 还需要解决更复杂的历史组织问题。SVM 的调参记录未必能直接指导 XGBoost;只保留若干高分配置,也难以看出某次调整从何处出发、修改了什么,以及为什么值得继续尝试。

观察 1:LLM 需要与当前算法和优化轨迹相关的经验,才能有效利用有限的上下文。
与此同时,CASH 的探索与利用发生在两个层次:在算法之间,要决定继续投入当前表现较好的模型,还是尝试评估不足的模型;在某个算法内部,要决定细调已有优质配置,还是探索新的参数区域。仅靠逐轮提示 LLM 生成配置,难以显式协调这两层决策。
观察 2:有效的 CASH 搜索需要同时平衡算法之间、算法内部的探索与利用。

进一步看,LLM 的语义先验与 BO 的定量建模各有优势,而不同算法积累数据的速度也不同。只做一次 LLM 热启动,或始终以固定比例调用两类优化器,都难以适应整个优化过程中不断变化的信息。
观察 3:BO 与 LLM 需要共享可持续更新的搜索状态,并根据代理模型的可靠性调整协作方式。
LB-MCTS 框架
围绕这三个观察,我们提出 LB-MCTS:将蒙特卡洛树搜索(MCTS)的树作为共享状态,把算法选择、参数优化和 BO–LLM 协作组织为一条条可追踪的优化轨迹。
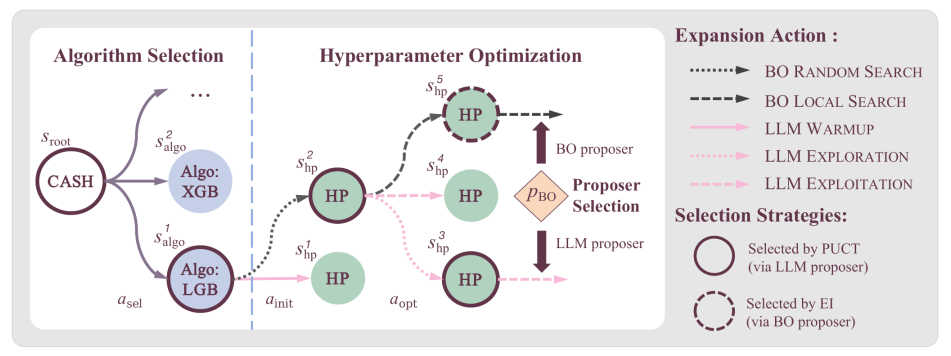
图 1. LB-MCTS 的树结构协同搜索:算法选择与超参数优化共同构成搜索轨迹,BO 和 LLM 的提议统一写入同一棵树。
1. 用树结构组织选模型与调参数
搜索树包含三类节点:根节点表示完整的 CASH 任务;下一层的算法节点分别对应一个候选算法;更深层的超参数节点记录具体配置及其验证性能。从根节点出发的一条路径,就记录了“选择算法—初始化配置—逐步调整参数”的过程。
每轮搜索先通过 PUCT 策略选择一个算法,综合考虑已有表现、改进趋势与探索机会。选定算法后,再由 BO 或 LLM 生成新配置。评估结果沿路径回传,更新节点统计量,引导后续预算分配。这样,算法选择与配置细化便能在同一个搜索过程中相互影响。
2. 让 LLM 读懂参数是怎样一步步改好的
LLM 提议器沿树选择一个基准配置,再结合任务描述、相关历史和本轮搜索指令提出调整。初始化时,LLM 利用先验知识生成起点;进入优化阶段后,Exploitation 指令鼓励局部细调,Exploration 指令鼓励尝试新的区域。
为了组织上下文,LB-MCTS 引入选择性调优记忆(Selective Tuning Memory,STM)。每条经验都包含父配置、子配置、调整前后的性能,以及相关反思,使 LLM 能够同时看到参数改动与对应反馈。
STM 只从当前算法的子树中取用历史,并结合两类记忆:局部记忆保留通向当前配置的祖先路径,说明这一步是如何走到的;全局记忆则综合起点相似度与结果质量,从同一算法的历史尝试中筛选有参考价值的经验。对探索或利用得到的新配置,LLM 还会在评估后分析本次调整的效果,将反思写回节点,供后续搜索使用。
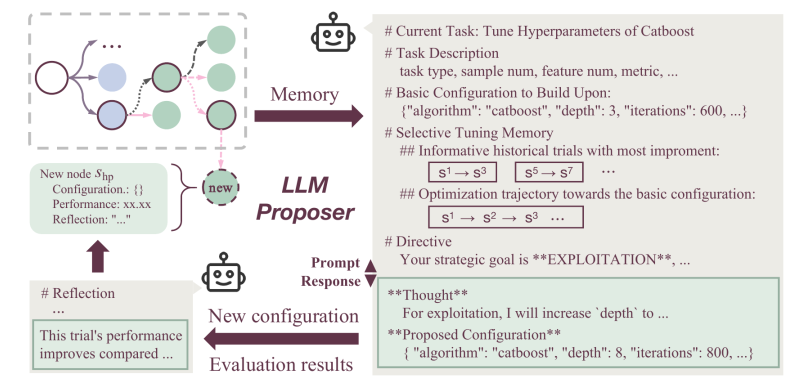
图 2. LLM 提议器的工作流:从共享树中提取轨迹和相关经验,生成新配置,再将评估结果与反思写回树中。
3. 让 BO 与 LLM 接续彼此的优化轨迹
BO 为每个算法维护独立的高斯过程代理模型,在该算法自己的超参数空间中进行定量建模。它同时生成随机候选与局部扰动候选,通过期望改进(EI)选择下一次评估的配置:随机候选开启新的路径,局部候选则接在原配置节点之后。
两类提议器生成的配置都进入共享树。LLM 找到的新配置会成为 BO 的训练观测;BO 产生的参数调整及其结果,也可以作为 STM 中的经验供 LLM 使用。一条优化路径因此能够交替承接语义推理与数值搜索。
至于下一步交给谁,LB-MCTS 会分别检查各算法代理模型的可靠性:通过交叉验证,衡量代理模型能否正确预测配置的性能排序,并据此调整选择 BO 的概率。观测较少时,搜索更多借助 LLM 的先验;随着代理模型更加可靠,BO 承担更多配置提议。
实验结果
我们在 AutoML Benchmark(AMLB)的 104 个数据集上评估 LB-MCTS,其中包括 71 个分类任务和 33 个回归任务。分类与回归分别设置了包含 8 种算法的 CASH 搜索空间,共涉及 45 和 46 个超参数。每种方法均使用 300 次配置评估预算,主实验的 LLM 为 GPT-4o-mini。
对比方法覆盖三类共 8 种基线:BO-based 方法 SMAC、OptDivBO、RB 和 MOSAIC;LLM-based 方法 OPRO 和 LLAMBO;以及混合方法 BOPRO 和 BORA。以下平均排名均以数值越小为优。
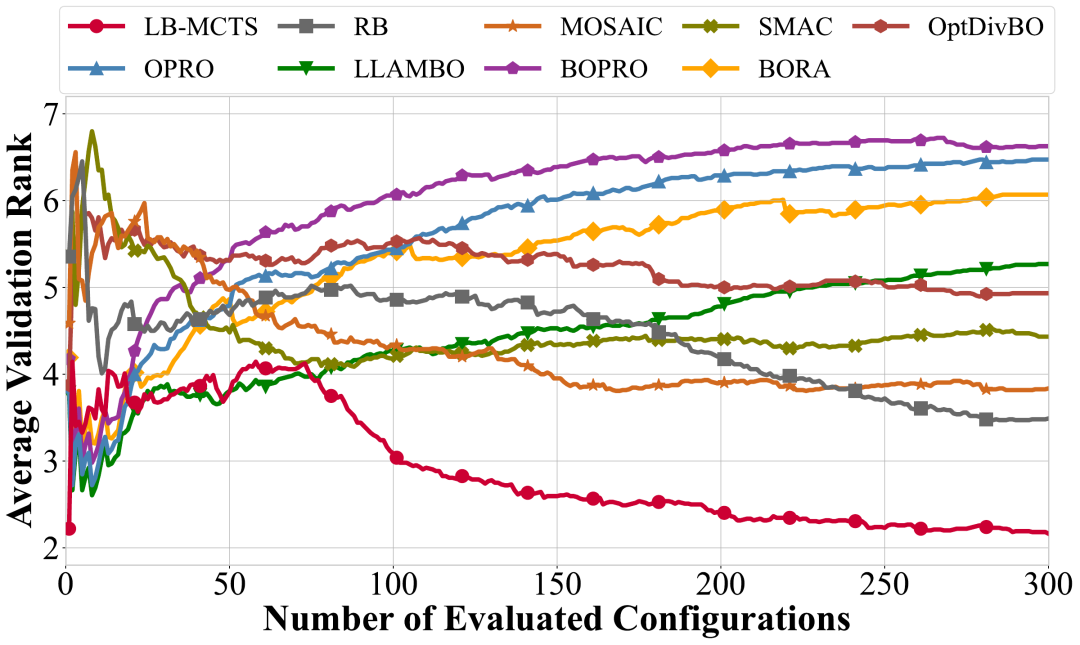
图 3. 9 种方法在 104 个数据集上的平均验证排名。横轴为配置评估次数,纵轴为各方法截至当前找到的最佳验证性能的平均排名,越低越好。
1)主实验获得最佳平均排名。在 300 次评估后,LB-MCTS 的平均验证排名为 2.16,优于第二名 RB 的 3.49。从约 70 次评估开始,LB-MCTS 的平均排名持续领先于全部基线。
2)测试集上保持领先。将各方法根据验证集选出的最佳配置用于独立测试集评估,LB-MCTS 仍获得最佳平均排名 3.05,说明其优势能够延续到未参与配置选择的数据上。
3)消融实验支持树结构与动态协作的作用。在 10 个代表性数据集上,树结构消融中,LB-MCTS 的平均排名为 1.5,移除超参数优化树、仅共享平面历史的 LB-Flat 为 3.4;在另一组提议器协作消融中,动态策略的平均排名为 1.6,优于固定 50:50 调用 BO 与 LLM 的 2.3。
4)LLM 调用成本较低。在论文采用的 GPT-4o-mini 设置及实验时的 API 单价下,每个数据集完成 300 次配置评估的平均 LLM API 费用约为 0.127 美元。该数字仅计 LLM 的输入、输出 token 费用,不包含下游模型训练与评估的算力开销。
案例分析
论文附录展示了 cmc 分类任务上的一次 AdaBoost 调优。当前路径曾同时增大学习率和弱学习器数量,验证表现出现下降;STM 又检索到其他历史尝试,其中包含 BO 和 LLM 分别提出的调整,显示较低学习率与适当模型规模的组合值得继续尝试。
结合这些经验,LLM 将当前配置的 learning_rate 从 0.045 调整为 0.038,将 n_estimators 从 350 调整为 300,并保留 SAMME 与 max_depth = 5。随后,验证集上的平衡准确率从 57.47% 提升至 59.24%,提高约 1.77 个百分点。
这个案例展示了共享轨迹的具体价值:当前路径上的失败记录提供了调整背景,同一算法下的其他尝试提供了参考,而新配置的评估与反思又成为下一步可用的经验。BO 与 LLM 产生的历史由此能够在后续优化中共同发挥作用。
总结
LB-MCTS 用共享的 MCTS 搜索树组织 CASH 优化轨迹,在两个层次上协调探索与利用,通过 STM 为 LLM 提供聚焦于当前算法和路径的经验,并根据代理模型可靠性动态选择 BO 或 LLM。104 个数据集上的实验表明,这种结构化协作能更有效地结合语义先验与定量建模,为复杂 AutoML 搜索提供一条可行路径。
作者: Longzan Luo、Bin Cui、Xupeng Miao
研究解读
研究背景与问题
3D 高斯泼溅(3D Gaussian Splatting,3DGS)通过大量三维高斯表示场景,能够高效合成逼真的新视角图像。随着应用拓展到高分辨率显示、城市级场景和交互式仿真,渲染系统需要处理更多高斯、更高分辨率,以及更加不均匀的计算负载。对于持续 60 Hz 的交互,每帧只有约 16.67 ms 的时间预算;一旦渲染速度跟不上输入速度,待处理帧就可能不断积压,导致交互延迟持续增长。
然而,现有渲染器在不同负载下的性能并不稳定。我们的研究发现,即使保持场景不变,仅调整高斯数量和渲染分辨率,也可能使 FlashGS 与 gsplat 的速度排名发生反转。这说明,高斯数量与分辨率共同决定的负载特征,会直接影响渲染器的性能表现。
长期以来,3DGS 加速研究主要依赖经典的 13 场景基准,其覆盖范围集中,难以充分暴露这种差异。为此,我们构建了包含 72 个独立场景、76 个测试目标的扩展基准,覆盖室内、室外、航拍、水下、驾驶和城市级六类环境。在新增的 63 个测试目标中,gsplat 在 9 个目标上超过 FlashGS,而经典 13 场景中没有出现这一现象。这些反转均发生在图像长边不超过 2K、且高斯数量不少于 50 万的负载区间。
因此,如何根据负载特征组织 GPU 执行,在不同场景规模和分辨率下保持高效渲染,成为提升 3DGS 系统性能的关键问题。
方法
我们提出 PolySplat,一个面向多样化负载的 3DGS 前向光栅化系统。其核心思想是:让任务划分、数据搬运和调度方式适应实际工作量,充分利用 GPU 的并行计算能力。 在保留深度排序与透明度混合流程的基础上,PolySplat 针对线程利用率不足、访存等待和执行尾部负载不均衡三个瓶颈,设计了以下三项优化。
1. 自适应三路分发:提高线程利用率
在预处理阶段,渲染器需要确定每个高斯覆盖哪些图像分块(tile),并生成后续排序使用的键值对。不同高斯覆盖的分块数量差异很大。在论文分析的代表性场景中,约 77.8%–84.8% 的高斯覆盖 2–31 个分块。如果固定为每个高斯分配一个包含 32 个线程的 warp,许多线程就会处于空闲状态。
PolySplat 根据覆盖范围自适应选择执行路径:只覆盖一个分块的高斯走快速路径;覆盖中等数量分块的高斯,将多个高斯的任务展平、组合,分配给 warp 中的线程并行处理;覆盖范围较大的高斯,则使用协同扫描,并在超大覆盖范围下进一步利用线程块内的多个 warp。
这种设计将执行粒度细化到“高斯—分块”任务,兼顾小任务的并行利用率与大任务的处理效率。
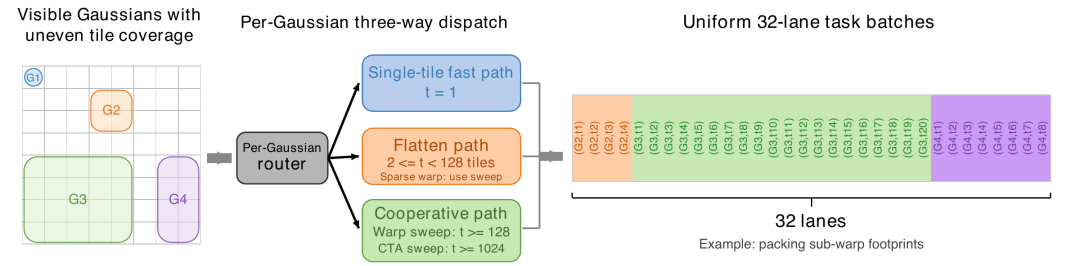
图 1:PolySplat 根据高斯覆盖范围选择执行路径,将多个较小任务组合为 32 线程的处理批次。
2. 异步共享内存暂存:重叠数据搬运与计算
在像素着色阶段,线程需要读取高斯的特征数据。由于这些访问较为分散,直接从全局内存取数会带来明显的等待开销。
PolySplat 采用异步加载与双缓冲流水线:将高斯按每批 32 个组织,在计算当前批次时,把下一批所需数据异步加载到另一块共享内存缓冲区。两块缓冲区交替工作,让数据搬运与像素计算重叠,减少计算单元等待数据的时间。
这一设计还结合了每个线程块一个 warp 的执行配置,在共享内存开销与并行度之间取得平衡,提高渲染阶段的执行效率。
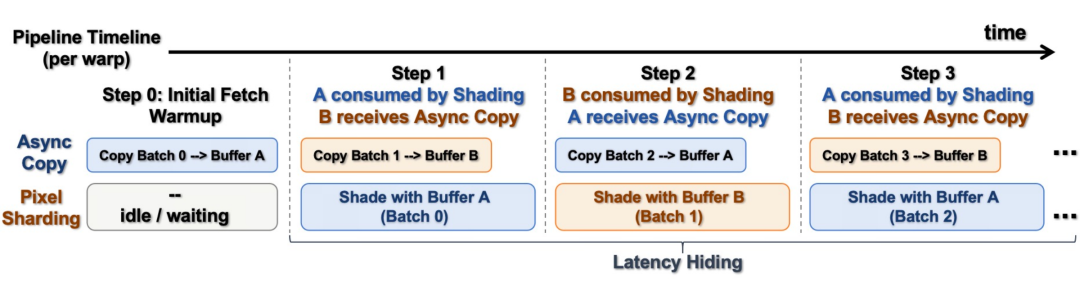
图 2:当前批次的像素着色与下一批次的数据加载并行进行,通过双缓冲减少访存等待。
3. 持久化动态调度:缓解执行尾部的负载不均衡
同一张图像中的不同分块,计算量也可能相差很大。天空和背景区域通常处理较快,而遮挡复杂的区域需要计算更多高斯。采用静态分配时,执行接近结束往往只剩少量重任务,部分 GPU 计算单元因此提前空闲,形成拖慢整帧的“长尾”。
为此,PolySplat 使用持久化线程块与集中式任务队列。线程块完成一个分块后,继续通过全局原子计数器领取下一个任务;系统根据 GPU 的实际驻留能力设置线程块数量,让可用计算资源持续参与工作。
这种动态领取任务的方式减少了反复分发和初始化的开销,也缓解了重任务分布不均造成的尾部等待。
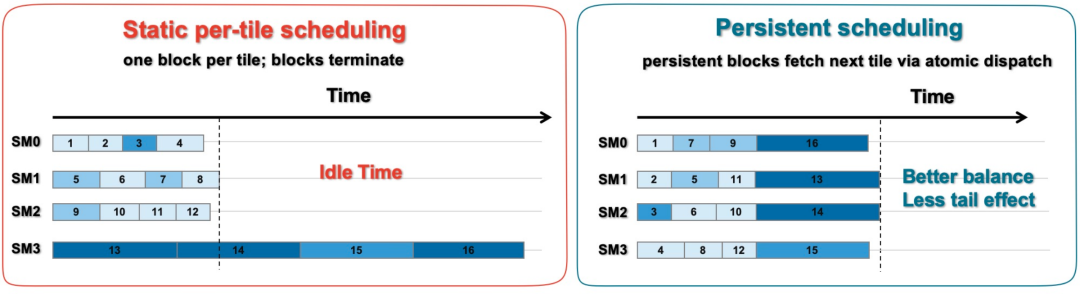
图 3:持久化线程块完成当前任务后继续领取新任务,改善负载均衡,减少执行尾部的空闲时间。
实验结果
我们在扩展基准上进行评估,覆盖 12 个数据集类别、76 个测试目标和 1518 个相机级样本。高斯数量从约 10 万到 5650 万,图像长边从 960 到 9288 像素。所有渲染器使用相同的输入模型、相机参数和渲染分辨率,主要性能实验在单张 NVIDIA H100 80 GB GPU 上完成。
在不同负载下保持加速。按数据集均衡统计的几何平均结果,PolySplat 相比 FlashGS、gsplat、Flash3DGS 和原始 3DGS 渲染器,前向渲染加速比分别达到1.42×、2.47×、5.18× 和 7.87×。其中,PolySplat 在全部 76 个测试目标上均快于 FlashGS,各数据集类别内相对 FlashGS 的平均加速比为 1.21×–1.64×。
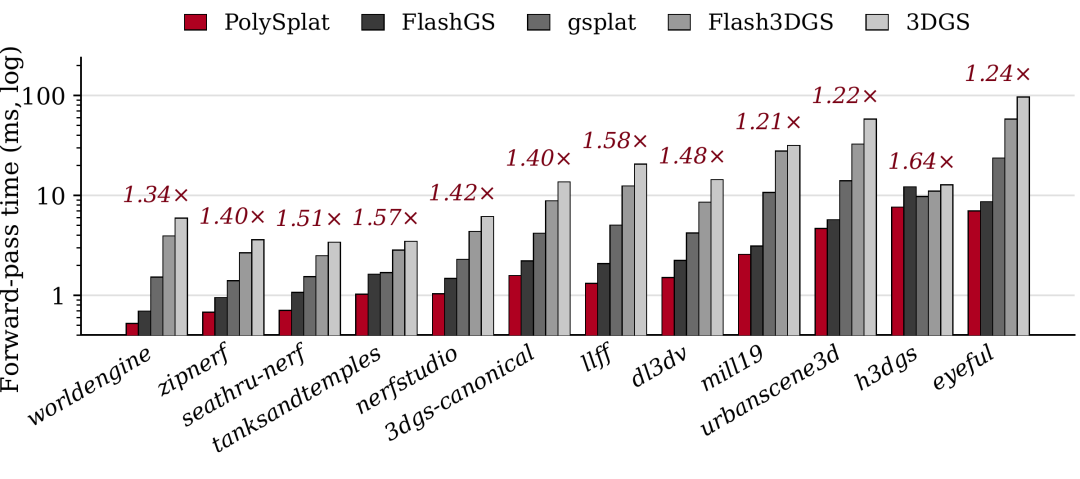
图 4:H100 上各数据集的前向渲染耗时对比,纵轴采用对数刻度,耗时越低越好;红色标注为各数据集内相对 FlashGS 的平均加速比。
1)渲染质量与原始实现相当。在相同基准上,PolySplat 的数据集均衡 PSNR/SSIM 为 24.03 dB/0.7430,原始 3DGS 为 24.04 dB/0.7431。结果表明,PolySplat 在加速前向渲染的同时,保持了与参考实现相当的图像质量。
2)优化效果可迁移到多种 GPU。在 H20、A800、RTX 4090 D 和 A40 上,PolySplat 相对 FlashGS 的几何平均加速比分别为 1.36×、1.34×、1.24× 和 1.18×,表明这些设计在不同 GPU 架构与硬件配置上均能带来收益。
消融实验进一步验证了各组件的作用:相比完整系统,强制采用“每个高斯一个 warp”或统一展平策略,按数据集均衡统计的端到端耗时分别增加 29.52% 和 20.94%;关闭异步共享内存暂存后,耗时增加 50.17%;改回静态分块调度后,耗时平均增加 2.32%,且在 70 个测试目标上变慢。
3)9K 连续轨迹下的实时交互表现。我们还在 Mill19 的 Rubble 场景上,使用包含约 319 万个高斯的模型,以 9216 × 6912 分辨率渲染一段持续 6 秒、包含 360 帧的连续飞行轨迹,并采用严格按序、每帧一个刷新周期截止期限的 60 Hz 队列回放协议评估响应能力。
在该测试中,gsplat 的单帧渲染耗时中位数为 35.37 ms,超过 16.67 ms 的帧预算,导致队列持续积压,有效吞吐率为 28.13 fps,错过截止期限的帧占比为 99.72%。PolySplat 的单帧渲染耗时最高为 11.58 ms,在这一回放协议下维持 60 fps,全部帧均满足截止期限。
这一案例说明,缩短渲染耗时能够帮助系统跨过实时交互所需的性能门槛,避免连续输入下的队列积压。
总结
本文提出了 PolySplat,一个面向多样化负载的 3DGS 前向光栅化系统。通过自适应三路任务分发、异步共享内存暂存和持久化动态调度,PolySplat 提高了 GPU 线程利用率,减少了访存等待,并改善了执行尾部的负载均衡。
实验表明,PolySplat 在覆盖多种场景规模与分辨率的扩展基准上取得稳定加速,保持与参考实现相当的渲染质量,并在指定的 9K 连续轨迹测试中满足 60 Hz 的逐帧截止期限。这项工作也表明,面向实际应用的 3DGS 系统优化,需要同时关注负载覆盖、平均性能和持续交互时的响应能力。
END
欢迎关注本公众号,帮助您更好地了解北京大学数据与智能实验室(PKU-DAIR),第一时间了解PKU-DAIR实验室的最新成果!
实验室简介
北京大学数据与智能实验室(Data And Intelligence Research Lab at Peking Univeristy,PKU-DAIR实验室)由北京大学计算机学院崔斌教授领导,长期从事数据库系统、大数据管理与分析、人工智能等领域的前沿研究,在理论和技术创新以及系统研发上取得多项成果,已在国际顶级学术会议和期刊发表学术论文200余篇,发布多个开源项目。课题组同学曾数十次获得包括CCF优博、ACM中国优博、北大优博、微软学者、苹果奖学金、谷歌奖学金等荣誉。PKU-DAIR实验室持续与工业界展开卓有成效的合作,与腾讯、阿里巴巴、苹果、微软、百度、快手、中兴通讯等多家知名企业开展项目合作和前沿探索,解决实际问题,进行科研成果的转化落地。
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢