

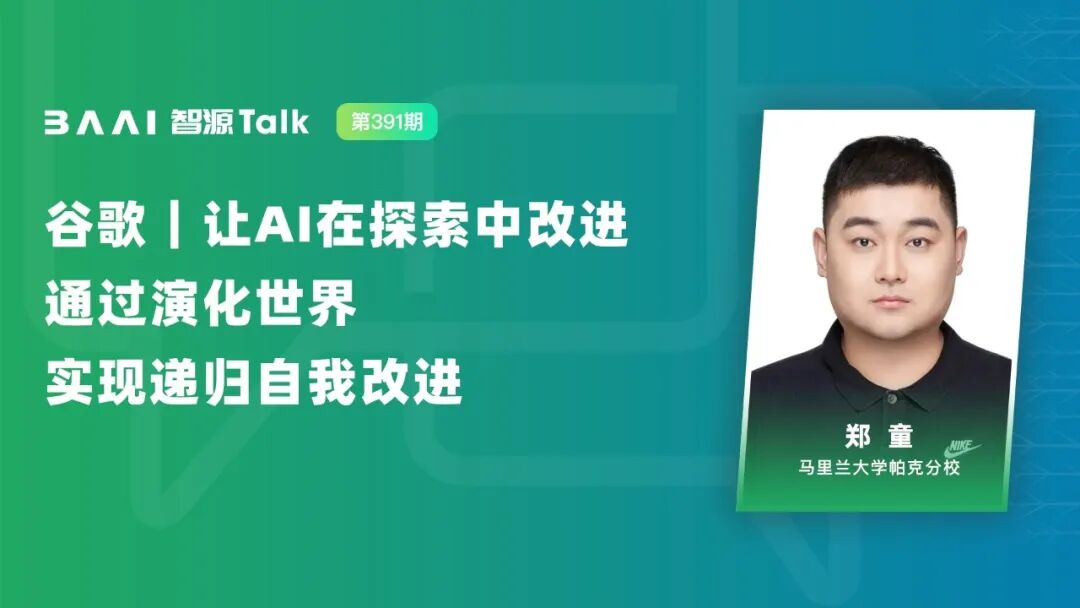
报告主题:
让AI在探索中改进探索 Dream-RSI,通过演化世界实现递归自我改进
报告日期:10月20日 10:30-11:30
递归自我改进(RSI)的一个关键问题是:AI 能否持续改进产生进步的机制本身?随着自主研究走向更复杂、更长程的任务,如何选择探索方向、分配并行资源以及决定何时停止,逐渐成为影响自我改进效率的关键。然而,评估一种探索策略,往往需要经历完整且昂贵的发现过程。改进探索的过程,本身也面临探索成本。
本报告将介绍 Dream-RSI 及其核心观点:探索历史本身可以成为支持自我改进的环境。通过将历史发现树转化为可回放的“世界”,智能体能够在已探索的空间内,以低成本评估和修改可执行的探索策略;改进后的策略再被部署到真实探索中,产生新的历史、扩展回放世界,形成探索策略与经验环境共同演化的递归循环。
结合算法工程、数学优化、GPU 内核工程与智能体 Harness 优化中的实验,本报告将讨论:如何让一次昂贵的探索支持多次低成本的策略改进,以及这种“历史即环境”的视角,为可扩展的 RSI 提供了怎样的实现路径。
报告论文:
论文:https://arxiv.org/abs/2609.17488v1
报告嘉宾:
郑童,马里兰大学帕克分校计算机科学系博士三年级学生,导师为 Brendan Iribe,讲席教授黄恒。主要研究方向为大语言模型推理、测试时扩展与智能体自我改进。以第一或共同第一作者身份在 ICLR、ICML、NeurIPS、ACL、EMNLP 等国际顶级会议发表论文 10 篇,相关 GitHub 项目累计获得约 1,700 个 Star。代表工作包括 Dream-RSI、AutoTTS、Parallel-R1、Parallel-Probe、Mixture-of-Thought 等。曾在 Google 担任学生研究员,并在腾讯 AI Lab(西雅图)担任研究实习生。个人主页:https://zhengkid.github.io/
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢