

近年来,人工智能 (AI) 的发展主要得益于大型语言模型,即基于称为“词元”的离散单元运行的深度神经网络。为了表示文本,大多数大型语言模型使用单词或词片段作为词元,这被称为子词分词。子词分词会掩盖细粒度信息,这尤其对于科学数据(例如计算机代码或生物序列)而言是个问题,因为这些数据的含义取决于单个字符或字节。直接对文本进行字节编码的模型可以避免这些限制,但迄今为止,它们的性能仍落后于基于子词的模型。本文提出了一种通过字节化创建字节级大型语言模型的通用方法,该方法能够接近基于子词的系统的性能。我们使用两阶段转换过程,只需极少的额外训练即可将现有的基于子词的模型改造为字节级模型。由此产生的模型优于以往的字节级方法,并在字符级推理任务中表现出色,通过高效处理字节级信息实现了实用的推理速度,并通过重用围绕源大型语言模型的现有生态系统实现了良好的适应性。我们的研究成果打破了端到端字节级语言建模长期以来面临的性能瓶颈,证明基于原始文本编码的模型可以实现具有竞争力的扩展性,并在需要细粒度文本理解的领域展现出优势。
论文:Retrofitting language models to operate over bytes
单位:Allen Institute for AI、剑桥大学、华盛顿大学、帝国理工、LMU Munich 与慕尼黑机器学习中心
发布日期:2026年
https://t.zsxq.com/RFryK
请索引第129篇论文
 |  |
给大模型做一次"字节级整容",只用不到 1% 的预训练预算
先讲一件小事。
你一定见过那个流传很广的问题:strawberry 里有几个 r?不少顶级大模型会一本正经地回答"两个"。这不是模型不会数数,而是它压根没"看见"字母——在它眼里,strawberry 很可能是一个或两个不可分割的 token,字母信息在输入模型之前就被切掉了。这篇 Nature 论文想解决的,正是这个藏在最底层的"地基问题":当代大模型其实并不端到端,它们看世界的第一道关口,是分词器(tokenizer)。
而这篇论文给出了一条非常"工程智慧"的路线:别再从头训练一个字节级大模型了,把现成的 subword 大模型"改装"成字节级就好。作者给这个改装过程起了个名字,叫 byteification(字节化改造)。他们用不到典型预训练预算 1% 的算力(总计 49.1B tokens),把 Olmo 3 7B、Qwen3 8B、Llama 3 8B 改造成了 Bolmo 7B、Bwen 8B、Blama 8B,性能逼近甚至在某些维度超过原模型,同时把此前所有同规模字节级模型远远甩在身后。
对做 AI+交叉学科的我们来说,这篇论文的价值远不止"又刷了一个榜"。它示范了一种极低成本的范式迁移方法:当你发现一个领域的底层表示(representation)有问题时,不一定要推倒重来,而可以设计一套"先精确复刻、再自由超越"的两阶段改造流程。这套方法论,几乎可以原样搬到序列科学、图学习、多模态等任何一个"表示层还在将就用 2019 年方案"的方向上去。
下面,我们把这篇论文拆开揉碎地讲一遍。
一、分词器到底偷走了什么
当代绝大多数大模型用的是 subword tokenization(子词分词):把文本切成词或词的一部分,映射到一个 3 万到 30 万规模的固定词表上。这个方案自 BPE 时代沿用至今,便宜、好用、几乎没人质疑。但它带来的代价,论文归纳得非常清楚,我按"对科研最要命"的顺序重排一下。
第一,字符级信息被抹掉。模型看不到 token 内部的字母,于是拼写、反转、按位替换这类任务就靠"隐式猜"。代码、DNA 序列、蛋白质序列、化学 SMILES、材料晶体文件这些"多一个字符就换一个意思"的科学数据,天生吃亏——已有研究明确显示,基因组分词器的选择会显著影响基因组语言模型的表现。
第二,分词带偏见(tokenization bias)。subword 分词会隐式利用"未来的字符"来决定边界,于是 prompt 结尾多一个空格、或者在单词中间截断,模型的输出分布就会莫名其妙地漂移。你可以把它理解成:模型看到的不是你说的句子,而是分词器"脑补"之后的句子。
第三,英语中心主义。固定词表是在以英语为主的语料上训练出来的,非英语、低资源语言、小语种文字常常被切成一长串昂贵的碎片,同样的意思要花几倍 token。这不是模型歧视,是词表歧视。
第四,算力分配被绑死。标准 LLM 对每个 token 一视同仁:同样的 FLOPs、同样的 KV cache 占用、同样一步一步地生成。可信息密度在文本里是极不均匀的——"的"和"deoxyribonucleic"显然不该花同样的算力。
字节级模型(byte-level LLM)理论上能一次性解决这四个问题:直接用 UTF-8 字节,词表只有 256 个,字符全在,没有分词器偏见,还能按信息密度动态分配算力。听起来完美。可现实是:至今所有头部大模型,没有一个用字节级。
二、造新脑,还是换感官
论文的诊断非常尖锐,值得每一位做"新架构"的研究者贴在墙上。
过去所有字节级模型的评估范式是:我从随机初始化训一个字节级模型 A,你从随机初始化训一个 subword 模型 B,然后比谁好。这看起来公平,实际上是个移动的靶子——因为工业界最强的 subword 大模型,其训练配方(数据清洗、架构、后训练、RL)每个月都在进化。字节级研究如果每次都要"从零追平 SOTA",那就永远在追赶,永远差一个数量级的算力投入。
作者的判断是:字节级模型没被广泛采用,不是因为路线错,而是因为研发成本结构不可持续。
于是他们换了个问题:能不能不重新造一个大脑,而是给已经很强的大脑换一套"感官"?
这就是 byteification。它建立在"latent tokenizer language model(LTLM,隐分词语言模型)"这一族架构之上(DTP、BLT、H-Net 都是其代表):字节先进一个轻量的 local encoder,被聚合成若干 patch,patch 序列送进一个很深的 global model(就是原来那个大模型的 transformer),再 depool 回字节,最后用 local decoder 预测下一个字节。
关键点在于:global model 直接复用原模型。也就是说,那个在数万亿 token 上训练出来的"知识主体"被完整保留,只需要新学一套"字节↔patch"的编解码接口。这就是为什么总预算能压到 49.1B tokens——不到典型预训练的 1%。
我用一句有点糙的话总结这个思路转变:前人想的是"重新进化出眼睛",作者想的是"给现成的老虎换个角膜"。 前者要几亿年,后者一台手术。
三、方案:两阶段,先把老师"复制"一遍
Byteification 分成两个阶段,设计得非常讲究。
Stage 1(蒸馏复刻阶段):global model 从原 subword 模型初始化并冻结,只训练 local encoder、local decoder、boundary predictor 和 language-modelling head。目标不是"把任务做好",而是精确复刻源模型的行为——论文的措辞是"loss 最小当且仅当字节级模型与源 subword 模型行为完全一致"。这个阶段用了 9.8B tokens(约 43B bytes)。
这一阶段的损失由三块拼成,每一块都有巧思。
边界预测损失:用二分类交叉熵,让边界预测器去模仿 subword 分词器切出的边界。因为允许看 1 个未来字节,这个预测器很快就能达到 99% 以上的准确率。
local encoder 损失:这一块最能体现作者的功力。直觉的做法是"让我 pooling 出来的 patch 表示,直接 L2 逼近对应的 subword embedding"(H-Net 就是这么做的)。但作者引用了 model stitching(模型缝合)的研究:表示相似,不等于过几层之后行为还相似。所以他们把 pooled 表示往前传 n 层 global model,再去逼近"subword embedding 传过同样 n 层之后"的表示。实验发现 n=4 是性价比甜点——比 n=0 好得多,又不需要反向传播整个大模型,因此 stage 1 单步非常快。
local decoder 损失:目标是让字节级模型对每段文本赋予的似然与源模型完全一致。这里有个精妙的技术细节——因为 subword 模型在生成时其实隐式地预测了"token 边界",而字节模型如果不显式预测边界,两者的 patch 似然就不可比、只能近似。作者的架构恰好显式预测边界,于是这个目标变成了精确的(论文在补充材料里给了证明)。比较函数用的是温度为 5 的温度调制二元交叉熵。
Stage 2(端到端阶段):解冻所有参数,包括 global model,只保留边界损失和交叉熵损失,再用 39.3B tokens(约 173B bytes)训练。此时模型才真正开始"利用字节级信息",而不是模仿老师。文中那个可选操作——提高每个 patch 的平均字节数(压缩比)——也在这个阶段引入。
这个两阶段设计的哲学,我认为是整篇论文最值得抄走的部分:先构造一个"精确可控的初始点",再放开让它超越。 它把"能不能复刻"和"能不能超越"两个问题解耦了。而且 stage 1 极其便宜,于是架构搜索有了快速反馈回路:如果某个 local encoder/decoder 架构在 stage 1 之后连"模仿老师"都做不到,那就不用浪费 stage 2 的钱了。
论文用图4专门做了消融,验证 stage 1 到底值不值。
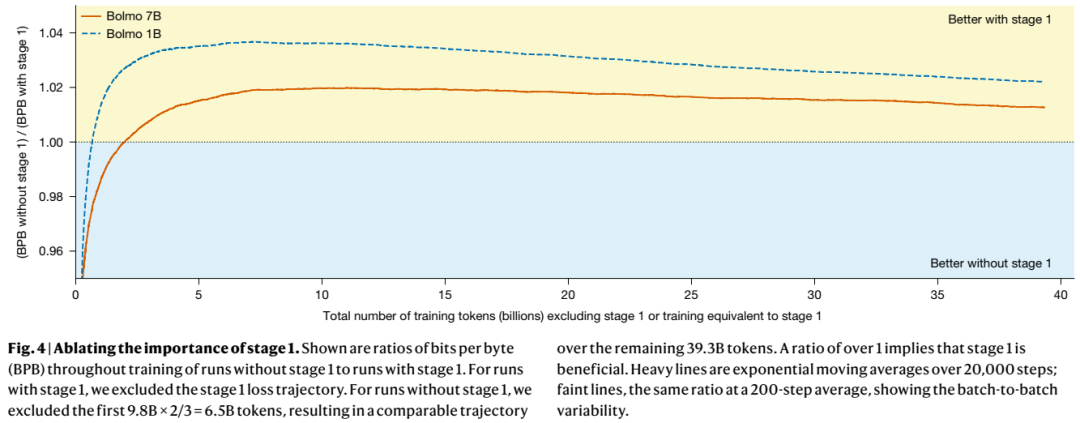
读这张图要抓两点。第一,整条曲线始终在 1 之上,说明即便把算力对齐(作者给"无 stage 1"那组多补了 9.8B × 2/3 = 6.5B tokens,把 stage 2 拉长 17%),加 stage 1 依然更省。第二,1B 模型受益明显大于 7B 模型——作者据此推测,更大的模型对"直接端到端训"导致的灾难性遗忘更鲁棒。换句话说:stage 1 是一份"规模越小越值钱"的保险。作者也诚实地说,随着 token 预算继续增大,stage 1 的重要性可能下降。
四、架构上最关键的一步:非因果边界预测
现在讲全文我最喜欢的一段推理,它短小、反直觉,而且漂亮。
此前所有 LTLM 的边界预测器都是因果的:只看过去,决定现在这个字节后面要不要切一刀。理由看起来天经地义——我们在做自回归预测下一个字节,怎么能看到未来?
作者说:等等,subword 分词器本身就不是因果的。
举个论文里的例子。文本是 _Hello_Wor!,分词结果通常是 {_Hello, _Wor, !},在位置 i(即 r 后面)有边界。文本换成 _Hello_World!,分词结果是 {_Hello, _World, !},同一个位置 i 就不再有边界了。可是这两个字符串在 i 之前是完全一样的!也就是说:subword 分词器偷偷用了未来信息来决定边界。subword LLM 在 token 序列上是因果的,但 token 序列本身的构造是非因果的。
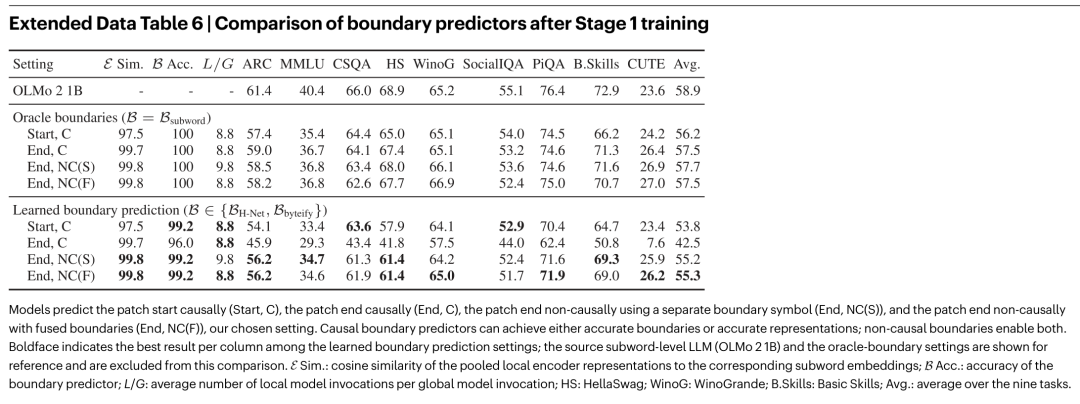
于是出现了一个"表达力错配":LTLM 的边界预测器只能因果,而它想模仿的 subword 分词器是非因果的。以前的工作只能二选一——要么边界准、要么表示准(扩展数据表6里给了这个撕裂的实证)。
作者的修法极简:让边界预测器多看1 个未来字节。形式化地,用当前字节表示与下一个字节表示的投影之间的余弦距离作为边界分数(学习的投影矩阵 Wq、Wk)。实验发现,1 字节的前瞻就足够复现 subword 分词的行为了。
论文里那个复合词的例子特别有画面感:面对 the flowerbed,边界预测器有三个选项——整词一个 patch(flowerbed)、在 r 后切(flower)、在 b 后切(flowerb)。直觉上第二个最符合语义。但因果预测器做不到,因为它必须对所有以 the flower 开头的文本(包括 the flowers)都切在 r 后;非因果预测器则能看到后面是什么,从容调整。
那解码时怎么办?解码阶段当然没有未来字节。作者的解法是往词表里加一个特殊符号 <b>,让 local decoder 在解码时学会自己发出"边界"(local encoder 从不看 <b>)。这与 subword 模型的行为恰好同构:prefill 时用外部分词器非因果地切分,解码时则一边生成内容一边隐式地生成边界。
顺带一个很聪明的小工程:如果 <b> 是独立符号,local decoder 就要多处理 k 个位置,既慢又不好和别的模型公平比较。作者于是把字节词表从 256 翻倍到 512——每个字节都有"普通版"和"带边界版"两个副本。这样一来模型重新变成各向同性的,唯一开销只是 softmax 从 256 类变成 512 类,可以忽略;而 top_p 之类的采样算法直接在 512 类的合并词表上跑。
扩展数据表6给出了这四种边界预测方案的直接对比(Start 因果 / End 因果 / End 非因果独立符号 / End 非因果融合符号),结论一句话:因果预测器只能在"边界准"和"表示准"之间二选一,非因果融合方案两者兼得。
五、整体架构长什么样
把上面这些东西组装起来,就是图1。建议读者对着这张图把前两节再顺一遍,它是全文的骨架。
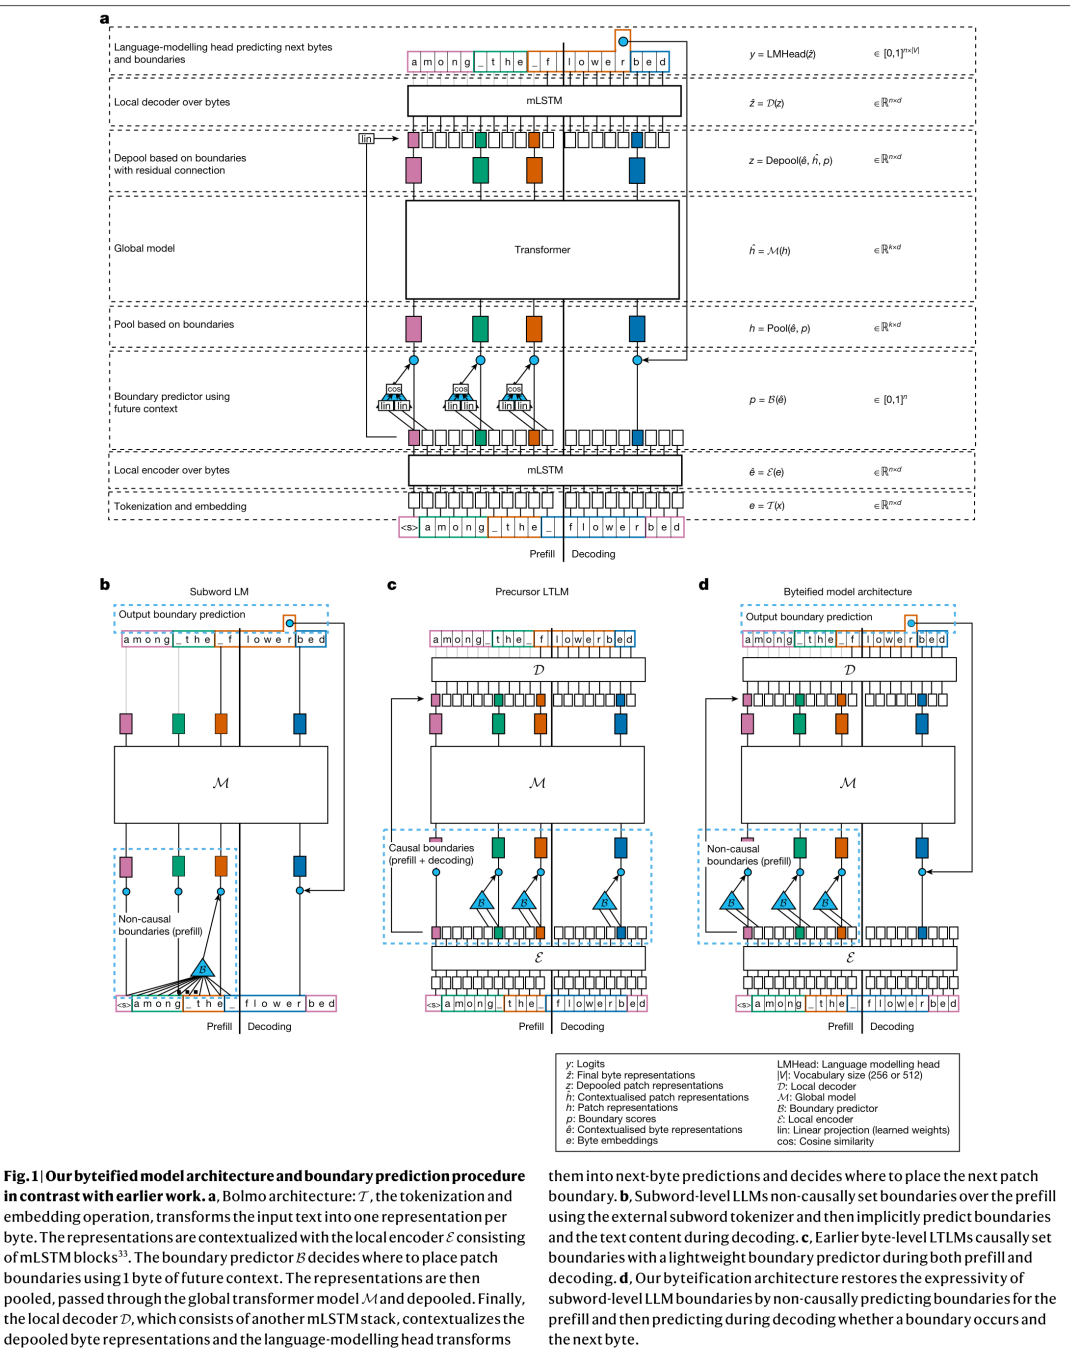
图中信息密度很高,我补充几个正文里容易滑过去的细节。
字节嵌入不是简单地查一张 256 行的表。作者把以当前字节结尾的最长 subword token 的 embedding 残差加到字节嵌入上(称之为 SubwordSuffix 嵌入)。这相当于把原来那张巨大的 subword embedding 表以稀疏激活的方式"废物利用":既增加了廉价参数,又让 local encoder 只需要一层 mLSTM 就够用。作者说这不是必需的(加大 local encoder 也能达到同样性能),但这样做性能/效率比更好。
Pooling 取每个 patch 最后一个字节的表示,不引入任何参数;Depooling 则是把"当前可用的最新 patch 表示"加到字节表示的线性投影上。注意作者特意让 local 与 global 使用相同的表示维度,省掉了 H-Net 里的 up-projection——因为他们发现这个小投影会限制表示的秩,成为瓶颈。
local encoder 用 1 层 mLSTM,local decoder 用 4 层 mLSTM(解码器没法"白嫖"输出 embedding 矩阵,所以要多给点容量)。选 mLSTM 而非其它线性 RNN,是因为它在实验中保持了高吞吐。
参数量的变化很有意思:Bolmo 7B 比 Olmo 3 7B 多约 3.3 亿参数(+4.5%),Bwen 8B 比 Qwen3 8B 多 1.5%,Blama 8B 多 2.7%,而 Bolmo 1B 反而比 OLMo 2 1B 少了约 1000 万参数(-0.7%)——因为 subword 模型那张巨大的输出 embedding 矩阵被移除了,新加的 local 模块不一定补得上这个缺口。
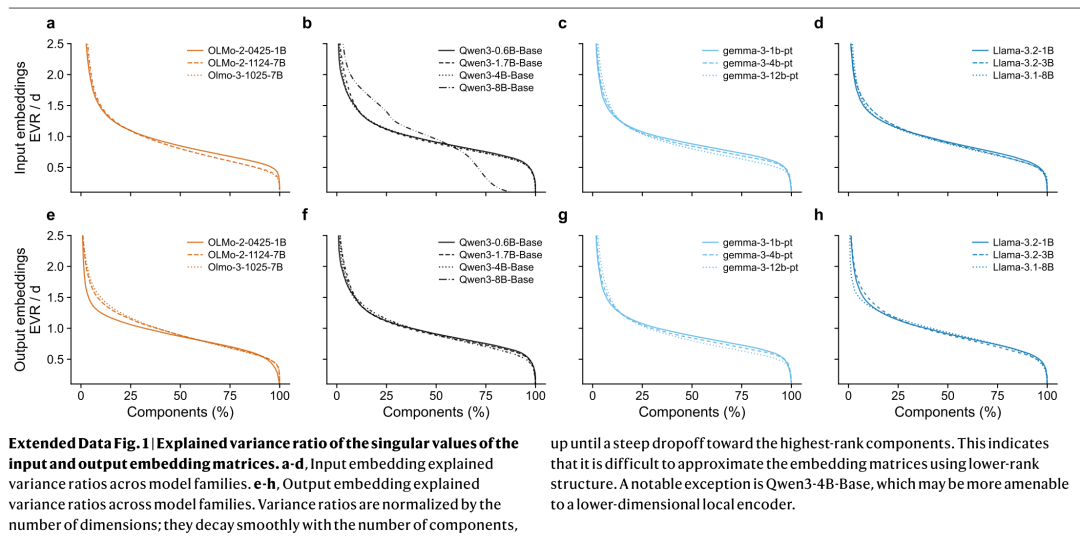
为什么 local 模型要"浅而宽"?证据在扩展数据图1:作者统计了各模型输入/输出 embedding 矩阵奇异值的解释方差比,发现曲线衰减非常平缓,直到最高秩分量附近才陡降——这说明 embedding 矩阵很难用低秩结构逼近。想用低维 local encoder 去模拟它?省省吧。唯一的例外是 Qwen3-4B-Base,它似乎更容忍低维 local encoder。
六、结果:哪些数字该欢呼,哪些该警惕
现在看主表(表1,分两页)。这张表值得花十分钟逐行读,因为它同时包含了"好消息"和"不那么好的消息",而后者往往被解读文章略过。
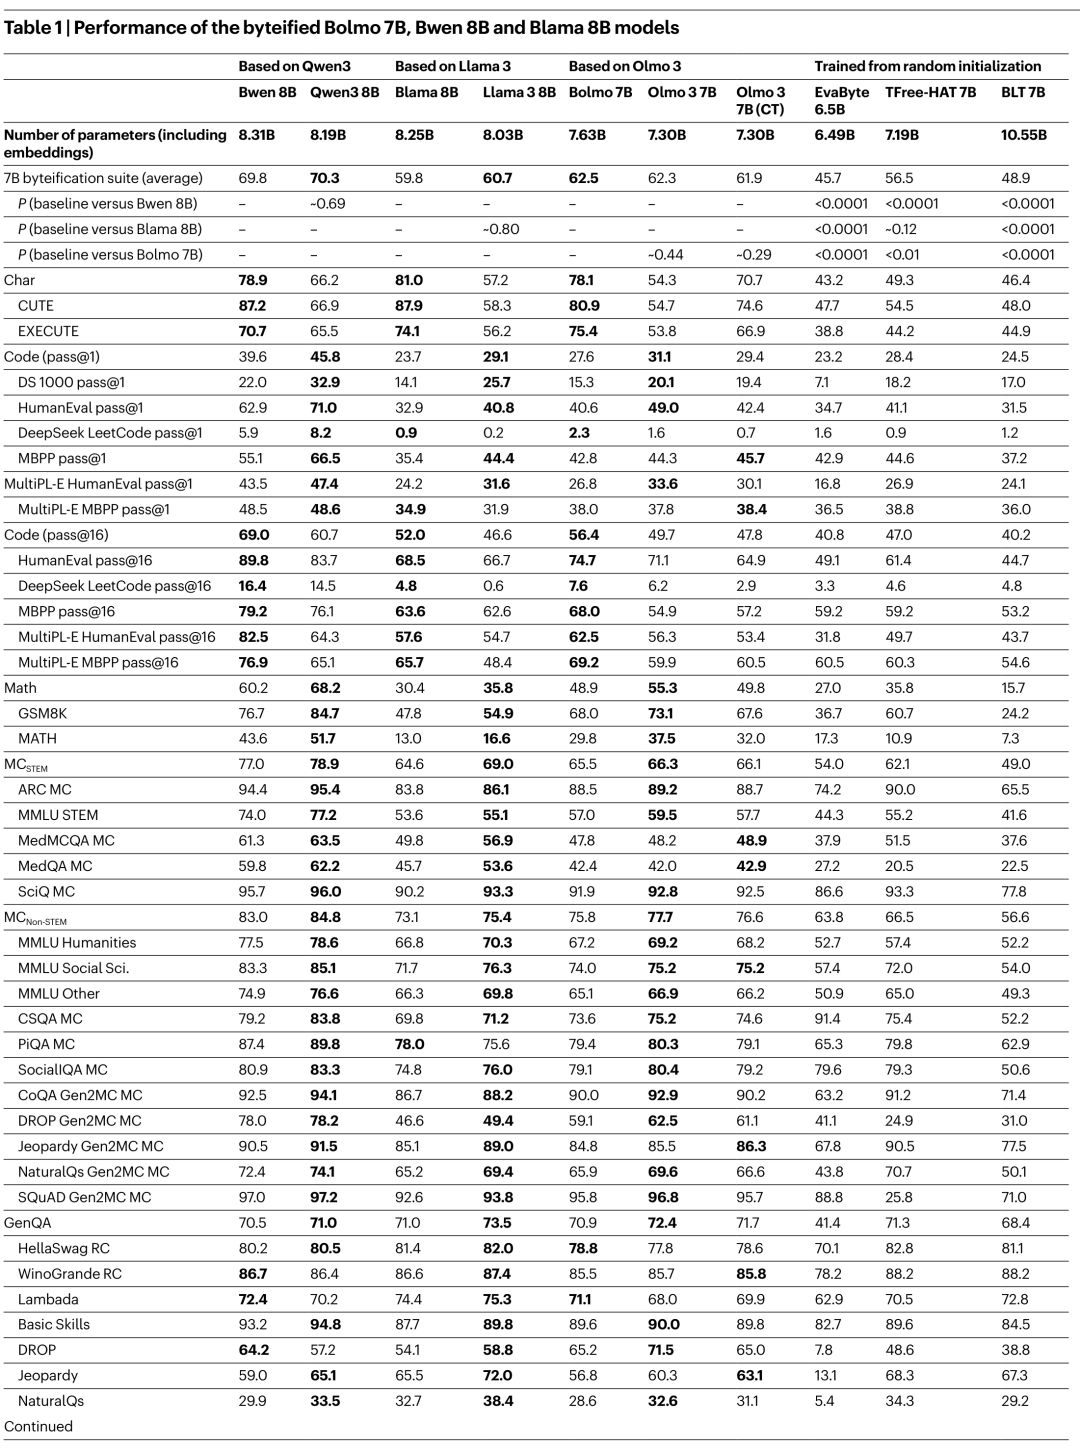
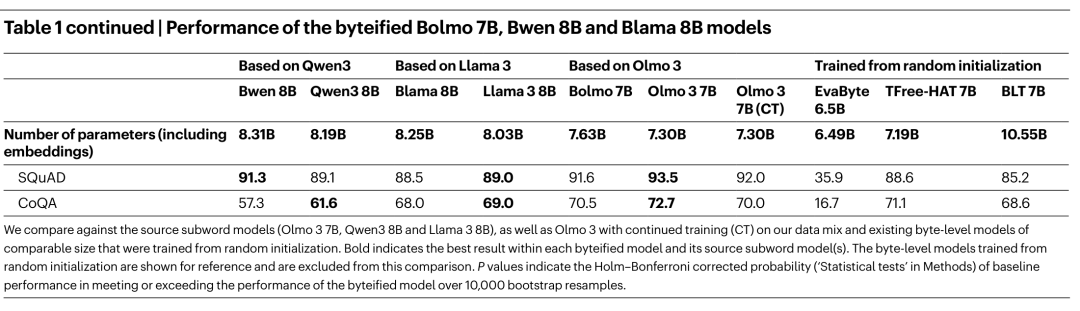
先看最大的结论。 在 7B 评测套件(40 个任务)的平均分上,Bolmo 7B 拿到 62.5,源模型 Olmo 3 7B 是 62.3——略微反超;Bwen 8B 69.8 对 Qwen3 8B 70.3,Blama 8B 59.8 对 Llama 3 8B 60.7,都是极小的差距(bootstrap 检验的 P 值分别约 0.44 和 0.80,统计上不可区分)。与此同时,从零训练的字节级模型被远远甩开:EvaByte 6.5B 只有 45.7,BLT 7B 48.9,TFree-HAT 7B 56.5。作者重点强调的 STEM 类,Bolmo 7B 是 65.5 对 BLT 7B 的 49.0,绝对提升 +16.5 个百分点。
再看真正的杀手锏:字符级理解。 Bolmo 7B 的 Char 大类从 Olmo 3 的 54.3 跳到 78.1,其中 CUTE 从 54.7 到 80.9,多语言 EXECUTE 从 53.8 到 75.4。Bwen 8B 的 Char 从 66.2 到 78.9,Blama 8B 从 57.2 到 81.0。这是本篇最硬的提升,也是字节级路线的立身之本。
但作者在这里做了一个很关键的诚实处理:他们加了一个对照模型 Olmo 3 7B (CT),即在同样的数据混合上继续训练的 subword 模型。对比 CT 与 Bolmo 可以发现:字符理解的提升有一部分来自数据(他们造了约 7500 万 token 的 CUTE 风格合成数据,占训练数据约 0.04%,且只用英文),但架构贡献依然是正的——CT 的字符分数只到 70.7,比 Bolmo 的 78.1 低一截。
然后看代价。 这一栏千万别跳过:
代码 pass@1 是下降的。Bolmo 27.6 对 Olmo 3 的 31.1,Bwen 39.6 对 Qwen3 的 45.8。数学下降更明显:Bolmo 48.9 对 55.3,Bwen 60.2 对 68.2(GSM8K 从 73.1 掉到 68.0,MATH 从 37.5 掉到 29.8)。
但代码 pass@16 反而上升:Bolmo 56.4 对 49.7,Bwen 69.0 对 60.7。作者的解释是:在同样的采样设置(temperature=0.6、top_p=0.6)下,字节级模型生成了更多样的续写。他们也很克制地补了一句——要断言"字节级模型更适合多样性生成",必须把质量-多样性帕累托前沿画出来,因为采样超参对字节模型和 subword 模型的作用可能本就不同。这种"不把观察到的现象直接写成结论"的写法,是值得学习的论文写作范例。
1B 规模上(扩展数据表3)趋势一致:Bolmo 1B 在同规模字节级模型中同样领先,源 subword 模型仅作参考。
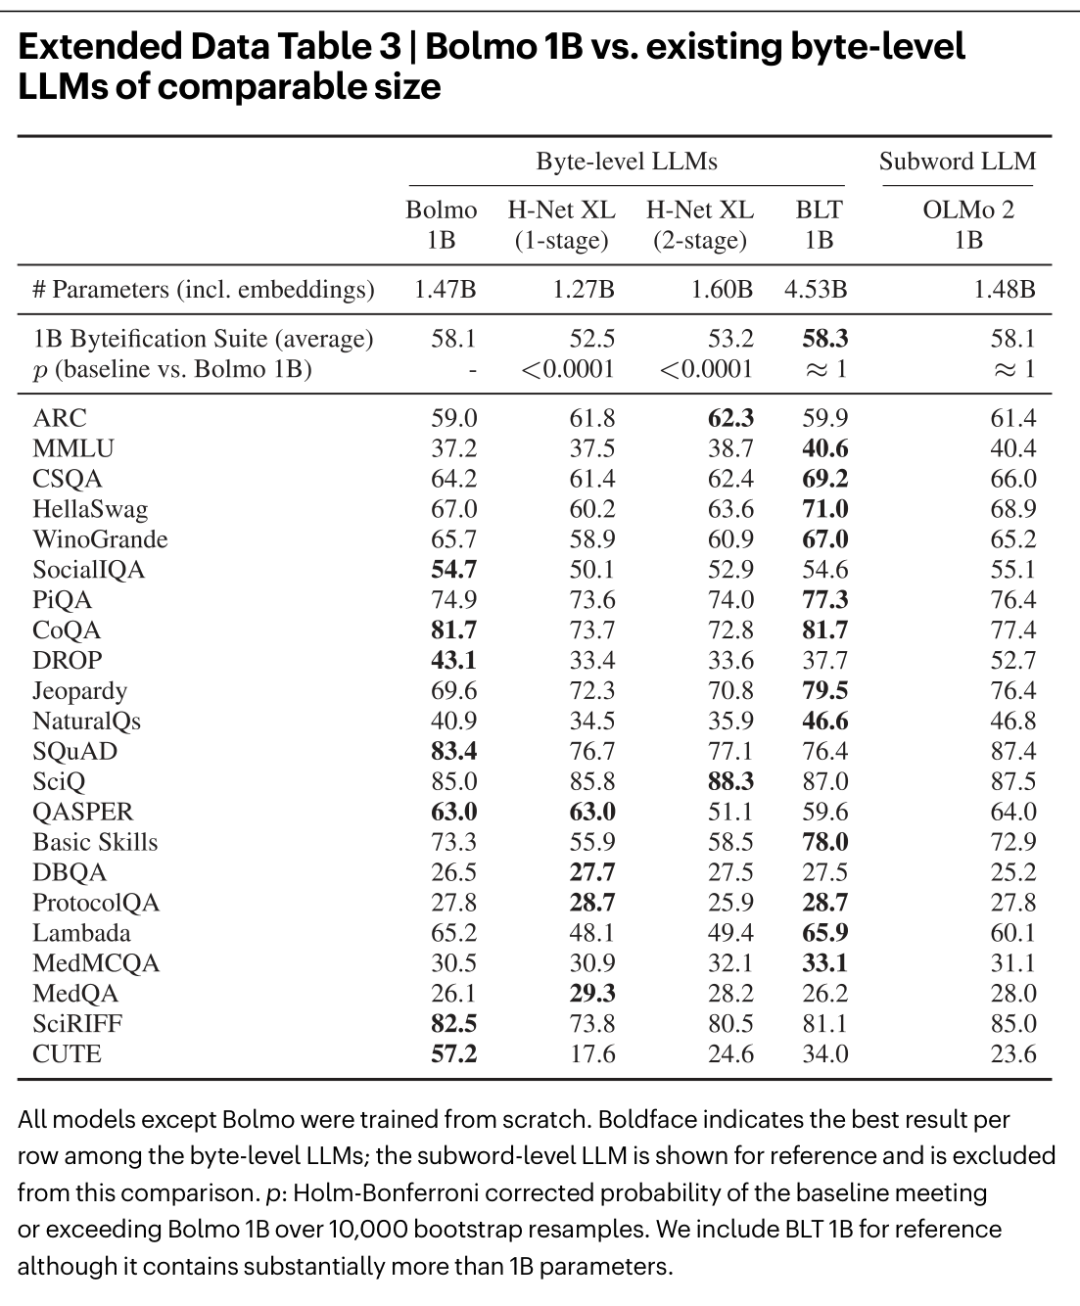
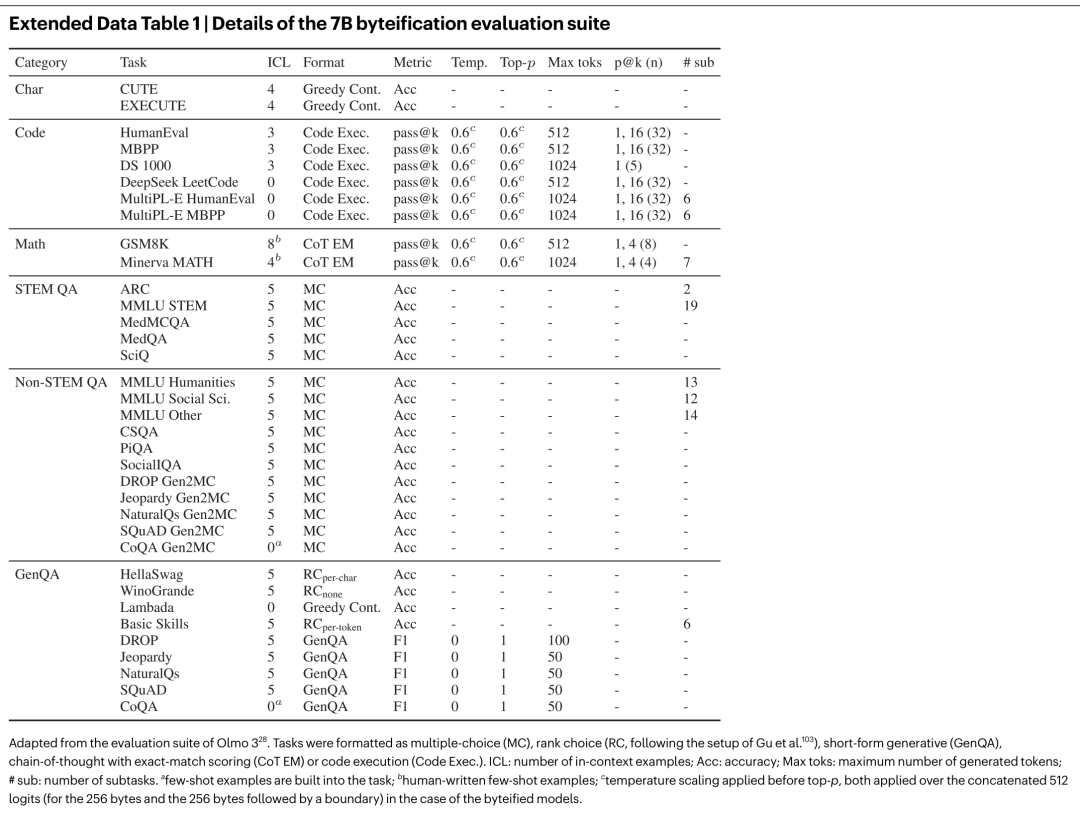
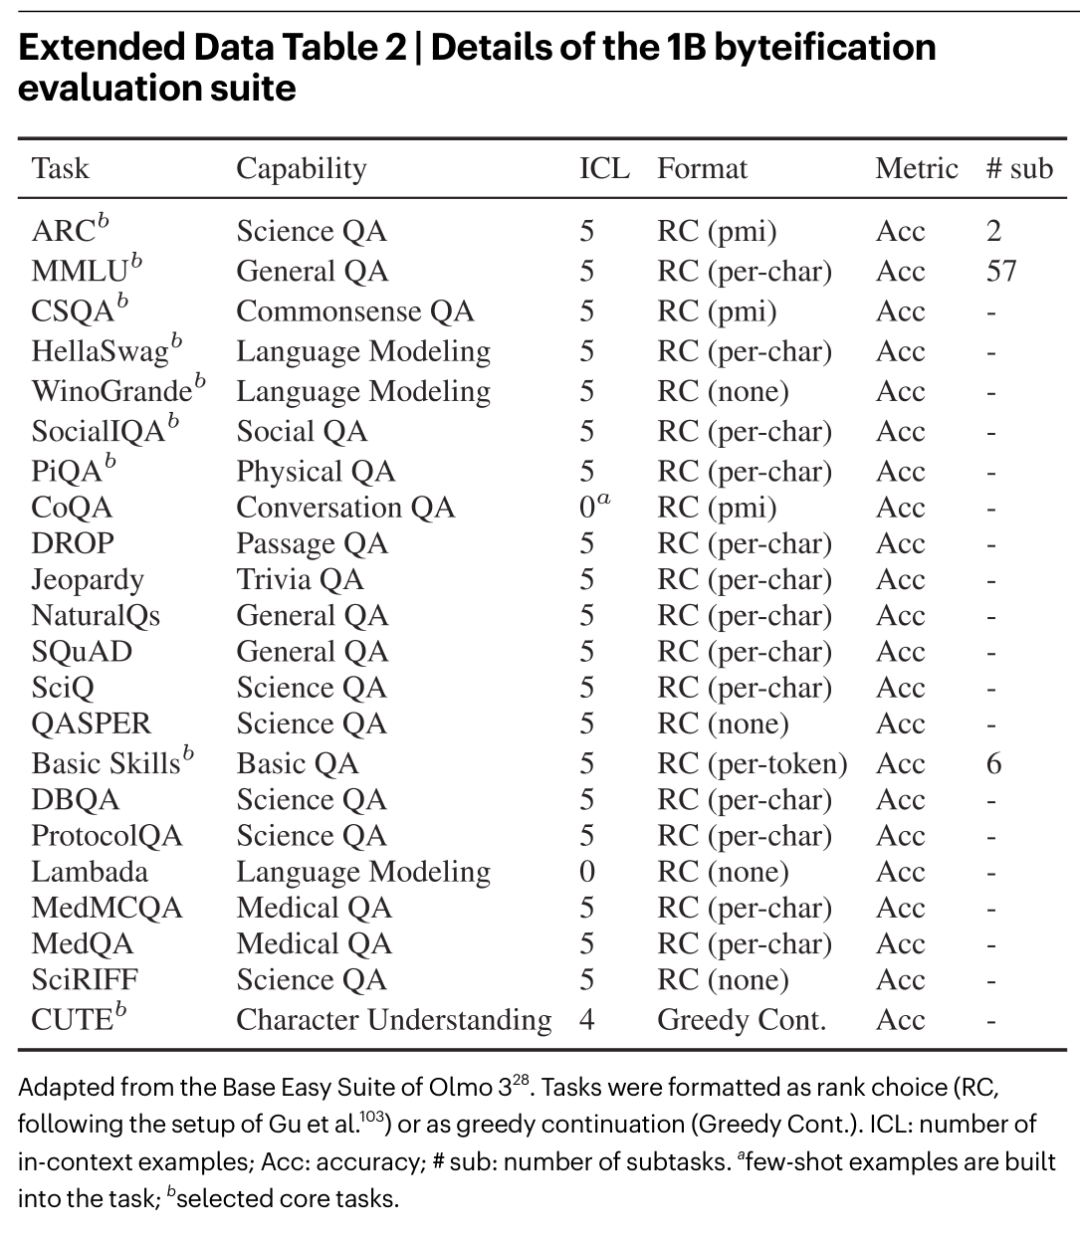
顺带说一句评测的严谨度。作者为 7B 套件准备了 40 个任务、1B 套件 22 个任务(细节见扩展数据表1、2),并用 10,000 次 bootstrap 重采样加 Holm–Bonferroni 多重比较校正来报 P 值。字节级模型的采样还有个细节:温度缩放与 top-p 都作用在拼接后的 512 维 logits(256 个字节 + 256 个"字节+边界")之上。这些细节是复现时最容易踩坑的地方。
七、效率:字节级模型终于跑赢了,但要越过一个临界点
字节级模型一直被诟病"序列变长就变慢"。LTLM 的一个独特优势是:patch 不受固定词表限制,可以任意调粗。于是作者问:能不能靠提高"每 patch 字节数"来换速度?
他们试了三种合并策略:BPE 式合并(在每个样本内迭代合并最常见的 token 对)、基于熵的合并、基于交叉熵的合并。后两者需要一个 3.7 亿参数的辅助 subword 模型来算 next-token 熵——但只在训练时用于监督边界预测,推理时不需要(这一点比 BLT 更省)。
对照组是给 subword 模型做 tokenizer transfer 到 SuperBPE(词表 200k、400k),用 FOCUS 初始化新 token 的嵌入。
结果在图2。
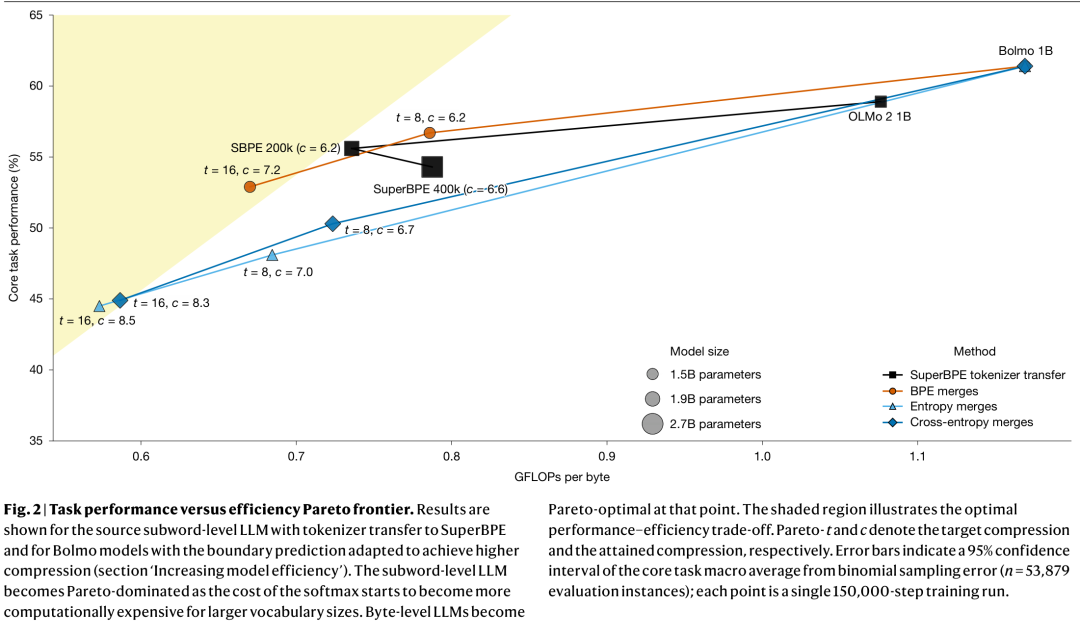
读图要点有三个。
其一,SuperBPE 迁移确实能加速 subword 模型,但存在一个词表规模阈值——一旦超过,softmax 本身变得太贵,subword 模型就被帕累托支配了。对 OLMo 2 1B 而言,这个阈值落在 20 万到 40 万词表之间。论文指出,虽然 softmax 分解(hierarchical softmax 一类)理论上能绕开,但它会带来收敛变慢与训练不稳定,还得重做嵌入初始化——工程上并不划算。
其二,字节级模型没有 softmax 瓶颈。词表永远是 256(或 512),所以压缩比可以一路往上推,换来一条"性能平滑下降、效率持续上升"的曲线。这就是图中字节级模型在高速区成为帕累托最优的原因。
其三,也是最反直觉的一点:BPE 合并策略优于基于熵和交叉熵的合并,与 BLT 等前代工作的结论相反。作者的解释很妙——BPE 为达到任一目标压缩比所需的"不同合并操作"最少,因此在某种意义上最接近预训练模型原本的分词习惯,扰动最小。这是一条只可能在"改装"(而非从零训练)场景下发现的规律,也从侧面印证了整篇论文的方法论立场。
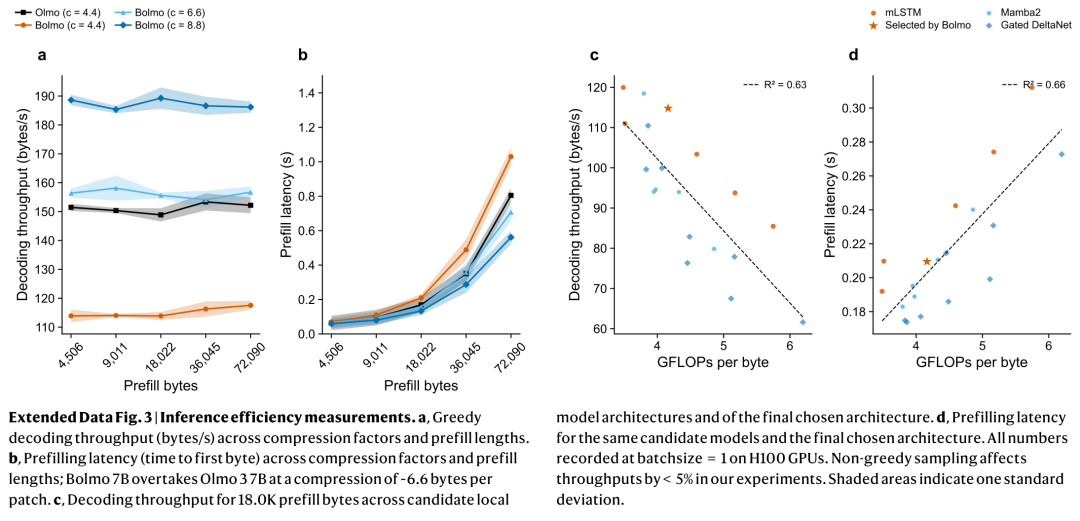
实际的推理速度见扩展数据图3:在 H100、batch size = 1 的条件下测了贪婪解码吞吐与 prefill 延迟,结果是 Bolmo 7B 在压缩比约 6.6 字节/patch 时反超 Olmo 3 7B。也就是说,字节级模型"追平原模型速度"是有条件的,不是无条件的。另外两张小图展示了不同候选 local 架构的吞吐/延迟对比,正是它们支撑了 mLSTM 的选型。
八、用"任务算术"把后训练能力搬进字节模型
这一段对工业界和"没算力做 RL"的学术团队来说,可能是全文最实用的一节。
字节化改造之后,Bolmo 成了一个新模型,按理说它的指令跟随能力得从头做后训练(SFT、RLHF 那一整套)。但作者发现:由于 Bolmo 的 global model 与 Olmo 3 的 transformer 层是一一对应的,可以直接用任务算术(task arithmetic)把后训练能力"加"过来——即把"后训练 checkpoint 的权重 − 基座 checkpoint 的权重"这个差值,加进 Bolmo 对应的层里。
结果见图3:Bolmo 基座在 IFEval 上原本不如 Olmo 3 基座,融合之后直接提升 36 个百分点,追平了那个用强化学习后训练过的 Olmo 3 checkpoint。代价是:零训练成本。
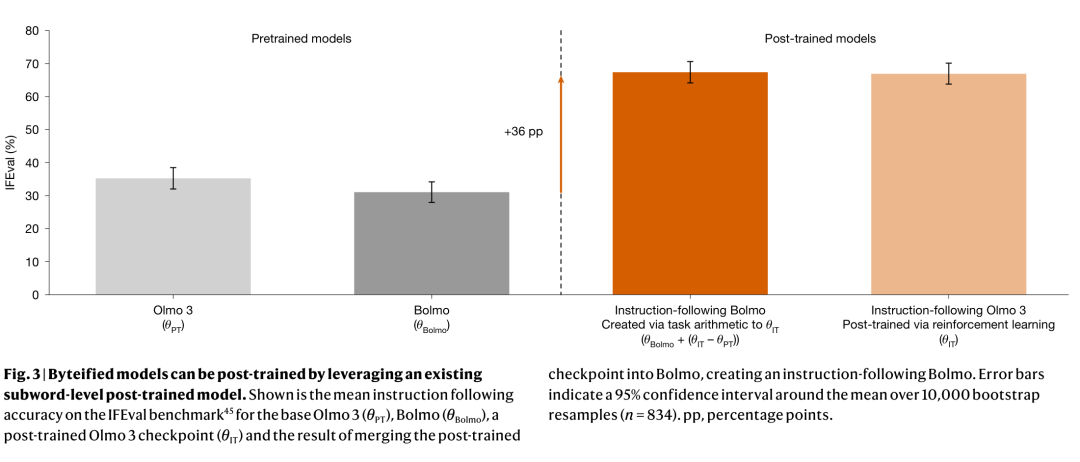
这个结果的战略意义在于:它把字节级模型从"必须有自己的后训练基础设施"这个前提里解放了出来。过去字节级模型之所以难以落地,一个重要原因是整个推理、对齐、工具链生态都围着 subword 模型转。现在,只要基座被字节化一次,整个生态里已经存在的后训练产物(各种 RL、DPO、领域适配 checkpoint)都可以零成本迁移。
当然有一个微妙的先决条件:要用任务算术,就必须能把后训练模型的嵌入重置回基座嵌入而不明显损失性能。这件事"通常成立,但不总是成立"。扩展数据图2专门研究了这一点:把后训练模型的嵌入重置为基座嵌入后计算交叉熵损失比,结果显示模型越大越容易重置,而且用强化学习后训练的 Olmo 3 RL-Zero 系列尤其容易被重置(这与已有文献中"RL 对模型的改动更小"的发现一致)。
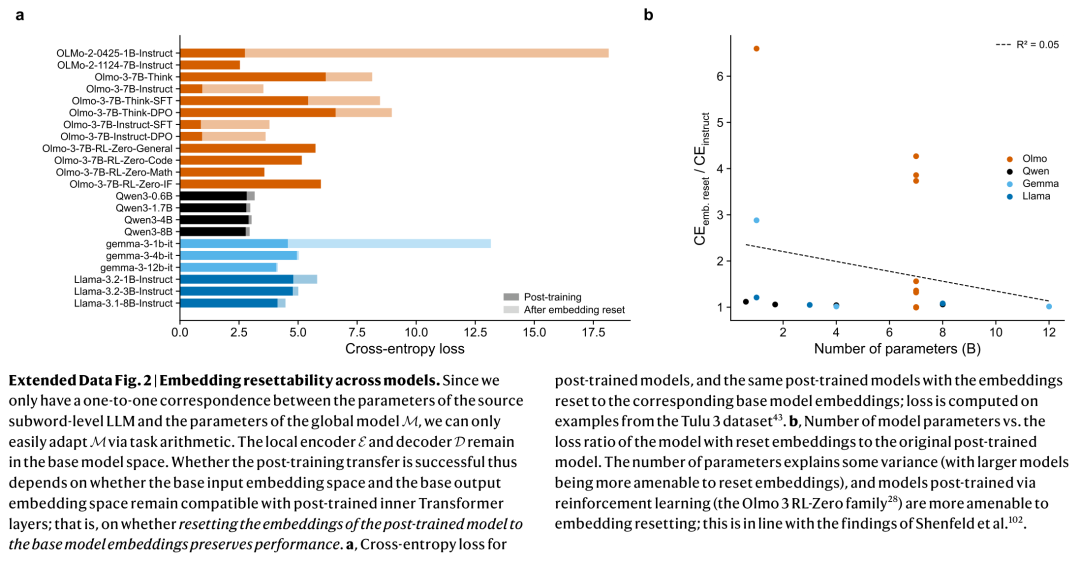
论文的措辞是"generally, but not always, the case"。翻译过来就是:你最好自己先测一下再动手。
九、如果你想复现:Extended Data 里藏着的工程清单
对打算真刀真枪跑一遍的同学,这里把散落在 Methods 和 Extended Data 里的关键配置集中说一遍。
数据:约 172B tokens(用 Dolma2 分词器对 Dolma 3 预训练混合统计),加上约 7500 万 token 的 CUTE 风格合成数据(拼写、反转、字符增/删/换,词表 15 万词,与 CUTE 测试集零重叠),训练不足一个 epoch。
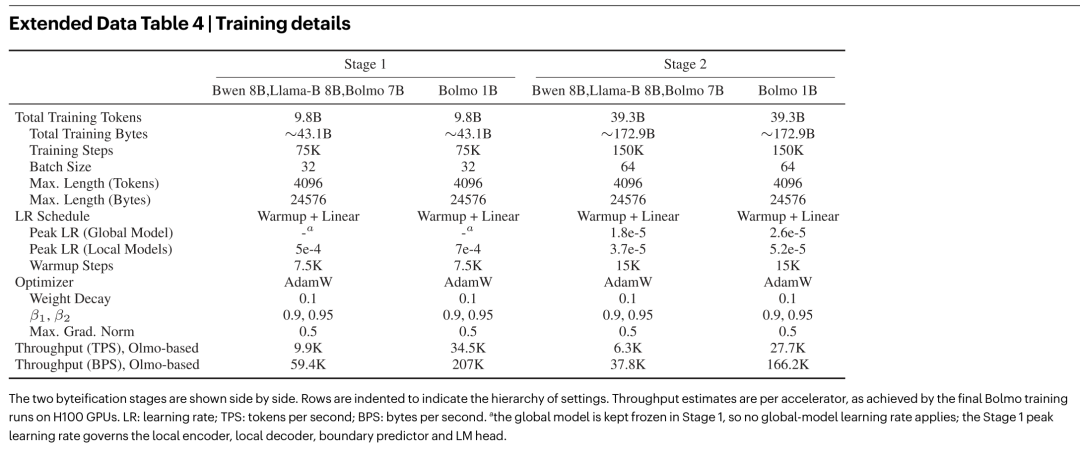
训练:stage 1 用 9.8B tokens(约 43B bytes),stage 2 用 39.3B tokens(约 173B bytes),合计 49.1B tokens。损失权重 λ_B=4、λ_E=1、λ_D(蒸馏)=1、λ_D(CE)=1;蒸馏比较函数温度 τ=5。框架是 PyTorch 2.8,生成用 vLLM 0.11.0,字节化模型的生成能力实现在他们的 bolmo-core 里。
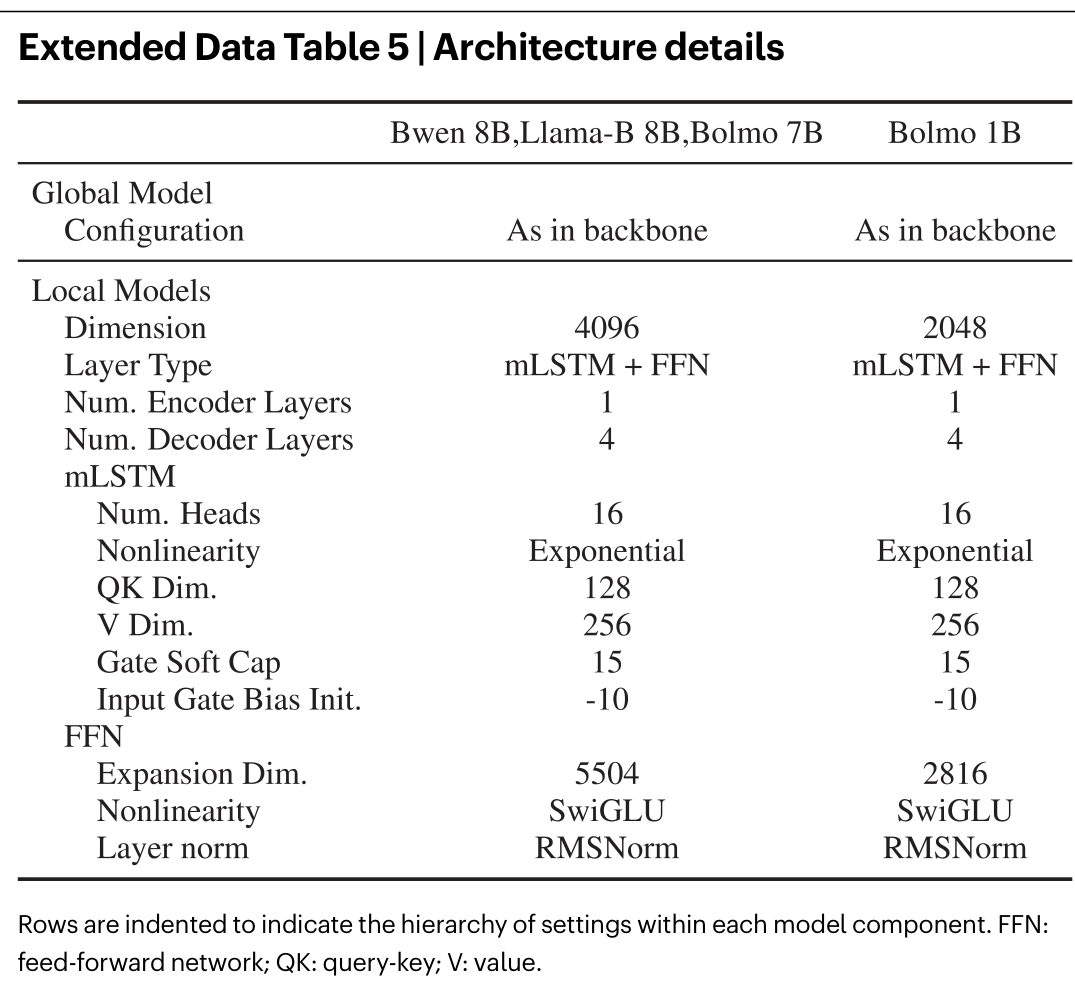
架构超参:local encoder 1 层(mLSTM + FFN),local decoder 4 层;边界预测器用 1 字节前瞻的余弦距离;词表 256 或融合边界后的 512。这些在扩展数据表5里逐项列清楚。
训练细节(学习率、每加速卡吞吐等)在扩展数据表4里并排给出两阶段配置。特别提醒一句:stage 1 的峰值学习率管的是 local encoder/decoder、边界预测器与 LM head,因为 global model 被冻结,压根没有 global 学习率这一项。
十、给 AI + 交叉学科研究者的三个移植方案
前面都是论文内容复盘。这一节是我作为读者最想和实验室同学们分享的部分:这篇论文的方法论,能怎么搬到我们自己的方向上去。
其一,序列科学(基因组、蛋白质、化学、材料):"表示层"值得被重新设计一次。
论文在引言里点了基因组语言模型的分词器问题——已有研究显示,分词器选择会显著改变基因组语言模型的表现。而基因组序列恰恰是最不适合 subword 的数据:它没有"词",ATCG 的每一个位置都携带信息,一个碱基的差异就是疾病与健康的差异。化学 SMILES、材料 CIF 文件同理。
字节级模型在这里的意义,不只是"能拼字母",而是算力可以按信息密度分配:保守区域、重复序列可以被压成粗 patch,而功能位点、突变热点可以保持细粒度。这与生物序列的先验知识天然契合——你甚至可以把已知的 motif 注释当作边界监督信号,这比论文里用 BPE 或熵来监督要"生物学"得多。
更现实的一条路:你手上如果已经有一个训好的基因组/蛋白语言模型,不必重训,可以照搬 byteification 的两阶段流程,把它的 embedding 层换成一个"碱基级 local encoder + 动态 patch"的接口,stage 1 用蒸馏精确复刻,stage 2 再放开。代价可能只是原训练预算的百分之一量级。
其二,多语言与语言类型学:英语中心是可以被"工程掉"的偏见。
这篇论文有个细节特别值得做多语言/低资源语言研究的同学注意:他们造的字符级合成数据只有英文,但 EXECUTE(多语言字符理解基准)上依然出现了大幅提升。这说明"字符内部结构的知识"具备跨语言迁移性。
对做语言类型学、历史语言学、濒危语言记录的同学,这意味着一件事:你不必为每种语言单独造大规模语料,就能改善模型对该语言文字结构的处理。反过来, morphological 丰富的语言(屈折语、多式综合语)、非空格分词的语言(中文、日文、泰文)、以及文字系统特殊的语言(阿拉伯文、天城文),恰恰是 subword 分词最"别扭"的地方——复合词、词缀、连写都会造成切分不一致。论文里 flowerbed 那个例子(以及他们引用的 CompoundPiece 复合词研究)正说明:分词边界的选取本身就是一个语言学问题,而不再只是一个工程实现细节。
其三,图科学与图学习:把"动态分词"翻译成"动态图粗化"。
这一条我格外想推荐给做图神经网络、图表示学习的读者。
请把 LTLM 的"字节 → patch → 字节"在脑子里换一张图:节点/边 → motif 或超节点 → 节点/边。你会发现两者是同构的。字节序列的边界预测,对应图上的分割/聚类(图割、模块度最大化、图粗化);local encoder,对应子图编码器;pooling/depooling,对应图池化与反池化(DiffPool、TopK pooling、MinCut pooling 那一族);global model,对应在粗化图上跑的深层 GNN。
而这篇论文的几个洞察,几乎可以逐条搬到图上:
一是动态优于静态。文本领域已经证明,动态 patching 比固定长度切分在性能-效率前沿上更好;那么在图上,为什么不学一个动态的图粗化策略,让分子中的官能团、社交网络中的社区、知识图谱中的子图结构,各自决定自己的粒度,而不是像现在这样固定用 k 层消息传递 + 固定池化比?
二是非因果的启发式监督是可以被"蒸馏"进模型的。论文用 subword 分词器(一个确定性的、非因果的启发式)去监督一个轻量的可学习边界预测器,99% 以上的准确率就到手了。图学习里我们同样有大量优秀的确定性启发式——谱聚类、Louvain、Weisfeiler-Lehman 着色、motif 枚举——它们是免费的老师。用它们蒸馏一个快的可学习图分词器,再端到端放开,这与 byteification 的两阶段完全同构。
三是图上的"词表瓶颈"确实存在。图学习近两年开始出现"graph tokenizer"的研究——为图构造离散的 motif 词表。论文在文本上已经证明:固定词表一旦变大,softmax 就会成为瓶颈并被帕累托支配;而"无固定词表 + 动态聚合"的路线没有这个天花板。这对图词表的设计是个明确的警告:别把图词表做成另一个 BPE。
四是任务算术可以直接用。如果你手上有一个在图数据上做过 RL 或领域适配的 GNN checkpoint,只要它与基座模型层一一对应,就能零成本把这份能力"加"到改装后的新架构上——对算力有限的学术团队,这可能是性价比最高的一条路。
最后一条更偏方法论:当你觉得某个领域的底层表示有问题时,先问"能不能改装",再问"要不要重训"。 这篇论文最宝贵的不是 Bolmo 这个模型,而是它示范了如何用不到 1% 的预算去验证一个"表示层重构"的假设。对多数交叉学科实验室而言,从零预训练是奢望,但从零开始设计一套"接口 + 蒸馏 + 端到端微调"的改造流程,是完全够得着的。
其四(附赠):认知科学视角的一点联想。
论文的复合词例子其实暗含一个语言学命题:人类读者处理 flowerbed 时,是在看到 bed 之后才回溯确认这是一个复合词——这与非因果边界预测器"看到未来再决定边界"的行为惊人地相似。subword 分词器之所以非因果,本质上是它模仿了"先有整体、后有切分"的语言知觉过程。做心理语言学、阅读眼动、计算语言类型学的同学,这里的对照实验空间很大:模型内部的 patch 边界,与人类阅读时的注视单元、词切分单元,究竟有多对齐?
十一、冷静的那一面:这篇论文没有告诉你的事
一篇负责任的解读必须有一段泼冷水。以下是我读完后认为需要保留的疑问。
规模尚未验证。 论文只验证了 1B 和 7B 两个规模。字节级路线在百 B 甚至更大规模上是否依然成立、是否依然能靠 1% 预算追平,没有任何证据。作者自己也把"从零训练字节级模型"与"字节化改装"描述为互补而非替代关系。
字符能力的提升不完全来自架构。 虽然有 CT 对照,但合成数据(7500 万 token,英文)的贡献与架构的贡献如何精确拆分,论文没有做完整的消融。而且作者明确指出:如果不加这些数据,在这样短的訓練排程下字节级模型学不到字符知识。也就是说,"字节级 = 自动获得字符理解"是个误解,它是被数据喂出来的。
代价真实存在。 代码 pass@1 与数学的下降幅度不小(Bwen 的数学掉了 8 分)。如果你的应用恰好是数学推理或单次代码生成,现阶段的字节化模型并不划算。
效率优势有前提。 Bolmo 7B 要在压缩比约 6.6 字节/patch 时才在 prefill 延迟上超过 Olmo 3 7B;而压缩比提高会平滑地牺牲性能。并且效率测量是在 batch size = 1 的 H100 上做的,工业部署的常见批量场景未必一致。此外,目标压缩比 t 实际上从未被真正达到(学到的 c 总是低于 t),边界预测与主任务之间存在多任务权衡。
采样行为尚未刻画。 温度、top_p 在 512 类融合词表上的作用机制,与在 subword 词表上并不等价。质量-多样性帕累托前沿没有被画出来,"字节级模型更擅长多样性生成"目前只是一个待验证的观察。
生态迁移有条件。 任务算术依赖嵌入可重置性,而扩展数据图2已经显示这"通常但不总是"成立。换一个模型家族,你需要先自己验证。
语言覆盖仍是短板。 字符级训练数据 100% 英文,多语言收益属于意外收获而非设计。真正的多语言/多文字系统字节级建模,还是一片空白——这恰恰是机会。
十二、结语:把"分词"这件小事,重新变成一件大事
这篇论文让我想起一个规律:一个领域里最容易被忽视的问题,往往是那个在 pipeline 最上游、看起来已经被解决的问题。分词就是这样一个问题——它便宜、成熟、有标准库,于是大家默认它不该再被研究。直到有人证明,只要换个角度(不是重训,而是改装),这个问题的解法其实一直都在预算之内。
如果要用一句话概括全文的贡献:它把一个"必须重训才能验证"的科学问题,改造成了一个"可以低成本改装来验证"的工程问题。 而对绝大多数交叉学科实验室来说,这两者的区别,就是"做不到"和"下周就能开始"的区别。
最后给想动手的同学一份最短清单:论文与补充材料开放获取;代码在 allenai/bolmo-core;训练混合数据在 allenai/bolmo_mix;评测套件在 allenai/olmes。如果你的实验室正卡在"我们的数据不适合做 token"这一步——不管是碱基、SMILES、谱图、还是一张奇怪的图——这篇论文值得你今晚就读一遍 Methods。
也欢迎在评论区聊聊:你的领域里,那个"被默认解决、但其实一直在偷走信息"的上游模块,是什么?

内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢