

文献来源
• 论文标题:Langevin Flow Maps: Efficient Molecular Dynamics and Transition Path Sampling • 作者:Sam McCallum、Niklas Rindtorff、Alexander Tong、James Foster • 研究机构:University of Bath、AITHYRA • 发表信息:arXiv:2610.05998v2,2026 年 10 月 14 日更新,预印本 • 论文原文:https://arxiv.org/abs/2610.05998 • 开源代码:https://github.com/sammccallum/lfm
摘要
分子动力学(MD)能够揭示分子的构象变化、热力学系综及状态跃迁,但传统数值积分通常需要飞秒级时间步长,限制了长时间尺度模拟的效率。近年来,机器学习力场显著降低了原子受力计算的成本,却未从根本上解决反复积分带来的计算负担。
这篇 2026 年预印本提出 Langevin Flow Maps(LFM),通过学习朗之万随机动力学在有限时间区间内的状态映射,实现无需显式轨迹监督的大步长模拟。作者结合布朗运动多项式表示、瞬时力匹配和半群一致性训练,在丙氨酸二肽上实现相对机器学习力场约 10 倍的模拟吞吐量,并展示了向未见过的多肽体系迁移的潜力。不过,其大步长模拟仍存在平衡分布偏差,揭示了加速动力学与保持热力学一致性之间的重要挑战。
一、为什么机器学习力场仍无法彻底解决分子动力学的效率瓶颈?
分子动力学的基本任务,是根据原子间相互作用力计算系统随时间演化的轨迹。传统分子模拟需要反复计算势能梯度,再通过数值积分更新原子的坐标与速度。由于分子内部存在高频振动,常规模拟往往需要约 1 fs 的时间步长,而蛋白构象转换、分子识别与结合解离等过程可能发生在纳秒至微秒甚至更长时间尺度。这意味着,即使只模拟 1 μs,在 1 fs 步长下也需要约 次积分更新。
机器学习力场(MLFF)通过神经网络近似量子化学势能面或原子受力,显著降低了单次力计算的成本。然而,更快的力计算并不意味着更少的积分步骤。如果仍然需要逐飞秒推进模拟,长时间尺度下的计算负担依然十分可观。
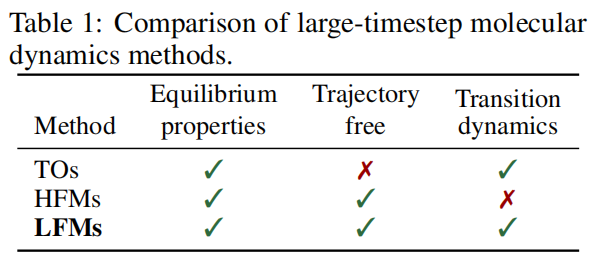
为突破这一限制,已有研究尝试直接学习较长时间间隔对应的动力学映射。其中,Transfer Operator 方法学习两个时间点之间的条件转移分布,但通常需要预先生成具有时间顺序的参考轨迹;Hamiltonian Flow Maps(HFM)则学习哈密顿动力学的有限时间映射,再与随机热浴步骤交替执行。后者避免了轨迹监督,却由于确定性演化与随机更新通常不可交换,仍会引入与时间步长有关的动力学偏差。
LFM 的出发点是进一步学习包含摩擦、保守力和随机热噪声的完整朗之万演化过程,从而同时减少力评估次数与传统积分拆分带来的误差。
二、Langevin Flow Maps 究竟学习什么?
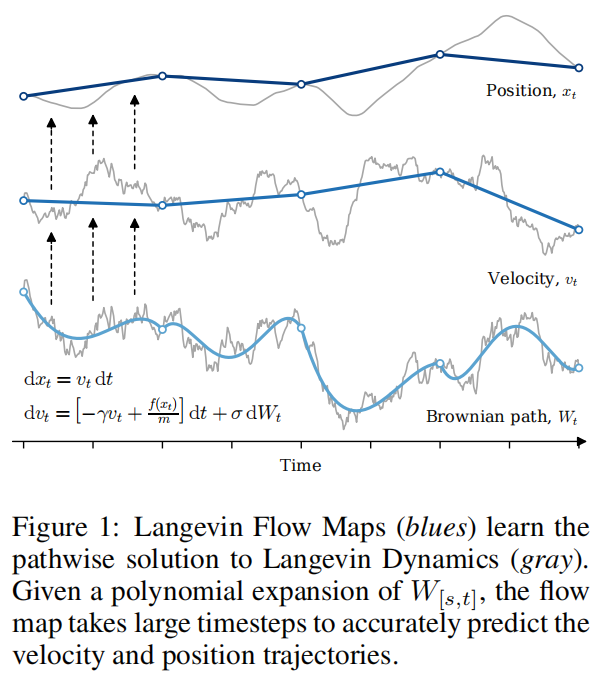
朗之万动力学描述的是受到势能、摩擦阻力和随机热扰动共同作用的粒子运动,其基本方程为:
其中, 和 分别表示原子位置与速度, 为作用力, 是摩擦系数, 为噪声强度, 表示布朗运动。在适当条件下,该动力学对应的平衡状态服从正则系综的玻尔兹曼分布。
传统积分器需要在每个很短的时间间隔内依次更新这些变量。LFM 则尝试直接建立从初始状态 到未来状态 的映射:
这一表达式的关键是随机路径条件。对于随机微分方程,只要给定初始状态和整个时间区间内的布朗运动实现,终点状态便由动力学方程确定。因此,LFM 学习的是给定随机噪声路径条件下的状态演化映射,而非单纯预测未来构象的概率分布。
这种逐路径映射保留了更丰富的时间演化信息,使模型有可能同时学习平衡采样、构象转换及跃迁动力学。
三、方法核心:如何在没有轨迹监督的条件下学习大步长动力学?
3.1 从瞬时力预测转向时间区间积分
LFM 的第一项核心设计,是将动力学方程中的积分写成时间平均速度和时间平均力的预测问题。对长度为 的时间区间,模型输出两个量: 表示区间平均速度, 表示区间平均受力。
对应的状态更新可以写为:
其中, 为时间区间内的布朗运动表示,第二行的平均速度和平均力使用与第一行相同的状态、时间及随机路径条件。
这一参数化具有明确的物理意义:当 时,平均速度和平均力应分别退化为初始瞬时速度与受力;当 增大时,网络需要学习整个时间区间内的有效积分结果。因此,模型不仅学习局部势能梯度,还需要通过训练近似原子在有限时间内的实际运动。
3.2 布朗运动多项式:大步长下如何保留随机路径信息?
这是 LFM 区别于普通大步长状态预测的重要设计。
如果只输入时间区间两端的布朗运动增量,便会丢失区间内部随机扰动的形状信息。两条具有相同总增量的随机路径,可能使分子在不同时间受到不同扰动;由于力场具有非线性特征,最终坐标与速度也可能不同。
作者采用基于移位 Legendre 多项式的布朗运动展开,将随机路径压缩为一组高斯系数:
零阶系数对应总布朗增量 ,更高阶系数描述路径相对于简单端点插值的波动。模型实际使用四个系数,既保留一定的随机路径形状信息,又避免显式生成大量细时间步的布朗运动。
这些系数具有两个重要性质:可以直接从已知高斯分布中采样,并且能够通过 Chen relations 将两个子区间的随机路径信息合成为完整区间的表示。这使后续的时间一致性训练成为可能。
论文中的消融实验也表明,增加布朗运动展开阶数能够降低积分误差,其中从仅使用总增量扩展到包含第一个高阶系数时,改善尤为明显。
3.3 半群一致性:没有真实未来轨迹,网络如何训练?
LFM 的核心难点在于:模型需要预测未来状态,但训练时并不要求提供真实的起点—终点轨迹对。作者利用随机微分方程解映射满足的半群性质构建自监督训练目标。
其物理含义十分直观:在同一条随机路径条件下,从 直接演化到 ,应该与先从 演化到中间时刻 ,再从 演化到 得到一致结果。
训练时,LFM 同时使用两类约束。
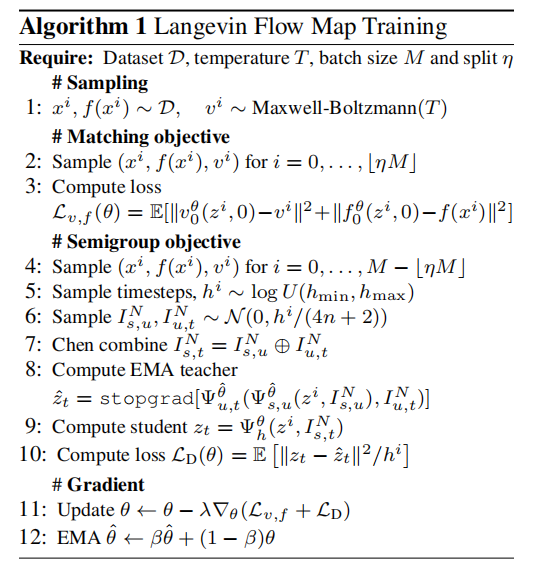
第一类是瞬时匹配损失。 当时间间隔趋近于零时,网络预测的平均速度应等于真实速度,预测的平均力应等于数据集提供的原子受力。这样可以将学习得到的流映射锚定在正确的局部动力学方程上。
第二类是半群一致性损失。 网络分别预测一次长步长演化与两次半步长演化,并最小化两者的终态差异。两次短步长演化由参数指数滑动平均(EMA)的教师网络产生,教师输出停止梯度传播,从而稳定自蒸馏训练。实际算法还使用时间步长归一化一致性误差,以平衡不同时间尺度的训练信号。
这一设计具有重要的数据意义。LFM 不需要将连续轨迹的未来状态作为监督标签,但仍然需要分子构象及其对应的力。 训练数据可以由时间上不相关的构象—受力样本组成,速度则独立地从 Maxwell–Boltzmann 分布采样。它消除了对时间有序轨迹监督的依赖,并不意味着完全无需分子模拟或力计算数据。
3.4 模型架构与实际模拟流程
网络采用平移不变的 Transformer 架构,以原子序数、三维坐标、原子质量、初始速度、时间步长及布朗运动系数作为输入。原子之间的距离和相对方向用于构建几何关系,时间、速度、质量和随机路径信息则通过条件嵌入注入网络。
模型包含 6 个 Transformer 模块、8 个注意力头和 256 维隐藏表示,并通过两个输出头分别预测时间平均速度和平均力。在推理阶段,系统从初始坐标与速度出发,每一步重新采样对应区间的布朗运动系数,利用神经网络直接计算新的坐标与速度,连续迭代即可生成分子轨迹。
为了支持不同分子的迁移,模型仅依赖原子属性及几何信息定义输入,不需要为每条多肽序列建立独立的输入编码。对于可迁移模型,作者还引入了动能温度校正,通过调整随机噪声幅度,使速度平方均值接近目标温度要求。不过,这种校正主要控制动能统计,并不能自动保证完整构象分布的玻尔兹曼一致性。
四、实验结果:大步长模拟究竟获得了什么?
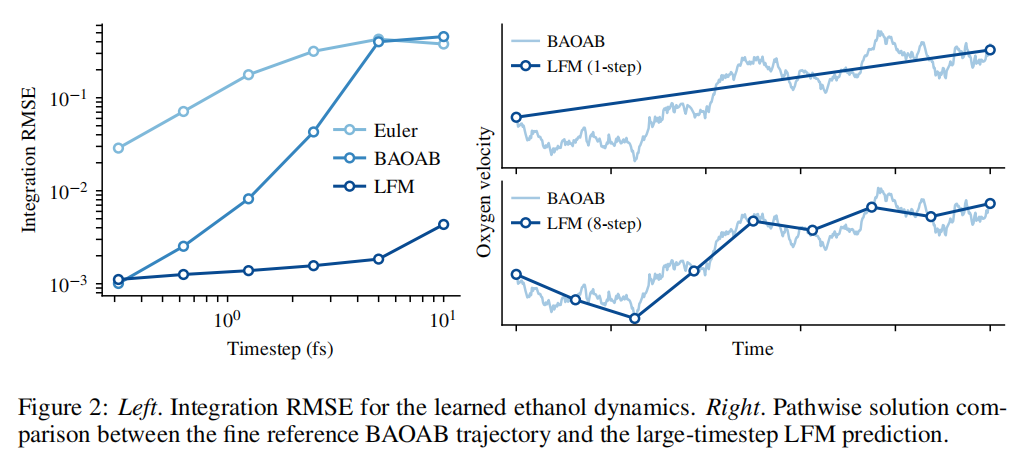
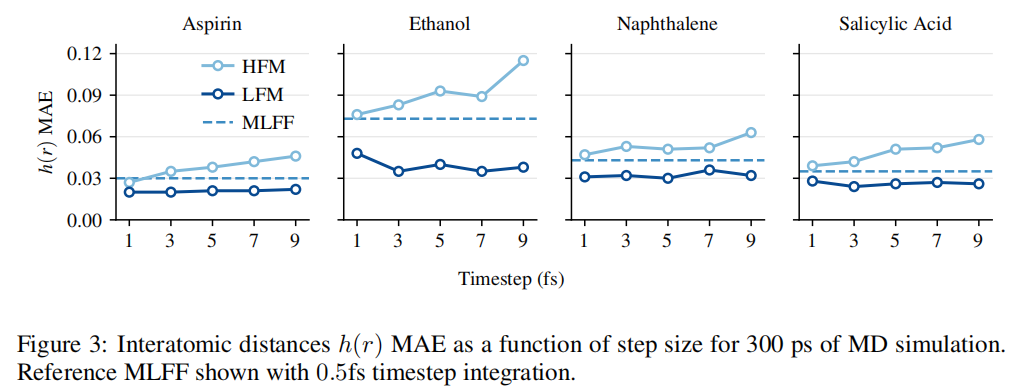
首先是小分子体系上的积分精度与构象采样。 作者使用 MD17 中的阿司匹林、乙醇、萘和水杨酸数据,评估模型的短时轨迹误差及长时结构分布。乙醇实验显示,LFM 在 10 fs 步长下的积分 RMSE 已接近传统 BAOAB 在 1 fs 下的水平。对于四种小分子,LFM 的原子间距离分布误差也低于所比较的 HFM,在该结构指标上甚至优于使用 0.5 fs 步长积分的参考机器学习力场。
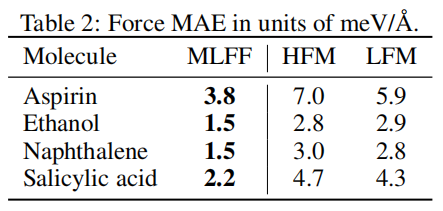
一个值得关注的现象是,LFM 的瞬时力精度未必最高。例如在阿司匹林数据集上,传统 MLFF 的力 MAE 为 3.8 meV/Å,而 LFM 为 5.9 meV/Å,但 LFM 获得了更好的结构分布结果。这说明单点受力误差不能充分表征长时间积分后的结构采样质量,也支持将动力学积分误差纳入模型设计与评价。
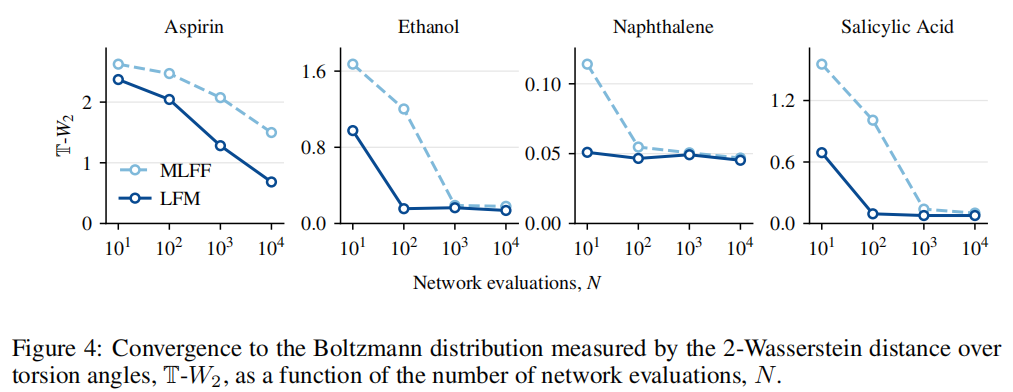
在玻尔兹曼分布收敛实验中,作者使用周期性扭转角分布的 Wasserstein 距离衡量采样系综与参考分布之间的差异。乙醇、萘和水杨酸等体系显示,LFM 在约 100 次网络评估后便接近参考分布,而小步长 MLFF 需要约 1000 次评估。这体现了大步长模型在相同网络调用预算下探索构象空间的效率优势。
其次是丙氨酸二肽上的跃迁动力学。 该体系存在 α、β 和 ppII 等亚稳态,是研究构象转换的经典模型。作者比较了平均首次到达时间(MFPT)、竞争性状态到达概率以及不同路径的跃迁通量,发现 LFM 生成的动力学统计与参考 MD 及小步长 MLFF 较为接近。
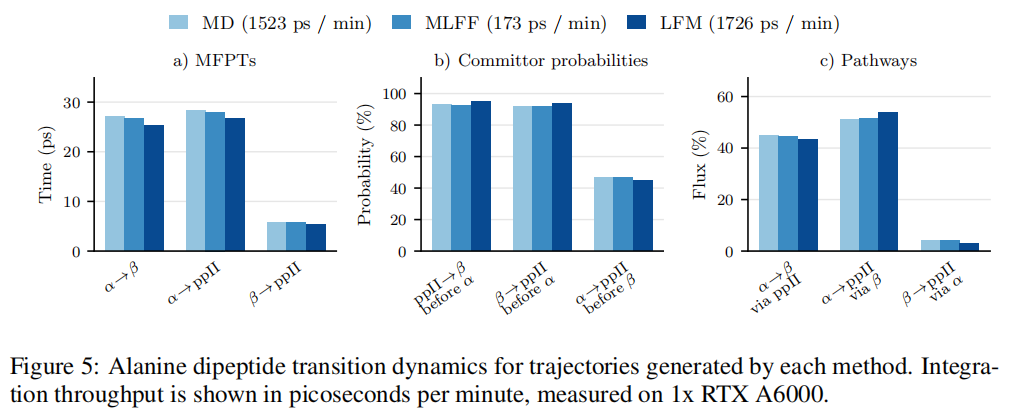
LFM 相对于所比较的 MLFF 获得约 10 倍加速,吞吐量也略高于该实验中的经典 MD。不过,这一结果来自特定的小分子体系与硬件配置,并不代表 LFM 对所有体系都比经典分子动力学快 10 倍。
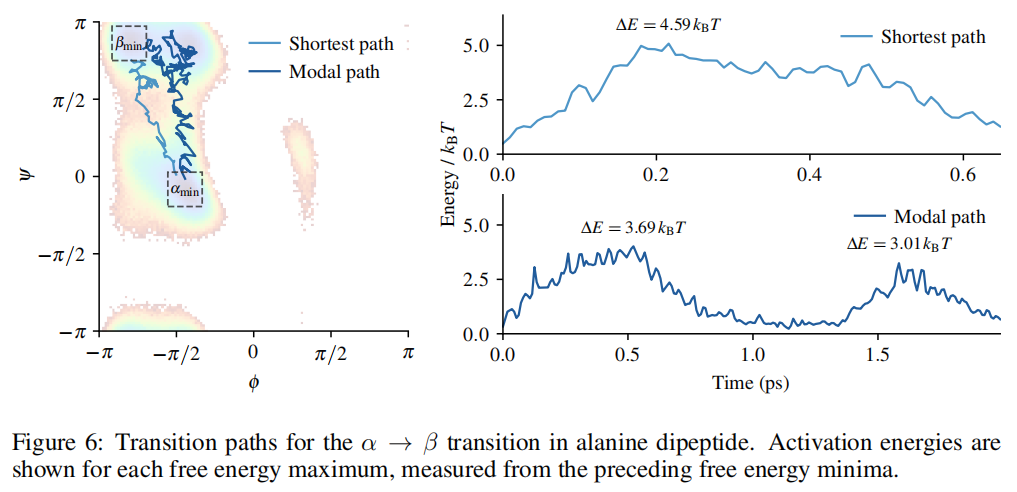
跃迁路径分析进一步显示,α 到 β 的转换可以通过不同路线完成。最短跃迁路径直接跨越约 的投影自由能势垒,而接近过渡时间分布众数的路径经过 ppII 状态,依次跨越约 和 的势垒。需要注意,这些势垒取自参考轨迹构建的自由能分布,说明不同路径可能采用不同的构象转换机制,并不等同于完整高维空间中的严格动力学活化自由能。
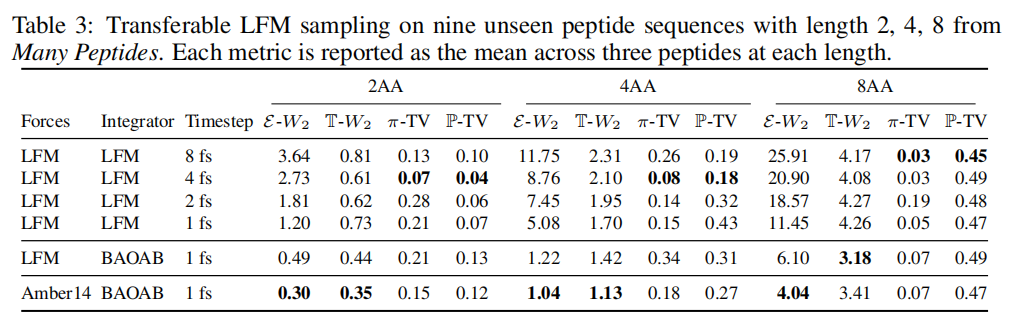
最后是可迁移多肽体系。 作者基于 Many Peptides Forces 数据集训练约 900 万参数的 LFM。训练资源包含 21,700 条长度为 2–8 个氨基酸的多肽、约 4.34 亿个带有能量和力标签的构象,并在 92 条未见过的多肽序列上测试积分泛化能力。
模型对短时积分表现出一定迁移能力,但大步长带来了明显的热力学—动力学权衡。以表 3 中的八肽结果为例,8 fs LFM 的能量分布 Wasserstein 距离为 25.91,而 Amber14/BAOAB 1 fs 为 4.04,说明其平衡能量分布偏差更大;但亚稳态占有概率的总变差距离分别为 0.03 和 0.07,表明 LFM 在该指标上更接近参考数据。跃迁概率误差则分别为 0.45 和 0.47,改善幅度相对有限。
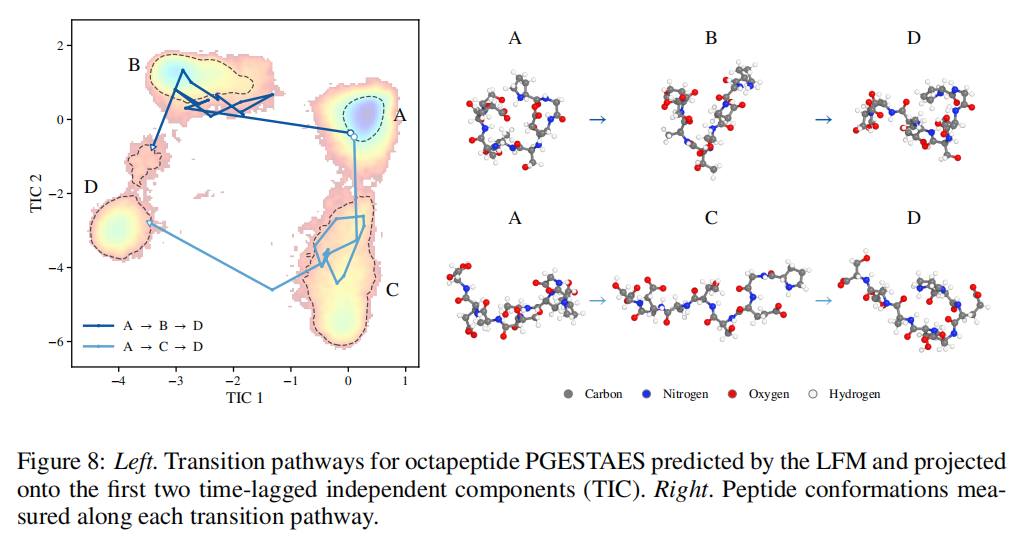
作者还利用 LFM 在未见过的八肽 ANKSMIEA 中发现了参考轨迹未覆盖的亚稳态,并通过三次独立经典 MD 验证其可维持约 6.8–15.8 ns。这提示大步长动力学可能辅助发现此前采样不足的构象状态,但仍需进一步确认新状态的平衡权重与长期动力学性质。
五、这项工作的真正价值在哪里?
LFM 的贡献首先体现在分子模拟模型的学习目标上。传统 MLFF 主要优化局部势能或受力预测,而 LFM 将有限时间的随机动力学积分本身纳入学习范围,使模型能够针对最终的状态演化构建训练约束。这也说明,学习到更准确的瞬时受力与获得更可靠的长时间模拟,并不总是同一个优化问题。
其次,它为无轨迹监督的动力学建模提供了一条可行路线。布朗运动多项式使随机路径能够被有限维表示,半群一致性则将跨时间尺度的演化关系转化为自蒸馏约束。在具有大量构象—力数据、但缺乏足够长参考轨迹的体系中,这种思路尤其值得进一步研究。
更进一步,可迁移模型展示了学习通用随机积分器的可能性。与直接生成玻尔兹曼构象的模型相比,LFM 还尝试保留状态转换的时间信息。因此,它与增强采样、稀有事件分析和动力学状态模型之间具有潜在的结合空间。
六、局限性:大步长是否意味着物理上更可靠?
第一,热力学一致性仍然存在问题。 LFM 使用神经网络直接预测时间平均力,当前架构没有严格保证能量守恒形式、详细平衡、可逆性和正确的平衡测度。尤其是在未见过的多肽上,随着时间步长增大,能量和扭转角分布误差会明显增加。动能温度校正只能缓解部分温度漂移,不能替代完整的平衡分布约束。
第二,随机路径表示和模型一致性仍然是近似的。 理论上的逐路径解依赖完整布朗运动,而实际模型只使用有限阶多项式系数。半群一致性训练也依赖有限样本、有限网络容量及 EMA 教师预测。因此,即使模型在测试中获得较低的短时积分误差,也不能据此保证任意时间尺度上的动力学精度。
第三,现有验证距离真实药物发现体系仍有差距。 研究主要覆盖小分子与短肽,尚未展示大型蛋白质、显式溶剂、离子环境及复杂蛋白–配体相互作用体系。当前全局原子关系计算还存在随原子数量近似二次增长的成本。对于蛋白质–配体结合解离,仍需要处理口袋柔性、溶剂重排、稀有事件采样和长时间速率估计等额外挑战。
第四,模拟速度与数据成本需要同时考虑。 虽然 LFM 在丙氨酸二肽上相对 MLFF 取得显著加速,但可迁移实验中,8 fs LFM 的吞吐量主要达到与传统经典 MD 相近的水平,尚未形成普遍速度优势。此外,模型训练依赖大规模力标签数据,实际部署时应将数据生成、模型训练、推理和精度损失纳入统一成本比较。
七、未来意义:从快速构象探索走向可靠的分子动力学模拟
LFM 提供了一个值得关注的方向:利用神经网络学习随机动力学在有限时间内的有效演化,在减少积分步骤的同时尽可能保留分子状态转换规律。未来若能进一步引入保守力约束、正确平衡测度、时间可逆性条件和自适应步长策略,有望在采样效率与物理准确性之间获得更好的平衡。
对于 AI 药物设计,这类方法的潜在价值包括蛋白构象变化分析、配体构象重组、结合路径探索和动力学状态发现。但现有结果还不能直接证明其能够准确预测蛋白–配体解离速率、结合自由能或实验结合动力学。特别是,采样得到的几何跃迁路径不能自动视为最小自由能路径,状态发现能力也不能直接等同于动力学速率的正确性。
总体而言,Langevin Flow Maps 最值得关注的地方,是将 AI 分子模拟的研究重点从局部受力预测进一步扩展到随机时间演化算子的学习。论文已经展示了大步长模拟和动力学采样的潜力,同时也清楚暴露了未来必须解决的核心问题:如何让模拟在跨越更多时间步长的同时,仍然保持正确的平衡分布和真实的时间演化规律。
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢