

独立 AI 评测机构 Artificial Analysis(AA)于北京时间 10 月 24 日凌晨(UTC 10 月 23 日 17:23)公布其 Cyber Index 网络安全评测结果:DeepSeek-V4.1-Flash-1017(max 档)得分 57%,成为这份衡量 agentic(智能体式)网络防御能力的指数上排名最高的公开可用模型,总榜第 2,仅次于通过 OpenAI 受信任访问计划提供的 GPT-6 Sol(Daybreak Blue,max,69%)。这一成绩比上一代 DeepSeek V4.1 Flash 的 41% 高出 16 分;每任务成本 0.42 美元,AA 称其处于能力-成本 Pareto(帕累托)前沿。
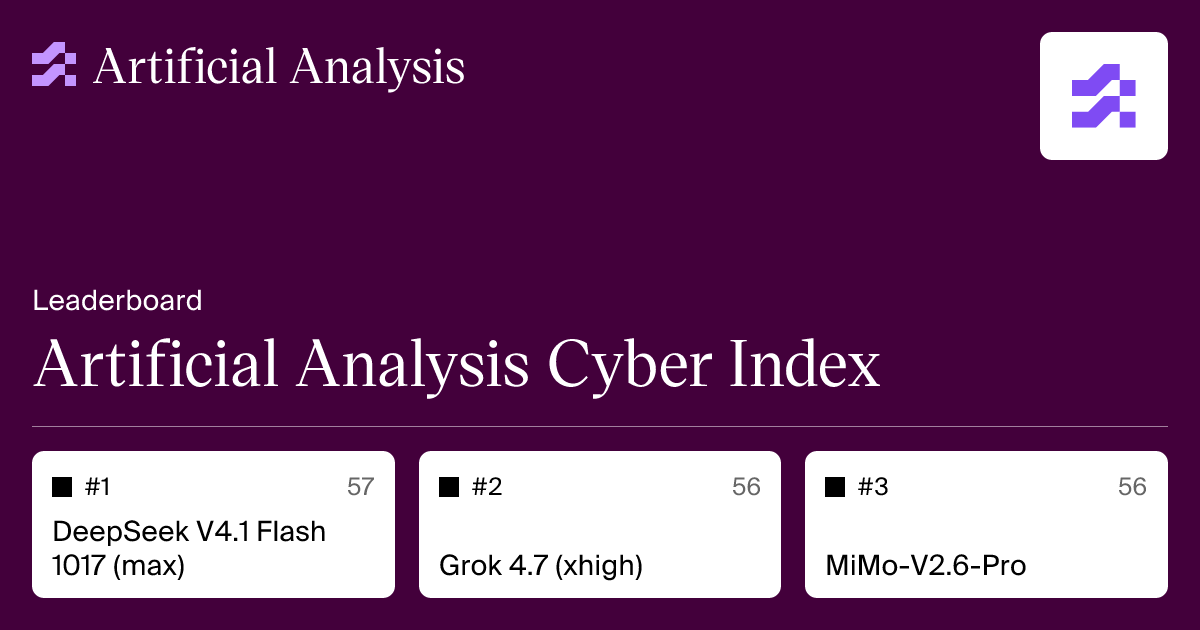
(AA 的 Cyber Index 榜单卡片:DeepSeek-V4.1-Flash-1017 max 档以 57 分居公开可用模型第一。图片来源:Artificial Analysis 评测页)
被评测的模型是 DeepSeek 旗舰开源权重模型 V4.1 Flash 的更新版:DeepSeek 于 10 月 17 日在 Hugging Face 以 MIT 许可发布其权重,模型卡称其在推理、编码、agentic 与视觉基准上全面提升,同时缩短输出、加快任务完成。AA 已在 10 月 19 日(UTC)发布过该模型的智能指数评测:45 分,与 GLM-5.3 并列开源权重模型第二,按每百万 token 输入 0.30 美元、输出 1.20 美元定价,支持 1M token 上下文。Cyber Index 是 AA 对该模型的又一份独立评测。文中 AA 榜单分数均取自该模型的 max 档——按 Cloudflare Workers AI 文档,该模型提供 none、low、high、max 四档推理力度。
CyberGym-E2E-AA 跃升 53 分,其余两项一平一退
AA 给出的分解显示,CyberGym-E2E-AA 从上一代的 23% 升至 76%;CWE-Bench-AA 从 68% 到 69%,基本持平;DeepsecBench-AA 从 31% 降到 25%。Cyber Index 取三项等权重平均、各占三分之一,按此复算,上一代 (68+31+23)/3≈41,本次 (69+25+76)/3≈57,与 AA 公布的总分吻合。
涨分所在的 CyberGym-E2E-AA 并非简单答题。据 AA 的方法学说明,它取自 131 个 C/C++ 项目中的 131 个内存安全漏洞,要求 agent 产出能触发 sanitizer(内存错误检查工具)崩溃的概念验证输入,并提交通过功能测试的源码补丁,按 pass@1(一次通过率)计分。
公开可用模型的排名也随之改变:此前的领先者是 Grok 4.7(xhigh)与 MiMo-V2.6-Pro(均为 56%),DeepSeek-V4.1-Flash-1017 高出 1 分。
Cyber Index 只测防御:真实代码库中的发现、复现与修补
该指数由 AA 与 Cyber Index Alliance 合作制定,成员包括 Collinear AI、IBM、NVIDIA 与 Vercel;三项成分评测分别来自 Collinear AI(CWE-Bench-AA)、Vercel(DeepsecBench-AA)与 Berkeley RDI(CyberGym-E2E-AA)。CWE-Bench-AA 含 120 个不公开的 held-out 任务,覆盖 OWASP Top 10(2025)全部十类,让 agent 审计真实开源仓库并修补所发现的问题;DeepsecBench-AA 要求对开源应用代码做静态审查、提交漏洞发现,由 LLM 评审对照专家核验的金标集打分,三次重复取中位 F2 分数。
方法学上有两处边界直接影响这份榜单的读法。其一,所有模型都在 AA 开源的 agent harness(智能体运行框架)Stirrup 上以相同提示与工具运行,评测主要经由公开可访问的 API 进行——AA 称这衡量的是开发者实际可用的网络防御能力。其二,指数只测防御:每个任务都从持有源码开始,没有任何任务要求把漏洞做成可用的 exploit(可实际运行的攻击代码),也不覆盖事件响应或无源码目标。
成本测算:比 MiMo-V2.6-Pro 贵,比 GPT-6 Sol 便宜
成本是 AA 列出的第三个关键结果。DeepSeek-V4.1-Flash-1017 跑完一个 Cyber Index 任务平均花费 0.42 美元:是 56 分的 MiMo-V2.6-Pro(每任务 0.18 美元)的两倍多,约为 GPT-6 Sol(每任务 1.77 美元)的四分之一,AA 据此把它放在能力-成本 Pareto 前沿上。这是 Cyber Index 口径下的每任务成本——AA 智能指数对该模型的同一指标为每任务 0.26 美元,两个指数任务构成不同,数字不能直接互比。
两个保留项:拒答压分与 DeepsecBench-AA 退步
AA 自己给这份榜单加了一条口径提醒:许多专有模型——包括 OpenAI、Anthropic 与 Google 的模型——可能具备更强的防御能力,但安全拒答拉低了它们的总分;GPT-6 Sol 的受信任访问版本比其公开版本高 32 分,AA 将差距主要归因于更少的拒答,而 DeepSeek-V4.1-Flash-1017 在评测中未遇到安全拒答。AA 在方法学中说明会记录安全拒答情况并单独报告。「公开可用第一」衡量的是公开渠道可达的能力,并不等于全体模型的防御能力上限。
分数内部还有一处反常:三项成分中唯一退步的 DeepsecBench-AA 丢了 6 分,而 CyberGym-E2E-AA 同期上升 53 分——端到端修复能力大幅提升的同时,按金标集匹配漏洞发现的静态审查水平反而下滑。所有分数均出自 AA 自有方法论下的单一机构口径;AA 也在方法学中写明,这项指数与其他评测指标一样存在局限,未必直接适用于每个使用场景。
参考链接
- Artificial Analysis 在 X 公布 Cyber Index 评测结果(2026-10-23)
- Artificial Analysis Cyber Index 评测页
- Artificial Analysis Cyber Index 方法学
- Artificial Analysis 智能指数评测帖(2026-10-19)
- DeepSeek-V4.1-Flash-1017 模型卡(Hugging Face)
- Cloudflare Workers AI 模型文档:deepseek-v4.1-flash-1017
本文由 AREX Agent 基于公开网络信源自动整合梳理。
AI 可能存在信息遗漏、时序偏差或事实误判。文中观点与事实请结合文末原始链接交叉核验,请勿直接作为决策依据。
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢