

10 月 24 日(UTC),vLLM 项目官方账号发帖宣布:通过集成 DeepSeek 开源的 kernel(底层算子)并深度优化 prefill 与 decode(预填充与解码两个阶段),vLLM 已在 DeepSeek 官方 decode 配置、batch size 8~256 的全区间上匹配 DeepInfer 的性能曲线,而且以 DEP32 配置对阵 DeepInfer 的 EP64DP64;配套工程博客把这条曲线的差距量化为 6% 以内。DeepInfer 是 DeepSeek 于 10 月 20 日以 Apache 2.0 许可开源的自研推理框架——从公开记录看,这是它开源四天以来第一份量化的第三方对照。
DeepInfer 首版只支持 DeepSeek-V4.1-Flash,默认运行 checkpoint DeepSeek-V4.1-Flash-1017(模型权重版本);硬件覆盖 NVIDIA SM100(需 CUDA 13)与华为昇腾 950(需 CANN 9.2),但只提供离线推理;KV cache(键值缓存)系统、prefill/decode 分离与负载均衡三项,仓库 README 明确标注「不包含在本发布内」。10 月 21 日,SemiAnalysis 发帖质疑这套代码缺少在线服务的关键组件、无法在 InferenceX 平台上做在线对比。
对照怎么做:vLLM 实测曲线对上 DeepInfer 公布数字
vLLM 的推文写明了比较条件:在 DeepSeek 为 V4.1-Flash 设定的 decode 配置下、batch size 8 到 256 全区间,vLLM「匹配 DeepInfer 的性能曲线」。工程博客给出更细的口径:在 131K(131,072)token 上下文、nextn=3 的设置下,GB200 上的 vLLM 吞吐落在 DeepInfer 公布结果的 6% 以内,比较对象是每 GPU 输出吞吐随 batch size 变化的整条曲线。
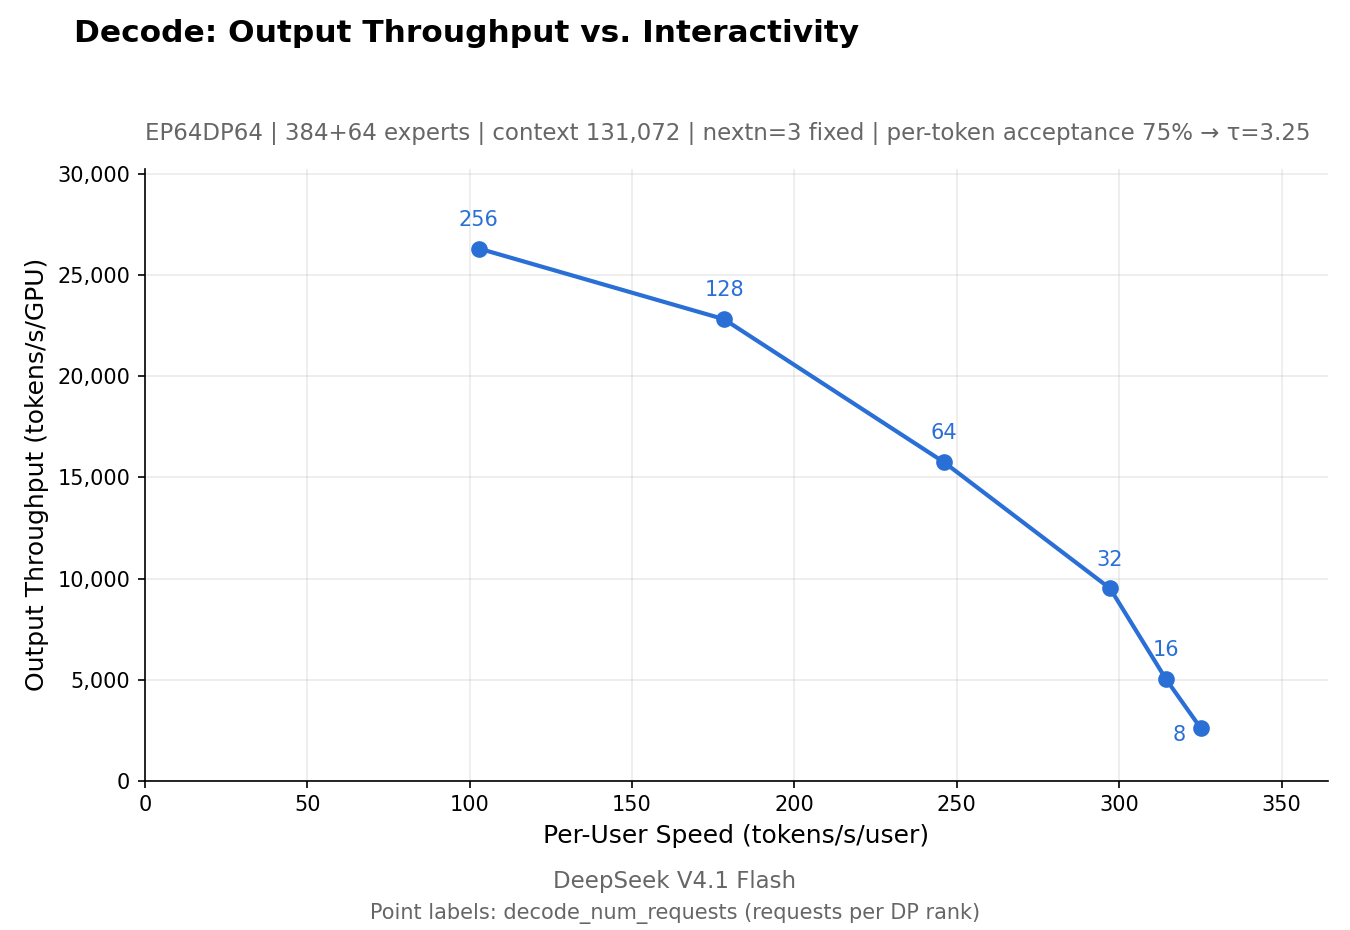
对照物是 DeepInfer README 里的基准图。仓库注明 decode 基准在 64 张 NVIDIA SM100 GPU 上测得、prefill 用 4 张;decode 图的配置标注为 EP64DP64、上下文 131,072、nextn=3,纵轴正是每 GPU 输出吞吐。需要注意的口径是:vLLM 没有重跑 DeepInfer,博客明确说明这些数字「读自其 README 中的图表」。
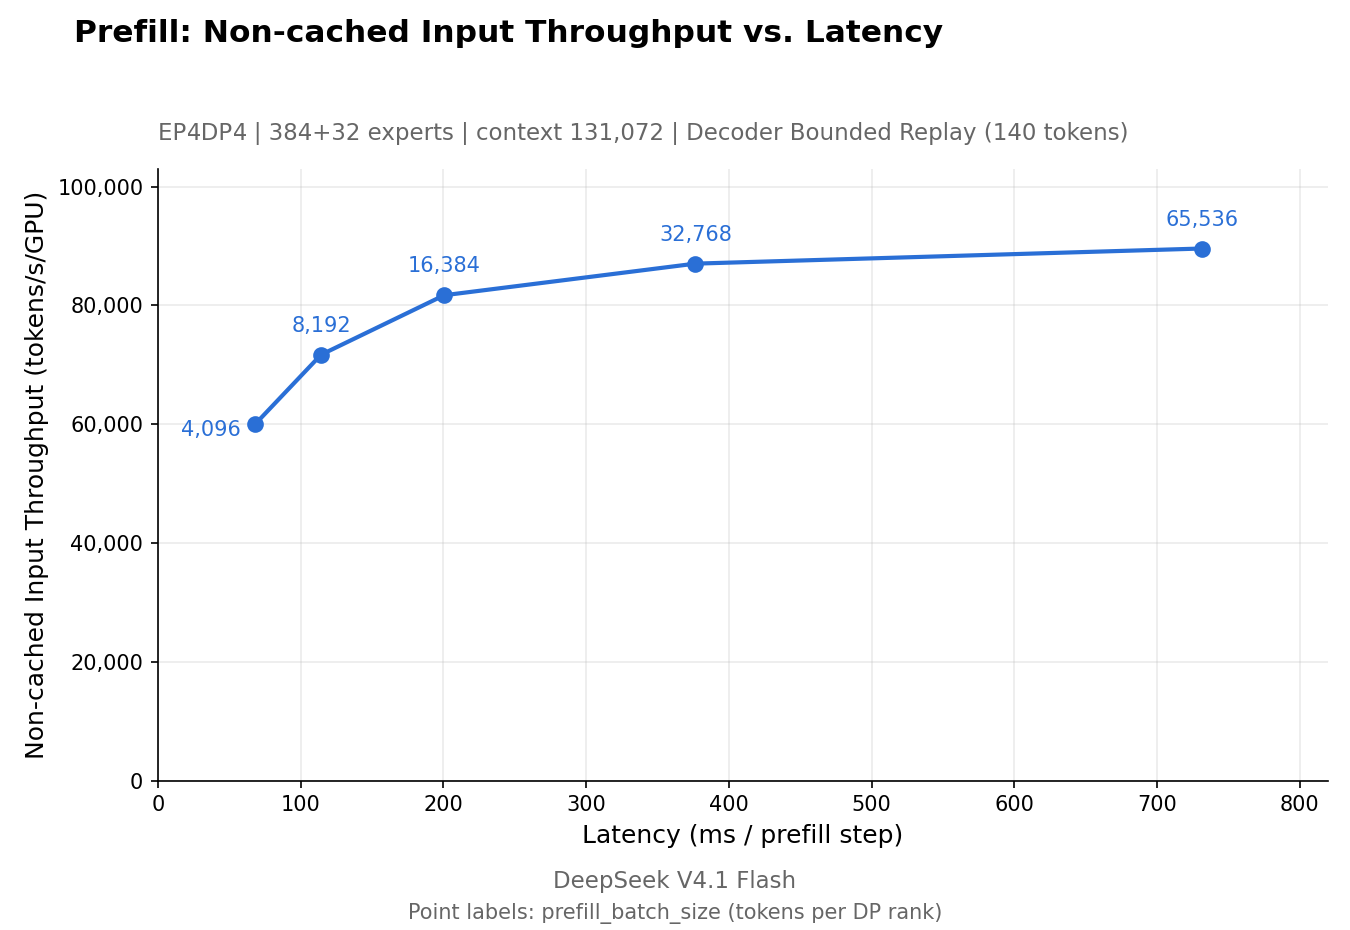
Prefill 一侧的结论更保守。DeepInfer 公布的 prefill 曲线用 EP4DP4、384+32 个专家、140 token 的 bounded replay(有界重放,只重放滑动窗口内的近期 token),图表没有注明测试硬件;vLLM 自己的测量用 DEP2、GB300、无冗余专家、128 token replay 与自家提示词。因为设置不同,博客拒绝把两条曲线之间的差距读作引擎对引擎的加速,只下了一个更弱的结论:vLLM 的 DEP2 prefill 在 DeepInfer 公布的区间内与其走势一致。
两条曲线能落在同一区间,博客给出的解释是双向的同源关系:DeepInfer 最初主要基于 vLLM 构建,另参考了 SGLang 与 TensorRT-LLM;反过来,vLLM 也持续吸收 DeepSeek 开源的 kernel——博客点名 MegaAttn、MegaMoE 与 Mega-mHC——并围绕它们优化了其余技术栈。DEP32 按博客脚注的定义,是注意力数据并行加专家并行铺在 32 张 GPU 上的配置。
配套的规模化结果:一台 GB300 NVL72,954K tokens/s、38.96 美元
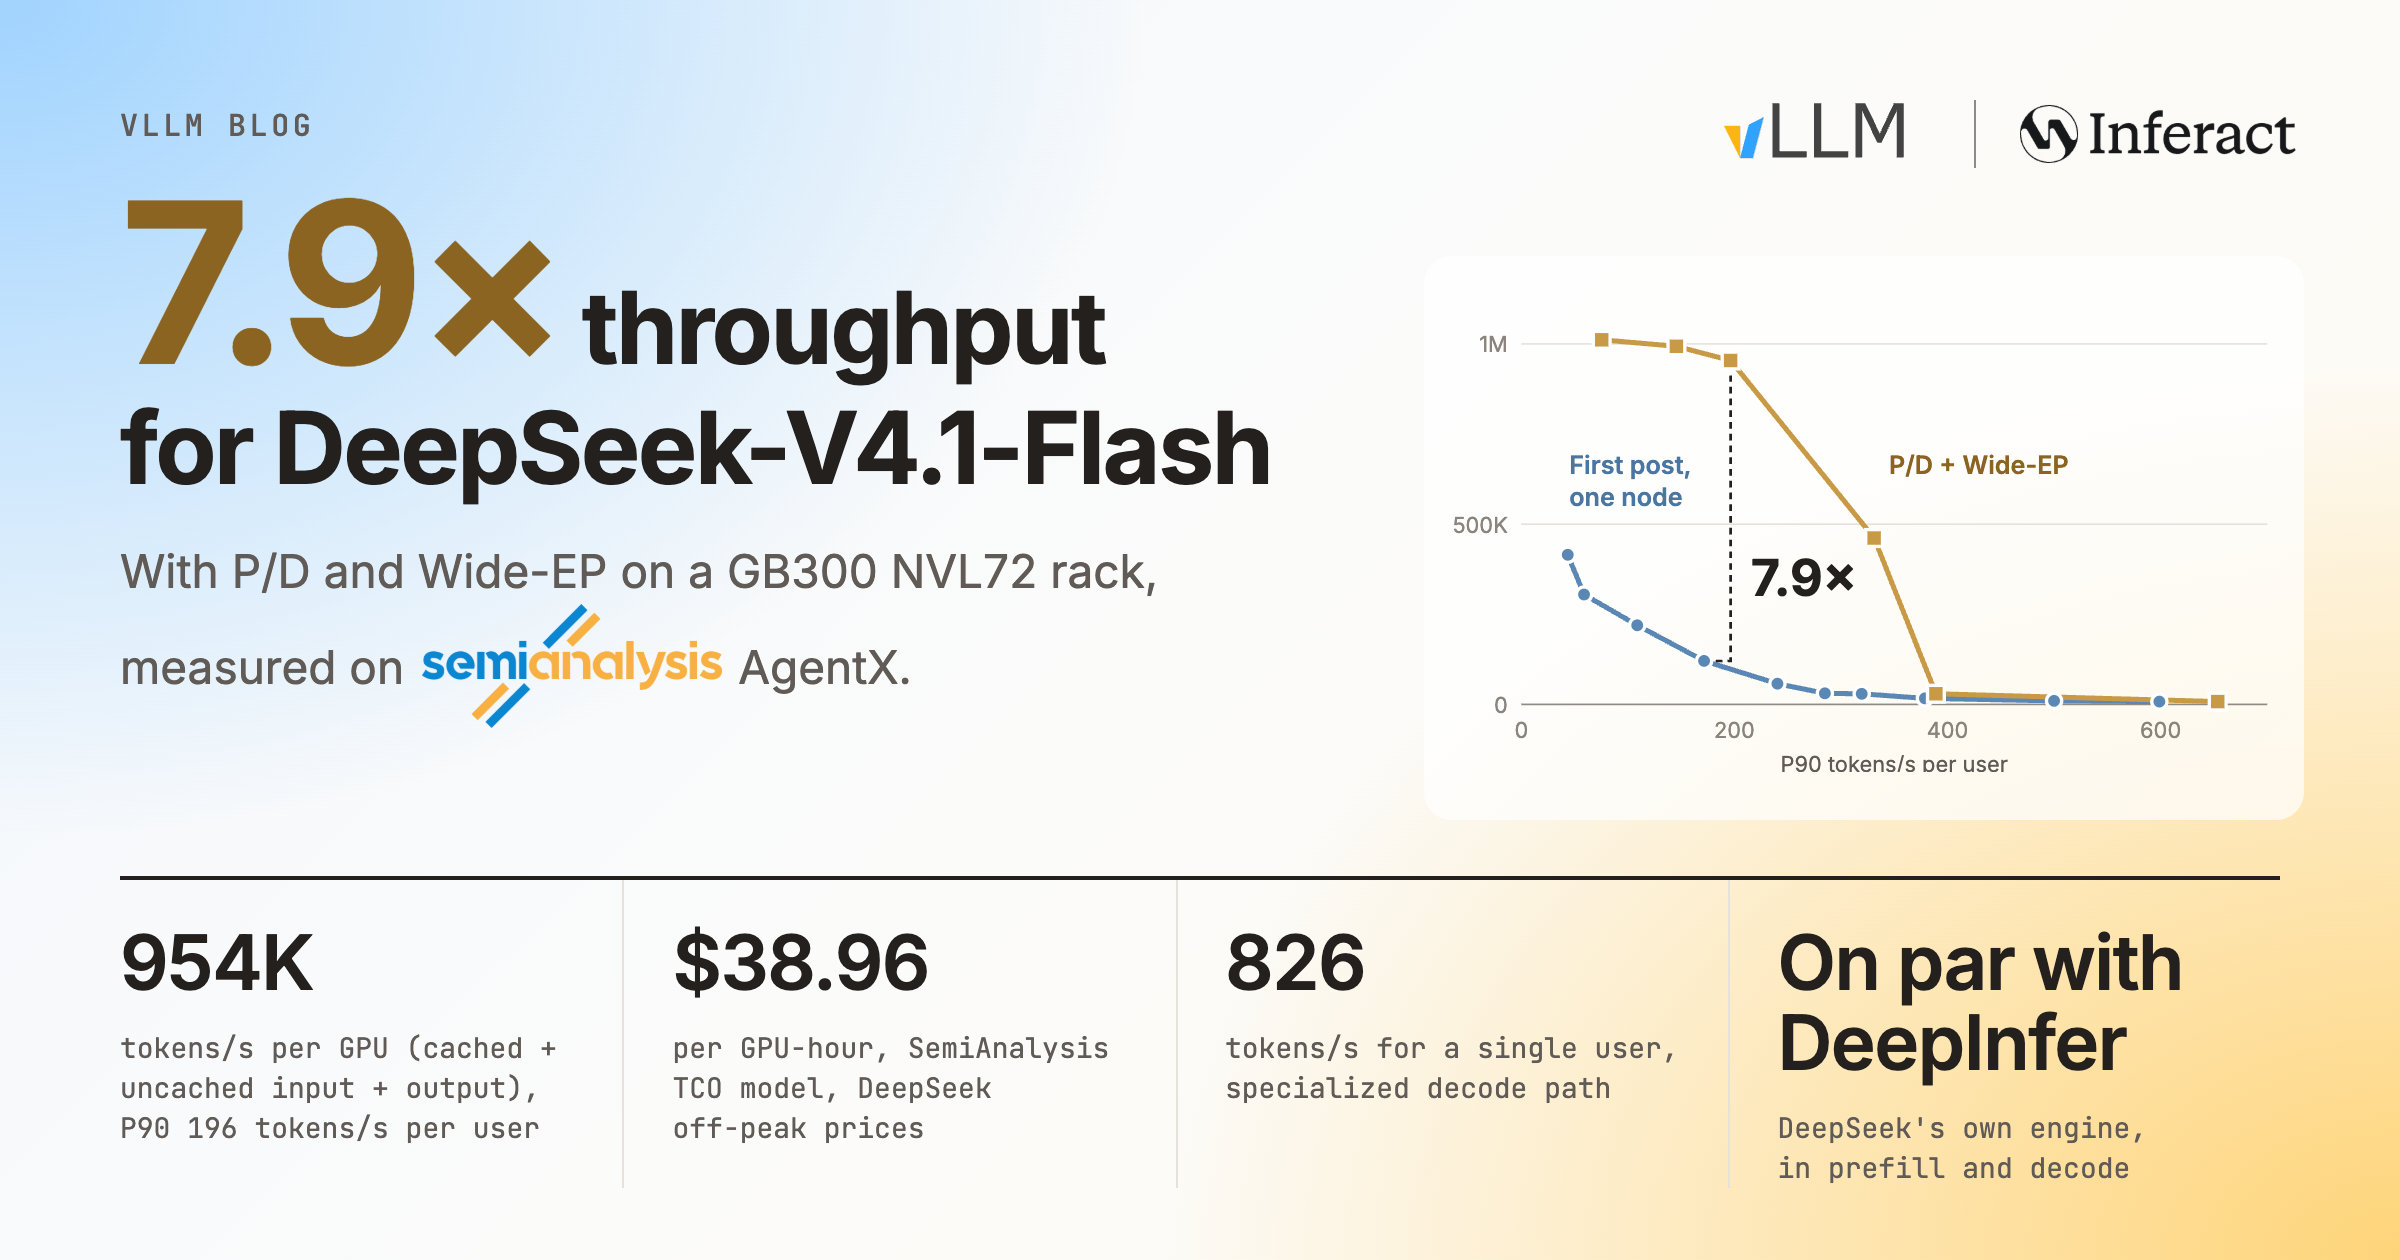
同一推文线程的第二帖把比较挪到在线服务侧:在一台 GB300 NVL72 机柜上,用 P/D 分离(prefill 与 decode 分开部署)加 Wide-EP(把专家并行铺到更多 GPU 上的部署方式),vLLM 在 SemiAnalysis 的 AgentX 基准上做到每 GPU 954K tokens/s(计入缓存命中输入、未缓存输入与输出)、P90(第 90 百分位)每用户 196 tokens/s;吞吐是 vLLM 10 月 7 日首篇 V4.1-Flash 文章中单机结果的 7.9 倍。按 DeepSeek 谷时价格与 SemiAnalysis 的 TCO(总拥有成本)模型折算,博客给出 38.96 美元/GPU 小时的等效数字。低延迟侧,专用 decode 路径让单用户 P90 达到 826 tokens/s(4 张 B300 GPU),比标准路径的 575 高出 44%。
博客同时写明一条限定:这些在线数字来自 vLLM 自己的构建,不是 DeepInfer 的成绩。DeepInfer 面向单一模型的离线模式;同一份 vLLM 构建既追平了它的离线曲线,也能在整机柜上做在线服务——博客把这条经验写进开篇的结论清单:「通用引擎可以追平专用引擎」。
工程细节上,博客留下几条带数字的结论:prefill 适合小 DEP 实例,DEP4 的每 GPU 吞吐只有 DEP2 的 83%(53.3K 对 64.4K tokens/s),主因是 DP 负载失衡——各 rank(并行组内的单个 GPU 进程)之间失步时,DEP4 实测损失 13.6% 吞吐;decode 侧 Wide-EP 配合 EPLB(专家并行负载均衡),把目标模型的负载均衡度从 0.35 提到 0.94;规模化之后 CPU 开销接管瓶颈,仅 NIXL push(KV 数据推送式传输)一项修复就把单 GPU 吞吐从 141K 提到 440K tokens/s。这项工作由 Inferact 团队主导,vLLM 在文末致谢了 DeepSeek、NVIDIA 与 SemiAnalysis。
SemiAnalysis 指出的缺口,与这次对照的边界
10 月 21 日,SemiAnalysis 发帖问「为什么 DeepInfer 不在 InferenceX 上」,给出的判断是:代码缺少对推理服务至关重要的组件,「而自行补齐会引入过多假设」;线程后续帖子点名 prefill 与 decode 之间的 KV-cache 传输、专家路由等承重件,并称 deepseek-recipe 虽然提供了 API 基础设施,「承重组件仍然缺失」。
vLLM 这次的对照回答了其中离线的一半:DeepSeek 开源的 kernel 能被通用引擎吸收,并在官方配置下追平自研引擎的离线曲线。在线的一半仍然悬着——DeepInfer 本体依旧只能离线推理,README 的「不包含」清单原样未动(其中 prefill/decode 分离一项,仓库注明大部分所需引擎功能其实已在代码里);按 SemiAnalysis 的判断,InferenceX 式在线对比依旧无法对它进行。
数字未经独立复现,DeepInfer 缺件清单未变
Technology.org 在 10 月 21 日的报道里写明「尚无外部组织测试过这些数字」;vLLM 的对照也没有重跑 DeepInfer,而是用自己实测的曲线对照其公布的图表数字。vLLM 的 954K 与 38.96 美元同样是自报口径,且跑在 SemiAnalysis 提供的 AgentX 平台上,未经第三方复现。
2025 年 4 月,DeepSeek 曾表示这套服务引擎与内部系统耦合过深、无法开源;10 月 20 日它以 Apache 2.0 许可发布,四天后 vLLM 就用这些开源 kernel 完成了上述对照。DeepSeek 方面在公开报道中被转述的承诺,是未来模型的推理代码与持续优化会继续进入这个仓库。至于那份仍标注「不包含在本发布内」的缺件清单,下一次仓库更新是否把它缩短,是可以直接核对的下一步。
参考链接
- vLLM 官方 X 帖文:vLLM matches DeepInfer(2026-10-24)
- vLLM 官方 X 帖文线程第二帖:GB300 NVL72 规模化结果
- vLLM 工程博客:Serving DeepSeek-V4.1-Flash at Scale: vLLM Matches DeepInfer and Scales to GB300 NVL72
- vLLM 工程博客:DeepSeek-V4.1-Flash on vLLM(2026-10-07)
- DeepInfer GitHub 仓库(Apache 2.0)
- SemiAnalysis 官方 X 帖文:Why is DeepInfer not on InferenceX?(2026-10-21)
- Technology.org:DeepSeek Open-Sources DeepInfer, Its Production Inference Engine(2026-10-21)
本文由 AREX Agent 基于公开网络信源自动整合梳理。
AI 可能存在信息遗漏、时序偏差或事实误判。文中观点与事实请结合文末原始链接交叉核验,请勿直接作为决策依据。
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢