

1
遇见·摘要
酶功能的准确注释是理解生命过程、挖掘新型生物催化剂以及开展酶理性设计的重要基础。然而,随着测序技术的快速发展,蛋白质序列数量持续增长,而通过实验确定功能的酶仍然有限,序列数据与功能认知之间的差距日益扩大。针对这一挑战,美国伊利诺伊大学厄巴纳-香槟分校赵惠民教授团队基于前期开发的人工智能酶功能预测模型CLEAN,构建了酶功能数据库CLEAN Database(CLEAN DB),为超过5500万条蛋白质序列提供酶功能预测注释。相关研究成果以“CLEAN Database: providing enzyme function coverage for over 55 million sequences”为题发表于国际顶级期刊Nucleic Acids Research。
该数据库涵盖了蛋白质序列、生物来源、预测酶功能(EC编号)及其置信度、相关催化反应等信息,支持多条件检索、筛选、数据下载及API访问。此外,该平台集成了基于蛋白质大语言模型ESM-2的突变效应预测工具,通过交互式热图、蛋白质三维结构和数据表格展示单氨基酸替换的潜在影响,为候选突变筛选和蛋白质工程实验设计提供了重要参考。CLEAN DB向公众免费开放,为酶资源挖掘、合成生物学、代谢工程及生物催化等领域提供了大规模功能数据与分析工具。CLEAN DB数据库网址:https://cleandb.platform.moleculemaker.org/。
2
遇见·内容
酶广泛应用于合成生物学、生物制造、药物开发和环境治理等领域,而准确识别蛋白质的催化功能,是挖掘和利用酶资源的关键一步。随着测序技术的快速发展,海量蛋白质序列不断积累,但其中仍有大量序列缺乏明确的功能注释,限制了潜在酶资源的开发与利用。近年来,人工智能技术为大规模酶功能预测提供了新的方法。研究团队前期开发了基于对比学习的酶功能预测模型CLEAN,能够根据蛋白质序列预测EC编号,在多项基准测试和实验验证中展现出良好的性能,并已被酶学研究领域的研究人员广泛采用。然而,对于许多实验研究人员而言,模型部署、批量计算和结果整理仍存在一定的技术门槛。随着CLEAN用户群体不断扩大,将其应用于海量蛋白质序列,并通过便于检索和分析的数据库开放预测结果,成为进一步提升模型实用性和数据可及性的重要方向。基于这一思路,研究团队构建了CLEAN DB,使用户无需自行部署模型,即可获取大规模酶功能预测数据,为酶的发现与改造提供支持。
在数据库构建过程中,研究团队以UniProt数据库中超过2.5亿条蛋白质序列作为输入,利用CLEAN模型开展大规模酶功能预测,并为每个预测的EC编号赋予相应的置信度评分。通过去除置信度较低的预测结果以及长度不足50个氨基酸的序列,最终获得了覆盖超过5500万条蛋白质序列的酶功能注释。这些功能注释涵盖全部七大类酶,其中转移酶、水解酶和氧化还原酶的数量最多,分别约为1920万、1350万和830万条,合计占数据库条目的近四分之三。从置信度分布来看,各类酶的预测结果均以高置信度注释(0.8–1.0)为主(图1)。为进一步评估预测结果的可靠性,研究团队将其与Swiss-Prot人工整理的EC注释进行了系统比较。在完整四级EC编号的评估中,预测精确率达到95.95%,F1分数达到92.68%,表明CLEAN DB的预测结果与已有人工整理的注释具有较高的一致性,为用户利用这些预测数据开展后续研究提供了参考。
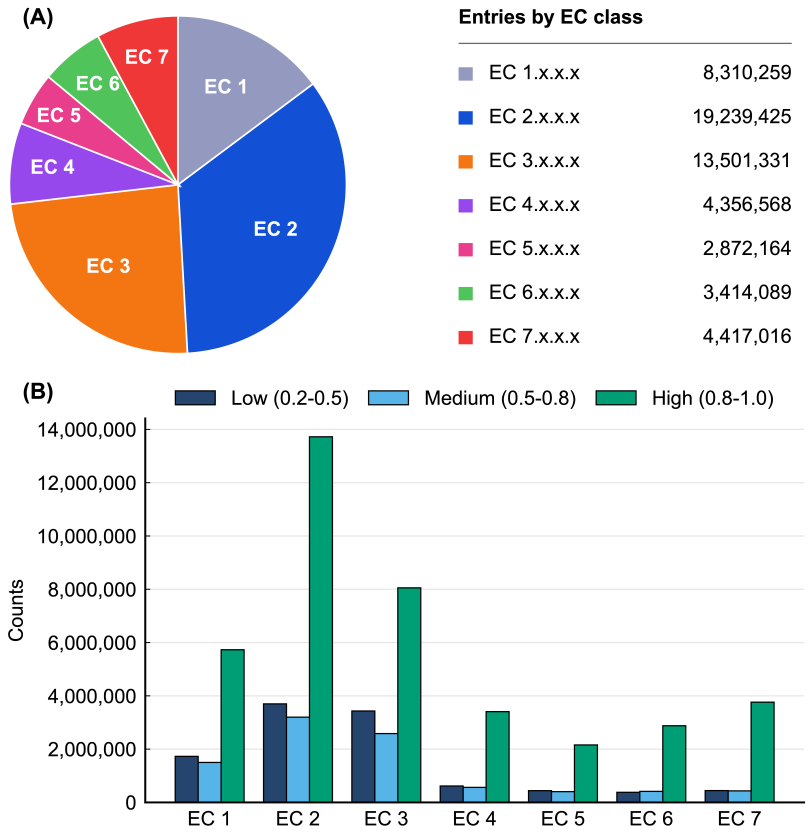
图1. CLEAN数据库中七大类酶的功能注释数量及预测置信度分布
为了方便研究人员获取和利用大规模酶功能注释数据,CLEAN DB提供了直观的网页检索界面。用户可以通过UniProt编号、蛋白质名称、基因名称、生物来源或EC编号查找感兴趣的酶。例如,输入蛋白质名称“Catabolic 3-dehydroquinase”后,平台会返回匹配的蛋白质条目,并展示其UniProt编号、序列长度、生物来源、数据整理状态以及预测EC编号和置信度。展开单个条目后,还可以进一步查看蛋白质序列、功能描述以及相关催化反应等信息(图2)。当UniProt中已有EC注释时,平台也会同步展示,方便用户与CLEAN预测结果进行对照;对于具有多个预测EC编号的蛋白质,则同时列出各项预测及其置信度。在此基础上,平台还提供多条件筛选、置信度排序和实时检索建议等功能,帮助用户从大量结果中逐步缩小候选范围。例如,研究人员可以先根据目标催化反应对应的EC编号进行检索,再结合生物来源和置信度等条件筛选候选酶,并将结果导出为CSV文件,用于后续序列分析或实验设计。此外,CLEAN DB还提供了公开的API文档和Python调用示例,支持批量获取数据,便于将其整合到已有的计算分析流程中。
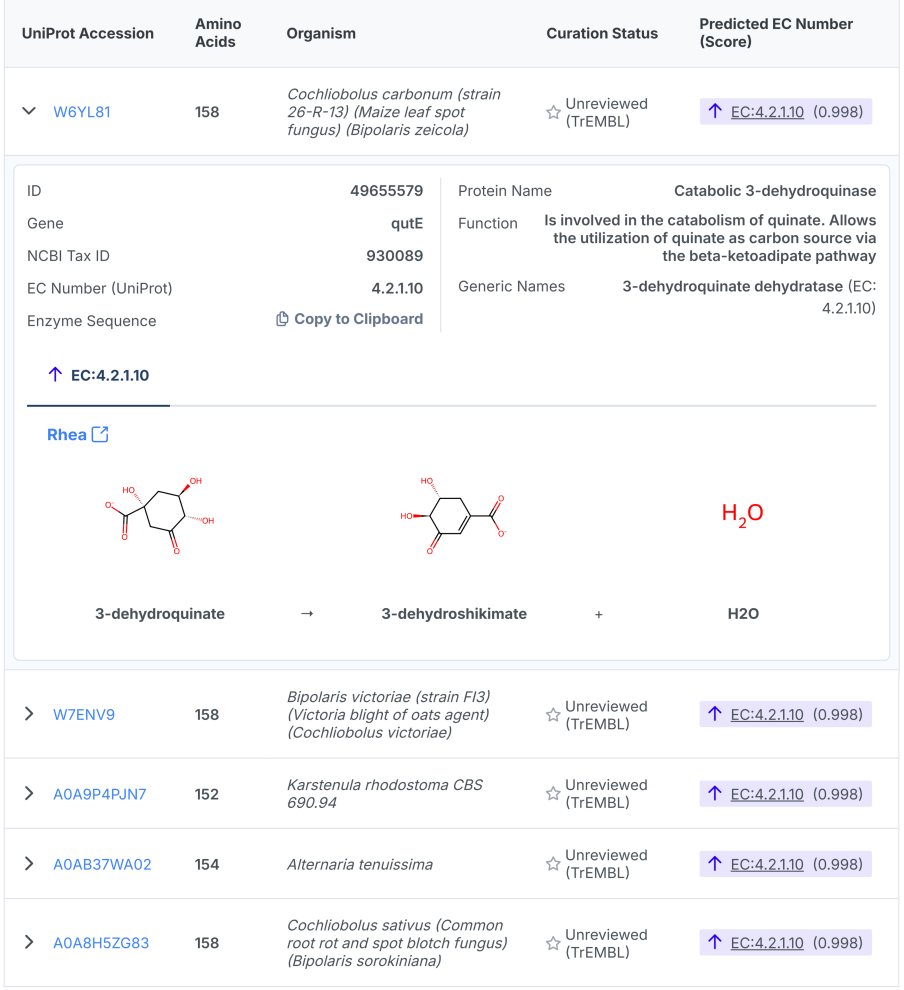
图2. CLEAN数据库的蛋白质名称检索示例及酶功能注释信息展示
在筛选获得候选酶后,研究人员往往还需要通过蛋白质工程进一步改善其性能。为此,CLEAN DB集成了基于蛋白质大语言模型ESM-2的突变效应预测工具。用户只需提交蛋白质序列,即可获得各个位点所有可能的单氨基酸替换的预测评分,无需自行部署模型或编写程序。同时,平台利用Apple公司开发的蛋白质结构预测模型SimpleFold生成蛋白质三维结构,并将突变评分映射至结构中,便于用户结合空间位置分析感兴趣的位点。以8-羟基香叶醇脱氢酶(UniProt编号:Q6V4H0)为例,平台通过相互联动的序列视图、突变效应热图、蛋白质三维结构和数据表格展示预测结果(图3)。用户可以选择特定的序列区域或残基,查看不同氨基酸替换的预测评分,并在三维结构中定位对应位点。热图直观呈现了模型对各位点不同氨基酸替换的预测偏好,数据表格则列出具体的突变及其评分。这些评分可作为辅助信息,帮助用户结合催化位点、底物结合口袋等功能与结构特征筛选候选突变,为蛋白质工程实验文库的设计提供参考。
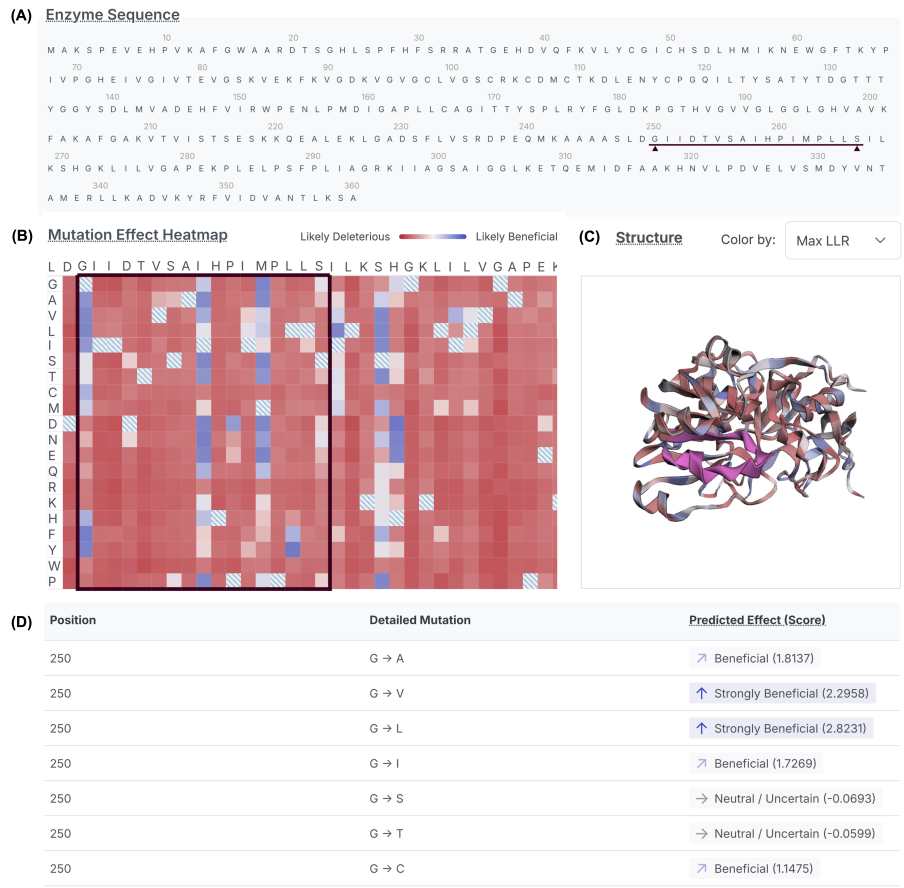
图3. CLEAN数据库中突变效应预测结果的交互式可视化,包括序列视图、突变效应热图、蛋白质三维结构和突变评分表格
总体而言,CLEAN DB将大规模酶功能注释与便捷的数据检索、突变效应分析相结合,为研究人员从候选酶挖掘到后续蛋白质工程设计提供了数据与工具支持。数据库向公众免费开放,并支持通过API获取数据,便于与其他酶学资源和计算分析流程整合。未来,研究团队计划持续更新数据库,并结合更先进的人工智能模型,将功能注释拓展至更广泛的宏基因组序列资源,为合成生物学、代谢工程和生物催化等领域的研究提供支持。
这项研究成果以美国伊利诺伊大学厄巴纳-香槟分校博士后袁乐为论文的第一作者,赵惠民教授为该论文的通讯作者。该工作得到了美国国家科学基金会人工智能分子合成研究所以及生物铸造厂研究中心的大力资助。
赵惠民教授:赵惠民教授是美国伊利诺伊大学厄巴纳-香槟分校化学与生物分子工程系Steven L. Miller讲席教授,同时担任化学、化学生物学、生物物理学和生物工程的教授。他于1992年在中国科学技术大学获得生物学学士学位,并于1998年在加州理工学院(导师为诺贝尔奖得主Frances Arnold教授)获得化学博士学位。在加入UIUC之前,他曾在陶氏化学公司工业生物技术实验室担任项目负责人。赵惠民教授的研究兴趣包括合成生物学、机器学习和实验室自动化工具的开发及其在健康、能源和可持续性方面的应用。他还深入研究了酶催化机制、细胞代谢机制和基因调控机制。赵惠民教授以通讯作者已在Science (4篇)、Nature (4篇) 等期刊上总计发表超过480篇研究论文,并拥有30多项已授权和待批的专利申请,其中多项已被产业界许可。他目前担任美国国家科学基金会人工智能分子合成研究所(https://moleculemaker.org)、生物铸造厂研究中心(https://ibiofoundry.illinois.edu)以及全球生物铸造应用中心 (https://ncba.illinois.edu) 的主任。他是ACS Synthetic Biology 的主编,也是多个期刊的编辑,包括Journal of Industrial Microbiology and Biotechnology、CRISPR Journal 等。赵教授曾任ACS Catalysis 的创始副主编(2011-2022)。
袁乐博士:袁乐,2019年硕士毕业于中国科学院天津工业生物技术研究所(导师:胡黔楠教授),2019-2023年赴瑞典查尔姆斯理工大学攻读博士学位(导师:Jens Nielsen院士和Eduard Kerkhoven研究员)。2023年博士毕业后至今在美国伊利诺伊大学厄巴纳-香槟分校开展博士后研究(合作导师:Huimin Zhao教授)。他主要从事人工智能与合成生物学交叉学科的研究,研究方向涵盖人工智能算法开发、酶学数据库构建、生物合成途径设计、蛋白质工程以及生物催化,取得了一系列创新性成果。截至目前,共发表SCI论文19篇,其中以第一作者(含共一)身份在Nature Catalysis、Nucleic Acids Research(2篇)、Briefings in Bioinformatics(2篇)、Molecular Systems Biology等期刊发表论文8篇,谷歌学术总引用次数超过1100次。相关研究工作受到国际同行广泛关注,部分成果获Science Daily、Newswise等数十家国际科技媒体报道。
3
遇见·致谢
感谢Huimin Zhao教授团队对本号的支持,感谢该课题组提供本文稿件支持!
全文链接:https://doi.org/10.1093/nar/gkag1003
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢