

DRUGONE
蛋白质中可电离氨基酸残基的质子化状态对其结构稳定性、催化活性及生物学功能具有重要影响,但准确预测其酸解离常数(pKa)仍然是计算生物学中的一项挑战。传统方法主要依赖蛋白质三维结构和物理化学计算,存在计算成本较高、预测精度有限及大规模应用困难等问题。为此,研究人员开发了基于蛋白质语言模型的序列预测框架KaML-ESMs,利用ESM2和ESMC提取残基级表示,并结合实验pKa数据及新提出的GAINES潜在空间采样增强策略进行训练。该方法能够直接从蛋白质序列预测天冬氨酸、谷氨酸、组氨酸、半胱氨酸、酪氨酸和赖氨酸六类残基的pKa值。在四类基准测试中,KaML-ESM2和KaML-ESMC对天然蛋白质的预测均方根误差约为0.5个pKa单位,优于多种传统经验方法、物理模型及机器学习方法。然而,在缺乏天然进化背景的蛋白质内部人工突变位点上,模型性能明显下降。进一步将KaML-ESM2应用于人类蛋白质组后,研究人员预测了超过187万个残基的pKa值,并展示了利用异常pKa识别功能位点和推断酶催化机制的潜力。该研究表明,蛋白质序列所蕴含的进化信息不仅能够反映结构与功能,还可能间接编码蛋白质的静电性质,为蛋白质功能研究和分子模拟提供了新的计算工具。
蛋白质的生物学功能与其内部可电离基团的质子化状态密切相关。氨基酸侧链在不同pH条件下发生质子结合或释放,会改变局部电荷分布、氢键网络及静电相互作用,进而影响蛋白质构象、配体结合和催化反应。其中,酸解离常数pKa是描述可电离基团质子化平衡的重要参数,也是理解酶催化机制、质子转移和蛋白质稳定性的关键依据。
蛋白质中残基的pKa通常不同于游离氨基酸或模型化合物中的参考值。这种偏移主要来自蛋白质内部复杂的局部环境,包括溶剂暴露程度、邻近电荷、氢键及构象变化。尤其对于催化中心或深度埋藏的可电离残基,pKa可能发生显著变化,并直接决定其在生理条件下的反应能力。
传统pKa预测主要依靠泊松–玻尔兹曼静电计算、经验模型及恒定pH分子动力学模拟。近年来,研究人员也利用蛋白质三维结构训练机器学习模型,以预测局部电离环境。然而,多数方法的预测误差仍在1个pKa单位左右。恒定pH分子动力学虽然能够更充分地考虑质子化与构象变化之间的耦合,但计算成本较高,难以应用于大规模蛋白质组研究。
与此同时,蛋白质语言模型通过学习海量天然序列中的进化规律,已经能够提取丰富的结构和功能信息。ESM系列模型在蛋白质结构预测、功能表征及残基环境识别方面表现出较强能力。这引出了一个值得研究的问题:蛋白质语言模型是否也能够从序列中学习与局部电离状态有关的信息,从而绕过对三维结构的直接依赖?
针对这一问题,研究人员提出KaML-ESMs,并进一步探索通过潜在表示相似性扩充有限实验数据的可行性,建立面向蛋白质组规模的pKa预测方法。
研究方法
研究人员以ESM2和ESMC蛋白质语言模型为基础,构建序列驱动的KaML-ESM2与KaML-ESMC预测框架。首先,从预训练模型中提取各氨基酸残基的嵌入表示,通过t-SNE分析其对可电离残基类型及pKa变化的表征能力;随后,为酸性和碱性残基分别构建四层多层感知机预测模块,以实验pKa相对于溶液参考值的偏移作为学习目标。模型首先使用结构预测模型KaML-CBT生成的合成pKa数据进行预训练,再利用修订后的PKAD-3r实验数据库开展监督训练。为缓解实验数据不足,研究人员提出GAINES(基于潜在空间采样的数据增强)策略,根据残基嵌入之间的余弦相似性,从外部蛋白质数据库中寻找具有相似生化环境的残基,并将已知实验pKa标签迁移至相似残基,形成扩充训练集。模型采用分层随机留出、序列相似性分组、独立实验数据和人工突变数据开展系统评估,同时与多种序列模型、结构模型及物理计算方法比较。最后,研究人员构建KaML预测平台,并将模型应用于人类蛋白质组,分析异常pKa与蛋白质功能位点及催化机制之间的联系。
研究结果
蛋白质语言模型能够表征残基的局部生化环境
研究人员首先考察ESM2和ESMC的残基级表示是否包含与蛋白质电离性质相关的信息。通过对PKAD-3r数据库中可电离残基的嵌入进行t-SNE降维,发现两种模型均能较好地区分天冬氨酸、谷氨酸、半胱氨酸、酪氨酸、组氨酸和赖氨酸。
其中,酸性残基与碱性残基在潜在空间中形成明显不同的分布,而化学性质相近的天冬氨酸和谷氨酸则存在一定重叠。这说明蛋白质语言模型能够识别不同氨基酸的化学特征及其所处的序列环境。
不过,模型并不能直接根据嵌入分布准确区分不同的pKa偏移。大多数正向和负向偏移残基在潜在空间中相互混合,仅有少量具有较大pKa变化的残基形成局部聚集。
值得注意的是,葡萄球菌核酸酶中人工引入的深度埋藏可电离残基,在潜在空间中表现出与天然残基不同的分布。这些残基原本处于疏水环境,人工突变后产生了天然进化过程中较少出现的电离位点。
进一步训练专门的pKa预测模块后,残基表示对pKa偏移的区分能力明显增强。消融实验显示,未经任务训练的ESM2预测误差为1.59,而经过监督训练后可降至0.75。使用较浅层表示时,预测误差明显高于使用深层表示。
这些结果说明,蛋白质语言模型虽然没有直接学习pKa标签,但其深层表示已经包含与局部生化环境有关的信息,需要进一步通过任务特异性训练才能转化为准确的静电性质预测。
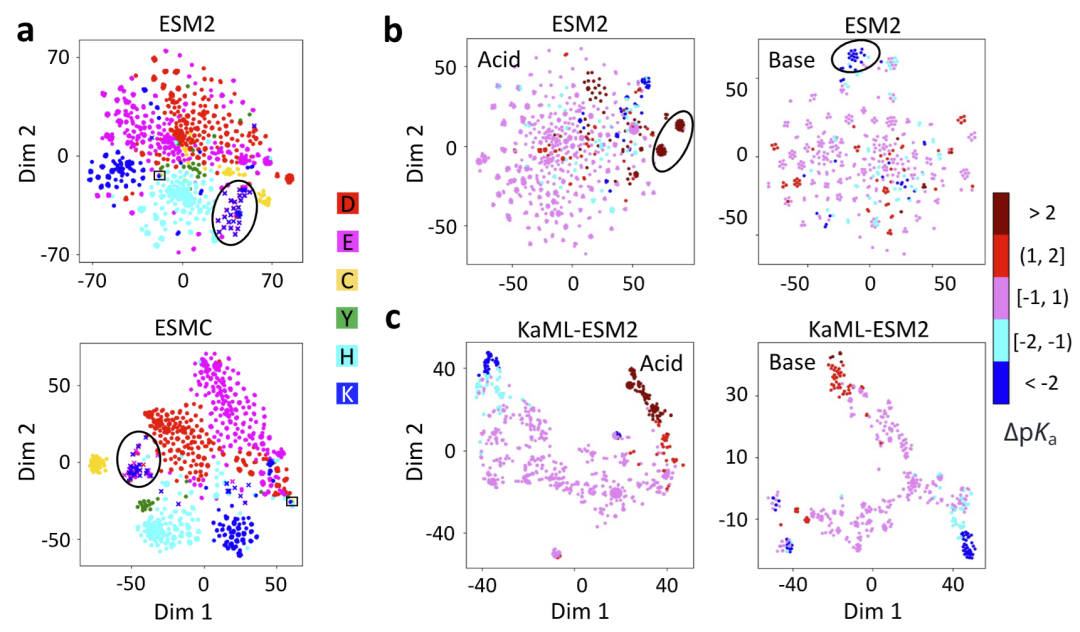
图1. ESM蛋白质语言模型对可电离氨基酸及残基pKa偏移信息的表征能力。
GAINES通过潜在空间采样缓解实验数据不足
实验pKa数据的稀缺性是限制机器学习模型性能的重要因素。PKAD-3r数据库虽然包含1205个实验pKa测量值,但不同残基类型的数据分布明显不均。其中,半胱氨酸和酪氨酸的实验数据尤其有限,导致常规训练模型在这两类残基上的预测误差较大。
为解决这一问题,研究人员设计了GAINES数据增强策略。其核心思想是,具有相似蛋白质语言模型表示的残基,即使来自进化距离较远、序列相似性较低的蛋白质,也可能具有相似的局部生化环境及电离性质。
具体而言,GAINES将具有已知实验pKa的残基作为查询对象,在外部蛋白质数据库中搜索嵌入表示高度相似的残基。当余弦相似性超过0.8时,将查询残基的实验pKa作为对应残基的合成标签。
通过这一方法,研究人员从2164种蛋白质中获得4220个残基的增强数据,使训练样本规模显著扩大。
以大肠杆菌谷氧还蛋白3中的Cys12为例,其实验pKa约为4.125。GAINES在来自不同物种的蛋白质中识别出10个具有相似表示的半胱氨酸残基。尽管这些蛋白质的整体和局部序列一致性多数低于40%,结构分析却显示目标半胱氨酸周围具有高度相似的局部环境。
这一结果表明,GAINES不仅是在寻找序列相近的蛋白质,还能够识别跨序列背景保守的局部生化特征。
利用增强数据重新训练后,KaML-ESM2的总体预测误差从0.70下降至0.48,KaML-ESMC则从0.66下降至0.53。其中,半胱氨酸和酪氨酸等低样本残基的改善尤为明显。
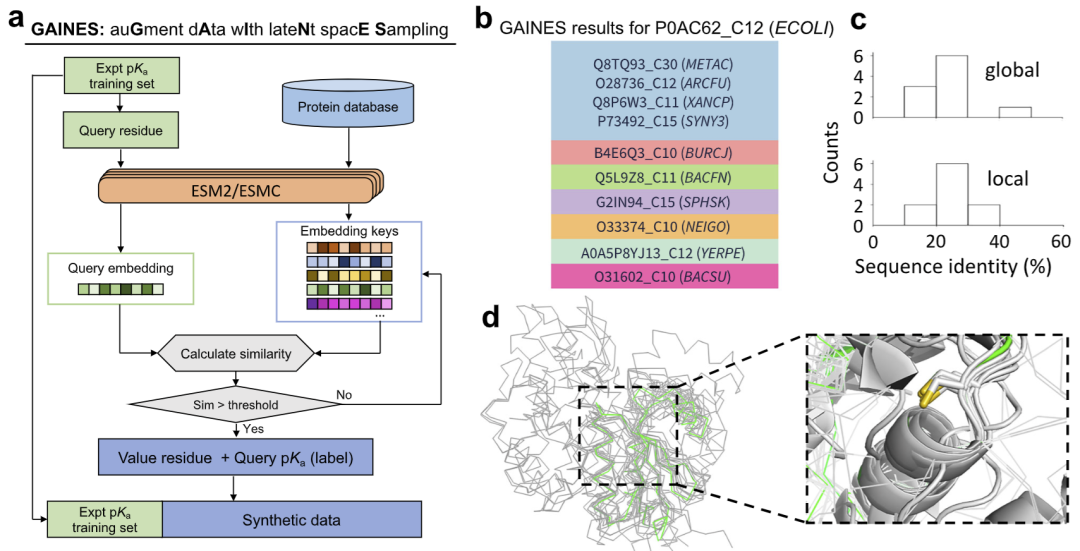
图2. GAINES潜在空间数据增强策略及其对保守局部生化环境的识别。
数据增强的有效性取决于潜在表示的生化相似性
为了确认GAINES带来的性能提升并非简单来自样本数量增加,研究人员开展了系统性消融实验。
首先,将原始训练数据直接重复十倍,发现模型性能与未增强时基本一致。这表明,单纯增加重复样本无法提供额外的有效信息。
随后,研究人员根据不同的嵌入相似性区间构建增强数据。结果发现,当相似性处于0.2–0.4或0.4–0.6时,增强数据反而使预测误差增加,分别较常规训练提高约0.20和0.07个pKa单位。当相似性为0.6–0.8时,模型性能与基线相近。
只有在相似性超过0.8时,预测误差才明显下降,较常规训练改善约0.22个pKa单位。
这一结果说明,GAINES的关键不在于生成更多训练样本,而在于筛选具有相似生化环境的残基,从而保证标签迁移具有合理的物理化学基础。
研究人员进一步将GAINES应用于基于蛋白质结构的KaML-CBT模型,发现半胱氨酸、组氨酸、酪氨酸和赖氨酸的预测误差同样降低,尤其在实验数据较少的残基类型中效果更明显。
这些发现说明,基于蛋白质语言模型潜在空间的数据增强并不局限于序列预测任务,也可以为结构驱动的分子性质预测提供额外监督信息。
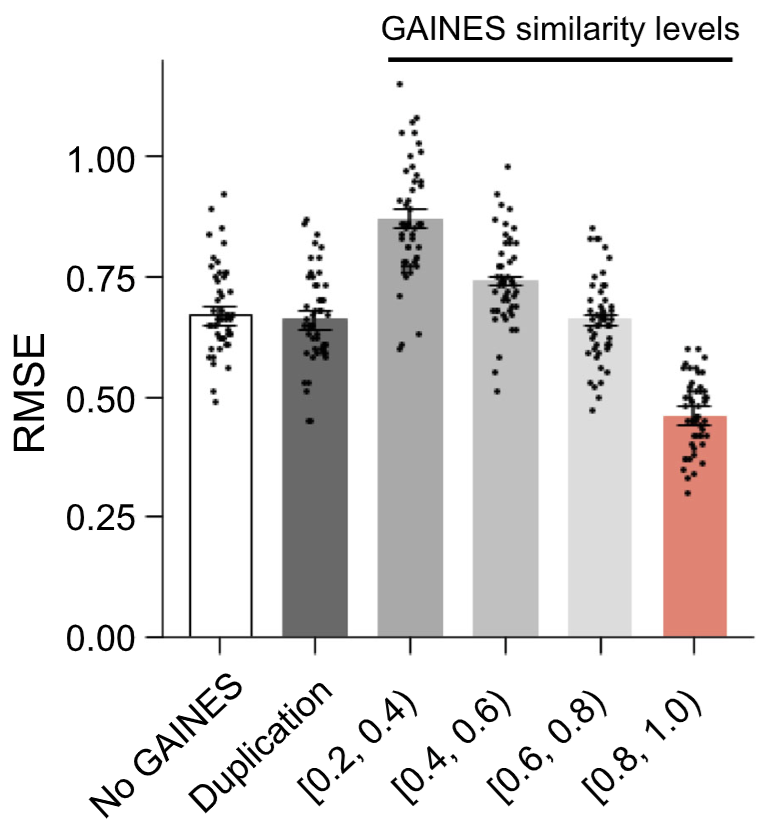
图3. GAINES数据增强策略的消融实验及嵌入相似性对pKa预测精度的影响。
天然蛋白质与人工突变位点揭示模型的泛化边界
研究人员进一步通过不同数据划分方式和独立测试集验证KaML-ESMs的预测能力。
在50组随机留出测试中,KaML-ESM2和KaML-ESMC的总体均方根误差分别为0.48和0.53。通过CD-HIT降低训练集与测试集之间的序列相似性后,两种模型仍取得0.43和0.48的误差,说明预测性能并不完全依赖同源序列之间的信息共享。
在包含160个实验pKa值的EXP67S基准中,两种模型的误差分别为0.52和0.56。在独立发表的实验数据上,误差进一步达到0.42和0.39,表明模型对天然蛋白质中的可电离残基具有较好的泛化能力。
然而,当研究人员使用89个葡萄球菌核酸酶人工突变位点进行测试时,模型性能显著下降。对于训练时未接触这类突变环境的模型,KaML-ESM2和KaML-ESMC的误差分别达到2.76和1.98。
这些人工突变将可电离残基引入蛋白质内部原本疏水的区域,产生了缺乏天然进化支持的局部环境,因此语言模型难以根据已有序列规律准确推断其电离行为。
为进一步检验监督学习是否能够弥补这一不足,研究人员选择V66和V74两个突变位置,在训练集中加入位于其他位置的人工突变数据,同时避免直接使用测试位点附近的突变信息。
结果显示,六个目标突变残基的总体预测误差从3.15下降至1.61,部分天冬氨酸和谷氨酸突变的误差显著减小。
这说明,虽然蛋白质语言模型依赖天然进化信息,但针对非天然环境引入适当的监督数据,仍然可以改善其预测能力。
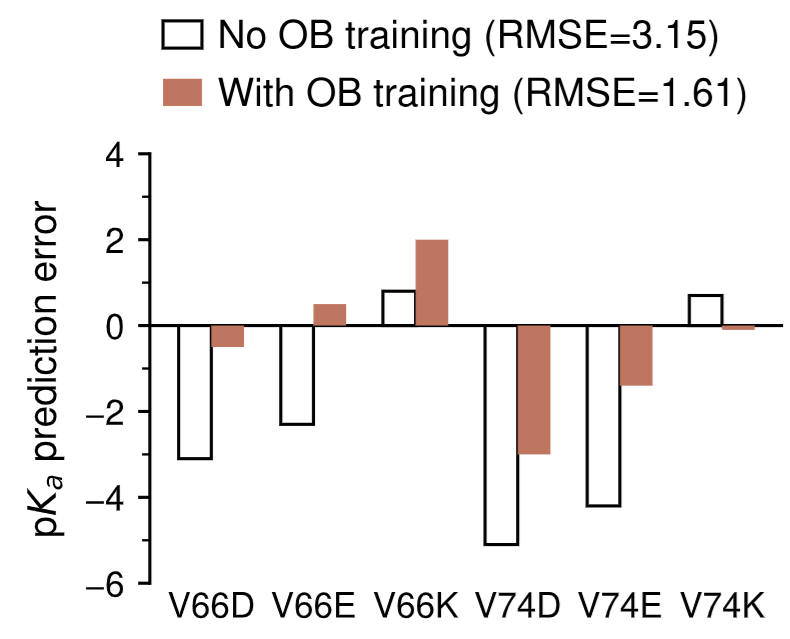
图4. 人工埋藏可电离残基的pKa预测误差及监督训练对模型性能的改善。
KaML平台实现序列驱动的蛋白质pKa预测与可视化
为提高模型的实际可用性,研究人员进一步开发了KaML预测平台,将序列预测、结构建模和结果可视化整合到统一工作流程中。
用户可以通过蛋白质序列、UniProt编号、PDB编号或自定义结构文件提交预测任务。系统使用ESM2或ESMC生成残基级嵌入,并分别调用酸性和碱性残基预测模块,输出各可电离残基的pKa值、预测标准误差及相对于参考值的偏移。
当缺少实验结构时,平台还可以利用ESM3生成三维结构,并通过结构依赖的KaML-CBT2模型开展补充分析。
研究人员以人类去泛素化酶UCHL1作为案例,展示了KaML平台的功能。该蛋白具有由Cys90、His161和Asp176组成的保守催化三联体,其质子化状态与催化机制密切相关。
KaML-ESM2预测Cys90的pKa为4.67,His161为6.95,Asp176为2.37。这些数值提示,Cys90在生理pH条件下倾向于形成具有亲核反应能力的去质子化状态,His161可能参与质子转移,而Asp176则有助于稳定催化中心的电荷分布。
通过将预测结果映射至蛋白质结构,研究人员能够直观识别pKa发生明显偏移的残基,并结合空间位置和局部相互作用分析其潜在功能。
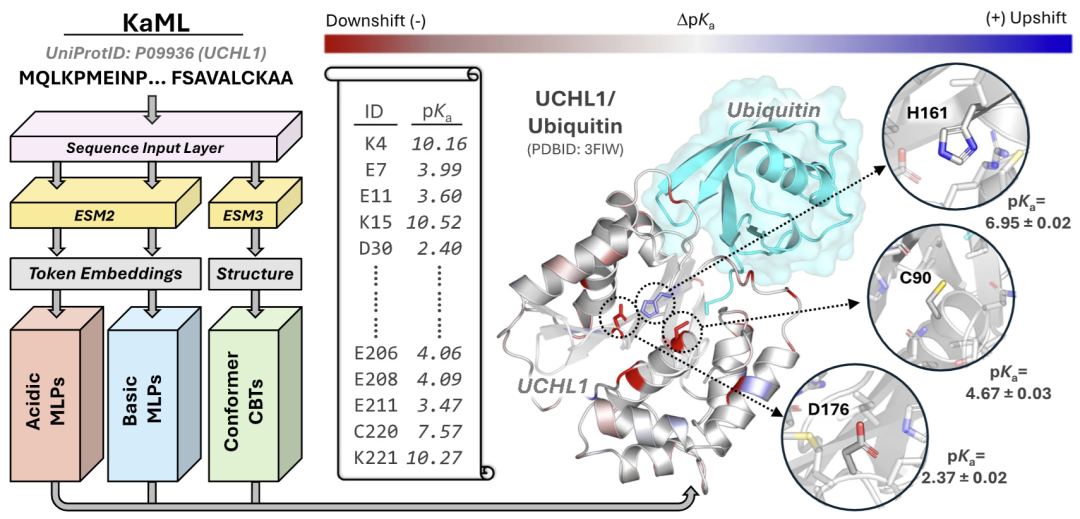
图5. KaML预测平台的整体架构及UCHL1催化中心的pKa预测与结构可视化。
人类蛋白质组分析揭示异常pKa与蛋白质功能之间的联系
研究人员进一步将KaML-ESM2应用于整个人类蛋白质组,以探索序列驱动的静电性质预测能否用于大规模功能位点发现。
在18,192种由不同基因编码的蛋白质中,模型共预测了1,877,704个可电离残基的pKa值。由于ESM2存在序列长度限制,1882种较长蛋白质未纳入分析。
整体结果显示,六类可电离残基的预测pKa中位数与对应的溶液参考值相差约0.3–0.4个单位,说明大多数天然残基的电离行为与其常规化学性质基本一致。
然而,少量残基表现出明显异常的pKa偏移,而这些变化可能与特殊生物学功能有关。
研究人员重点分析了130个预测pKa低于5的半胱氨酸残基。由于半胱氨酸在较低pH下即可发生去质子化通常意味着其局部环境有利于形成硫负离子,这些位点可能具有较强的亲核反应能力。
通过Pfam蛋白质家族注释,研究人员发现这些低pKa半胱氨酸与多种具有催化功能的蛋白质家族相关。在30种泛素水解酶中,29个对应的半胱氨酸被已有功能注释确定为催化亲核残基,剩余一个来自无活性的泛素水解酶U17L4。
UCHL1中的Cys90进一步提供了具体的机制解释。结合Cys90、His161和Asp176的预测pKa,研究人员推断,Cys90形成的亲核性硫负离子能够攻击待切割肽键的羰基碳,形成四面体中间体,随后在His161介导的质子转移作用下促进键断裂和产物释放,而Asp176参与稳定催化中心。
这一推断与UCHL1已知的结构及催化机制相符,说明蛋白质语言模型预测的pKa不仅可以描述残基的静电性质,还能够为功能位点识别和酶催化机制分析提供有价值的线索。
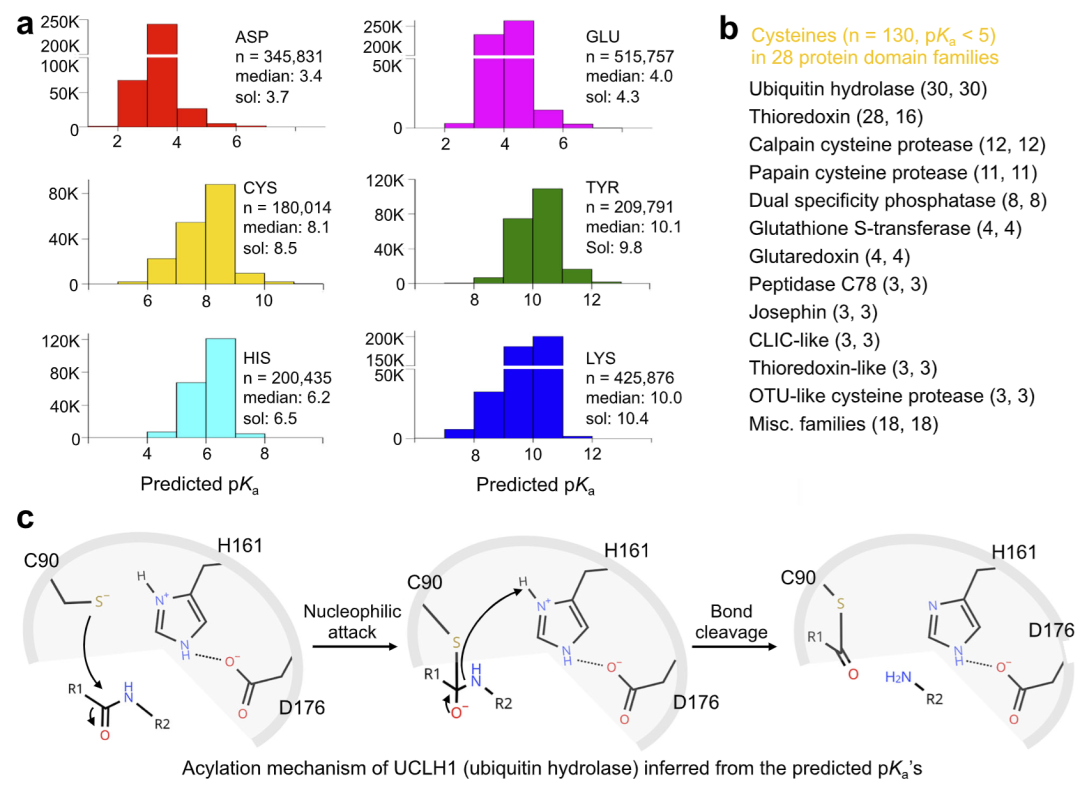
图6. 人类蛋白质组的pKa分布、低pKa半胱氨酸功能富集及UCHL1催化机制分析。
讨论与结论
本研究表明,蛋白质语言模型能够从天然序列中提取与残基电离行为相关的信息,并通过少量任务特异性监督实现较高精度的pKa预测。KaML-ESMs在多个天然蛋白质基准中的误差约为0.5个pKa单位,优于研究中比较的多种经验、物理及机器学习方法,说明蛋白质序列所蕴含的进化背景能够间接反映局部静电环境。
GAINES是另一项重要贡献。该策略利用潜在表示相似性,在序列差异较大的蛋白质之间寻找生化环境相近的残基,有效缓解了实验数据不足的问题。不过,其有效性依赖于预训练模型能否准确表征局部环境,低质量的相似性匹配可能引入错误标签。
研究也揭示了序列模型的局限性。对于缺乏天然进化支持的人工埋藏突变,预测误差明显增加;此外,单纯依赖序列的模型难以直接描述不同蛋白质构象之间的电离平衡变化。未来可通过引入更多人工突变实验数据、恒定pH分子动力学结果及蛋白质构象信息,进一步改善复杂环境下的预测能力。
总体而言,KaML-ESMs将蛋白质语言模型的应用从结构与功能预测拓展到了静电性质建模,并展示了其在蛋白质组功能注释和催化机制研究中的应用潜力。随着训练数据和结构信息的进一步整合,该方法有望为蛋白质工程及生物分子模拟提供更加高效的计算支持。
整理 | DrugOne团队
参考资料
Shen, M., Dayhoff II, G.W., Kortzak, D. et al. Predicting protein electrostatics with protein language models. Nat Commun (2026).
https://doi.org/10.1038/s41467-026-78406-y
内容为【DrugOne】公众号原创|转载请注明来源
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢