

大型语言模型(LLM)通过学习海量的人类文本,在众多任务中取得了显著进展。这种训练范式赋予了LLM生成流畅、符合语境的语言的能力,但也带来了一个根本性的限制:模型学习的是模仿人类推理的结果(如文本记录),而非推理本身的认知过程。因此,LLM在需要结构化探索、基于语境的符号计算或深思熟虑的规划等任务上始终面临挑战——而这些能力在人类身上部分地独立于语言之外运作。
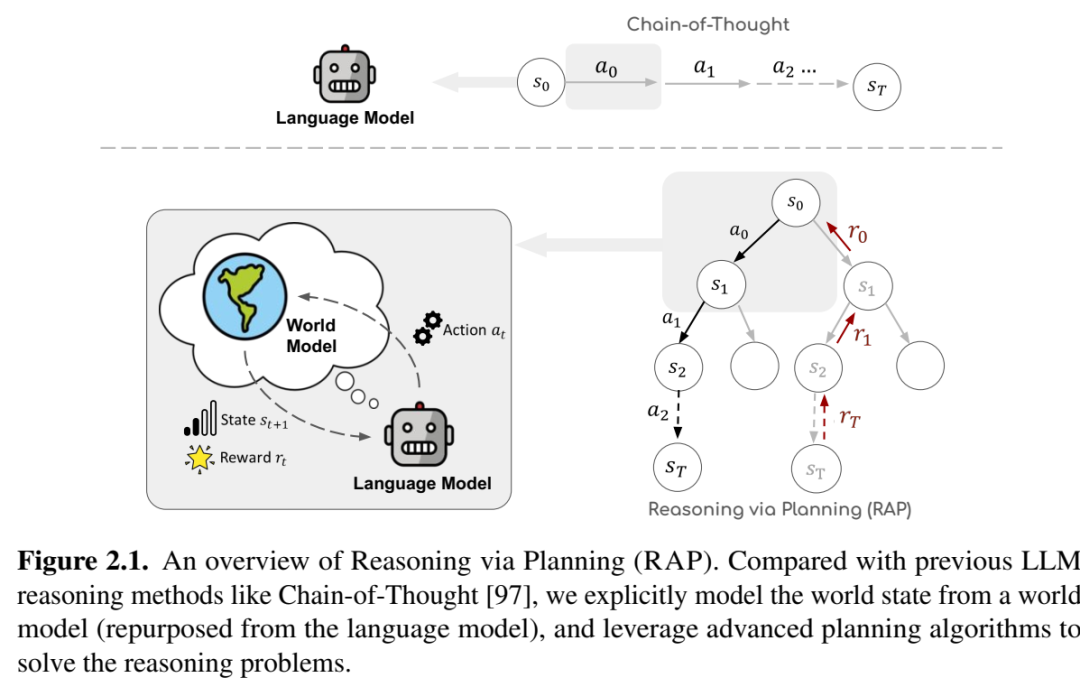
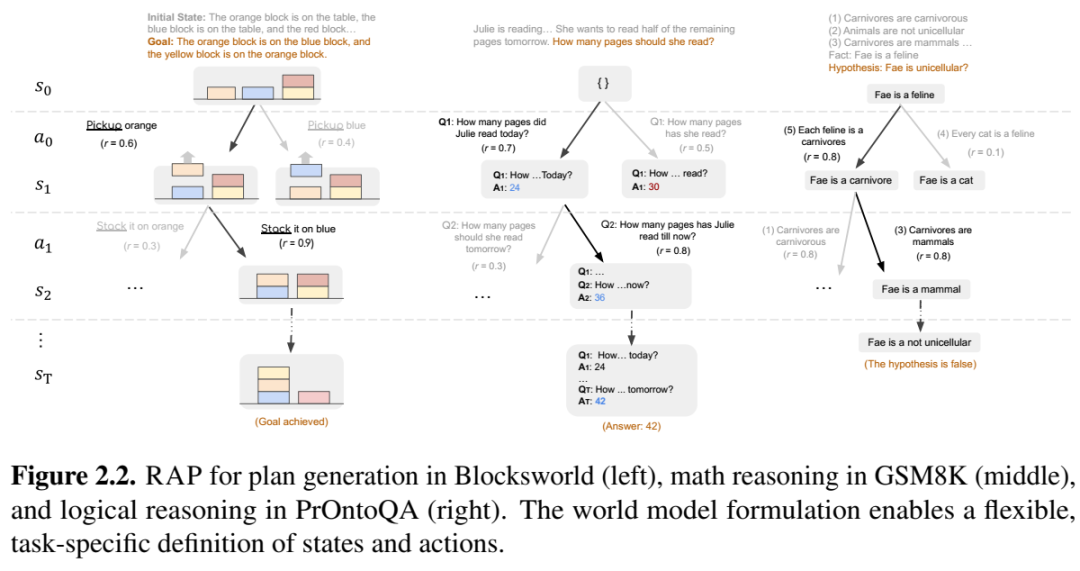
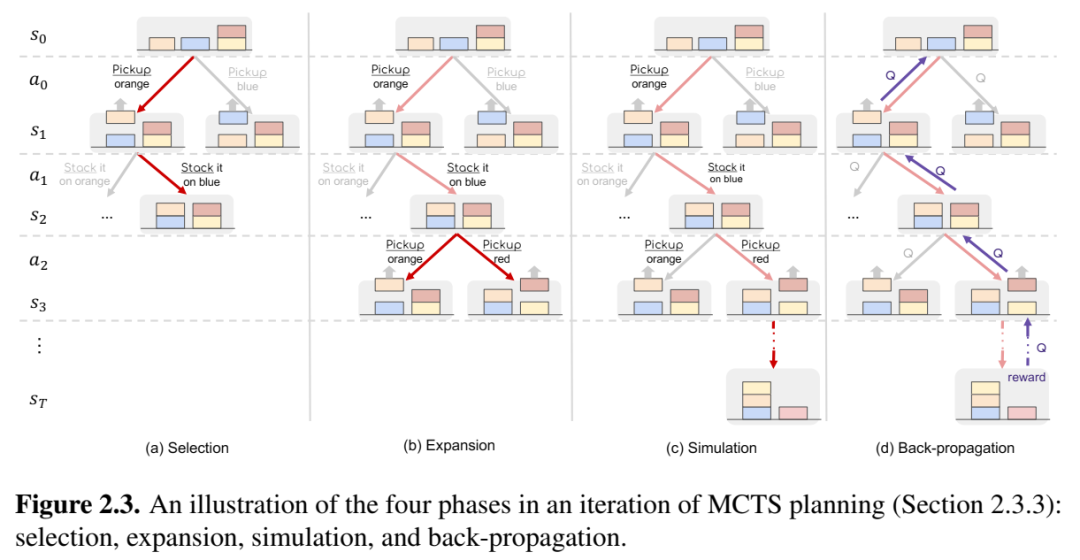
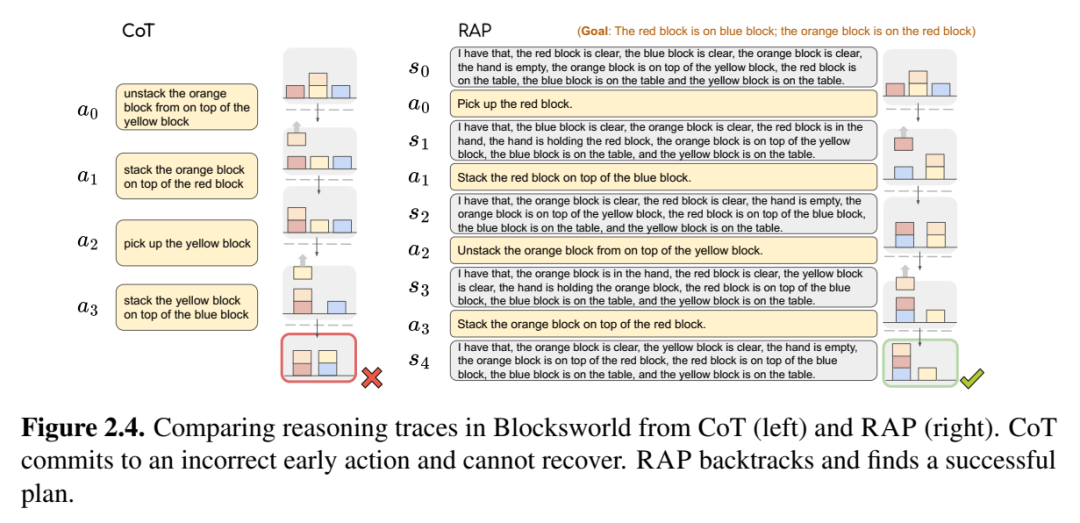
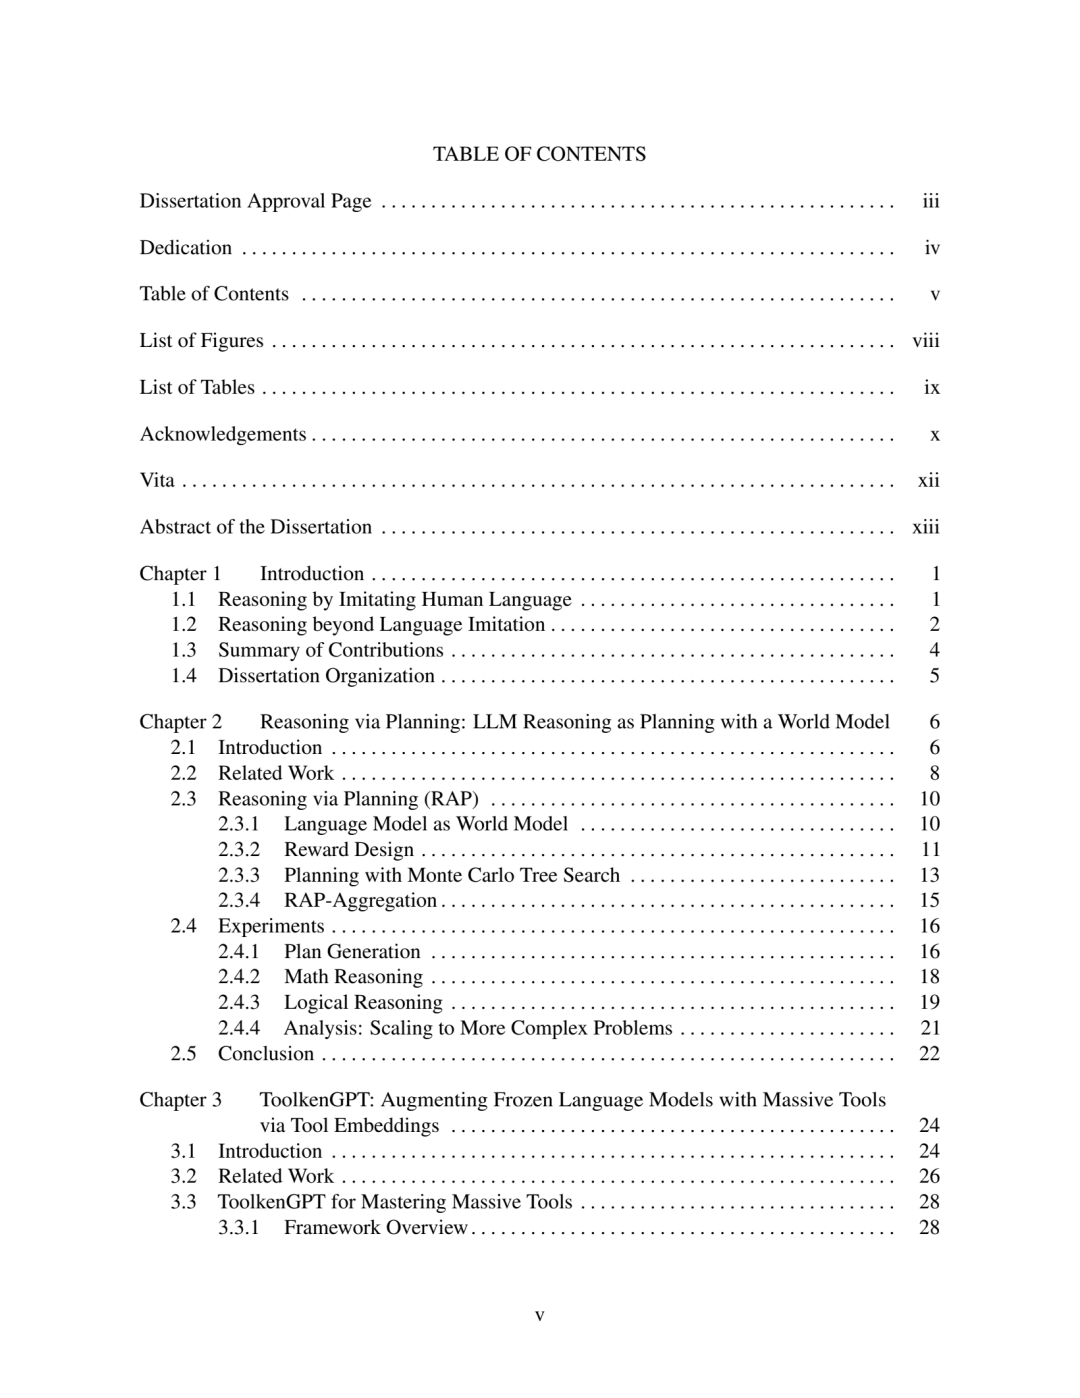
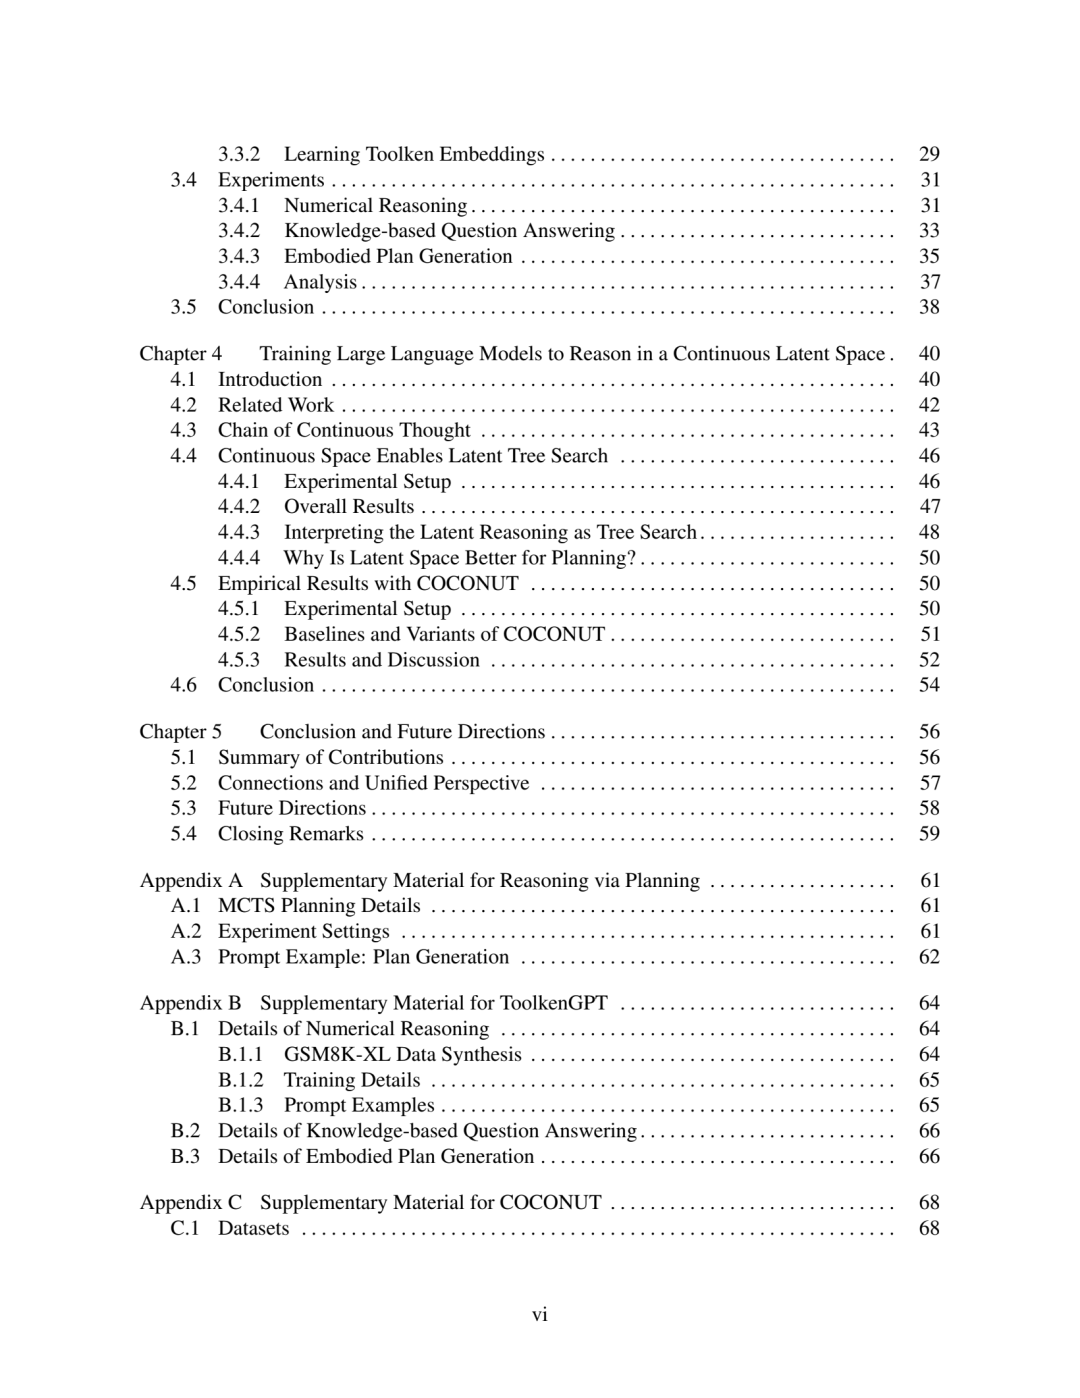
本论文探讨了三种不同的方法,旨在突破语言模仿的限制,使语言模型推理能力得到提升。首先,我们将LLM推理重新定义为一个规划问题。“基于规划的推理”(RAP)方法将同一个语言模型同时用作推理主体和世界模型,从而能够通过蒙特卡洛树搜索对推理空间进行结构化探索。通过显式模拟世界状态并评估奖励,RAP 使语言学习模型 (LLM) 能够回溯错误的推理步骤并找到高质量的解决方案——仅使用 330 亿参数的模型,在规划生成基准测试中就取得了超越 GPT-4 的结果。
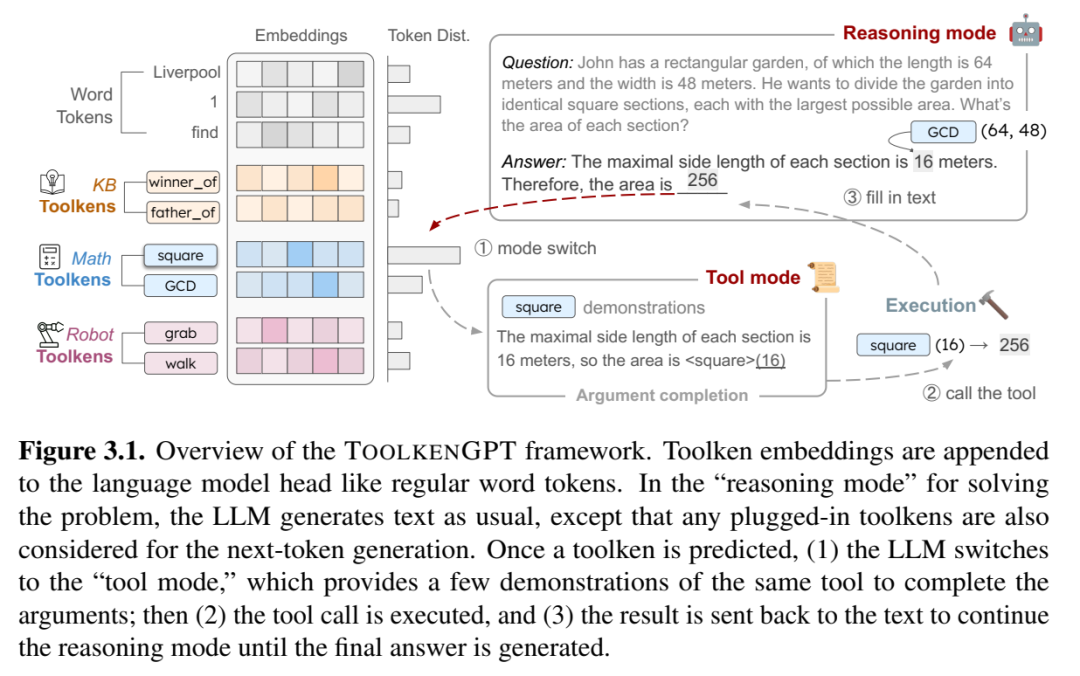
其次,我们解决了语言文本无法教授符号计算的局限性。ToolkenGPT 通过将每个工具视为附加到模型词汇表的特殊“toolken”嵌入,为冻结的 LLM 添加外部认知工具。这种轻量级方法——仅训练 toolken 嵌入,同时保持 LLM 冻结——使模型能够以即插即用的方式掌握任意数量的工具,从而提高数值推理、基于知识的问答(支持 200 多个 API 工具)以及具身规划生成方面的性能。
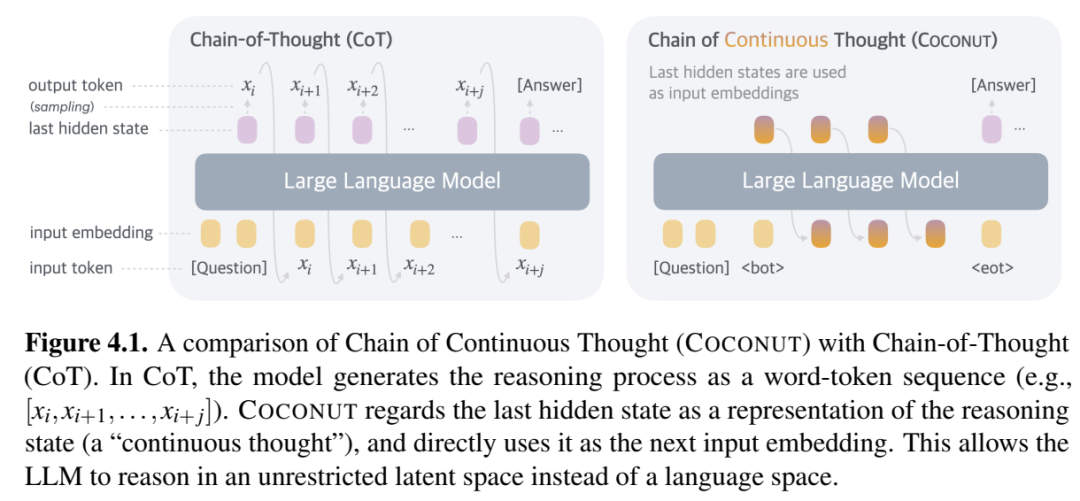
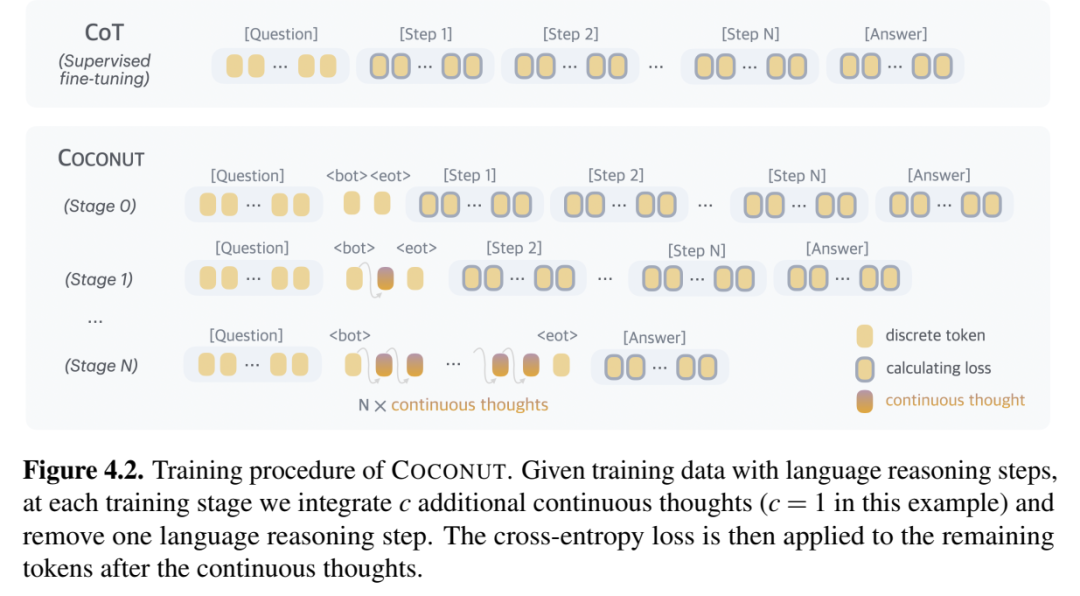
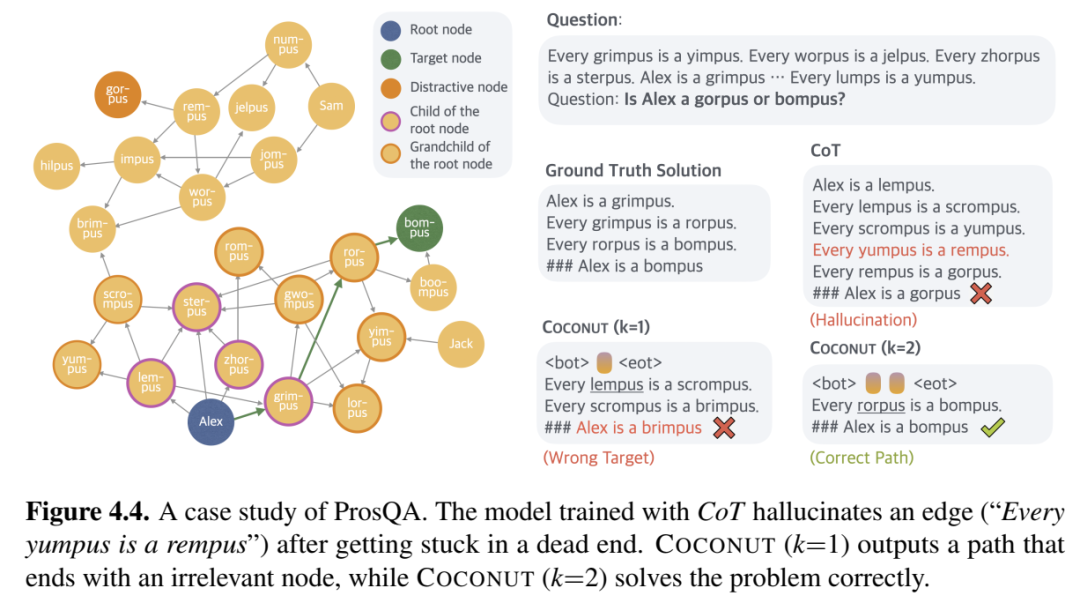
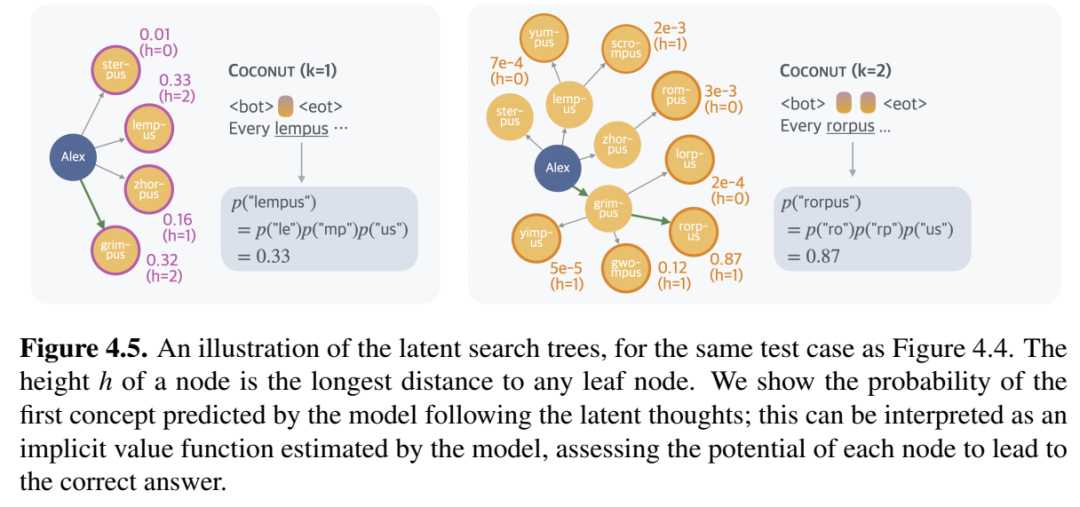
第三,我们质疑语言标记是否是进行推理的合适媒介。连续思维链(COCONUT)通过将最后一个隐藏状态直接作为下一个输入嵌入反馈给语言模型头部,绕过语言模型头部,训练语言学习模型(LLM)在连续的潜在空间中进行推理。这种简单的改进产生了一种类似广度优先搜索的涌现推理模式:连续的思维可以同时编码多个候选推理路径,使模型能够延迟做出决定,并以比基于语言的思维链更少的词元收敛到正确答案。
这三项工作共同展示了机器推理从单纯依赖语言模仿的系统性演进:从对语言推理路径的结构化搜索,到基于符号化的外部工具,再到完全摆脱语言词元的推理。
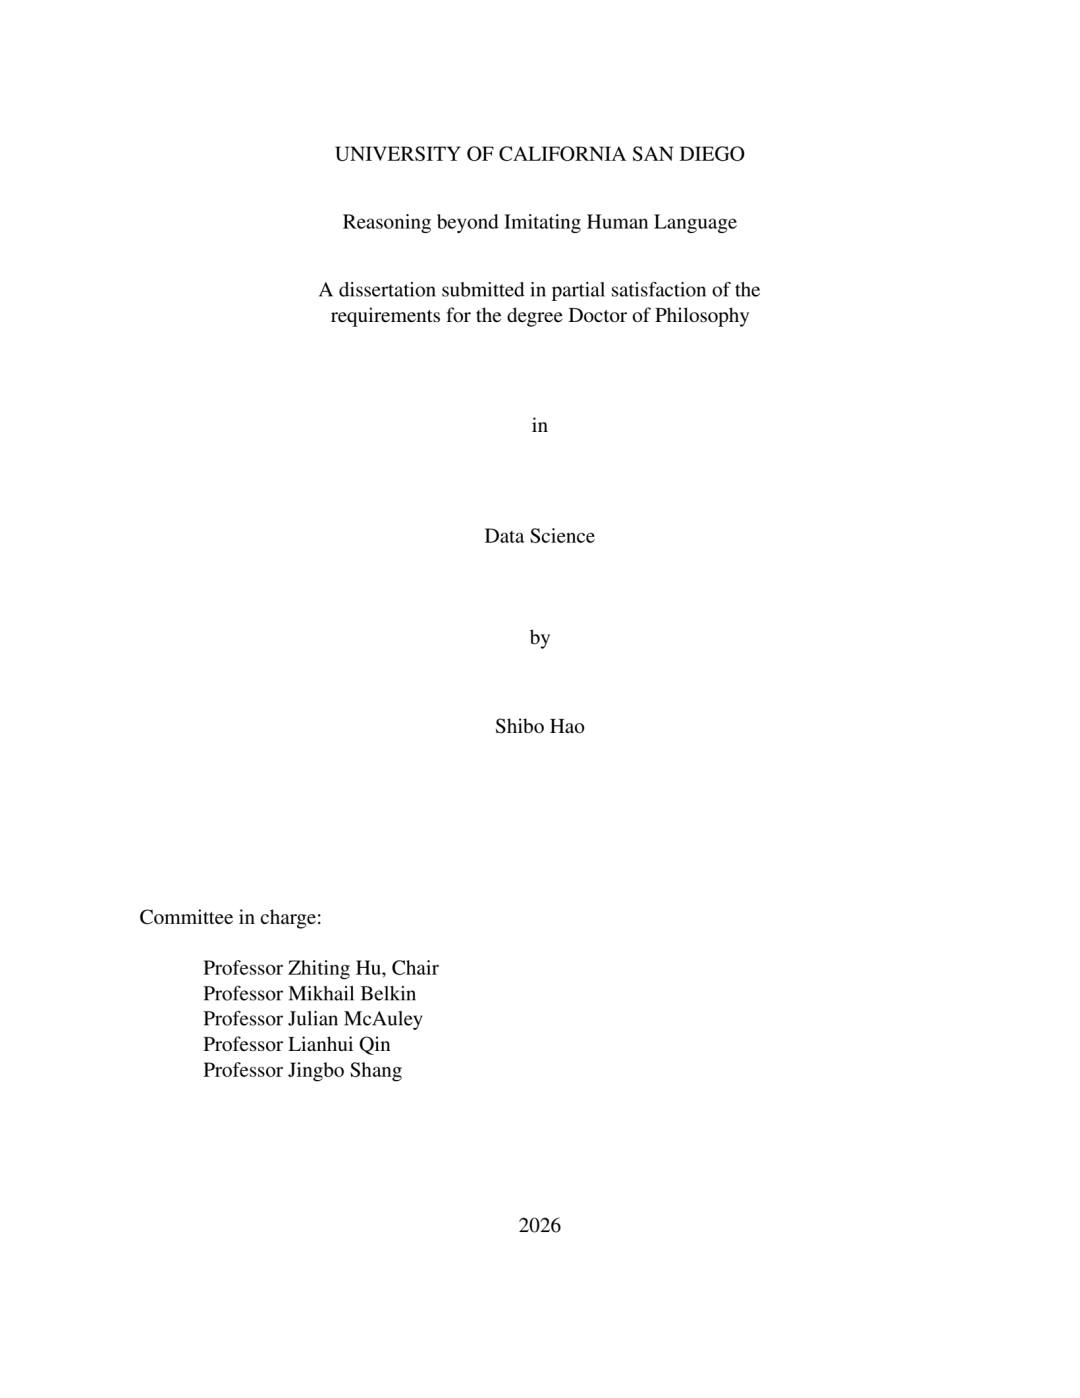
论文题目:Reasoning Beyond Imitating Human Language
作者:Hao Shibo
类型:2026年博士论文
学校:University of California San Diego(美国加州大学圣地亚哥分校)
请索引第154篇博士论文
 |  |

内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢