

AI制药正在面对一个新的问题:当模型能够预测性质、生成分子之后,谁来决定下一步做什么,以及如何根据实验结果调整研究路线。
智能体试图承担这部分工作。而其价值,则是取决于它能否把分散的工具连接成可验证、可纠错的研究过程。
2026年10月12日,浙江大学药学院侯廷军等在npj Drug Discovery发表观点文章,梳理智能体在药物发现中的应用,并提出六级自主性框架。文章提供了一套判断能力边界的思路:哪些工作已经可以交给AI,哪些环节仍离不开科学家的判断。
从执行单项任务,到组织研究流程
预测分子活性、生成蛋白序列、规划合成路线,分别回答了研发中的局部问题。真正推进项目,还要决定如何组合这些结果。当结合能力、溶解度和合成难度之间出现冲突,研究者需要判断先验证哪项假设,再根据结果修改方案。
智能体将大语言模型与外部工具、任务记忆连接起来。模型负责拆分目标、选择行动;专业软件和实验平台执行计算或操作;返回的数据影响下一步计划。它的关键能力,是在执行过程中根据反馈调整路径。
以先导化合物优化为例,一个有用的系统需要记住上一轮改动、对应的实验结果及尚未解决的问题,再安排新的设计与测试。这形成“设计—合成—测试—分析”的DMTA循环。若系统只是依次运行预先写好的程序,即使最后由大模型生成报告,也不能据此认定它具有自主研究能力。
多智能体可以进一步分工,例如分别负责文献、分子设计和数据分析。但分工也增加了信息传递与协调成本。对步骤明确、规则稳定的任务,固定工作流往往更容易控制;是否需要智能体,应由任务中的决策需求决定。
六级自主性,区分工具调用与研究闭环
作者从科学决策、系统自主性和人工参与程度三个维度,将系统划分为L0至L5。这是论文提出的分析框架,并非已经统一的行业认证标准。
L0是完成单项计算的工具;L1在固定流程中加入大模型,用于解释、翻译或生成报告。两者的执行路径仍由预设规则或人工决定。
L2开始具备任务调度能力:能够拆分目标、调用工具、保存任务状态,并修复部分接口错误。L3则要求围绕研究目标形成反馈闭环,依据计算或实验结果调整策略。区别在于,修好一段程序,并不等于能够判断实验结果是否支持原来的科学假设。
L4进一步强调跨项目积累经验,改善工作策略与工具组合。L5“虚拟科学家”则指向更高的自主性:提出新的研究问题和原创假设,并组织端到端探索。作者将其定位为长期愿景。
这一分级也提醒研究人员,调用多少工具、配置多少个智能体,不能直接说明它处于哪一级。需要查看实际执行过程,以及关键决策由谁完成。
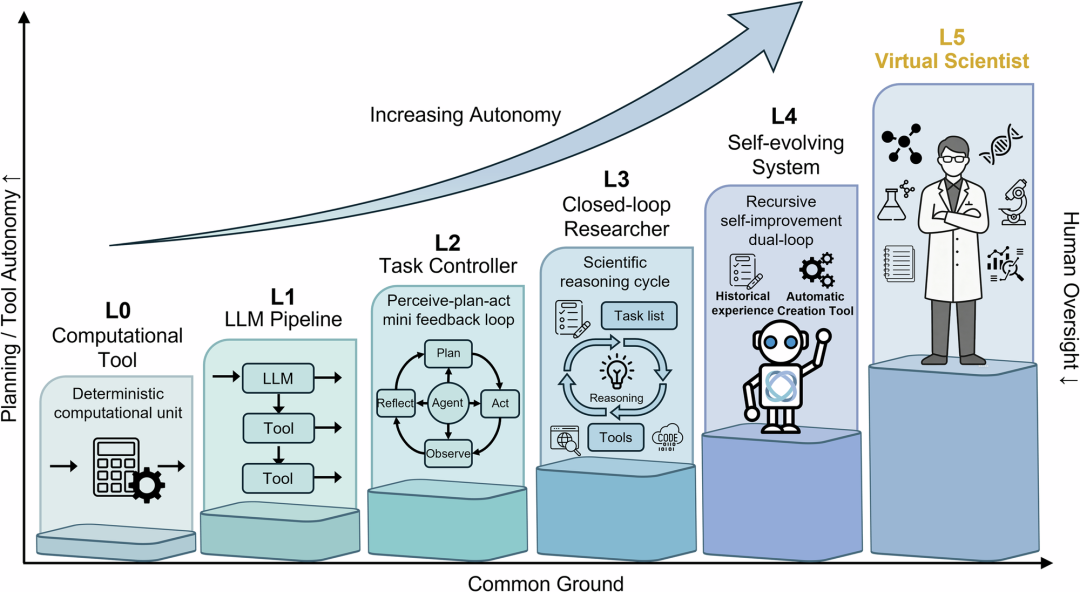
图1|从单项计算工具到“虚拟科学家”的自主性分级。来源:Zhao等,npj Drug Discovery(2026),原文图4,未修改;CC BY-NC-ND 4.0。
两类案例,展示不同的自主能力
原文梳理了靶点发现、分子与蛋白设计、候选物评估、合成规划和自动化实验等应用。其中,Coscientist与Robin分别展示了连接实验设备、利用生物实验反馈的能力。
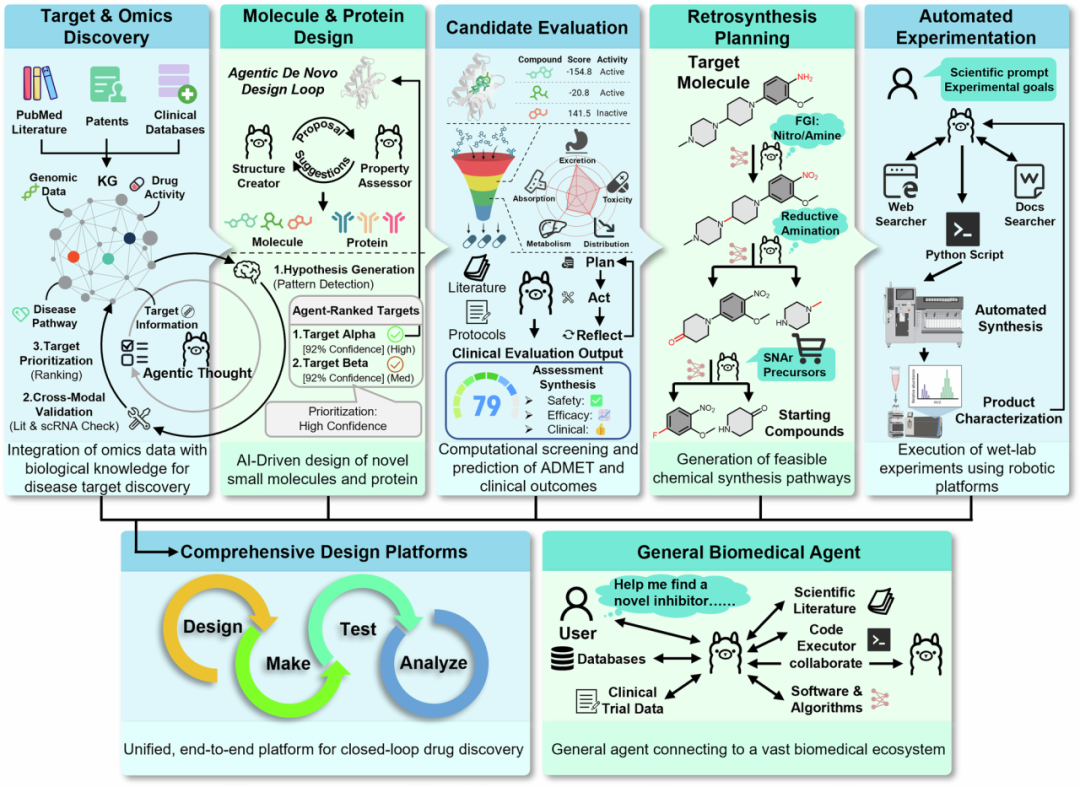
图2|智能体的研发应用范围示意,不代表各环节均已实现自主运行。来源:Zhao等,npj Drug Discovery(2026),原文图5,未修改;CC BY-NC-ND 4.0。原图科学图标由BioRender制作(Zhao,2026)。
Coscientist:把规划转化为设备操作
Coscientist发表于2023年的研究中,系统接到交叉偶联反应任务后,检索资料、选择试剂并生成液体处理机器人的控制代码。一次执行中,它使用了错误的设备方法名,随后查阅文档并修正程序;产物分析确认了目标产物的形成。
这一过程说明,AI能够把文献信息转化为设备操作,并处理执行错误。不过,原研究明确指出实验板仍需人工移动。它验证的是特定化学任务中的规划与执行能力,不能直接外推为整条药物研发流程的无人化。
Robin:让实验反馈进入下一轮假设
Robin更接近生物研究中的假设迭代。其2026年发表于Nature的研究以干性年龄相关性黄斑变性为对象,提出通过增强视网膜色素上皮细胞的吞噬功能寻找候选干预药物。
研究人员完成实验后,将数据交给Robin分析。系统根据第一轮结果继续提出候选药物,后续体外实验发现,ripasudil增强吞噬功能的效力高于首轮候选Y-27632,并在原代人源视网膜色素上皮细胞中得到验证。这里的证据是细胞功能改善,尚不能说明能够治疗患者。
Robin的意义在于,实验数据实际影响了下一轮假设。实验实施、部分条件选择和结果核查仍有研究人员参与,因此更准确的定位是半自主研究系统。这也说明,自主分析、自主规划和自主操作需要分别评价。
可靠的科研协作者,需要怎样的证据
判断智能体是否有用,需要先区分验证方式。计算测试可以检查工具执行和预测表现;回顾性复现已有发现可能受到训练数据记忆的影响;前瞻性实验能够检验新方案,但单次细胞实验仍不足以证明临床价值。不同证据回答的问题不同。
评估也应延伸到过程。最终结果看似正确,可能掩盖中途的数据处理错误或人工接管。作者建议报告人工干预次数及程度、自主错误恢复率、子任务完成率,并记录时间与成本。保留数据来源、工具调用和中间结果,才能追查错误发生在哪一步。
还需要验证收益是否来自智能体本身。在相同底层模型与工具条件下,比较固定流程和动态规划,并分别移除记忆、纠错或多智能体协作模块,才能判断哪些设计带来了改善。更强的基础模型与更多计算资源,也可能解释表面的性能提升。
对研发团队而言,这意味着试点目标应足够具体:系统能否减少某项任务的人工处理,在出错后恢复,并留下可复核的依据。围绕这些问题建立比较,比笼统评价“像不像科学家”更有实际意义。
这篇文章为不断扩大的智能体应用提供了能力分层和证据尺度。下一步值得观察的是,系统能否将可靠的局部闭环扩展到跨轮次、跨设备的研究,并把历史经验用于新的项目。若这些能力得到验证,科学家有望把更多精力转向问题定义、实验选择与转化判断,而智能体承担更多连续执行和反馈整理工作。
参考资料
1. https://www.nature.com/articles/s44386-026-00075-0
2. https://www.nature.com/articles/s41586-023-06792-0
3. https://www.nature.com/articles/s41586-026-10652-y
--------- End ---------
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢