

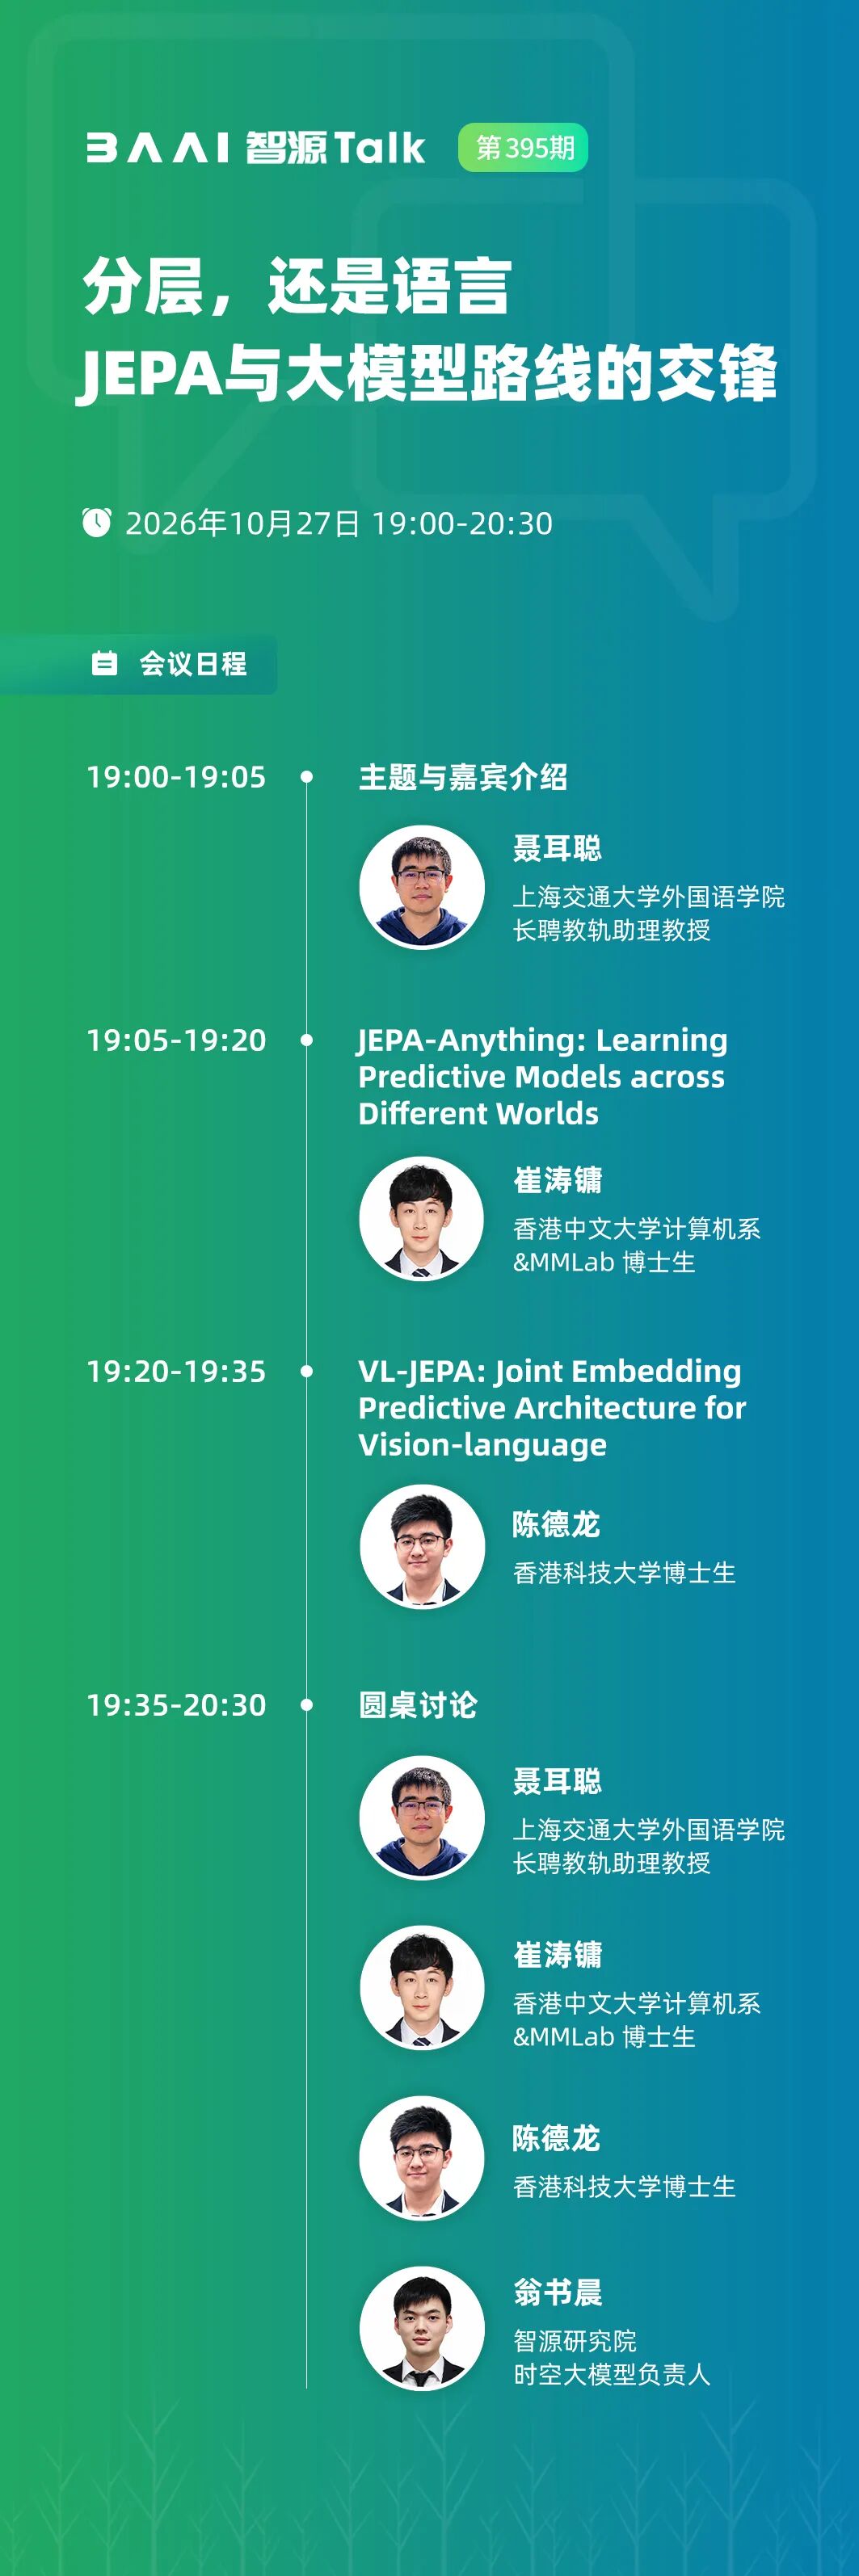
VL-JEPA: Joint Embedding Predictive Architecture for Vision-language https://arxiv.org/abs/2512.10942v1
聂耳聪,上海交通大学外国语学院长聘教轨助理教授,研究方向为自然语言处理和语言科学智能,聚焦语言科学与人工智能的双向赋能,尤其关注多语智能、大语言模型可解释性、脑—模型语言认知对齐等领域。
陈德龙,香港科技大学博士生,师从 Pascale Fung 教授,香港科技大学博士四年级学生,于2024-2026年访问 Meta Fundamental AI Research (FAIR)。研究兴趣包括视觉语言多模态学习和面向推理与规划的JEPA世界模型。代表性工作包括 Vision Language World Model (VLWM),Vision-language JEPA (VL-JEPA) 等。谷歌学术引用15000次。个人主页:https://chendelong.world/
崔涛镛,香港中文大学计算机系&MMLab博士生,曾在微软研究院和上海人工智能实验室开展研究。研究聚焦AI for Science、物理世界建模与递归自我改进,以第一作者或共同第一作者在Nature Machine Intelligence、Nature Communications等期刊上发表论文多篇,获世界人工智能大会青年优秀论文奖、中国人工智能学会潜力清源学者等奖项,作为第一作者与团队共同发布JEPA-Anything和RSI-Anything,探索世界模型与智能体的协同改进,参与Gen-Verse开源社区建设。
翁书晨,智源研究院时空大模型负责人,博士毕业于北京大学,现任北京大学/中科院博士企业导师。研究方向为视频生成与多模态大模型,目前已发表学术论文 30 余篇(含TPAMI/IJCV 7 篇,CVPR/ECCV/ICCV 等顶会 30 余篇)。曾入选华为“天才少年”、阿里淘天 T-star 等顶尖人才计划。代表工作InstructAV2AV, PanoWan等。
点上方预约,开播有提醒
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢