

今天给大家分享一篇发表于 Nature Communications 的文章:A structure-informed deep learning framework for modeling TCR-peptide-HLA interactions。研究团队提出StriMap,将抗原肽与HLA的结合、T细胞受体(TCR)对肽–HLA复合物的识别,建模为前后关联的两个阶段。同时,模型融合氨基酸理化性质、蛋白质语言模型表征和预测结构信息,用于筛选可能发生免疫识别的分子组合。
一、研究背景
T细胞识别抗原时,TCR通常面对的不是一条游离抗原肽。抗原肽首先与特定HLA结合,形成展示在细胞表面的肽–HLA复合物(pHLA);随后,TCR同时接触肽与HLA形成的界面。
因此,“一条肽能被HLA呈递”和“一个TCR能识别该pHLA”是两个不同的问题。前者决定抗原能否出现在细胞表面,后者关系到特定T细胞能否发现它。对于肿瘤新抗原筛选,仅凭肽–HLA呈递分数,很难判断患者现有的TCR是否会产生识别。
现有预测方法还面临两方面困难。一方面,许多方法主要使用氨基酸序列,未充分利用残基所处的空间环境;另一方面,TCR相互作用数据库以已观察到的阳性组合为主,缺少可靠的非结合样本。若直接把数据库中未记录的组合当作阴性,模型可能学到数据构造方式,而不是分子识别规律。
StriMap试图回答:能否让模型沿着“先呈递、后识别”的过程学习,并利用结构信息描述跨分子的识别界面?
二、模型方法
2.1 两阶段预测:先判断呈递,再判断识别
StriMap首先输入抗原肽和HLA的氨基酸序列,训练肽–HLA预测器。模型学习肽残基与HLA结合槽之间的匹配关系,输出呈递相关分数。
随后,作者将第一阶段学到的肽和HLA表征用于TCR–pHLA预测器,再加入TCR α链和β链的信息,判断该TCR是否可能识别形成的pHLA。第二阶段因此能够利用肽–HLA匹配信息,而不是孤立地比较TCR与抗原肽。
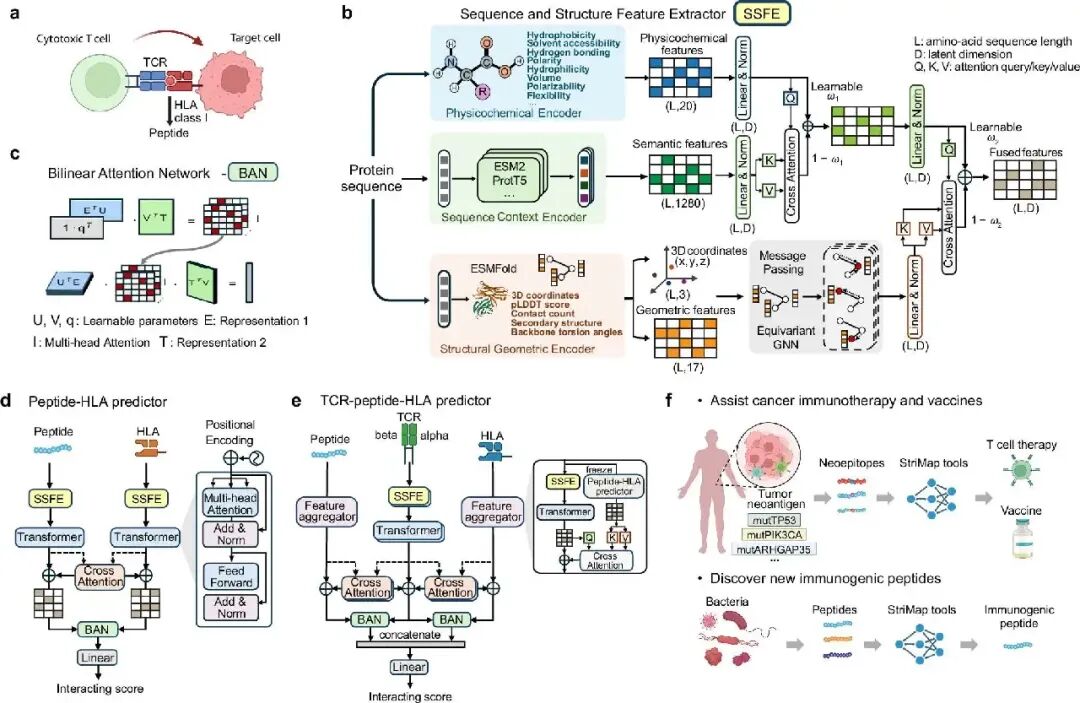
图1|StriMap整体框架。模型先学习肽–HLA呈递,再结合TCR两条链预测TCR–pHLA相互作用。图片来源:论文原文。
2.2 三类残基信息如何进入模型?
对于每条输入序列,StriMap分别提取三类信息:
- 理化信息
:描述氨基酸的电荷、疏水性等性质; - 序列信息
:由ESM2提取残基及其上下文表征; - 结构信息
:由ESMFold预测结构,再用等变图神经网络EGNN提取残基的空间环境。
这些信息经门控和交叉注意力融合后,模型使用双线性注意力网络BAN学习两组分子之间的残基配对关系。在TCR识别阶段,作者重点建模CDR3α–肽、CDR3β–肽、TCRα–HLA和TCRβ–HLA四组交互。
这里的结构信息来自预测结构。BAN学习到的残基配对权重有助于模型分类,但不能直接当作实验确定的原子接触;StriMap也没有输出完整的TCR–肽–HLA三元复合物结构。
2.3 如何处理缺少负样本的问题?
StriMap采用动态负采样:在训练过程中不断将TCR与不匹配的pHLA重新组合,使模型接触更多不同的负样本。针对肿瘤新抗原,作者还通过少量改变抗原肽或TCR的CDR3序列,构造更难区分的训练样本。
这些设计旨在让模型关注细微的序列变化。不过,人为构造的“阴性组合”仍可能真实结合,负样本标签噪声是这一任务无法忽略的限制。
三、实验结果
3.1 结构信息和两条TCR链是否有用?
作者在肽–HLA呈递和TCR–pHLA识别的多组公开基准上评估StriMap,测试设置包括同分布、跨数据来源和未见抗原肽等情形。
消融实验提供了更直接的证据:去除预测结构、动态负采样,或将跨分子交互模块改为简单拼接,性能均有所下降。在Zhang等人的数据集上,去除TCR α链后,AUROC由0.737降至0.662,AUPRC由0.507降至0.400。这说明仅使用β链会丢失一部分识别特异性信息。
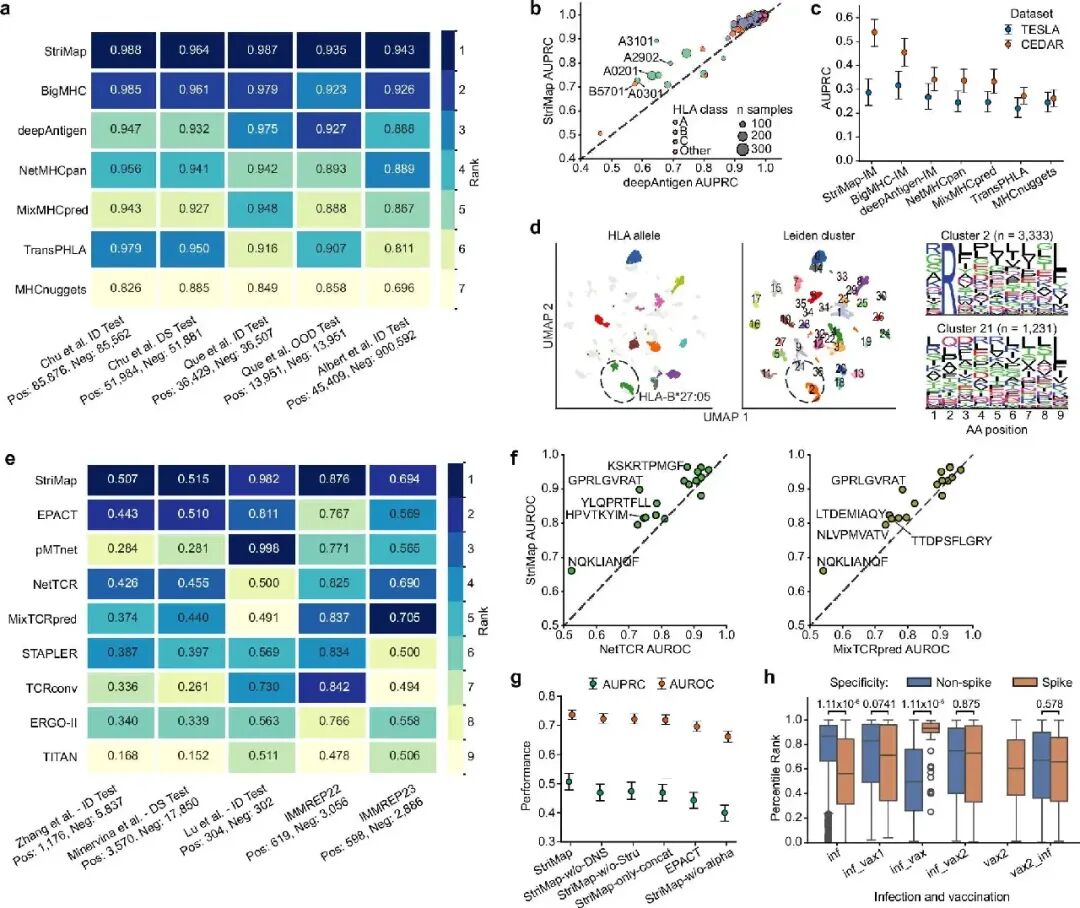
图2|公开基准与消融实验。图中分别检验了结构模块、跨分子交互、动态负采样及TCR α链的贡献。图片来源:论文原文。
3.2 能否帮助筛选肿瘤新抗原和匹配TCR?
论文考察了两类实际排序问题:已知突变抗原时,寻找可能识别它的TCR;已知患者TCR库时,在候选突变肽中寻找值得进一步实验的新抗原。
在后一项黑色素瘤数据分析中,共有106条候选突变肽,其中5条经过实验确认。综合肽–HLA呈递与TCR识别分数的StriMap-joint,其AUROC和AUPRC分别为0.72和0.14;只使用肽–HLA呈递分数时,分别为0.56和0.08。这一差异说明,能被HLA呈递的肽,未必能被患者的TCR有效识别。
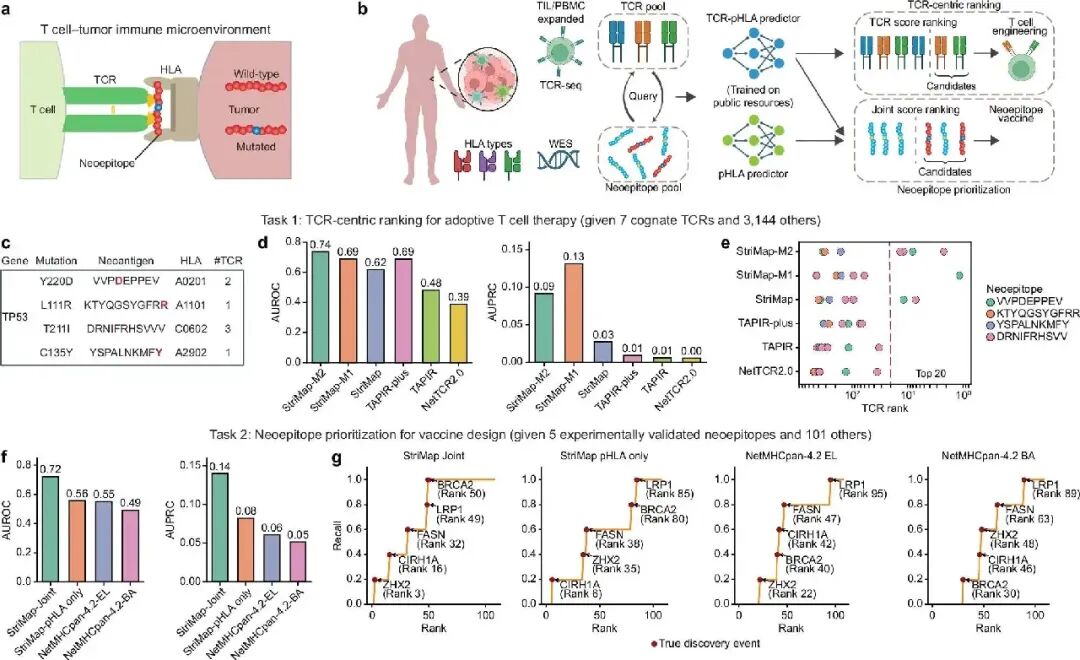
图3|癌症应用:分别从候选TCR中寻找抗原识别者,以及从候选突变肽中筛选新抗原。图片来源:论文原文。
3.3 从大规模筛选走向体外实验
作者还将StriMap用于强直性脊柱炎相关抗原的探索。他们从43,241个肠道细菌蛋白中产生约1300万条候选9肽,先筛选可能由HLA-B*27:05呈递的肽,再预测疾病相关TCR对这些pHLA的识别能力。
对于筛选出的候选,作者进行了T细胞实验。部分预测肽能够激活表达特定TCR的细胞,为模型辅助发现候选抗原提供了实验支持。
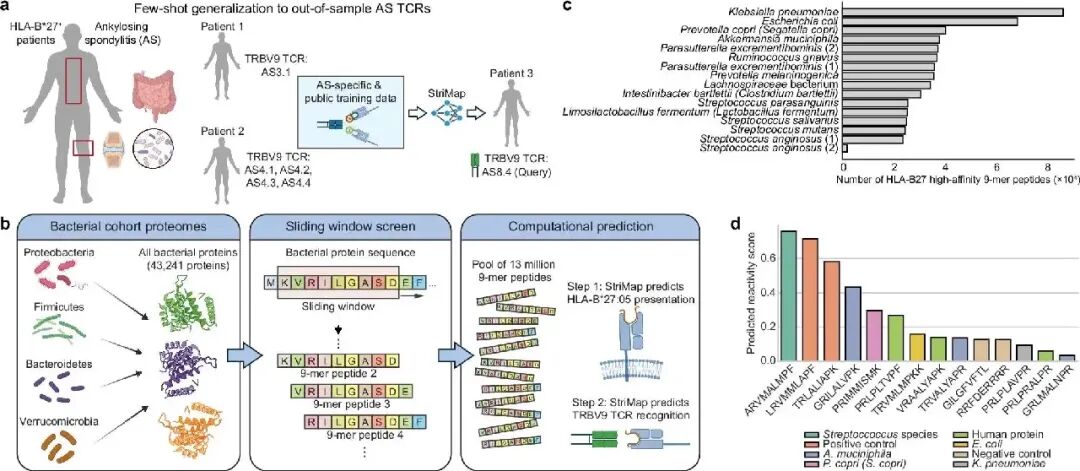
图4|从细菌蛋白序列筛选候选抗原肽。图片来源:论文原文。
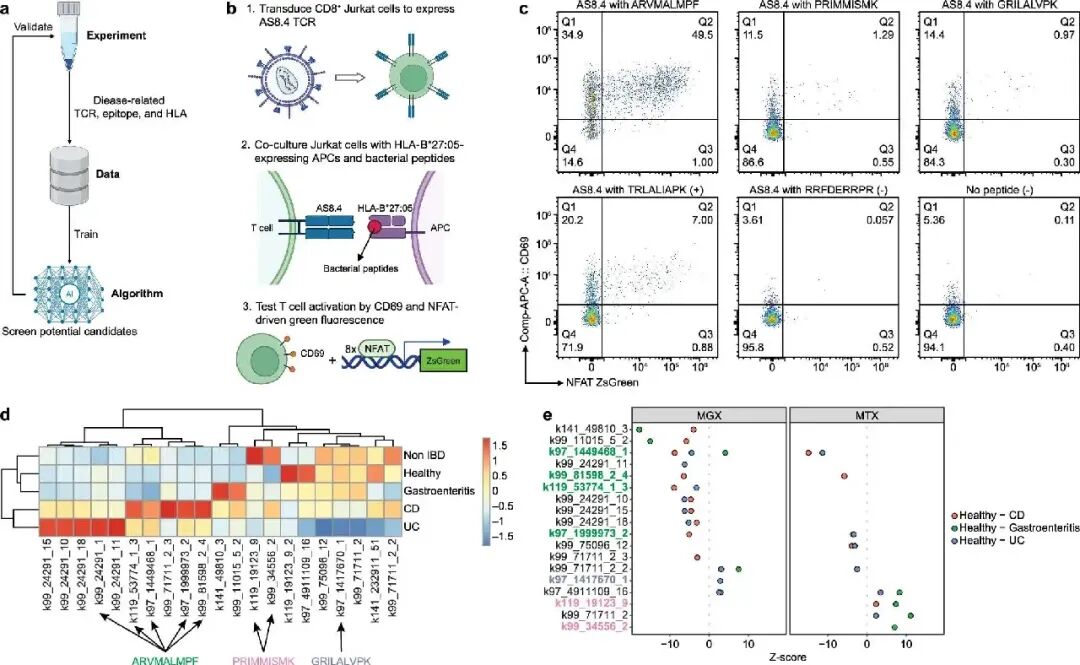
图5|对部分预测候选进行细胞实验验证。图片来源:论文原文。
四、总结与讨论
StriMap的主要贡献,是将肽–HLA呈递和TCR–pHLA识别按生物学顺序连接起来,并在残基层面融合序列、理化性质与预测结构。动态负采样和突变样本设计,则回应了TCR数据缺少可靠阴性样本的问题。
研究结果支持StriMap用于候选排序,但其预测分数不能直接解释为结合亲和力或T细胞激活强度。模型使用的结构来自预测,跨分子界面也未得到原子级复合物结构验证。此外,真正未见抗原肽的测试样本仍然有限,模型对全新抗原的泛化能力需要更多独立数据检验。细菌肽的体外激活结果同样不能直接证明其在人体内引发疾病。
这篇工作展示了一种清晰的建模思路:把免疫识别拆解为相互依赖的步骤,再检验每一步的信息能否改善最终筛选。
论文链接:https://www.nature.com/articles/s41467-026-78063-1
代码链接:https://github.com/uhlerlab/strimap-tools
编辑|武文泽 审核|熊展坤
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢