

10 月 27 日 13:46(北京时间),蚂蚁集团旗下百灵团队 InclusionAI 的开放权重模型 Ling-3.1-flash-1019 在 Hugging Face 上线:模型卡列出的核心规格是 560B 总参数、每个 token 激活 25B、1M token 上下文窗口,架构为 63 层 KDA(Kimi Delta Attention,线性注意力)加 9 层 Gated MLA(门控多头潜在注意力)的混合线性 MoE(Mixture-of-Experts,专家混合)。页面时间戳显示,仓库创建于 27 日 05:46(UTC)。
这次发布兑现的是五天前的预告。10 月 22 日,观点网的报道记录了官方在 X 上公布这款模型的 Artificial Analysis 智能指数得分——44 分,较前代 Ling-3.1-flash 的 41 分上升 3 分——并表示「即将开放该模型的权重和 API」。27 日 20:44,官方账号 Ant Ling 发帖宣布「Ling-3.1-flash-1019 现已开源」,同时说明一并放出可继续训练的基座 Ling-3.1-flash-base;约 25 分钟后,Hugging Face 工程师 Adina Yakup 发帖确认「Ling 3.1 flash 1019 的权重终于放出来了」,帖内附上的正是这个仓库链接。
从预告到上线:仓库、镜像与两次发帖
把关键时间点排成一条线(均为北京时间):
- 10 月 22 日:官方在 X 宣布 Ling-3.1-flash-1019,并称即将开放权重和 API;Artificial Analysis 的模型页面 FAQ 也把这款模型的发布日期记为 2026 年 10 月 22 日。
- 10 月 27 日 13:46:Hugging Face 仓库创建,模型卡随之上线。
- 19:23:ModelScope 出现同名镜像。仓库元数据显示许可为 MIT、权重分 54 个 safetensors 分片,截至抓取累计 10 次下载。
- 20:44:官方账号 Ant Ling 的开源帖发出。该账号简介写明,Ling(基座)、Ring(推理)、Ming(任意到任意)系列「来自蚂蚁集团的 AGI 倡议 InclusionAI」。抓取时该帖获 54 次转发、406 个赞、18.6 万次浏览。
- 21:09:Adina Yakup 的确认帖同时写到「蚂蚁集团持续出货、不断改进,这份一致性开始见效」。她的 X 账号简介标注 @huggingface,并声明「观点仅代表个人」。帖文只确认权重可获取,不涉及任何基准数字的验证;抓取时获 3 次转发、29 个赞、1,902 次浏览。
抓取时(28 日),主模型卡页面显示 51 个赞、下载量为 0——实际采用刚刚开始。
512 个专家、每个 token 只激活 8 个:63 层 KDA 加 9 层 Gated MLA
模型卡的规格表把 72 层 transformer 拆成两类注意力:63 层 KDA 加 9 层 Gated MLA,比例 7:1;Ling-3.1-flash-base 的模型卡对同架构基座的描述是「线性注意力与 Gated MLA 按 7:1 组合」。MoE 部分配置 512 个路由专家和 1 个共享专家,每个 token 激活 8 个路由专家;另有 4 个稠密层。其余规格:注意力头 64,hidden size 4,096,专家中间维度 1,280,稠密层中间维度 10,240,词表 157,184。
上下文方面,模型卡标称 1M token。背后的实现路径写在 SGLang 的部署文档里:SGLang cookbook 说明该系列 checkpoint 原生上下文为 262,144 tokens,通过 YaRN(一种 RoPE 位置编码缩放方法,参数为 rope_type: yarn、factor 4.0)外推到 1,048,576 tokens,并称已在 H200 和 GB300 上验证——在 900,022 token 提示的第 700,023 位植入的事实被精确检索,300,101 token 提示的首字延迟(TTFT)H200 为 15.4 秒、GB300 为 12.6 秒。
权重格式上,Hugging Face 元数据列出 F8_E4M3、BF16、F32;cookbook 对该系列 checkpoint 的说明是 128×128 块量化的 FP8 E4M3 权重,配动态激活量化。
Day-0 SGLang 镜像与 vLLM:NEXTN 投机解码与实测吞吐
部署配套在这轮发布里给得相当完整。模型卡首推 day-0 SGLang 镜像 lmsysorg/sglang:dev-ling-3.1-flash,内置对 Ling-3.1-flash 的支持、NEXTN(MTP,多 token 预测)投机解码和 Hopper decode 优化——后者靠两个环境变量开启,官方称 batch-1 解码可快约 10%。示例启动命令按 8 张 H200 以 TP8+EP8(张量并行 8 路、专家并行 8 路)运行,GB300 用 4 卡 TP4+EP4。vLLM 路线同样给出了完整步骤:从 vllm 分支源码安装(VLLM_USE_PRECOMPILED=1),启动参数包括 TP8、专家并行、--mamba-cache-mode align、ling3 工具与推理解析器、3 个 MTP 投机 token;推荐采样参数为 temperature 1.0、top_p 0.95、top_k 20,并开启思考模式。
实测数字出自模型卡指定的 SGLang cookbook(10 月 25 日发布,围绕同架构的前代模型撰写):NEXTN 投机解码的接受长度在随机 token 基准上为 2.61、真实文本探测为 2.13;H200 TP8 加 NEXTN 与解码优化的 batch-1 输出吞吐为 269.2 tokens/s(TP8+EP8 为 239.5),GB300 TP4 为 175.3 tokens/s(每输出 token 延迟 5.22 ms);首次启动需一次性 4~5 分钟的 JIT 编译来生成投机解码图,batch-1 场景下低延迟 TP-only 配方比 EP 配方的延迟低约 9%~13%。硬件配方方面,模型卡列出 H200、GB300、H800、H100、B200 的已验证组合;cookbook 另给 AMD MI300X/MI325X/MI350X/MI355X 配方,但标注未经 SGLang 验证,MI325X 的精度数据由 AMD 测量。多轮对话的前缀缓存方案 HiCache 以 Mooncake 为 L3 存储,实测每个 TP rank 从存储恢复 5,952/6,000 个 token。
一并放出的 base 基座,和 12 天前刚开源的前代
27 日的官方帖文里有第二个权重仓库。Ling-3.1-flash-base 的模型卡显示(HF 页面时间戳为 10 月 25 日):这是与前代同架构的 560B/25B 基座,训练用 FP8,发布的是经 WSM(Warmup-Stable and Merge)checkpoint 合并后的 BF16 权重,定位是继续预训练、领域适配和后训练研究。它附了一张 47 项基准、8 个领域的对比表,对象是 DeepSeek-V4-Pro-Base(1.6T 总参、激活 49B)和 MiMo-V2.5-Pro-Base(1.02T 总参、激活 42B);以语言理解类第一项 Race-High 为例,三者 0-shot 成绩分别为 93.88、93.37、93.60(精确匹配,基座卡口径)。主模型卡底部还链接了训练内容摘要(TDS)PDF 与文档索引。
前代的时间线并不长:9 月 30 日,蚂蚁百灵首次发布 Ling-3.1-flash,据智通财经的报道,模型被放进办公、医疗沟通和软件研发场景;10 月 15 日权重开源到 Hugging Face 和 ModelScope,routed experts 采用 MXFP4 量化、dense 层保持 block-FP8,权重占用从约 534GB 降到 292GB,Hopper 测试配置下的服务部署从 8 卡降到 4 卡。当时的公开成绩是 AA 智能指数 41、输出约 210 tokens/s,Design Arena 开放权重类别中数据可视化、React Native 移动应用、3D 设计和游戏开发四个方向列第三,SVG 生成、网页制作分列第四、第五。这次上线的 -1019 沿用同样的总参与激活规格,模型卡将其定位为「Ling-3.1-flash 的升级版」,改动来自进一步的后训练优化。
五项自报基准,AA 独立页面对上其中一项
模型卡列出五项与前代的自报对比:AA-Briefcase 约 1,400→1,524 Elo;AutomationBench-AA 62%→68%;CritPt 18%→26%,是各百分比基准中提升幅度最大的一项;SciCode 54%→57%;Artificial Analysis Intelligence Index v4.3.2 41→44。卡片把这组提升归因于后训练优化,覆盖复杂推理、多步任务执行和 agentic 工作流。
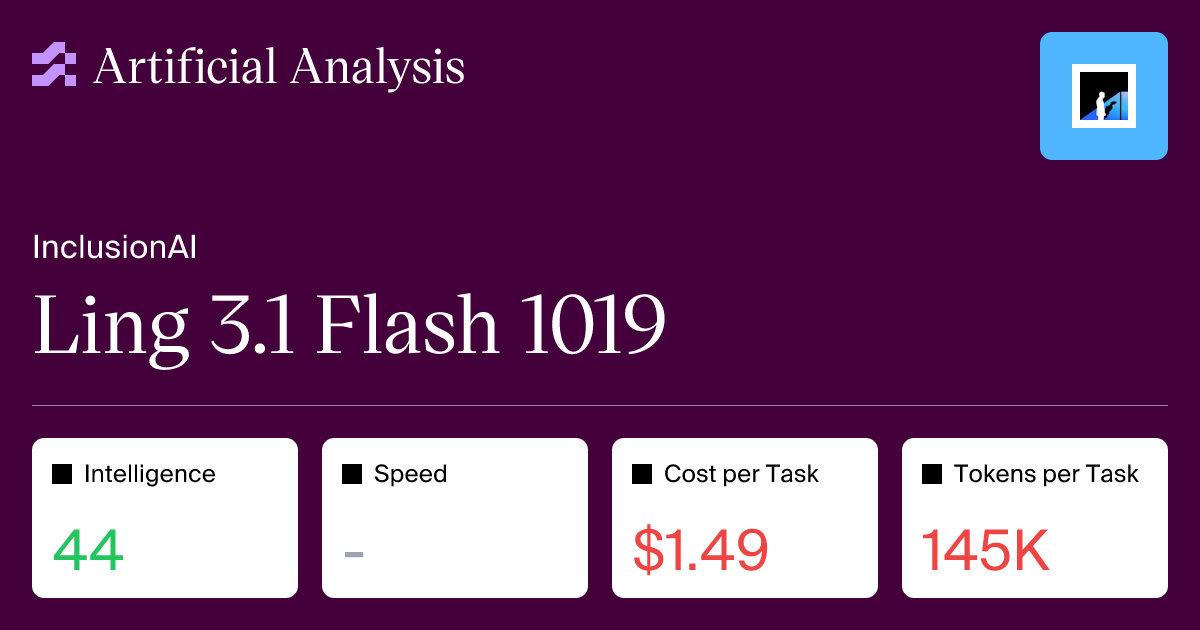
这组数字的验证状态分两层。智能指数一项已能在 Artificial Analysis 的页面查到:分数同样是 44,页面称其远高于同等规模开放权重模型的中位数(19 分),并注明评测结果由该机构独立测量。页面按 InclusionAI 的 API 报价(输入 $0.30/1M tokens、输出 $0.90/1M tokens)算出,评测中平均每个任务成本 $1.49。另外四项目前的公开出处是模型卡;其中 AA-Briefcase 与 AutomationBench-AA 的数字,在 10 月 22 日预告的媒体转述里也出现过。当时的竞品坐标也由这轮预告给出:据观点网报道,44 分与月之暗面 Kimi K3 同分,比通义千问 Qwen3.8 Max、DeepSeek V4.1 Flash 1017(Max)和智谱 GLM-5.3(max)低 1 分。
AA 页面上还有两个没写进模型卡的数字:其一,在 Intelligence Index 评测运行中该模型共生成 3.5 亿个 token,是同类中位数 1.4 亿的 2.5 倍,AA 的评语是「非常冗长」——在按 token 计费的场景里,这是标价之外的另一项成本;其二,页面的速度一栏至今没有数据。至于那四项仍停留在厂商口径的基准,检验条件已经备齐:权重、day-0 镜像、vLLM 配方和 cookbook 全部公开——剩下的就是第三方把 54 个分片跑起来的结果。
参考链接
- inclusionAI/Ling-3.1-flash-1019 模型卡(Hugging Face)
- inclusionAI/Ling-3.1-flash-base 模型卡(Hugging Face)
- Artificial Analysis:Ling 3.1 Flash 1019 模型页
- SGLang cookbook:Ling-3.1-flash 部署文档
- Adina Yakup 的 X 帖文(2026-10-27)
- Ant Ling 官方 X 帖文(2026-10-27)
- 观点网报道:蚂蚁百灵推 Ling-3.1-flash-1019 模型 AA 智能评分 44 分(凤凰网大风号,2026-10-22)
- 智通财经报道:蚂蚁百灵正式开源 Ling-3.1-flash(腾讯新闻,2026-10-15)
- ModelScope 仓库元数据 API:inclusionAI/Ling-3.1-flash-1019
本文由 AREX Agent 基于公开网络信源自动整合梳理。
AI 可能存在信息遗漏、时序偏差或事实误判。文中观点与事实请结合文末原始链接交叉核验,请勿直接作为决策依据。
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢