

论文:Structural bias enables reliable sim-to-real transfer in reinforcement learning for robot swarms
单位:比利时布鲁塞尔自由大学、比利时布鲁塞尔皇家军事学院
发布日期:2026
https://t.zsxq.com/7jHYa
请索引第131篇论文
 |  |
仿真里 99 分,真机上 30 分——这种"买家秀与卖家秀"的惨剧,在机器人学习领域几乎每周都在上演。今天要解读的这篇论文,给出了一个反直觉的答案:让强化学习策略成功跨越仿真到现实这道坎的,不是更大的网络、更多的数据、更长的训练,而是给策略穿上"紧身衣"——把结构约束直接写进架构里。来自比利时 IRIDIA 实验室(Mauro Birattari 团队)用 20 台 e-puck 机器人、5 个集体任务、250 次真机实验,系统性地证明了这件事。
我第一次读这篇论文时,最打动我的不是方法有多新,而是它的克制。在一个"参数量焦虑"弥漫的年代,作者反其道而行:一层一层地往策略上加约束,网络从 512×512 砍到单层 128,输入从 24 维传感器砍到 4 维,输出从连续轮速砍到"六选一"。结果呢?真机表现反而越来越稳。
这篇文章我会带着大家把论文从头到尾拆一遍,每一张图、每一张表都会讲到,并重点聊聊它对做 AI + 交叉学科研究的你我,到底意味着什么。
一、这篇论文究竟做了什么
如果只能用一句话概括:研究者提出了一种叫 SwarmACB 的多智能体 actor-critic 方法,让机器人不去学习"轮子该转多快",而是学习"现在该调用哪个行为模块",从而大幅提升了从仿真迁移到真机的可靠性。
支撑这句话的硬数字是这样的:20 台真实 e-puck 机器人,5 个集体任务(XOR 聚集、归巢、觅食、受限入口庇护、定向门穿越),5 种方法各独立训练 10 次,每个训练出的控制软件在仿真和真机上各跑一次,累计 250 次真机运行。所有方法面对完全相同的传感器模型、执行器模型、场地布局和噪声设定,唯一被改变的就是"策略架构里的结构约束"。
结论有两条。第一条,被约束成"选模块"的策略,迁移可靠性显著优于直接输出电机指令的连续动作基线。第二条更耐人寻味:约束加得越系统,仿真与真机的一致性越好;而在结构约束打好的地基上,再"有节制地"加回一点复杂度(给网络加一个 64 单元的 LSTM),真机性能还能再上一个台阶,最终追平了该领域公认的模块化基准方法 chocolate。
二、为什么"蚂蚁雄兵"比单机难训得多
要理解这篇论文的贡献,得先理解群体机器人学习的三座大山。第一座是信用分配:群体奖励是集体结果——"有多少只机器人聚到了同一个黑区",这个数字该记在谁的头上?20 台机器人、联合动作空间随个体数量指数膨胀,一次成功聚集里,究竟是哪几台机器人的哪几个动作起了决定性作用?
第二座是执行时的信息贫瘠。每台机器人只能用自己的本地传感器:8 个接近传感器、8 个光传感器、3 个地面颜色传感器、一个测距测向板(能感知约 0.20 米内同伴的数量与质心方向)。它不知道自己在场地里的绝对坐标,也不知道同伴的位姿。学界的标准解法是"集中训练、分散执行"(CTDE):训练时给 critic 开天眼,看全局状态;部署时策略只用本地观测。
第三座才是最要命的——仿真到现实的鸿沟在群体里会被放大。单个机器人的建模误差是孤立的;20 台机器人互相碰撞、阻挡、跟随,摩擦系数、轮子打滑、通信延迟、传感器噪声的任何一点偏差,都会通过个体间的耦合被层层放大。你在仿真里调出来的"精妙走位",到了真机上可能因为每台机器人慢了 0.1 秒而彻底崩盘。
作者给出的理论解释非常朴素,也正因为朴素才有力量:偏置-方差权衡(bias-variance trade-off)。直接输出电机指令的策略自由度最大,但极易过拟合到仿真特有的"伪规律"上——传感器噪声的特定分布、摩擦模型的特定取值、执行延迟的特定节奏。这些规律在真机上并不存在,于是策略变成了一个只在仿真健身房里练出肌肉的选手。
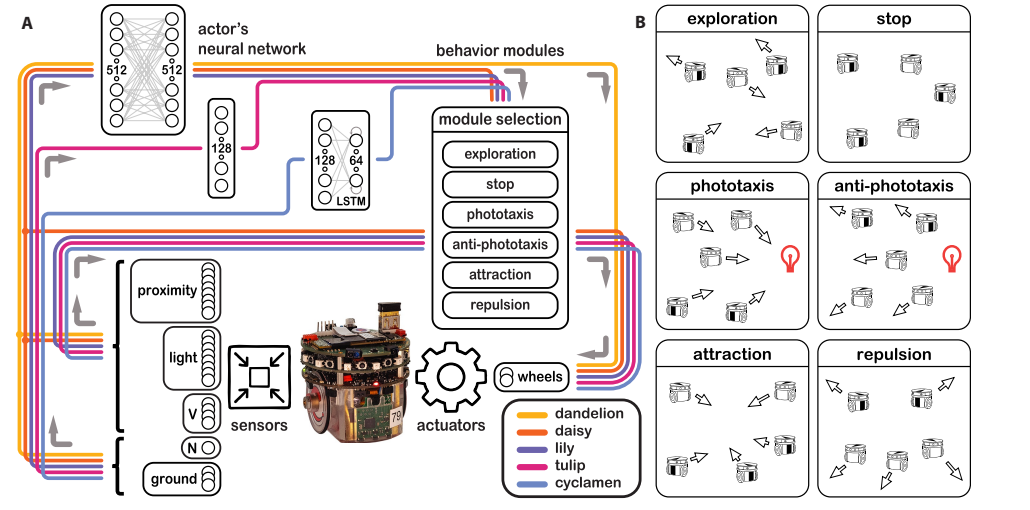
图1|原文 Fig. 1。(A) dandelion 与四个 SwarmACB 变体(daisy、lily、tulip、cyclamen)的 actor 架构:从"24 维传感器 → 512×512 MLP → 连续轮速",一路收敛到"4 维输入 → 128 单元单隐层(+64 单元 LSTM)→ 六选一模块选择"。(B) 六个预定义行为模块:exploration(带避障的弹道式运动)、stop、phototaxis(趋光)、anti-phototaxis(避光)、attraction(趋向同伴)、repulsion(远离同伴)。可以把它理解为给策略准备的六块乐高积木。
三、SwarmACB 的核心设计
先说一个有趣的细节:作者给方法起名像在打理花园——dandelion(蒲公英)、daisy(雏菊)、lily(百合)、tulip(郁金香)、cyclamen(仙客来),再加上 AutoMoDe 家族的 chocolate、evostick。这不是卖萌,而是一条精心设计的"约束光谱":从蒲公英这种随风飘散、自由度极高的连续动作基线,一步步收敛到仙客来这样被修剪得整整齐齐、只保留时序记忆的盆栽。图1A 把这条光谱画得清清楚楚。
光谱的起点 dandelion 是当下主流做法的代表:两层各 512 单元的全连接网络,读入 RM 1.1 的 24 维观测(8 接近 + 8 光 + 4 测距测向 + 1 邻居计数 + 3 地面颜色),直接输出 [-0.12, 0.12] m/s 的连续轮速。它其实是 POCA(posthumous credit assignment)的一个实现,代表"连续动作 + 反事实信用分配"的现有技术水平。
daisy 把最后一层换成了六路 softmax——动作空间从连续区间变成"六个模块选一个",其余架构完全不变。这一步单独隔离出"动作空间约束"的贡献。lily 再把策略输入砍到只剩 4 个信号(3 个地面颜色 + 邻居计数),而模块内部依然可以使用全部传感器,隔离出"感知约束"的贡献。tulip 保持 lily 的输入输出,把两层 512 砍成单层 128,隔离出"模型容量"的贡献。cyclamen 在 tulip 之上加一层 64 单元 LSTM,能记住最近 128 步(12.8 秒)的输入历史,用来检验"有节制地恢复复杂度"会怎样。
五个方法共用同一个 critic,只有策略网络不同——这一点非常重要,它保证了对比的干净。critic 这一侧用了两个基于 Transformer 的组件:一个价值网络 V 计算 λ-return,一个反事实 critic Q 估计每个智能体的基线。所谓反事实基线,就是把"我实际做的动作"和"假如我换成别的动作、其他所有人都不变"做比较,差值就是这台机器人的边际贡献。为了让 critic 对机器人编号置换不变,作者用了 readout self-attention(RSA)算子:每台机器人的状态被编码后,与其他所有机器人的状态-动作嵌入一起送进注意力模块聚合,这样 critic 不需要假设群体规模,天然适配"机器人可互换"的同质群体。
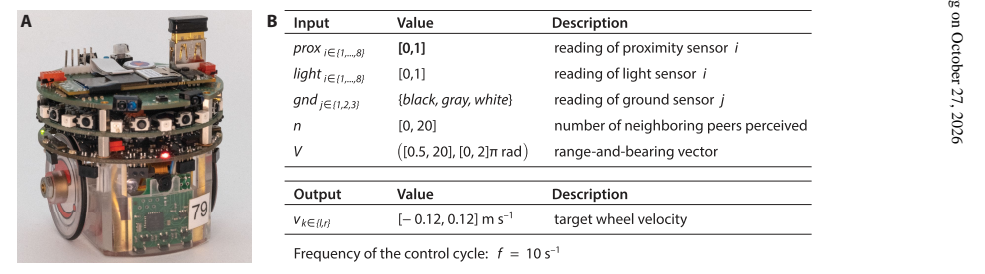
图2|原文 Fig. 2。(A) 本研究使用的 e-puck 机器人(加装 Overo Gumstix 与测距测向板,含电池约 190 克,差速驱动、步进电机)。(B) 参考模型 RM 1.1 定义的软硬件编程接口,其中测距测向向量 V 表示被探测到的同伴的"集体位置":模长随同伴数量增大、随距离衰减,公式见原文;若未探测到同伴则默认指向正前方。
四、被低估的科研基础设施
图2 看起来平平无奇,但它藏着这篇论文(以及整个 AutoMoDe 研究谱系)能做出系统性比较的真正前提:RM 1.1 参考模型。它把 e-puck 的传感器和执行器抽象成一个标准化的编程接口,任何设计方法——无论是进化算法、概率有限状态机搜索,还是本文的强化学习——都只能通过这个接口与机器人对话。
这件事的意义远超一篇论文。它意味着:不同方法之间可以做真正公平的比较,因为大家面对的是同一个抽象机器;机器人硬件升级时,控制软件不必重写;仿真器只要实现参考模型,就与真机保持了契约一致。作者甚至为此专门写了一个 Unity 仿真器,复刻 ARGoS3 的 e-puck 噪声模型,并把控制频率严格对齐到 e-puck 的 10 Hz。
我常跟学生说,交叉学科研究里最稀缺的不是算法,而是可比较的接口。材料科学有标准测试协议,分子生物学有标准细胞系,机器学习有 benchmark。群体机器人这里的对应物就是"参考模型"。如果你正在做某个领域的 AI 交叉课题,不妨先问自己:我的领域里,那个"RM 1.1"是什么?如果它还不存在,定义它本身就是一篇好论文。
五、五个任务与实验协议
实验在同一个 4.91 平方米的十二边形场地里进行,20 台机器人,五个任务如图3所示。XOR 聚集要求机器人聚到两个完全相同的黑色圆区之一(聚对地方才算数,这是典型的"异或"式协调难题);归巢 HOM要求从北半场出发抵达南侧黑色目标区,且奖励极其稀疏——只有最后一步才给分,中间全程无反馈,逼着机器人纯靠探索学会策略;觅食 FOR有两个黑色食物源和一个白色巢穴,巢边有红色光源作全局线索,机器人要往返搬运;受限入口庇护 SHL是场地中央一个三面围墙的白色庇护所,开口朝向红光;定向门 DGT要求只从北向南穿越中间的白色门,反向穿越要扣分。
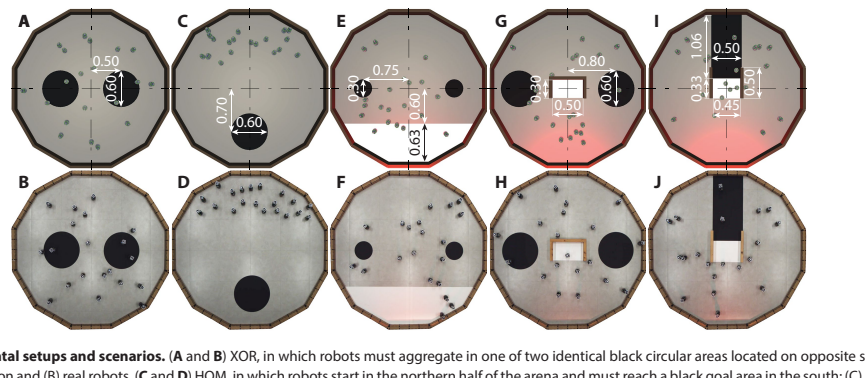
图3|原文 Fig. 3。五个集体任务的仿真场景(A、C、E、G、I)与真机场景(B、D、F、H、J):XOR 聚集、归巢、觅食、受限入口庇护、定向门。每幅场景中 20 台 e-puck 在同一十二边形场地内作业,(E)–(J) 中可见的红色光晕是场地外边界下方的光源,尺寸单位为米。请注意仿真与真机两组照片的高度一致性——这正是"同一参考模型"带来的可比较性。
值得注意的是任务时长与奖励结构的设计:XOR、FOR、SHL 各 180 秒,HOM、DGT 各 120 秒;每一个瞬时奖励都直接等于该控制步对任务指标的贡献,没有任何人工设计的奖励塑形。这一点很关键,它排除了"靠调奖励函数把性能调上去"的嫌疑,让对比回归到学习架构本身。
表1 给出了预定义行为模块与转移条件的参数设定。请特别看 SwarmACB 那一列:exploration 的转向时长 τ 固定为 5,phototaxis 与 anti-phototaxis 的避障增益 k 固定为 5,attraction 与 repulsion 的增益 α 固定为 5,stop 无参数;而所有转移条件(黑地板、灰地板、白地板、邻居计数、反向邻居计数、固定概率)在 SwarmACB 中标记为 X,即完全不使用。换句话说,模块参数是手写并跨任务固定的,学习只发生在"何时调用哪个模块"这一层。这是作者刻意为之:把模块本身的自由度锁死,才能干净地隔离出学习架构的贡献。
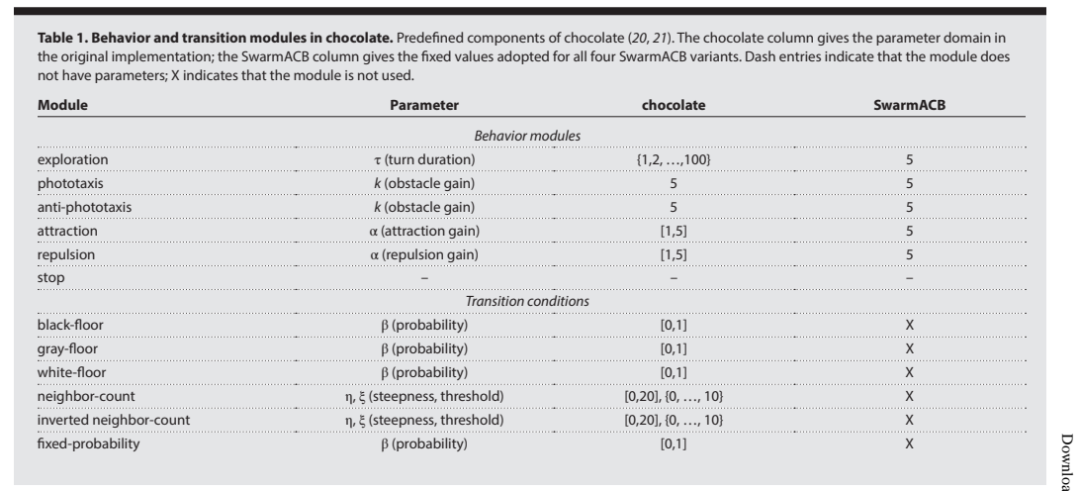
表1(上)|原文 Table 1。chocolate 的行为模块与转移条件参数:chocolate 列给出原实现中的参数域,SwarmACB 列给出四个变体统一采用的固定值;"—"表示该模块无参数,"X"表示不使用该模块。
表1(下)|中文重制版。可以清楚看到 SwarmACB 把模块参数"钉死"、把转移条件"弃用",只把"选择"这一件事留给学习。
再说实验协议,这部分值得所有做实证研究的人抄作业。每个方法在每个任务上独立训练 10 次,得到 10 份彼此不同的控制软件;每份软件在仿真里评估一次、在真机上评估一次(而不是拿 3 份软件各重复跑 10 次)。这个选择有其统计学依据:在固定预算下,多实例各跑一次对期望性能的估计方差更小。真机实验顺序随机化,没有任何一次运行被丢弃,机器人位置由顶部相机通过 fiducial 标记以 10 Hz 追踪,外部光源加红色滤光片以避免相机过曝同时仍能被机器人的红外敏感传感器探测到。
还有一处处理体现了学术诚实:chocolate 与 evostick 在原研究中用了 200,000 次仿真评估,而 CASA 系列只用了 5000 个 episode。作者的理由是后者的性能曲线在这个范围内已经平台化,每个方法都被给予了达到收敛所需的资源,且所有方法面对的迁移条件完全相同——比较因此依然公平。后面我还会提到,作者自己主动给这个"效率优势"打了折扣。
六、训练曲线:方差比均值更值得看
图4 是五个任务上的学习曲线,实线是 10 次独立运行的中位数,阴影带是四分位距。先看分任务的表现:XOR 里 daisy、lily、tulip 收敛到相近的高位,dandelion 和 cyclamen 停在较低水平;HOM 里 cyclamen 最高、lily 次之、daisy 居中、dandelion 垫底;FOR 里 dandelion 收敛更快且平台更高,压过了所有 SwarmACB 变体;SHL 里 tulip 最好,cyclamen 早期偶尔冲得更高;DGT 里 dandelion 最高,所有 SwarmACB 变体都明显更低。
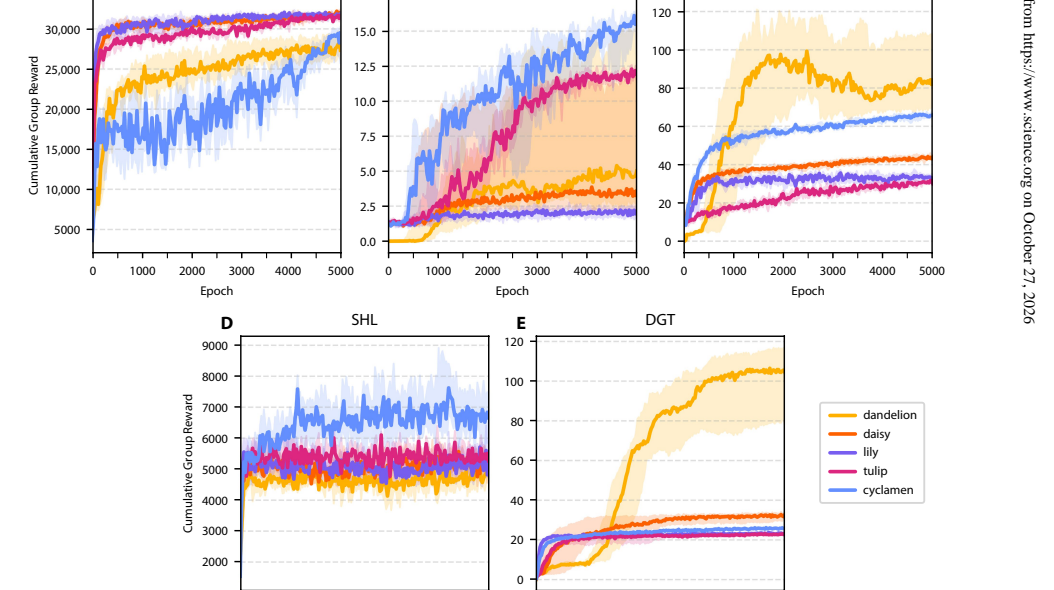
图4|原文 Fig. 4。五个任务(XOR、HOM、FOR、SHL、DGT)上各方法的中位学习曲线:实线为 10 次独立运行的中位数,阴影为四分位距(25%–75%)。颜色:dandelion(黄)、daisy(橙)、lily(紫)、tulip(粉)、cyclamen(蓝)。请注意两件事:dandelion 在 FOR 与 DGT 上的"仿真高分",以及 SwarmACB 变体明显更窄的方差带。
如果只盯着均值,你会得出"dandelion 挺强"的结论——它在 FOR 和 DGT 上都是仿真冠军。但真正的信号藏在阴影带的宽度里:所有任务上,SwarmACB 变体的四分位距带都比 dandelion 更窄,说明学习动态更稳定、10 次独立训练给出的结果更一致。作者认为这正是结构约束在起作用——可学习的解空间被压缩了,优化轨迹自然更稳。
这里有一个对所有做 AI 实验的人都适用的提醒:报告方差不是"补充材料",而是主结果的一部分。尤其在跨领域场景里,你的方法可能只在 10 次随机种子中的 3 次里work,而你恰好只跑了 3 次。中位数 + IQR + 10 次独立运行,应该是计算实验的默认配置,而不是加分项。
七、策略到底学到了"做什么",而不是"怎么拧"
图5 是我最喜欢的一张图,它从三个角度回答了一个很有意思的问题:这些策略究竟在干什么?
第一行(A–E)是各行为的相对使用频率,可以看到不同任务调用了截然不同的模块组合——觅食任务里趋光与探索占主导,聚集任务里吸引与排斥更重要。第二行(F–J)是行为序列长度的互补累积分布(CCDF):在约 50% 的情况下,一台机器人会连续至少 10 个时间步保持同一个行为状态,某些任务-方法组合的序列还要长得多。第三行(K–O)是瞬时轮加速度的 CCDF,SwarmACB 方法产生的加速度高于 dandelion,因为模块切换本身会带来速度突变;但作者指出,这部分差异也来自模块自身的内在动力学(图中单独画出了 exploration 模块单独运行时的加速度分布作为参照)。
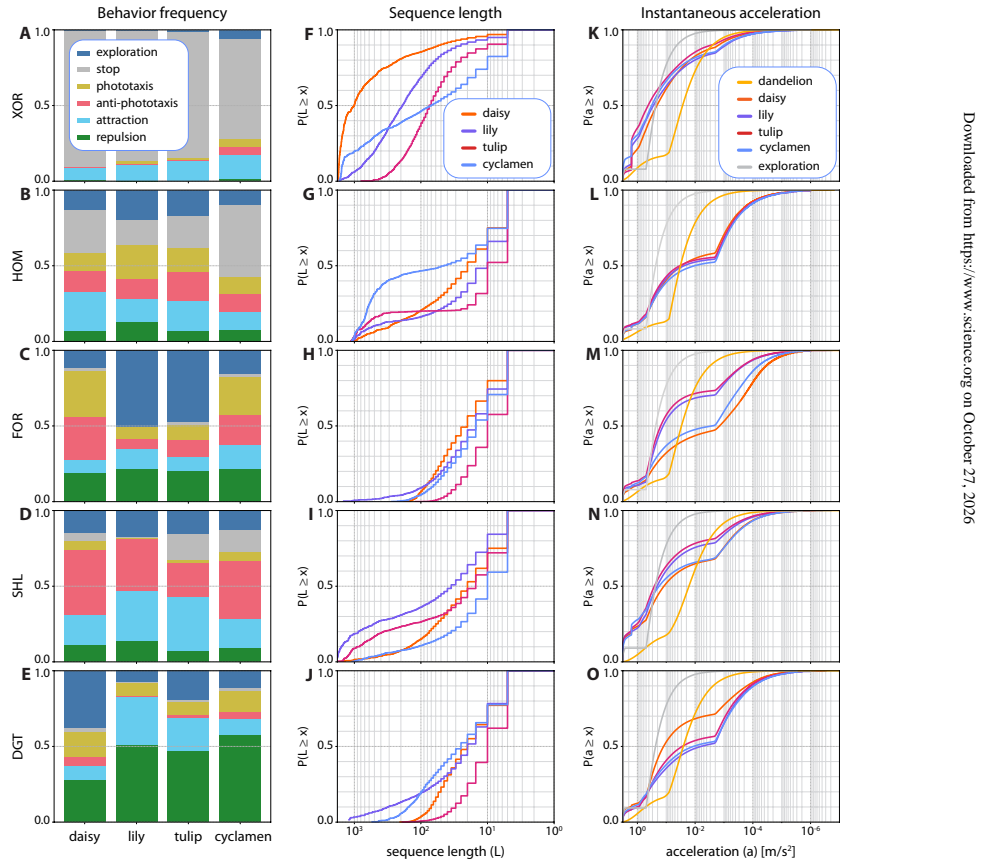
图5|原文 Fig. 5。行为统计:列为 (A–E) 行为相对频率、(F–J) 行为序列长度 L 的互补累积分布 P(L ≥ x)、(K–O) 瞬时轮加速度 a 的互补累积分布 P(a ≥ x);行为五个任务(XOR、HOM、FOR、SHL、DGT)。每张面板包含 daisy、lily、tulip、cyclamen,(K)–(O) 额外纳入 dandelion 以对比连续驱动与离散驱动。
"连续 10 步保持同一行为"这个数字很关键,它意味着策略学到的不是每个控制周期都在微调轮子转速的"抖动控制",而是在做高层决策:现在该聚、该散、还是该跟着光走。用作者的话说,模块化的策略把"做什么"(what to do)与"怎么做"(how to do it)解耦了——底层的传感运动例程是固定的,学习只需要负责它们的时序编排与情境选择。
关于加速度的问题,作者的处理也值得学习:他们没有回避,而是坦承 e-puck 只有约 190 克、用步进电机,可以在一个控制周期内完全刹停,因此观测到的加速度对本平台不构成问题;同时明确指出,对于动力学更复杂的机器人,应该实现更平滑的底层指令与行为切换,并且可以在训练中对切换频率和加速度幅值显式加惩罚。这种"先说清为什么在本平台无害、再说清换平台怎么办"的写法,是讨论局限性的正确姿势。
八、仿真与现实的距离,是可以被设计出来的
重头戏来了。图6 是五个任务上仿真(窄箱)与真机(宽箱)的性能对比,用了带凹口的箱线图——凹口是中位数的大致 95% 置信区间,凹口不重叠说明中位数差异显著。图中还以浅色纳入了三个基准:模块化方法 chocolate、神经进化方法 evostick、以及最简单的 randomwalk。
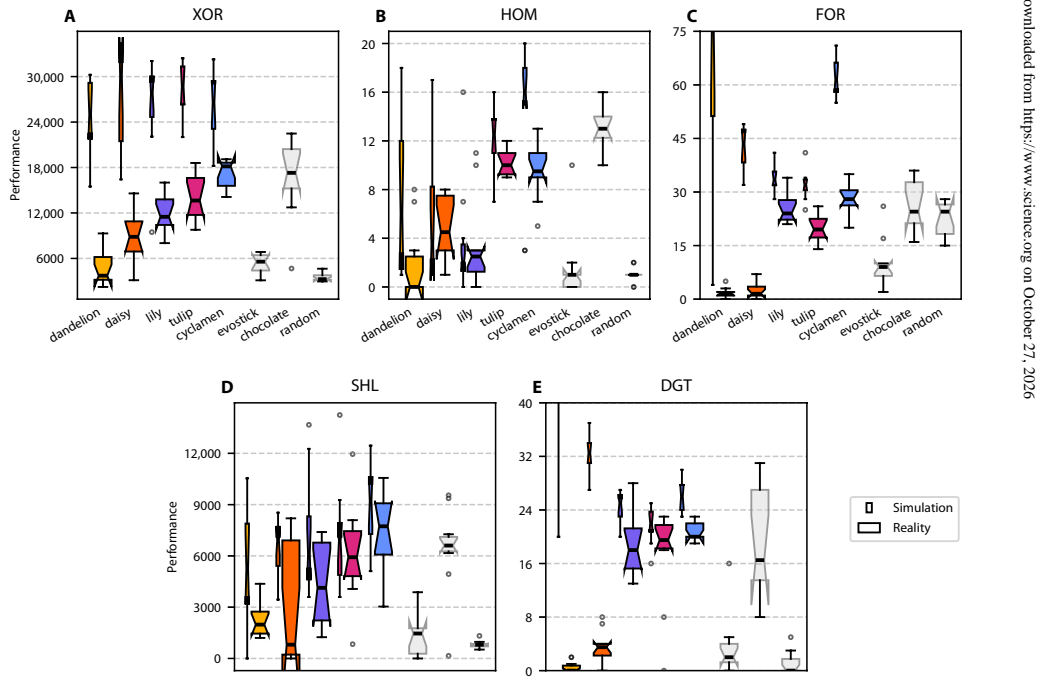
图6|原文 Fig. 6。五个任务(A–E)上各方法在仿真(窄箱)与真机(宽箱)中的性能对比。粗线为中位数,箱体为四分位距,须延伸至 1.5 倍四分位距内的极值,凹口为中位数 95% 置信区间;每个箱含 10 份独立生成的控制软件。evostick、chocolate、randomwalk 以浅色呈现以突出 dandelion 与四个 SwarmACB 变体。
结论一目了然,而且非常"打脸":所有方法在仿真里的成绩都高于真机(鸿沟客观存在),但鸿沟的大小在不同方法之间差异巨大。dandelion 的性能落差最大——它在仿真里拿到的高分,到了真机上大量蒸发,尤其在 FOR 和 DGT 这两个任务上,学到的策略在真实条件下极其脆弱。而 daisy、lily、tulip 则呈现出递进式的收敛:仿真与真机的吻合度一个比一个好。
cyclamen 的情况最微妙:它的真机总体性能最强,但因为它额外引入了 LSTM,对鸿沟的敏感度也比 tulip 略高。这构成了一个漂亮的对照——加复杂度不是免费的,但可以是有收益的,前提是加在刀刃上。
九、归一化、排名与置信区间
单个任务的结果容易以偏概全,于是作者做了跨任务的聚合,见图7。上半部分是按真机分数做逐任务 min-max 归一化后的性能:真机值落在 [0, 1],仿真值可能超过 1(超出 1.5 的极端离群值被截断)。下半部分是真机性能的平均排名及 95% bootstrap 置信区间——注意这里的重采样单位是任务(n = 5),而不是运行次数,这很讲究,因为它刻画的是"方法在任务总体上的稳定性"。
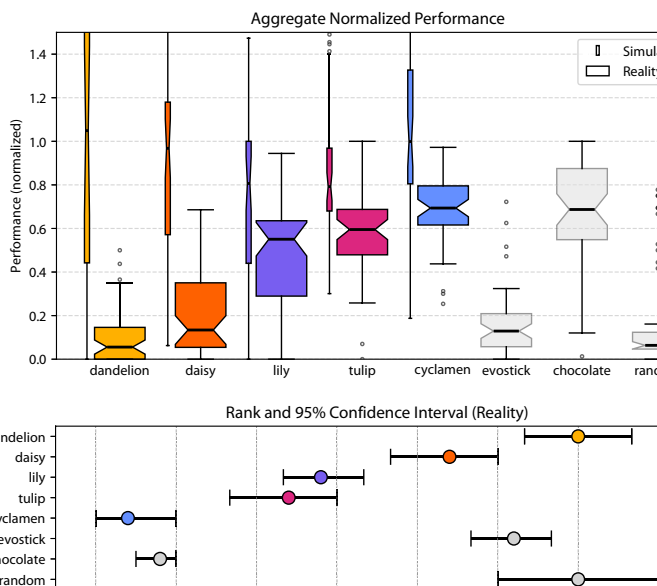
图7|原文 Fig. 7。上图:五个任务聚合后的归一化性能(窄箱为仿真,宽箱为真机),每个箱聚合 50 个观测(5 任务 × 10 次独立运行);下图:真机性能的平均排名与 95% bootstrap 置信区间(对任务重采样)。cyclamen 的平均排名最高,追平 chocolate 并优于其他所有方法;tulip 的仿真-真机落差最小。
两条核心结论。第一,dandelion 拿到了最高的仿真分数,但四个 SwarmACB 变体的迁移一致性明显更好;tulip 达成了最平衡的折中——从仿真到真机的性能跌落最小。第二,cyclamen 凭借时序记忆拿到最高的真机总体表现,平均排名追平 chocolate,超过 dandelion、daisy、lily、tulip、evostick 和 randomwalk。
把 daisy → lily → tulip 这条链子放在一起看,结论就非常清晰了:循序渐进地约束并简化策略架构,会系统性地提升迁移可靠性。而 cyclamen 是在这个地基上"有选择地"把复杂度加回来——它多出来的一点鸿沟敏感度,被"能捕捉短期依赖"这一能力带来的收益抵消掉了。觅食任务就是最好的例子:机器人需要记得"我上次回巢之后有没有去过食物源",这种短期依赖正是 LSTM 的用武之地。
十、一条教科书级的"约束光谱"
我想单独用一节来夸一下这个实验设计,因为它是做消融研究(ablation study)的范本。五个方法构成了严格的递进关系:dandelion 提供连续动作基线;daisy 只改动作空间(连续 → 六选一);lily 只在此基础上改输入(24 维 → 4 维);tulip 只在此基础上改容量(512×2 → 128×1);cyclamen 只在此基础上加时序记忆。每一步只动一个维度,五步串成一条可解释的光谱。于是"模块化、输入选择、模型容量、时序记忆"各自对迁移的贡献被干净地分离出来。
critic 那一侧还有一个容易被忽略的工程细节,见图8。每台机器人的状态被编码为 s = (ρ, cos α, sin α, cos β, sin β),其中 ρ 是机器人到场地中心的距离,α 是场地中心-光源轴与中心-机器人连线的夹角,β 是机器人朝向相对中心-机器人连线的角度。用 cos/sin 而非角度原始值,是为了消除角度在 ±π 处的不连续,同时不丢失任何信息。这种"把已知的物理/几何结构预先编码进输入表示"的做法,与整篇论文的主题是一脉相承的——把先验知识放进架构,而不是指望网络自己从数据里悟出来。
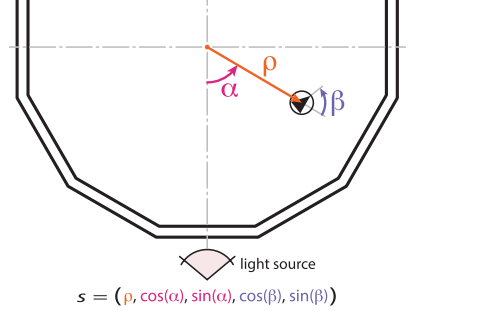
图8|原文 Fig. 8。机器人状态由三个量唯一描述:ρ(场地中心到机器人的距离)、α(场地中心-光源轴与中心-机器人连线的夹角)、β(机器人朝向相对中心-机器人连线的角度);送入神经网络时编码为 s = (ρ, cos α, sin α, cos β, sin β),以消除角度不连续性且保留全部信息。
十一、为什么会有效
作者的解释回到了 Geman 等人在 1992 年就提出的偏置-方差困境。约束策略去选择预定义模块,等于给假设空间加了一道结构性偏置:策略无法再去利用执行器层面上那些细碎的仿真伪规律,被迫去学高层协调。方差因此下降,过拟合因此减轻,迁移因此变好。
这个解释还打通了两条原本各自发展的技术脉络。一边是 AutoMoDe 这类模块化自动设计方法:通过在预定义组件的离散组合空间里搜索,获得了可靠的迁移,但牺牲了样本效率,也难以做精细的信用分配。另一边是梯度强化学习:信用分配高效、自动化程度高,但策略一旦直接作用于执行器就被鸿沟卡住。SwarmACB 的做法是——用梯度学习来做 AutoMoDe 曾经用离散搜索做的那件事,于是同时拿到了两边的优点。
这里有必要把它和层级强化学习(HRL)区分开。HRL 在多个时间抽象层次上都学习策略;而 SwarmACB 把底层原语钉死,只学习顶层的仲裁。用作者的话说,这是"刻意消除执行器层面的方差"。一个学"怎么做",一个只学"做什么"——后者正是迁移可靠性的来源。
还有一个我很欣赏的理论伏笔:由于模块仲裁是离散的,这类策略与切换动力系统(switched dynamical systems)存在天然联系,而后者是可以做形式化稳定性分析的。这为"把学习到的策略与解析保证桥接起来"提供了一条真实可行的路径——对做 AI + 控制、AI + 系统科学交叉的同学,这是一个值得立刻动手的方向。
十二、给 AI + 交叉学科研究的六点启发
把领域知识编译进架构,而不是仅仅喂给模型更多数据。这篇论文里的结构约束,和 CNN 的平移等变性、GNN 的置换不变性、物理信息神经网络里的守恒约束,是同一类东西:先验知识以归纳偏置的形式进入模型。做 AI + 材料、AI + 生物、AI + 流体、AI + 社会网络的同学,请认真盘点一下你的领域里有哪些"硬结构"——守恒律、对称性、单调性、因果约束、拓扑约束——然后想办法把它们写进架构,而不是指望一个更大的黑箱自己学出来。
把"迁移落差"本身当成评价指标,而不是附带现象。这篇论文最有说服力的数据不是真机分数,而是"仿真减真机"这个差值。在任何存在"代理模型 vs 真实系统"的交叉学科研究里(分子动力学力场 vs 真实实验、模拟电路 vs 流片、计算流体 vs 风洞、经济仿真 vs 真实市场),都应该把 gap 作为主指标明确报告,画成图6 那样的一对箱线图。你的方法在代理环境里有多好,意义有限;gap 有多小,才决定它能不能用。
消融要设计成"阶梯",而不是"开关"。很多论文的消融是"去掉模块 A 掉 3 个点,去掉模块 B 掉 5 个点",信息量极低。本文的做法是构造一条每一步只改一个维度的递进链条,让读者能读出趋势:约束越系统,一致性越好;在地基上再加一点复杂度,性能还能再涨。这种设计能让审稿人和读者同时接受"趋势"和"归因"两层结论。
样本效率与迁移可靠性是两件独立的事,别混为一谈。CASA 方法用 5000 个 episode 收敛,进化基线用 200,000 次评估,表面上是 40 倍的效率优势。但作者主动指出:CASA 在训练中对批量经验做重复梯度更新,而进化方法只在完整 episode 结束后更新一次,这个额外开销把实际效率优势"大幅收窄",再加上实现、硬件、并行化的差异,严谨比较非常困难。这种自我打折的态度值得每个做跨学科对比的人学习——尤其当你用 PyTorch 对手写 Fortran 代码时,先谈硬件归一化再谈加速比。
先定义接口,再谈方法竞争。RM 1.1 参考模型的价值在前面已经说过。交叉学科研究最大的隐性成本往往不是算法,而是"不同团队的结果无法比较"。如果你的领域还没有标准化的输入输出契约、标准测试集、标准噪声模型,那么定义它们就是低垂的果实,而且会被整个社区长期引用。
可部署性优先于代理环境里的 SOTA。dandelion 在 FOR 和 DGT 上都是仿真冠军,真机上却摔得最惨。这句话值得贴在每个做 AI for Science 的实验室墙上:如果评价只看代理环境分数,你优化的方向可能与真实目标南辕北辙。在真机、真实实验、真实临床数据上做哪怕少量、但诚实的验证,胜过在代理环境里刷一百个点的 SOTA。
十三、这篇论文没有证明什么
一篇好论文的价值,一半体现在它知道自己没证明什么。作者在讨论部分明确列出了几条边界,我在这里替大家梳理一遍。
第一,可靠性是经验性的,不是解析性的。神经网络策略无法像经典控制理论那样给出闭式稳定性证明,本文的结构约束减轻了过拟合,但并未提供任意扰动下的形式化稳定性保证——前面提到的切换系统视角,正是朝这个方向走的一步。
第二,规模可扩展性仍是开放问题。所有实验都固定在 20 台机器人;群体规模增大时,训练复杂度、通信约束和集体行为空间都会增长,本文的结论能否外推尚不清楚。
第三,模块化方法的前提是任务能被分解为原语序列。需要精细连续控制、或者所需行为不在模块库里的任务,这套方法会失败,除非扩展模块库。而"哪些任务特征能预测模块化策略的成功"目前还没有系统答案。
第四,本文的模块刻意做得非常简单:参数固定、六个模块跨所有任务共用,目的是隔离学习架构的贡献。如何在不重新引入过拟合的前提下扩展模块的表达能力,是下一步的关键挑战。
第五,训练效率的优势需要打折,理由上文已述,作者把硬件归一化的比较放进了补充材料。好消息是,这与本文的核心贡献(迁移质量)相互独立。
十四、想跟进?这里有六个可以立刻开做的课题
作者在展望部分给了几条明确线索,我加上自己的理解,供正在找课题的同学参考。把基于注意力的 critic 扩展到异质群体(用角色嵌入或形态学描述子)是第一条,也是最容易出成果的一条。第二条是把模块选择从"每步选一个模块"升级为"多时间尺度层级控制",让高层策略选择模块序列而非单个模块,这样能在保留迁移收益的同时桥接反应式行为与长时程规划。
第三条是用质量多样性(quality-diversity)算法自动生成模块库,提供更具表达力的动作空间而无需人工工程。第四条是让模块参数与选择策略联合优化,但约束参数相对已验证默认值的偏离幅度——这是一个非常漂亮的约束优化问题,兼顾适应性与可迁移性。第五条是把结构偏置与域随机化、可微物理仿真结合:前者靠架构减少方差,后者靠训练分布拓宽覆盖面,理论上互补。
第六条是我个人最看好的:研究模块库的性质——规模、多样性、语义一致性——中究竟哪一个最能预测学习与迁移的成功。这个问题一旦有了答案,"如何为任意任务设计动作空间"就从手艺变成了科学,其影响会远远溢出群体机器人领域,延伸到一切"把动作空间离散化"的决策问题:临床治疗方案推荐、交通信号控制、乃至组合优化里的启发式选择。
补充一句实操信息:论文的代码、配置文件与分析工具已在 Zenodo 公开(含 Unity 工程),数据也在正文与补充材料中完整给出。想复现的同学门槛不算高,主要成本在 20 台 e-puck 硬件与顶部追踪系统。
十五、写在最后
这篇论文让我想起一句老话:自由不是想做什么就做什么,而是不想做什么就可以不做什么。给策略减去自由度,它反而在真实世界里站得更稳。在一个被"更大、更多、更强"叙事主导的时代,这篇 Science Robotics 用一个近乎笨拙的实验——20 台小机器人、250 次真机、一层层往策略上加锁——提醒我们:结构先验不是无奈的妥协,而是把人类知识送进学习系统的正门。下次当你的模型在仿真里漂亮得不像话时,先别急着发朋友圈,问问它:你敢不敢在真机上跑一次?

内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢