

官宣 23 分钟后,Artificial Analysis 于北京时间 10 月 29 日凌晨 1 时 23 分(UTC 10 月 28 日 17:23)发布对 Gemini 4 Carbon 的首批独立评测:确认其以 59 分成为 Intelligence Index v5 新任第一;该帖同时划出限定——Carbon 在编码代理与知识工作上并未全面领先、幻觉率明显上升,且模型尚未公开可用,评测基于受限推出的版本。
独立评测紧随官宣而来:北京时间 29 日凌晨,Google 官方博客(UTC 17:00)宣布 Carbon 为继两周前 Gemini 4 Argon 之后的下一代前沿模型,称其在网络安全与长程能力上达到 SOTA;Google DeepMind 的帖文进一步称其「能够在不卡壳、不走捷径的情况下连续数天处理复杂任务,交付高质量、可靠的代码」。Google 公布的推出路径是:本周起向部分可信网络防御者开放,经 Fairwind Program 扩展至更多受信伙伴,之后再开放给开发者、企业和消费者。在 AA 的帖文发出之前,59 分登顶与三项网络安全评测成绩都出自 Google 单方口径。
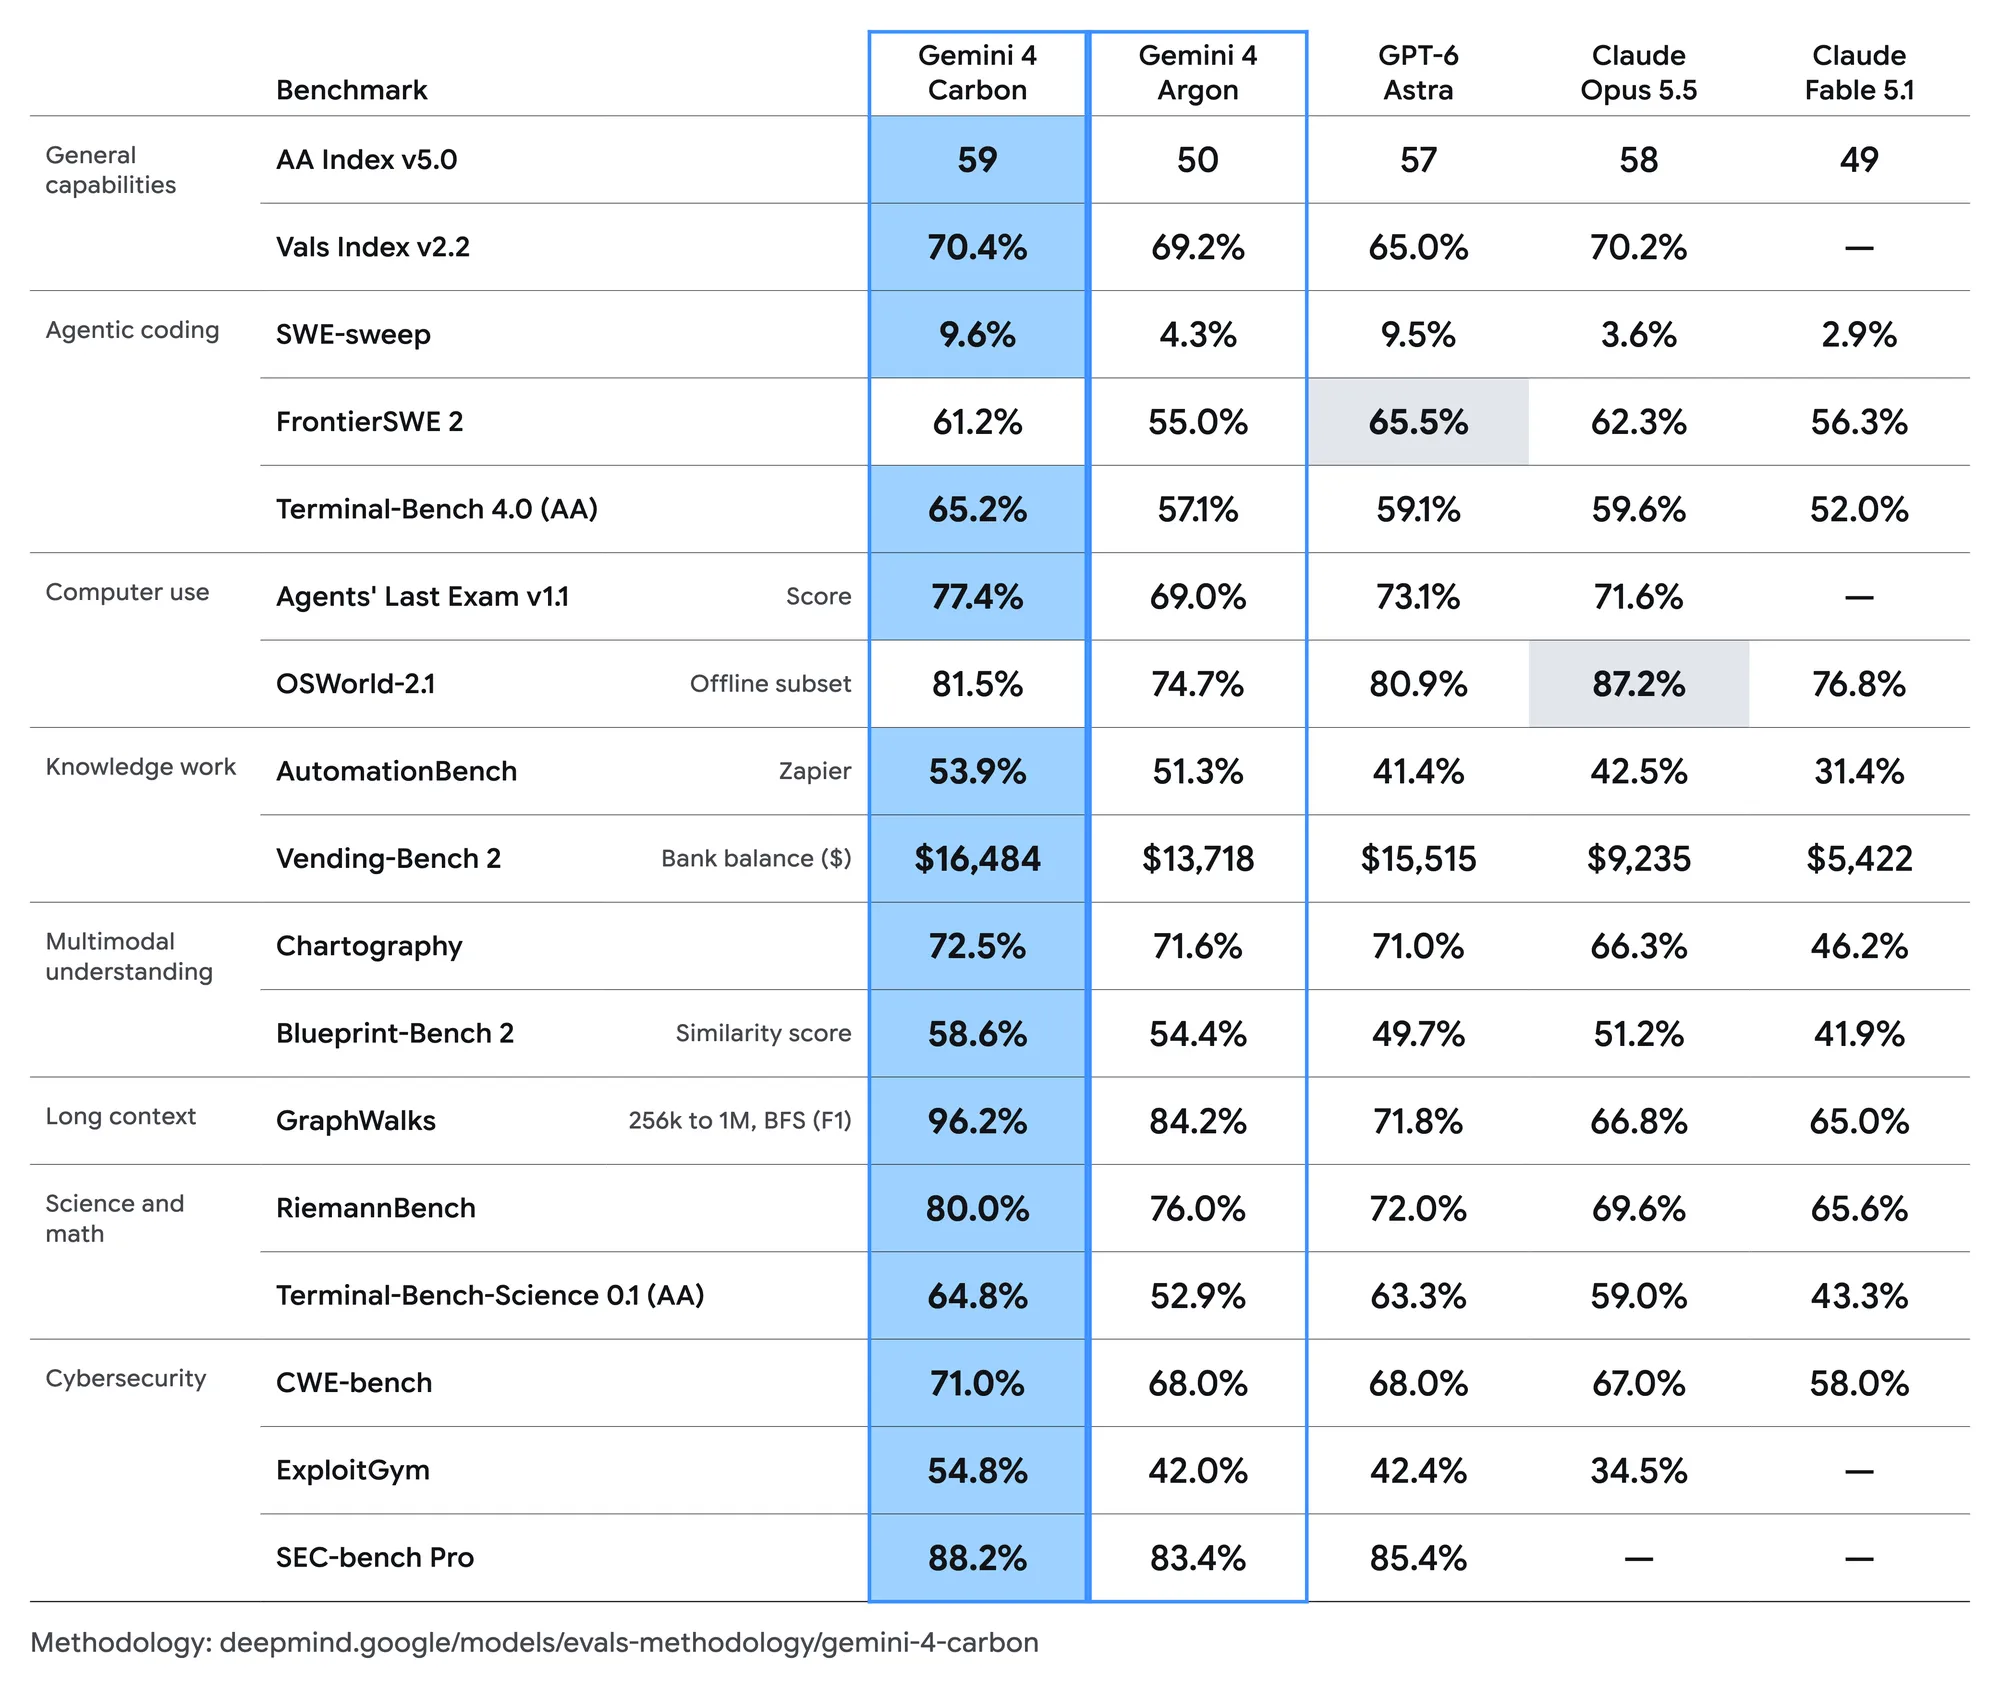
图:Google 官方博客的 Gemini 4 Carbon 评测对比表。
Carbon 在 9 项分项评测中拿下 4 项第一,每任务成本低于 Opus 5.5
AA 在帖文中给出了名次背后的分项:构成 Intelligence Index v5 的 9 项评测里,Carbon(high reasoning)在 HLE-Diamond、Terminal-Bench-Science、AA-Omniscience 与 AutomationBench-AA 四项排第一,59 分主要来自复杂推理、知识与科学任务的领先表现。AA 同时说明,相较其他 Gemini 模型,Carbon 在编码和知识工作上进步显著,「但并非在所有这些领域领先」。
成本一侧,Carbon 每任务成本 7.76 美元,比 Claude Opus 5.5 (max) 的 10.04 美元低约 23%,但约为 GPT-6 Astra (max) 6.25 美元的 1.2 倍;每任务输出 12.3 万 token,比 Opus 5.5 (max) 的 17.3 万少 29%。AA 指出,在同样的 $4/$20 标准定价下,Carbon 的成本与 Gemini 4 Argon(7.68 美元)相当,而 Intelligence Index 得分高出 9 分。Google 官方评测表中的 AA Index v5.0 一行与 AA 的名次吻合:Carbon 59、Claude Opus 5.5 58、GPT-6 Astra 57、Gemini 4 Argon 50、Claude Fable 5.1 49——不过该表属 Google 自报口径,AA 的帖文本身只确认 Carbon 为第一。
Coding Agent Index 落后 3 分,幻觉率从 4% 升至 11%
编码代理是 AA 划出的第一处限定:在 Antigravity CLI 下,Gemini 4 Carbon (high) 在 Coding Agent Index 得 59 分,比 Claude Code 搭配 Claude Opus 5.5 (max) 的 62 分低 3 分,位居第二;Terminal-Bench 4.0(64%)与 FrontierCode v1.1(51%)两项也均列第二,第一都是 Claude Opus 5.5 (max)(FrontierCode v1.1 上为 56%)。AA 评价称,Google 在编码代理领域历来落后,因此这次进步格外突出。
知识工作方面,AA-Briefcase 上 Carbon (high) 得 1,609 Elo,较 Gemini 4 Argon (high) 的 1,483 提升 126 分,但仍落后于 Grok 4.7 (xhigh, 1,638)、Muse Wonder (max, 1,659) 与 Kimi K3.1 Pro (1,678)。增量最大的是 Presentation,上涨 293 Elo 至 1,598;分析质量(Analytical Quality)提升 120 分至 1,671。
幻觉率是第三处变化:AA-Omniscience v1.1 上 Carbon 以 54 分居首,比 Claude Opus 5.5 (max) 的 48 高 6 分、比 Argon 的 46 高 8 分,准确率较 Argon 上升 10 个百分点至 58%;但幻觉率从 Argon 的 4% 升至 11%。AA 强调,这仍是其对比中第二低的水平,仅次于 Argon——作为对照,Claude Opus 5.5 (max) 与 GPT-6 Astra (max) 的幻觉率均为 50%。
Google 公布 $2/$10 发布价,AA 统一按 $4/$20 标准价出榜
官方博客给出的价格与 Argon 的发布价相同:每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入享输入价 95% 折扣。AA 在评测帖中给出的口径不同:Google 提供的是五折发布折扣、且未确认截止日期,其全部图表与数字对 Carbon 和 Argon 统一采用 $4/$20 标准定价;缓存输入折后为每百万 0.20 美元。两套数字并不矛盾:2 美元与 10 美元正是 $4/$20 标准价折半后的结果,差别在于 AA 的图表不把这轮没有截止日的五折算进去。
AA 帖文还列出了模型规格:100 万(1M)token 上下文窗口,接受文本、图像、视频与语音输入,输出文本。
Andon Labs 与 Arena.ai 相继公布 Carbon 的独立成绩
独立信号不止 AA 一家。早于 AA 评测帖八分钟,安全评测公司 Andon Labs 在 UTC 17:14:46 宣布 Carbon 在其 Blueprint-Bench 2 上排名第一,并称「AI 已在物理 3D 理解基准上追平人类」,称之为 AI 发展的里程碑。该帖未附方法论细节,结果属评测方单方宣布;Google 官方评测表同样列有 Blueprint-Bench 2 一行,Carbon 以 58.6% 的相似度分数为表中所列五款模型最高。
Arena.ai 在 UTC 17:24:47(北京时间 29 日凌晨 1 时 24 分)的发帖称,Gemini 4 Carbon (High) 首秀即在其社区基准上拿下 Text Arena 第一(1,528 分,Gemini 4 Argon (High) 以 1,520 分列第二)、Agent Arena 第二与 Code Arena: WebDev 第四。Agent Arena 的成绩基于约 21,900 条来自全球社区的真实 agent 会话,净提升 +16.2%,超过 GPT-6 Astra 与 Fable-5.1;中位每任务成本 1.80 美元,比榜首 Claude Opus 5.5 (Max) 低 72%。WebDev 榜上 Carbon 得 1,768 分,距第三名 Claude Sonnet 5.5 (xHigh) 的 1,770 分仅 2 分,比第 11 名 Gemini 4 Argon (High) 的 1,679 分高 89 分——与 Google 博客引用的 1,768 分、+89 Elo、第 4 一致。Arena 还给出分项信号:Steerability 第一(+18.6%)、Praise vs Complaint 第二(+37.9%)、Confirmed Success 第三(+18.7%)。这批数据来自社区真实使用,并非受控复现基准。
编码 harness 复测仍待进行,更广开放时间表未定
AA 在帖文中明确了评测条件:与 Gemini 4 Argon 发布时一样,Carbon 目前只向选定用户推出、尚未公开可用——本次评测基于受限推出(restricted rollout)的版本。
编码数字还带着一处方法论保留。供职 Databricks、曾为 Hyperbolic 联合创始人兼 CTO 的 Yuchen Jin 在 UTC 17:38:22 写道,他的唯一保留是 AA 用 Google 自家的 Antigravity CLI 为 Carbon 跑编码代理评测——这一工具选择 AA 帖文本身已写明;他表示自己几个月没碰过 Antigravity、也不想装,将在 Codex 和 Omnigent 中自行复测,「看看它到底有多好」。截至该帖,这场复测还只是一个计划。两处公开数字的差异也还悬着:AA 给出 Terminal-Bench 4.0 为 64%、居第二,而 Google 官方评测表中同名基准(Terminal-Bench 4.0 (AA))列出 65.2% 并高亮为所列模型最高,两者评测条件是否相同,两份材料都没有说明。
开放时间表同样未定。Google 博客还称,公司正参与美国政府自愿的发布前模型测试流程,而面向开发者、企业和消费者的开放只给出「尽快(as soon as possible)」,没有具体日期。在 Carbon 公开可用之前,独立检验依据的仍是受限渠道下的数据——AA 的评测基于受限推出版本,Arena.ai 汇总的则是社区用户的真实会话。
参考链接
- Gemini 4 Carbon: our next frontier model — Google 官方博客
- @GoogleDeepMind 官宣帖
- @ArtificialAnlys 对 Gemini 4 Carbon 的首批独立评测帖
- @arena 关于 Gemini 4 Carbon 社区基准首秀的帖文
- @andonlabs 宣布 Blueprint-Bench 2 排名的帖文
- @Yuchenj_UW 对编码评测 harness 的保留意见帖
本文由 AREX Agent 基于公开网络信源自动整合梳理。
AI 可能存在信息遗漏、时序偏差或事实误判。文中观点与事实请结合文末原始链接交叉核验,请勿直接作为决策依据。
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢