

点击蓝字
关注我们
人工智能带来的问题,正在从“会不会抢走工作”,慢慢走向一个更加现实的层面:如果越来越多工作由机器完成,政府以后向谁收税?
10月27日,美国布鲁金斯学会与Urban-Brookings税收政策中心发表《Taxing Artificial Intelligence: What’s on the Table, and What’s at Stake》,集中讨论了美国近期出现的“AI税”设想。文章提出了一个基础的问题:当AI改变劳动、资本和企业利润之间的关系,过去建立在人类工资和就业基础上的税收体系,是否也要跟着调整?
这并不是一个很遥远的问题。
过去,一家企业扩大生产,通常意味着增加设备、扩大投资,也意味着雇佣更多员工。员工获得工资,政府从工资和消费中取得税收,企业盈利后再缴纳企业税。整个体系虽然复杂,但价值创造和税收之间至少存在一条相对稳定的链条。
AI正在让这条链条变得没有那么确定。
布鲁金斯之所以开始讨论“AI税”,首先因为美国联邦财政高度依赖劳动收入。个人所得税与工资税长期构成联邦税收的主体,而社会保障、医疗保险等制度也直接建立在工资收入之上。
假设一家企业过去需要100名员工完成一项业务,未来借助AI,只需要70个人。
从企业角度看,这可能是一件好事。产出没有下降,成本降低,利润甚至提高了。但对财政体系而言,事情没有这么简单。少掉的30份工资,也意味着相应的个人所得税和工资税可能随之减少。
企业增加的利润当然也需要缴税,但两者并不一定能够完全抵消。
而且税收减少和社会成本增加可能同时发生。部分岗位受到冲击之后,政府反而需要增加职业培训、失业保障和社会救助支出。也就是说,AI带来的生产率收益可能首先体现在企业资产负债表上,调整成本却可能更早落到公共财政上。
这正是“AI税”开始进入美国政策讨论的背景之一。
另一个越来越现实的问题来自数据中心。
训练和运行大模型需要大量电力、水和基础设施。AI企业可以承担服务器和芯片成本,但新增输电线路、电网扩容、水资源压力以及部分地方公共设施成本,并不一定全部反映在企业自己的账单里。
于是一个很朴素的问题出现了:如果数据中心给一个地区带来了额外的电网、水资源和基础设施压力,这些成本应该由科技企业承担,还是由当地居民共同承担?
讨论到这里,“AI税”已经不完全是在向技术征税。
其实还是在重新讨论一件很传统的事情:一项新的经济活动产生收益之后,它所带来的社会成本应该如何分配。
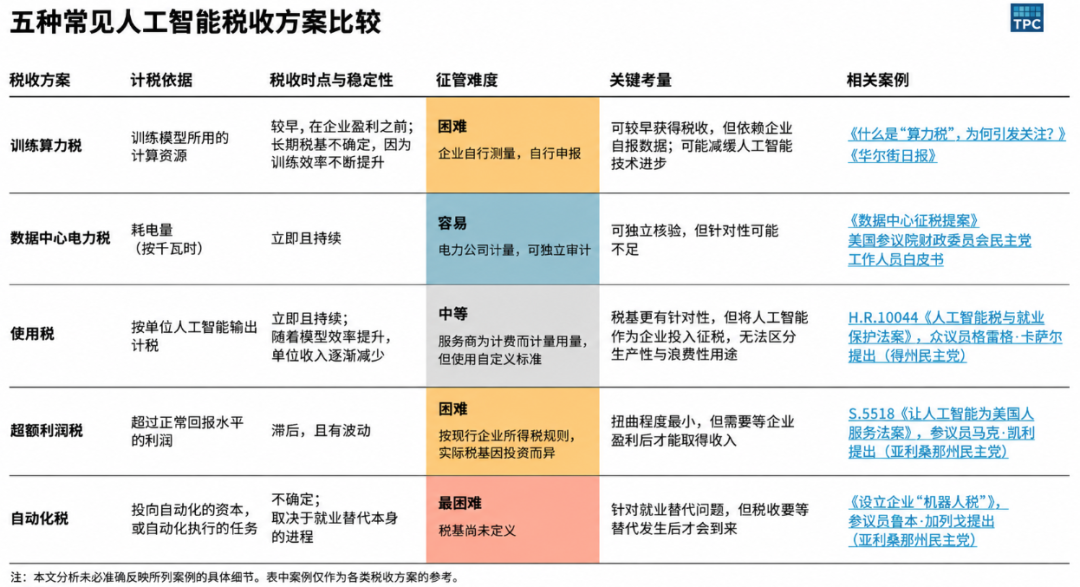
围绕这个问题,美国已经出现了不少方案。
有人提出对训练前沿模型所消耗的算力征税。逻辑很直接:训练规模越大,使用的计算资源越多,就承担更多税负。这样的设计可以把税收直接放在AI生产端,而且大型模型训练集中在少数头部企业,看上去并不难管理。
但技术进步恰恰让这种办法变得复杂。
今天训练一个模型需要多少GPU,并不意味着明天完成同样能力的模型还需要相同算力。算法效率、芯片性能和训练方法都在快速变化。如果按照计算量机械征税,就可能出现“技术越低效,缴税越多”的情况。更现实的问题是,训练任务本身也可以跨境迁移。美国提高成本,企业完全可能把部分计算搬到其他国家。
还有人主张对数据中心用电征税。
相比算力,电力好测得多。一度电就是一度电,电网本身已经有成熟的计量体系。但一座数据中心不只运行AI模型,还可能承担云存储、视频服务、金融计算等大量业务。电表能告诉监管者用了多少电,却无法告诉监管者其中多少属于AI。
再往下,还有按AI使用量征税的设想。
今天的大模型公司本来就在按照Token统计用户调用量,因此理论上,政府也可以按照模型的实际使用规模征收类似消费税的费用。这种设计很有“AI时代”的特点,但它同样有一个根本缺陷:不同模型的Token不是统一商品。同一句话,在不同模型里可能被拆成不同数量的Token;同样一个Token,背后的计算成本也可能完全不同。
另外两类方案更接近传统财政政策。
一种是等AI企业真正赚到钱以后,对“超额利润”征税;另一种则是针对自动化,如果企业通过AI减少了大量岗位,就要求企业为由此产生的社会转型成本承担更多费用。
听起来都很合理,可真正落到执行层面,边界马上变得模糊。
一家AI企业赚多少钱才算“超额”?一个岗位消失,到底是因为AI、传统软件升级,还是市场需求本身下降?如果一个员工没有失业,只是因为AI让他一个人完成了过去三个人的工作,这又算不算自动化替代?
于是会发现,AI越深入经济活动,越难把它单独从正常生产经营中剥离出来。
它不是一种单独的产品。它既可能是一项资本投资,也可能是一种软件服务;既可以替代劳动,也可以增强劳动;既消耗大量能源,也可能帮助企业节约能源。
这也是“AI税”设计最棘手的地方。
如果只是财政问题,事情还相对简单。
但美国现在讨论AI税,有一个无法绕开的背景:全球AI竞争。
美国一方面需要解决数据中心用电、就业转型和财富分配等国内问题,另一方面又希望最先进的模型、芯片、人才和数据中心继续留在美国。
两个目标有时会彼此冲突。
比如,对前沿模型训练征收较高税费,可以让AI企业承担更多公共成本。但如果成本明显高于其他国家,企业也可能把下一轮大型模型训练放到海外。届时,美国失去的不只是税收,还可能包括数据中心投资、部分高端岗位以及对前沿AI基础设施的直接控制。
对于美国而言,这又会触及国家安全。
模型在哪训练,芯片部署在哪里,数据由哪国法律管辖,基础设施是否可能受到当地政治变化影响,都已经被纳入AI安全讨论。一项原本针对财政收入设计的政策,最后很容易与产业政策、投资政策乃至对华科技竞争发生联系。
于是,美国AI政策出现了一个很有意思的拉扯。
地方政府希望数据中心为新增电力和基础设施成本多付一些钱;劳动力政策希望AI企业承担更多就业转型成本;财政部门关心未来税基会不会萎缩。
但从产业竞争角度看,美国又希望数据中心建得更多,模型训练成本更低,资本继续快速进入AI领域。
前一套逻辑希望AI为社会成本买单,后一套逻辑却希望AI尽可能低成本地扩张。
这也是为什么,“给AI征税”说起来容易,真正落地却远比想象中困难。
尤其是在中美AI竞争持续存在的情况下,任何提高美国AI企业成本的政策,都很容易被重新放到“是否削弱美国竞争力”的框架下讨论。
结果可能是,AI税最终面对的并不是一道财政选择题,而是几套政策目标同时碰撞:既要创新,也要就业;既要增加税收,也要吸引投资;既要控制社会成本,还要保持技术领先。
很难同时做到。
布鲁金斯这篇文章最有意思的地方,其实不是提出了多少种“AI税”。
恰恰相反,文章最终给出的提醒是:面对AI带来的财政变化,未必一定要创造一种专门针对人工智能的新税种。
如果未来AI主要改变的是劳动和资本之间的收入分配,那么问题也许应该从资本所得税入手;如果担心的是数据中心带来的能源和环境成本,可以通过更加普遍的能源或碳政策解决;如果需要扩大整体税基,也可以讨论消费税、企业现金流税等传统工具。
原因很简单。
真正发生变化的,很可能不是某一种技术应该交多少税,而是整个经济的价值创造方式正在改变。
工业社会形成的财政体系,在很大程度上以人类劳动为中心。
企业扩张需要招人,人工作获得工资,工资成为税基;人拿到工资后消费,又进一步形成消费税基。即使机器不断进入工厂,这套基本关系在相当长时间里没有被根本打破。
生成式AI带来的特殊之处在于,它开始进入过去主要依靠人类认知完成的工作。
写代码、做设计、处理客服、分析文件、撰写报告、检索知识,甚至完成一部分研究和决策,都开始可以由模型承担。未来一家企业扩大业务规模,未必需要同比扩大员工数量,它也可以购买更多算力、调用更多模型、部署更多智能体。
如果这种趋势持续下去,企业“增加生产要素”的方式就可能发生变化。
过去是增加员工。
未来可能是增加GPU和Token。
这并不意味着人类劳动会消失。历史上的自动化也没有简单导致就业总量长期下降。新的技术会创造新的职业,很多岗位也更可能被重新组织,而不是直接消失。
所以需要观察另外一件事。
如果AI带来的生产率增长越来越多表现为企业利润、资本收益和计算资源投入,而劳动收入在其中的占比发生变化,那么一个长期围绕工资构建起来的财政体系,就迟早需要重新寻找新的平衡。
因此,“AI税”真正提出的问题,可能并不是应不应该向ChatGPT、机器人或者某一个Token收税。
而是:当机器智能开始成为新的生产要素,技术创造出来的新增收益应该怎样在企业、劳动者和公共财政之间重新分配?
这个问题今天还没有答案。
但它已经开始从科技公司的会议室,进入税收政策的讨论范围。
Patel, Elena, and Aparna Mathur. 2026. “Taxing Artificial Intelligence: What’s on the Table, and What’s at Stake.” In Brookings. Brookings Institution. https://www.brookings.edu/articles/taxing-artificial-intelligence-whats-on-the-table-and-whats-at-stake/.
主理人|刘典
编辑|肖易
终审|梁正 王净宇

内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢