

大模型的发展让 Scaling 成为人工智能的重要研究方向。推荐系统积累了丰富的交互数据,如何把这些数据和持续增长的算力转化为更准确的理解与匹配能力,是推荐模型走向更大规模时需要回答的核心问题。召回决定了哪些候选有机会进入后续排序,需要在数千万乃至上亿候选中完成筛选,但在线预算往往只有几十毫秒。把更强的 Transformer 引入召回,既要让新增计算带来效果收益,也要让这种能力在海量候选检索中高效运行。
围绕这一问题,阿里妈妈展示广告 Match 团队与中国人民大学联合提出 TransRetrieval。我们将用户与广告特征组织为 Transformer Token,从异构特征聚合、Target Token 压缩和多场景共享入手,构建可持续扩展的工业召回模型。这项工作已被 CIKM 2026 录用为 Oral Paper。
我们在包含 400 亿条交互的工业数据集和公开数据集 KuaiRand 上观察到,TransRetrieval 的召回效果随计算量增长总体呈上升趋势。在持续一个月的线上 A/B 实验中,平台收入提升约2.5%。
论文标题:TransRetrieval: Scaling Up Transformer-Based Retrieval for Industrial Recommendation
论文链接:https://arxiv.org/abs/2608.25528
1. 问题背景:召回模型的 Scaling,难在哪里?
召回需要从海量广告库中筛选出候选集合,交给后续排序。传统双塔模型分别编码用户和广告,通过向量内积实现高效检索;用户与广告之间的匹配关系,也主要由这一次内积表达。更丰富的特征交互,有助于模型识别细粒度的兴趣与需求,却会增加检索时的计算开销。
在此前的二向箔(NANN)[1]工作中,我们采用模型驱动的检索框架:在 HNSW[2] 上用神经网络的打分引导搜索,让复杂的用户与广告交互直接参与候选发现。TransRetrieval 沿用这一范式,进一步扩展打分网络的能力。这需要解决三方面的挑战:
探索可 Scaling 结构:推荐系统的输入天然异构,用户属性、行为序列和广告属性在取值数量、weight 与分布上存在明显差异。将这些特征映射到相同维度后,各 Token 的数值尺度仍可能相差悬殊,影响后续交互建模。导致堆叠模型参数、Transformer 层数&深度离在线指标反而下跌的问题。
海量候选下的算力分配:在召回阶段,候选广告库量级巨大,严重制约了模型 Scaling 空间。在我们的场景下,候选量级为千万,通过 HNSW 图检索将打分候选数量大幅降低至万级别,但每个被访问的候选仍需经过模型计算。单候选的开销会在一次请求中重复数万次,成为扩展打分网络时的关键约束。
多场景数据复用:工业推荐通常还需要服务多个业务场景。不同场景的用户行为与候选分布各有特点,数据量也不均衡。统一模型既要利用跨场景数据,也要识别当前请求所处的场景,才能让共享参数学到有效的匹配关系。
2. TransRetrieval 模型设计
针对上述三个挑战,我们分别从输入端、计算预算分配和多场景数据复用三个层面对现有召回模型进行了升级,提出了 TransRetrieval 模型。其模型结构如下图,整体基于标准 Transformer 结构,通过如下步骤完成 user 和候选广告的打分:
输入端 - 特征聚合:将 user 侧和 target 侧的输入 ID 特征映射为输入 Transformer 的 token。此处我们采用了Weighted Mean 聚合来缓解多值特征带来的尺度差异,确立了具备显著 Scaling Law 性质的召回模型结构。
计算预算分配 - Trarget 特征压缩:为了降低海量候选带来的算力需求,我们将 Target 侧特征压缩到一个 token,有力支撑了召回模型的高效 Scaling。
多场景建模 - Position-style Domain Embedding:我们将场景信息通过 embedding 相加的方式融入 Transformer 输入中,在几乎不增加推理计算量的前提下完成了简洁、高效的多场景建模。
主干打分网络 - 多层 Transformer:将 user 侧和 target 侧的 token 输入多层 Transformer 交互网络,使得 Target Token 可通过多层 attention 读取用户上下文,再经 MLP 预测头输出召回分数。
其中主干 Transformer 为标准 Pre-LN Transformer,FFN 使用 ReLU 激活。以下分别介绍前三项我们的核心创新。
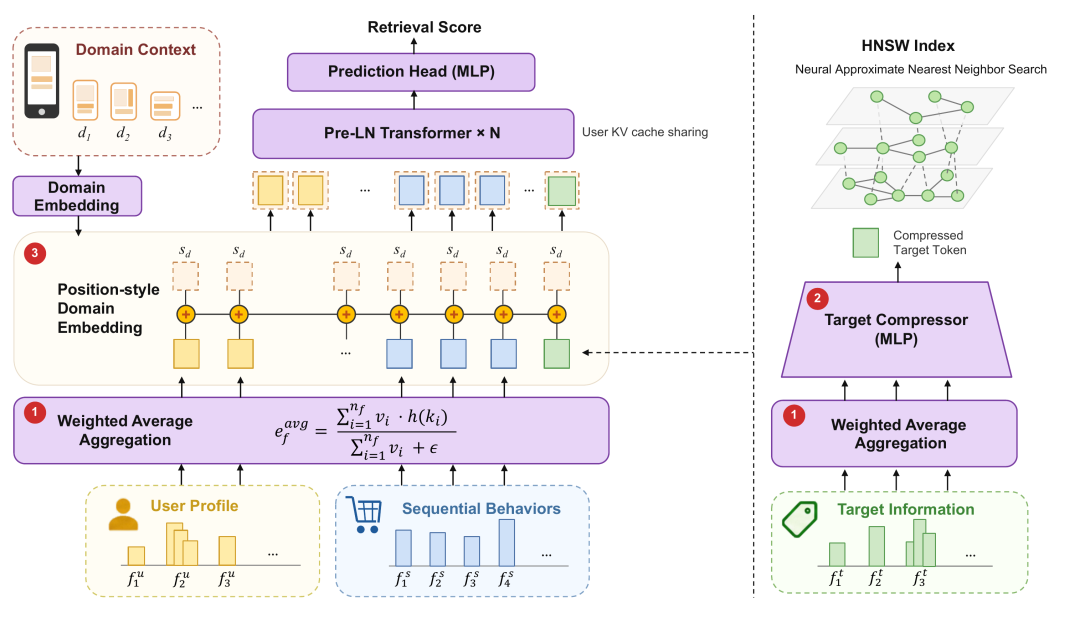
图 1. TransRetrieval 整体架构
2.1 Weighted Mean:从输入端改善尺度失衡
在搜推广中,ID 特征是最常用的特征。每个 ID 特征均可抽象为二元组列表的形式,其中为 ID,为对应的权重(均 为 1 时代表无权重,如序列特征)。一般通过如下 weighted sum 的方式将 ID 特征映射为 embedding 输入模型:
其中,字段的 ID 数量为 和 分别为 ID 及其 weight, 是对应的 Embedding, 用于数值稳定。
在 Weighted Sum 聚合方式下,输出 embedding 的尺度容易随 ID 数量和 weight 总量累积。我们观察到最大 token norm 最高可达最小 norm 的 10 倍,导致 Transformer 中 attention 集中于高 norm token,低 norm token 重要性极低,进而导致增加主干 Transformer 层数、宽度后模型效果持平甚至下跌。
为此,我们采用了 Weighted Mean 特征聚合方式,在 Weighted Sum 的结果上除以 weight 总量,保留各取值的相对权重,同时减弱累计 weight 对 norm 的影响:
在工业数据集上,我们固定 Transformer 主干,比较四种聚合方式。Weighted Mean 在四个场景上均取得最高 Recall,整体较 Weighted Sum 提升 1.0pt。
Recall@2000 衡量真实正样本进入前 2,000 个召回结果的比例;
Overall 按各场景评测交互量加权。
| Aggregation | Domain A | Domain B | Domain C | Domain D | Overall |
|---|---|---|---|---|---|
| Weighted Mean | 61.0% | 59.8% | 58.9% | 68.1% | 61.8% |
表 1. 不同聚合方式的 Recall@2000(Industrial,64D-5L)。D 表示模型维度,L 表示 Transformer 层数。
2.2 Target Token Compression:为更深、更宽的主干腾出预算
离线训练和在线推理中,我们采用多个候选共享同一 user KV-cache 的策略,用户编码每次请求只需执行一次,Target 侧的投影、FFN 及其与用户上下文的 attention 则随候选重复执行。Target 相关的网络部分计算量近似为:
其中, 是模型维度, 是 Transformer 层数, 和 分别是用户侧 Token 数和单个 Target 的 Token 数, 为 FFN 升维倍数, 是一次请求实际打分的候选数量。
这个公式中的变量对应不同的设计取舍:模型容量需要扩展,检索覆盖与用户信息需要保留,Target Token 数量则提供了直接的压缩空间。
与:扩展模型能力。 维度和层数是模型 Scaling 的主要方向,需要将计算预算用于支持更深、更宽的交互主干。
:保留检索覆盖。 HNSW 已将实际打分量压缩到约 4 万个候选。继续减少会收缩图搜索范围,可能损失检索精度。
:压缩收益有限。 在上式中仅影响 attention 项,Target 的投影与 FFN 开销不随它变化。当 项占主导时,减少用户侧 Token 对逐候选计算开销的改善有限,还可能损失用户信息。
:直接降低逐候选计算。 在上式中,Target Token 数量同时线性影响投影、FFN 与 attention 开销。将多字段信息提前融合为更少的 Token,可以为主干扩展释放计算预算。
我们据此使用 Target Compressor,将拼接后的广告特征通过三层 MLP 融合成一个 Target Token。多字段信息在进入主干前完成融合,每层 Transformer 只需处理一个 Target Token,并保留它与完整用户上下文的多层交互。
Target Compressor 三层的输出维度依次为 8D、4D、D,中间使用 PReLU 和 LayerNorm,最后一层为线性投影。得到的定长向量同时用于构建 HNSW 索引。
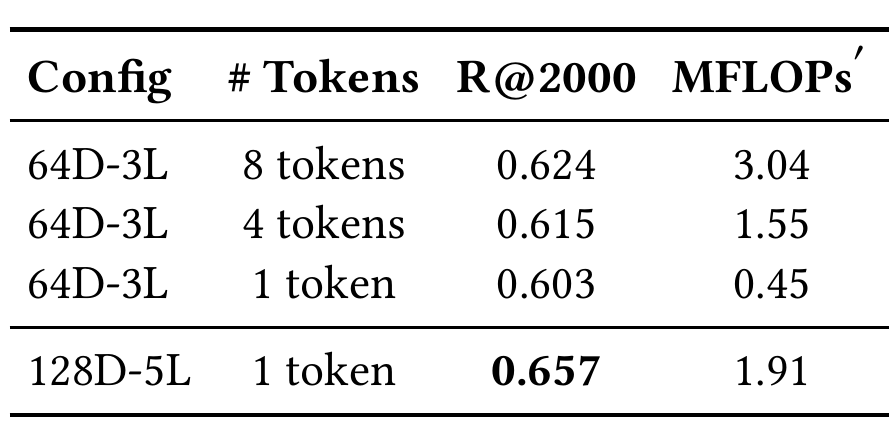
表 2. Target Token Compression 与主干扩展的效果对比。MFLOPs′ 表示 Target 侧的单候选计算量,以百万次浮点运算为单位。
在 64D-3L 的 Transformer 结构下,将 Target Token 从 8 个压缩到 1 个,单候选计算量由 3.04 降至 0.45 MFLOPs,减少约 85%,Recall 降低 2.1pt( 62.4% → 60.3%)。把节省下的预算投入更宽、更深的 128D-5L Transformer 主干后,Recall 达到 65.7%,单候选计算量为 1.91 MFLOPs。相较最初的 8 Token 64D-3 Transformer 配置,最终 128D-5L 1token 模型以更低的计算量获得了 3.3pt 的提升。
2.3 Domain Embedding:让多场景数据共同支撑模型 Scaling
当主干持续扩大时,按场景分别训练和部署模型会放大训练与服务成本;数据较少的场景也难以单独支撑更大模型。我们希望把多场景数据汇聚到一套主干中,让不同场景共同支撑模型扩展。需要解决的关键问题是:如何在共享参数的同时,保留各场景的分布差异?
我们首先尝试直接混合四个场景的数据。在 64D-3L 配置下,整体 Recall 从独立训练的 57.9% 降至 26.5%。追加一个表示场景 ID 的 Domain Token 后有所改善;将其重复到 20 个,Recall 也仅达到 45.2%,仍低于独立训练,用户侧计算量却从无额外 Token 时的 41.3 增至 49.8 MFLOPs。增加场景 Token 的数量,未能在效果与计算开销之间取得满意的平衡。
这促使我们把关注点转向场景信息的注入方式。我们希望每个特征从进入网络时就带有场景条件,同时保持原有序列长度。为此,我们为每个场景学习一个 Domain Embedding,借鉴 position embedding 的加法形式,将其逐元素加到所有输入 Token 上:
其中,d 表示场景。每个场景对应一个可学习向量,所有场景共享完整的 Transformer 主干。场景条件直接进入各 Token,attention 与 FFN 参数则由各场景样本共同更新。
| Setting | A | B | C | D | Overall | User |
|---|---|---|---|---|---|---|
| Domain Embedding | 59.3% | 59.0% | 57.5% | 66.3% | 60.3% | 41.3 |
表 3. 多场景建模方案的离线对比(Industrial,64D-3L)。Recall@2000 以百分比表示;MFLOPs 仅统计单次请求的用户侧计算,各设置的 Target 侧处理保持一致。
在相同的 64D-3L 主干下,我们的统一模型将 Overall Recall 提升至 60.3%,较独立训练增加 2.4pt,用户侧计算量维持在约 41.3 MFLOPs。四个场景的 Recall 都超过了对应的独立模型。
这让多场景统一成为我们继续 Scaling 的数据基础:各场景共同支撑更大主干的训练,主干能力的提升也能同时服务多个业务场景。
3. 实验结果
3.1 数据与评测设置
我们使用包含 400 亿条交互的工业数据集,以及从 KuaiRand[3] 经预处理得到的约 1.52 亿条交互数据。两者均覆盖四个场景,按时间划分训练集与测试集。各模型在统一框架下训练与评测,保留各自的特征处理方式。Production Baseline 为此前线上使用的竞价感知召回模型 BAR[4],对比方法包括 KuaiFormer[5],以及适配到召回评测中的 HSTU[6] 和 RankMixer[7]。
3.2 在不同计算预算下比较召回效果
| Industrial | ||||||
|---|---|---|---|---|---|---|
| Method | Domain A | Domain B | Domain C | Domain D | Overall | MFLOPs′ |
| Production Baseline | ||||||
| TransRetrieval-64D3L | ||||||
| TransRetrieval-128D5L | 64.4% | 64.1% | 63.4% | 71.9% | 65.7% | |
| KuaiRand | ||||||
| Method | Tab 0 | Tab 1 | Tab 2 | Tab 3 | Overall | MFLOPs′ |
| 61.1% | ||||||
| Production Baseline | ||||||
| TransRetrieval-64D3L | ||||||
| TransRetrieval-128D5L | 52.6% | 46.5% | 47.9% | 47.3% |
表 4. Industrial 与 KuaiRand 上的召回效果及计算量。
D、L、T 分别表示模型维度、Transformer 层数和 Token Mixing Block 数量。MFLOPs′ 为单候选计算量;KuaiFormer¹ 按实际打分候选数摊销用户编码成本,工业数据约 4 万个,KuaiRand 约 2.8 万个。粗体标出每列最优的 Recall。
在工业数据集上,TransRetrieval-64D-3L 的整体 Recall 达到 60.3%,较生产基线的 57.6% 提升 2.7pt;单候选计算量从 0.69 降至 0.45 MFLOPs,减少约 35%。
扩大到 128D-5L 后,工业数据集 Recall 达到 65.7%,比生产基线提升 8.1pt;KuaiRand 达到 47.3%,比基线的 37.8% 提升 9.5pt。两个数据集上的单候选计算量分别为 1.91 和 1.81 MFLOPs。
在工业数据集约 1.7–2.1 MFLOPs 的单候选预算范围内,HSTU-128D-5L、RankMixer-128D-8T 的整体 Recall 分别为 52.7% 和 45.2%,TransRetrieval-128D-5L 为 65.7%。
3.3 增加计算,能带来怎样的效果增长?
我们将 32D、64D、128D 与 1、3、5 层进行组合,观察模型扩展过程中的收益。图中每个散点对应一个配置,横轴为单候选计算量,阴影为对数线性拟合的 95% 置信区间。
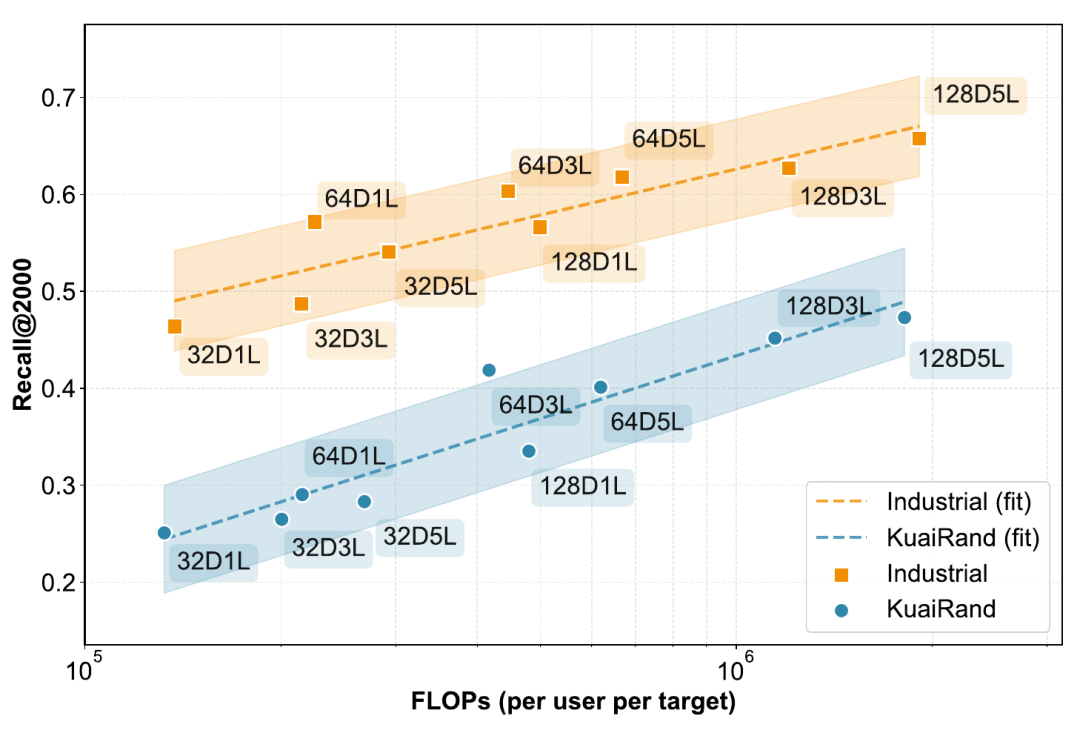
图 2. 不同模型配置下,Recall@2000 与单候选计算量的关系。
从 32D-1L 扩展到 128D-5L,工业数据集 Recall 从 46.4% 提升到 65.7%,增加 19.3pt;KuaiRand 从 25.1% 提升到 47.3%,增加 22.2pt。两个数据集的对数线性拟合 分别为 0.82 和 0.88。
在我们的对比实验中,RankMixer-768D-16T 以 151 MFLOPs 的单候选计算量取得 53.1% 的工业 Recall,TransRetrieval-128D-5L 则以 1.91 MFLOPs 达到 65.7%,Recall 高出 12.6pt。
在上述模型规模范围内,我们在两类数据上均观察到召回效果随计算预算增加总体提升的趋势,验证了通过扩展模型容量改善召回效果的技术路径。
4. 工业落地
线上召回由 HNSW 图搜索与候选打分交替推进,并通过索引更新保持广告信息的新鲜度。围绕共享用户 KV 和单 Target Token 的模型结构,我们对推理与检索系统进行了配套优化。
4.1 共享 KV 与候选批处理
推理时,我们将同一请求的 user KV-cache 无复制地广播给各候选,复用用户侧计算结果。
Target 压缩后,Attention 计算中每个候选只有一个 Query Token,难以充分利用 GPU 的并行矩阵计算能力,因此我们将多个候选合并为批量计算,并使用掩码保持候选之间的独立性。
结合上述 KV-cache 共享、候选批处理,以及 LayerNorm、残差和激活等算子融合,模型 forward 相对朴素实现获得约 11 倍加速。
4.2 图搜索与模型打分留在 GPU
模型驱动的 HNSW 搜索需要多轮交替执行邻居查询、候选打分与筛选。若 HNSW 索引驻留在 CPU 中,每轮搜索都会涉及 CPU 与 GPU 之间的 H2D、D2H 数据传输,影响计算的连续性。我们将邻居查询、距离计算和候选选择迁移到 GPU,让搜索与模型打分在同一设备内完成。
相较 CPU 检索实现,这一改造使检索时延降低 89%。进一步通过请求间推理引擎共享和静态索引数据量化降低显存占用,服务并发能力提升至原来的 3 倍。
4.3 近线更新保持广告新鲜度
Target Compressor 作为独立子图部署。全量构建索引时,它负责计算所有广告的压缩 Token 表征;后续由事件驱动的近线服务监测广告特征变化,仅重算受影响广告的表征,并异步更新在线索引。
4.4 线上收益
TransRetrieval 已在阿里妈妈展示广告系统中全量上线。在此前持续一个月、覆盖 5% 生产流量的 A/B 实验中,相比生产基线,平台收入提升 2.53%,RPM 提升 1.28%。
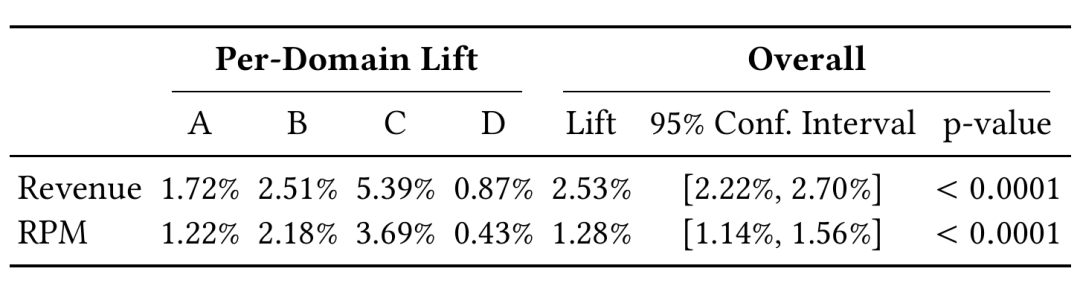
表 5. 线上 A/B 实验的分场景及整体收益。
线上实测中,TransRetrieval-128D-5L 的单请求计算量从生产基线的 27 GFLOPs 增至 95 GFLOPs。通过推理 Infra 的深度优化,在保持 40 ms 超时阈值不变的前提下,单卡极限 QPS 仅下降 23%(300 -> 230)。
5. 结语
通过 TransRetrieval,我们探索了以模型能力持续扩展驱动检索效果提升的召回技术路径。围绕异构特征、海量候选与在线计算预算,我们通过算法与 Infra 的协同设计,推动模型、检索架构和推理系统协同演进,让 Transformer 的能力增长在工业召回中转化为效果收益。
从两个数据集上的 Scaling 趋势,到已有工业基线上的线上收益,我们验证了持续扩展召回模型的价值。围绕这条路径,我们可以不断增强海量候选中的匹配与发现能力,形成可持续扩展的技术基础,为广告检索的长期创新提供支撑。
🏷️ 关于我们
我们是阿里妈妈展示广告 Match 团队,负责淘宝信息流场景的召回算法探索和广告产品的定向机制设计。结合产品设计从消费者和商家双端促成供需匹配,通过算法创新提升匹配效率,实现消费者、商家和平台的三方共赢。
团队在大规模匹配与检索、广告推荐大模型、定向产品等方向上持续深耕,结合深入的业务理解、大模型等前沿技术和贯穿全链路的架构设计和抽象,实现广告算法和广告产品的创新突破,并在 KDD、ICML、NeurIPS、CIKM 等会议上发表多篇论文。
欢迎感兴趣、热爱技术、敢于突破边界的小伙伴加入我们,一起探索下一代广告算法的更多可能。团队长期开放「广告推荐大模型」方向的研究型实习生岗位,欢迎扫码了解。
📮 简历投递邮箱:ziru.xzr@alibaba-inc.com
参考文献
[1] Rihan Chen et al. Approximate Nearest Neighbor Search under Neural Similarity Metric for Large-Scale Recommendation. CIKM 2022.
[2] Y. A. Malkov, D. A. Yashunin. Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs. IEEE TPAMI, 2020.
[3] Chongming Gao et al. KuaiRand: An Unbiased Sequential Recommendation Dataset with Randomly Exposed Videos. CIKM 2022.
[4] Bin Liu et al. Bidding-Aware Retrieval for Multi-Stage Consistency in Online Advertising. CIKM 2026;arXiv:2508.05206.
[5] Chi Liu et al. KuaiFormer: Transformer-Based Retrieval at Kuaishou. arXiv:2411.10057, 2024.
[6] Jiaqi Zhai et al. Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations. ICML 2024.
[7] Jie Zhu et al. RankMixer: Scaling Up Ranking Models in Industrial Recommenders. CIKM 2025.
也许你还想看
关注「阿里妈妈技术」,了解更多~
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢