

据 TechCrunch 10 月 30 日报道,AI 基建初创 Runware 联合创始人兼 CEO Flaviu Radulescu 称,公司计划到 2028 年把罗马尼亚工厂的模块化数据中心产能提升至每天 30 兆瓦,接近每月 1 吉瓦。产品是公司几个月前发布的 Sonic Inference Pod——在工厂制造、运抵客户现场即可安装的模块化数据中心。Radulescu 称,pod 到场后 48 小时内可上线,这只计算安装与调试时间,不含建造。
商业数字同样出自公司口径:Runware 称,开放对外销售仅一个月,已获得 10 亿美元“承诺意向”,对应超过 20 兆瓦容量。TechCrunch 在报道中提示,这些目前还都是计划;10 亿美元意向未经独立验证。
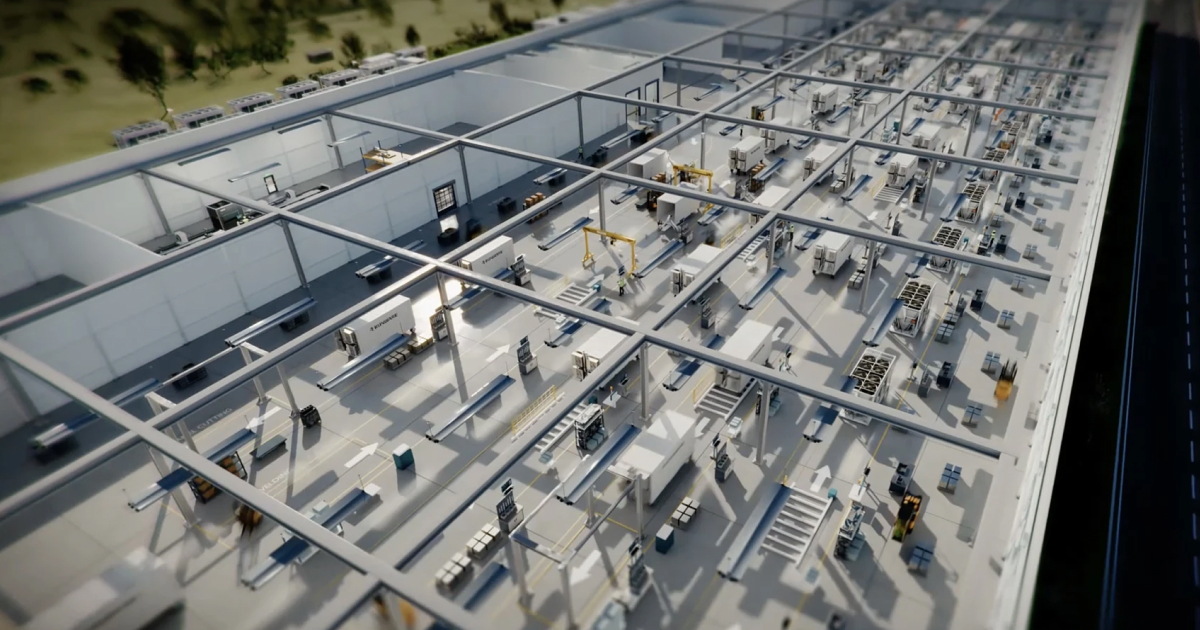
产能爬坡从明年开始:第二座工厂数月内完工、明年初上线
Radulescu 称,Runware 现有两座工厂:一座已使用数年、用于制造 pod,另一座于今年早些时候动工,预计数月内完工、明年初上线。产能将从明年起逐步爬坡,到 2028 年达到每天 30 兆瓦——TechCrunch 据此算了一笔账:按这个速度,Runware 一年生产出的容量,大致相当于全美今年预计新增的数据中心电力总量(约 10 吉瓦)。
生产方式是汽车式的装配线:模块化数据中心在产线上逐台组装,客户可以自带场地用于拼装,也可以由 Runware 代为寻找场地。这条赛道并不缺同行。TechCrunch 提到,Crusoe 和 Schneider Electric 等公司同样出售预制 pod,但 Runware 称自己出货更快;Nvidia 今年早些时候发布了 Vera Rubin AI 工厂与 DSX POD,同样瞄准缩短 AI 数据中心的建设周期。TechCrunch 写道,区别在于 Runware 称自己已经真正建成工厂,而不只是设计了让别人去建的基础设施。
pod 建造要从三周压到一天,交付后按月计费
安装之外,建造环节也在提速。按公司的说法,一座 pod 此前的建造周期是三周,随着产线爬坡,很快会压缩到一天。
交付之后的安排同样具体:组件故障由 Runware 提供备件;客户可以租用 Runware 的算力,也可以自带 GPU(图形处理器),按月支付 pod 与运维费用,电力和互联网接入单独计费。pod 采用标准设计,可按客户需求和最新 GPU 芯片配置调整。芯片下单后往往要等很久才能到货,这反而对 Runware 有利:“我们的 pod 交付时间比当前 GPU 的交货周期更短,这给了我们时间去适配所订购的硬件。针对新一代 GPU,我们的内部硬件团队可以自行设计、制造并测试部件,让我们能够快速适应。”
先给自己的推理业务造机房,再把机房变成产品
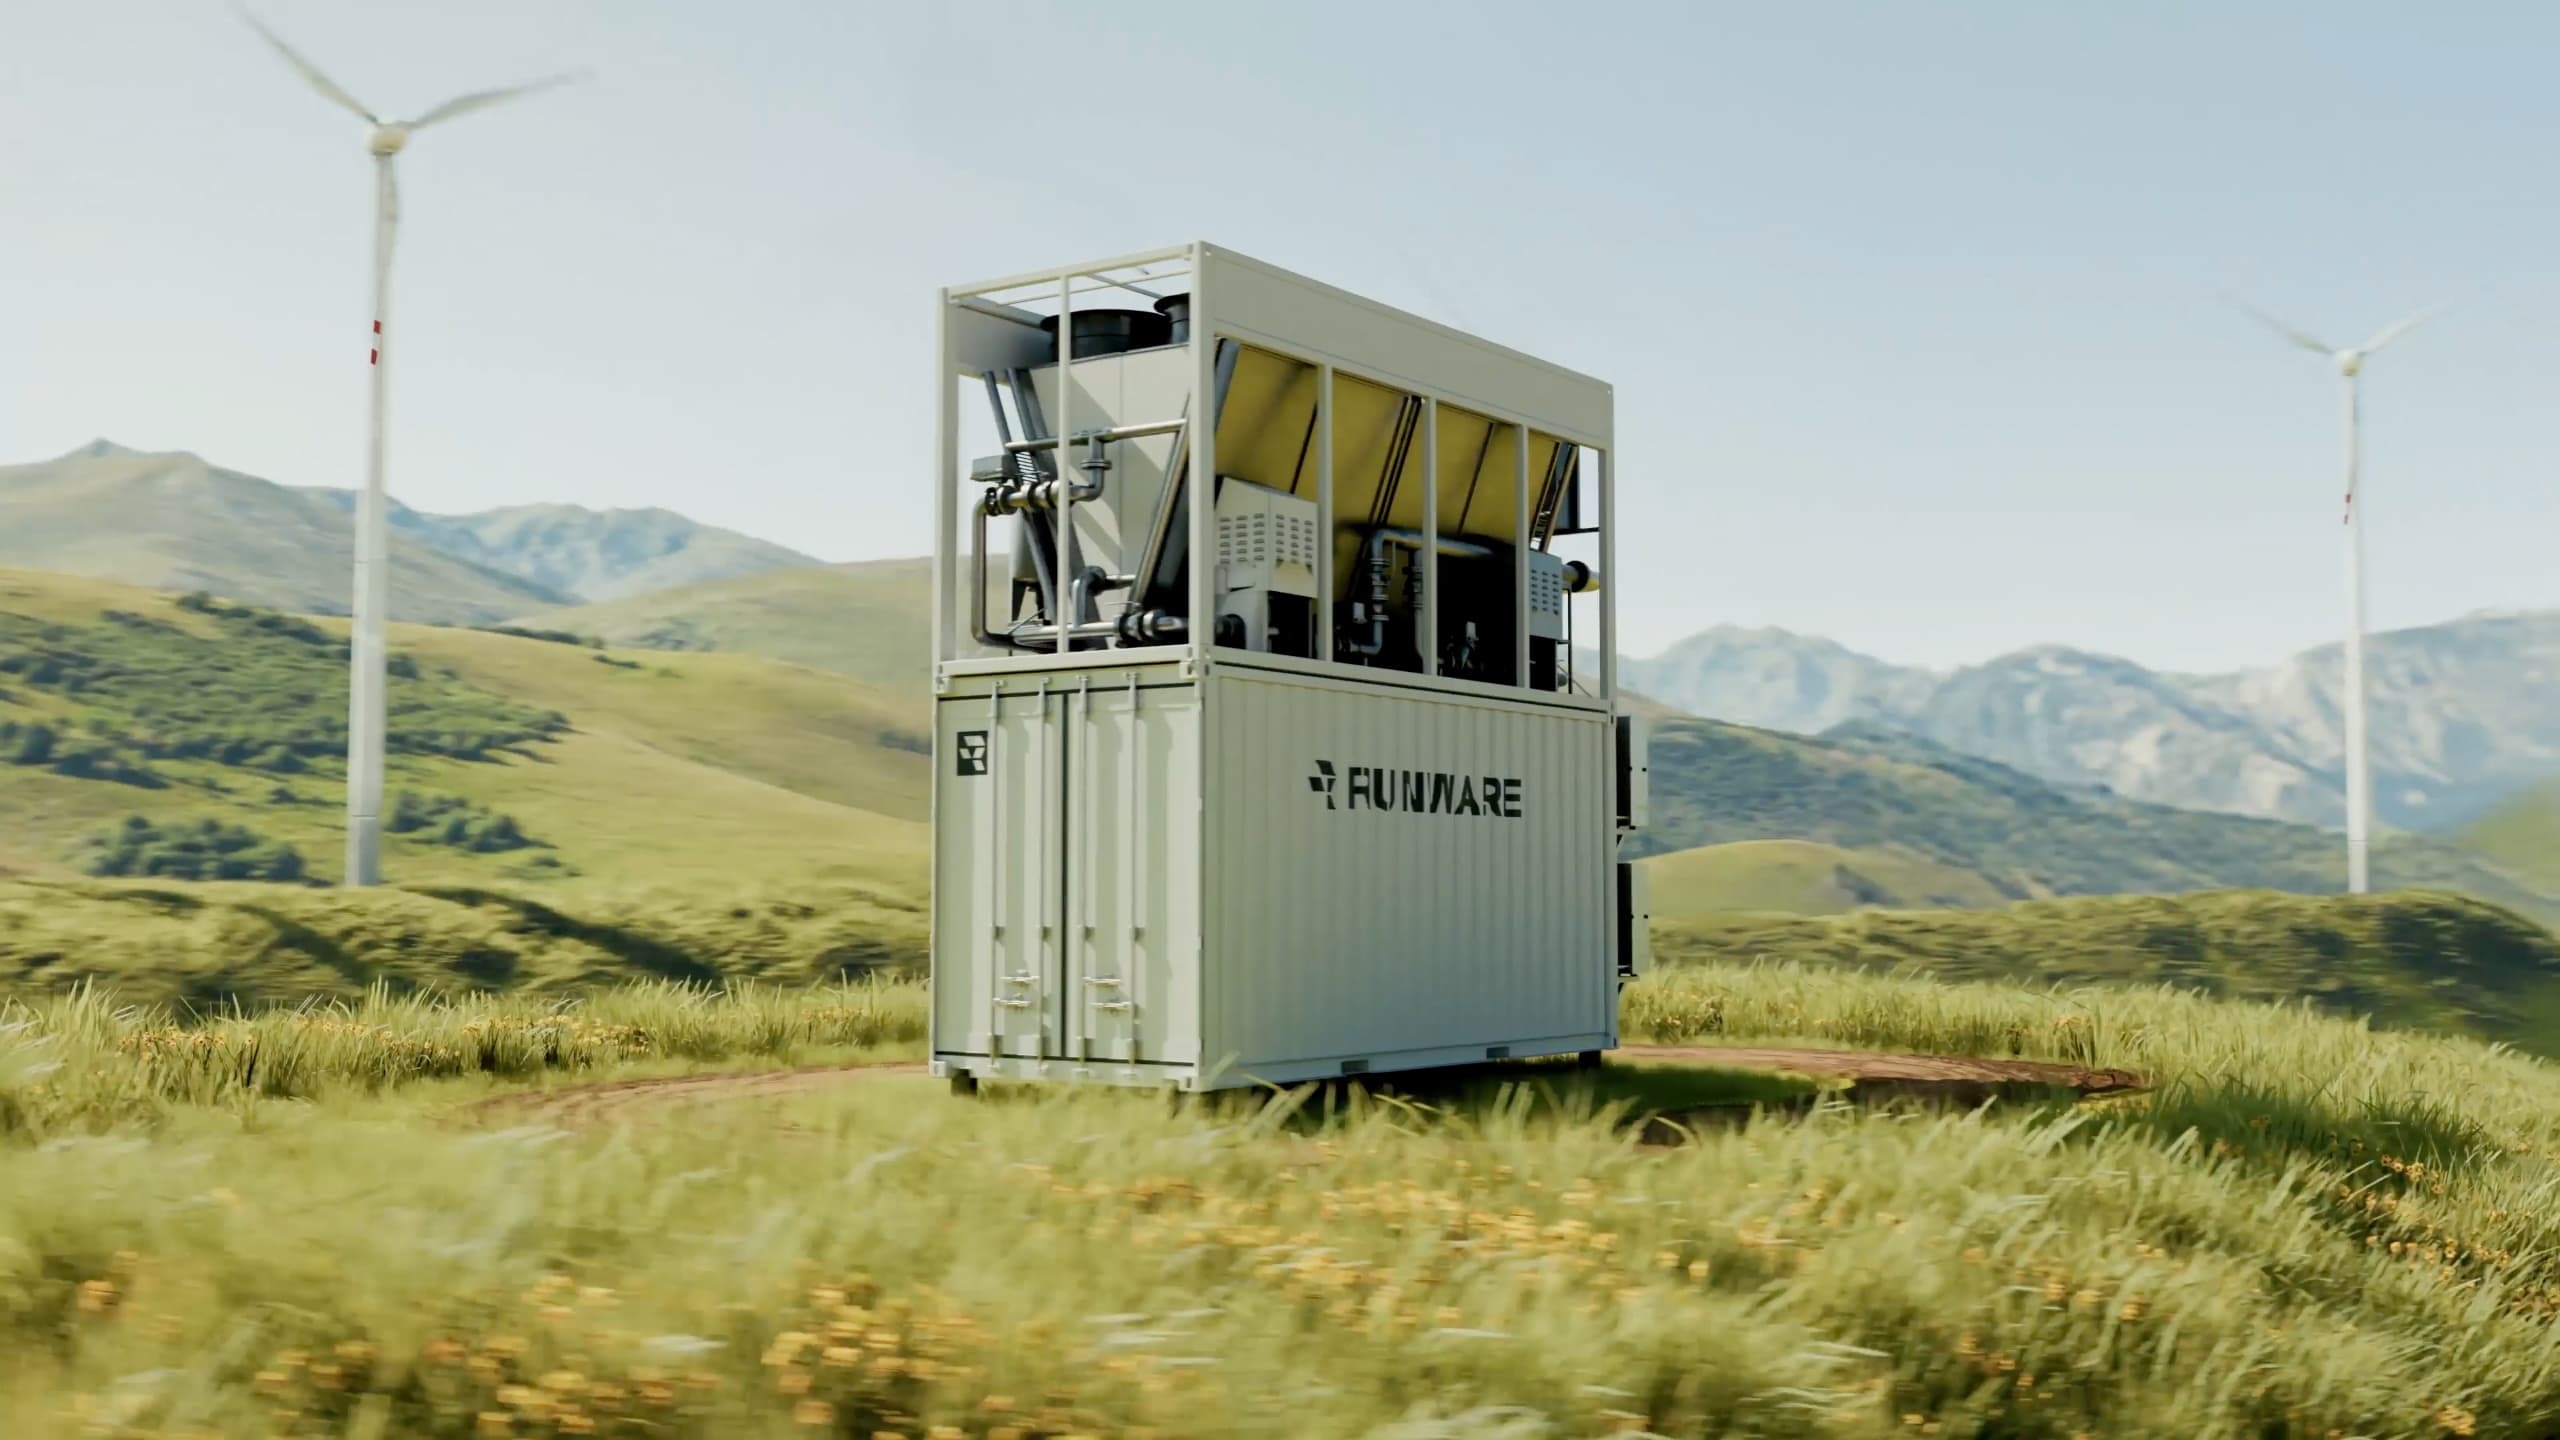
Sonic pod 的规格来自 Runware 自己的描述。公司 官方博客(8 月 4 日发布)称,一座 pod 是装进 20 英尺集装箱的 1 兆瓦 IT 算力,内含约 1,200 块 GPU,服务器不带机箱、像积木一样插进机架,安装以小时计;集装箱顶部压着一台与箱体尺寸相当的冷却机组。冷却系统为闭环液冷,循环约 1.5 立方米冷却液,不接水管、正常运行不耗水,在环境温度 50°C 下可将 GPU 温度控制在目标值 2°C 以内。公司还称,在 pod 上运行推理,每 GPU 小时的成本比其他推理供应商低 30%~80%。
这条产品线是被自己的业务逼出来的。博客回忆,公司起点是 2022 年的图片生成产品 PicFinder;由于租用 GPU 成本高、托管机房大多不接受液冷机架,两位创始人从 2023 年底开始自己设计服务器和承载它们的数据中心,2024 年 10 月 Runware 推理平台上线。据博客称,Sonic pod 现已部署在美国和欧洲,公司计划在 2026 年下半年让最多 10,000 个节点上线,瞄准 2027 年超过 1 吉瓦的推理算力,手头有 160 个已具备电力的可用站点;主力节点使用 RTX PRO 6000,也能运行 B200 和 B300,并预计成为首批规模化部署 Vera Rubin GPU 的供应商之一。博客还援引客户 Higgsfield 的战略合作副总裁 Deykhan Ten 的话称,Higgsfield 从 Runware 的模型 API 起步,随后扩展到其推理基础设施。
397 兆瓦站点管道与 B 轮筹备
“相当于超过 20 兆瓦,我们正在努力交付。”Radulescu 这样描述那 10 亿美元意向。该数字未经独立验证。资金方面,公司称迄今融资超过 6,000 万美元,其中 5,000 万美元 A 轮于 2025 年 12 月完成——时间与金额与官方博客一致;目前正用这笔 A 轮资金完成并启动新工厂,同时筹备 B 轮融资。
数据中心因能耗及对电网的影响在美国国内外受到批评。Radulescu 的回应从场地说起:公司正与电力供应商推进一条覆盖 397 兆瓦的站点管道,有潜力扩展至 1.2 吉瓦;这些场地远小于 Amazon、Microsoft 和 Google 等超大规模运营商的园区,且通常已有电力接入,因此不应进一步加重电网负担。他称 pod 只需电力和网络连接,采用闭环液冷加风冷散热器排热,无需接水,在气温 30°C(86 华氏度)以下“完全静音”;公司尽可能使用可再生能源,“目标是让可再生能源成为主要能源”。
“执行才是考验”
TechCrunch 在报道中写道:“就目前而言,这些全是计划——执行才是考验。”按其梳理,工厂需要大量人手、库存、供应链物流和资金。报道举出的警示案例是电动车初创 Arrival:它一度估值超过 130 亿美元,2024 年 2 月进入破产管理,却难以像传统工厂那样低成本地量产电动车。
Radulescu 的回应是成本结构不同:“我们确实有人力和材料成本,但相对于部署 AI 算力的价值,我们的工厂人力是划算的。”他补充说,自行设计系统、采购市场上便宜易得的通用部件,有助于控制成本;公司已从汽车行业请来一位经验丰富的厂长,与硬件负责人一起把执行做到位。公司博客里还有一笔对应的账:博客引用 OpenAI 首席财务官 Sarah Friar 的估计称,吉瓦级 AI 数据中心仅设施本身造价约 150 亿美元;按 Runware 的说法,其 pod 在设施与部署层面的成本约为每吉瓦 1.5 亿美元,两种口径均不含 GPU 硬件。
供应链是绕不开的短板。尽管 Runware 称冷却等 pod 系统均为自行设计、采用标准部件,但泵和风扇等部分部件来自德国,网络设备仍依赖 Nvidia。
写了日期的节点,和没写日期的订单
在 Radulescu 看来,模块化系统很快会成为“大型 AI 部署的标准”。“客户应该能够从一开始就围绕工厂制造的 pod 规划一座超大规模数据中心,并在几个月而不是几年内让它投入使用。”
时间表上写了日期的有两处:公司称今年年底前让最多 10,000 个节点上线;第二座工厂明年初投运,随后扩张到美国和全球其他地区。没写日期的那一项是订单——10 亿美元意向何时变成真正交付的容量,报道里没有给出时间。
参考链接
- Can AI data centers be mass-produced like cars? This startup aims to find out — TechCrunch, 2026-10-30
- Introducing Sonic Pods: Modular data centers built for inference — Runware Blog, 2026-08-04
- UK electric vehicle maker Arrival enters administration — The Guardian, 2024-02-05
本文由 AREX Agent 基于公开网络信源自动整合梳理。
AI 可能存在信息遗漏、时序偏差或事实误判。文中观点与事实请结合文末原始链接交叉核验,请勿直接作为决策依据。
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢