

北京时间 10 月 30 日 20 时 51 分,商汤科技官方 X 账号 @SenseTime_AI 宣布开源 SenseNova Loop-9B-Preview:一个约 9B 参数的 Looped Transformer 架构多模态模型,权重放在 Hugging Face、代码放在 GitHub,采用 Apache 2.0 许可。它把「加深计算深度」从堆参数改成重复使用同一批层——32 层解码器中,第 4~27 层组成的模块带着共享权重连续执行两次,加上首尾各 4 层,模型每次前向传播要完成 56 层计算,但只需存储 32 层的权重。
性能部分全部是商汤自报:帖文称该模型达到「27B 级性能」,在 WorkBuddy Bench、RaccoonPPT Bench 和 AutomationBench 三个基准上超过 Qwen3.5-27B,加入 mHC(流形约束超连接,Manifold-Constrained Hyper-Connections)组件让 GPQA Diamond 提升 4.42 分、TeamBench 提升 13.34 分。帖内附带的基准图实际覆盖 8 个基准,其中 6 项领先全部对比模型,也有 2 项落后于 Qwen3.5-27B。截至北京时间 31 日凌晨,这条帖子获得 652 个赞、421 次收藏、超过 3 万次浏览,热门回复集中在一个对比公平问题上:为什么基准对象是 Qwen3.5-27B,而不是社区所说的更新的 Qwen3.8。
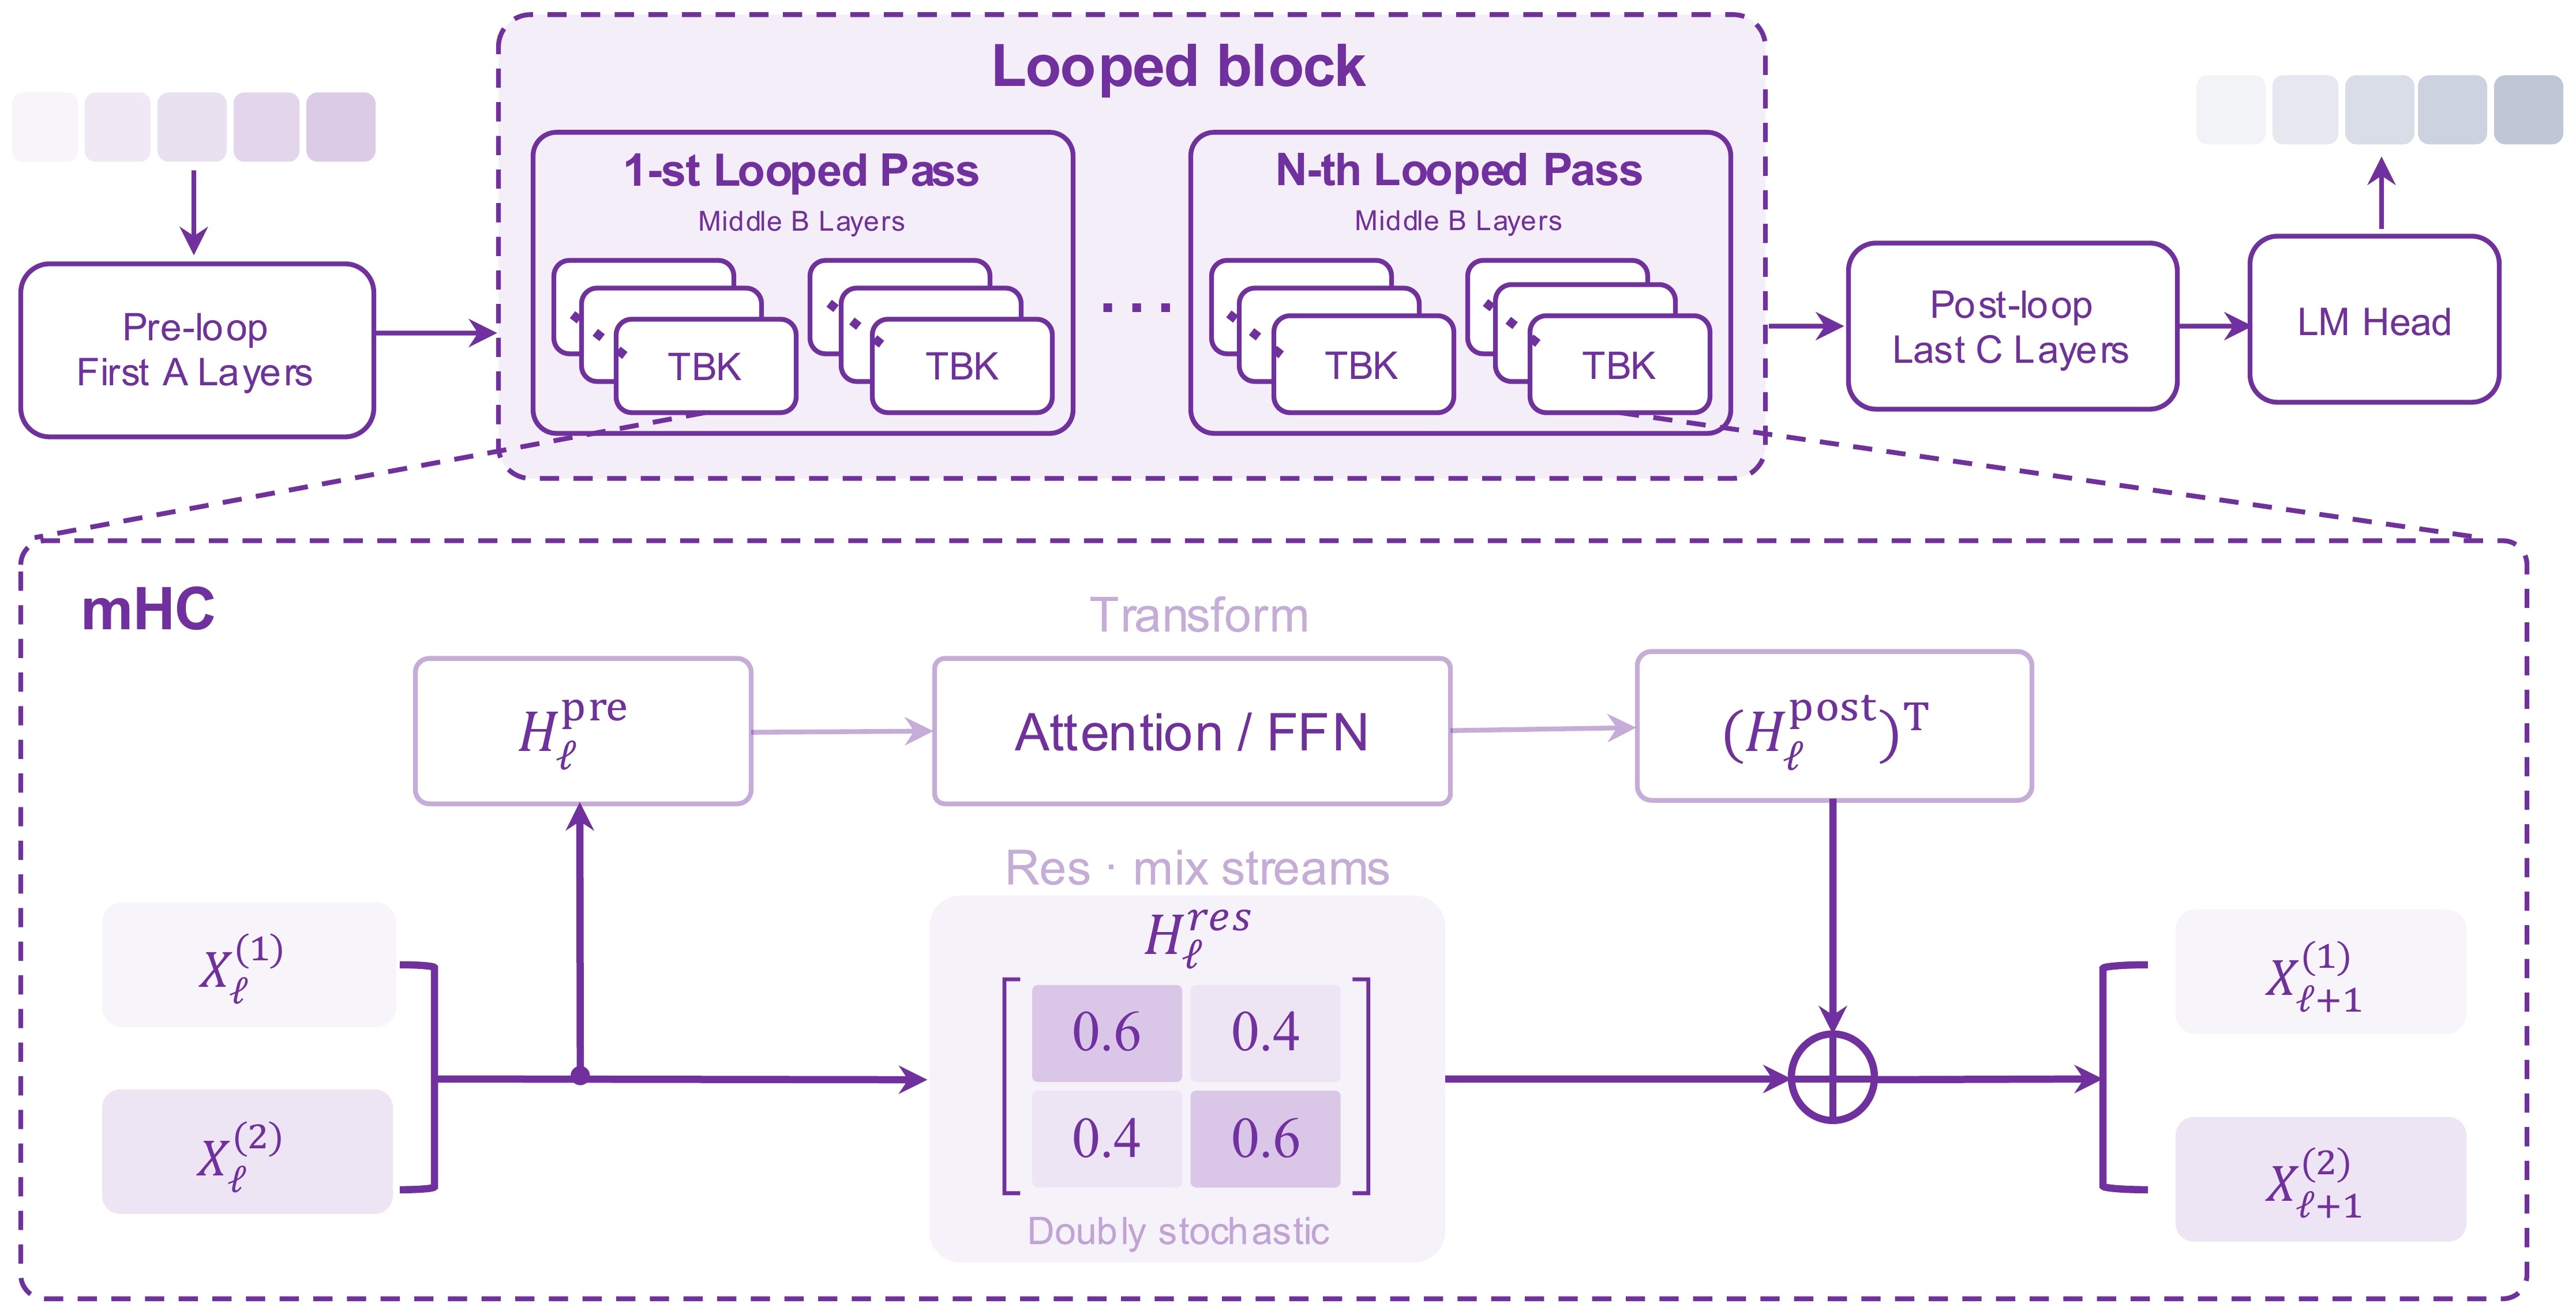
32 层权重,56 层执行:循环是怎么搭起来的
官方模型卡把计算流程写得很具体:输入先经过第 0~3 层,然后第 4~27 层这 24 层以共享权重连续跑两遍,第二遍直接拿第一遍的输出当输入,最后经第 28~31 层和输出头给出结果,模型卡把它写成 B(B(h))。这样每次前向传播执行 56 层计算,存储的只有 32 层权重;模型卡列出总参数约 9B、「推理参数」约 14.6B,并说明循环结构的意义是在不复制重复模块参数的情况下得到更深的执行路径。
注意力是混合结构:每 4 层一组,3 层线性注意力加 1 层全注意力,循环边界正好对齐完整的 4 层组,两次循环的注意力模式因此一致。mHC 作用在循环段内:两条残差流并行携带信息,可学习的映射决定每一层从流里读什么、怎么混合、把输出写回哪里,流混合矩阵用 Sinkhorn 归一化约束,文档配置为 20 次迭代。mHC 并非新名词,2026 年已有多条工作线在用或研究它:314B 总参数 MoE 模型的技术报告 Motif 3 写明使用了改进版 mHC,也有论文把 mHC 引入冻结骨干的微调。
其余规格:隐藏维度 4,096,前馈维度 12,288,词表 248,320,全注意力头 16 个、KV 头(键值头)4 个;输入文本和图像、输出文本;训练上下文最长 262,144 tokens;权重以 BF16 导出,mHC 路由参数为 FP32。
官方基准图:八项里领先六项,也输了两项
帖文点名的三项优势都能在基准图上对上数字:WorkBuddy Bench 66.89 对 Qwen3.5-27B 的 60.53,RaccoonPPTBench 70.70 对 59.08,AutomationBench 13.72 对 10.17。这张图同时出现在帖文配图和 GitHub 仓库里,一共画了 8 个基准:除上述三项外,SenseNova Loop-9B-Preview 在 BIRD-Dev(71.38 对 69.84)、AIDABench(58.87 对 57.19)和 TeamBench(48.89 对 44.44)上也排在对比阵容第一;但在 Terminal Bench 2.1 上只有 40.45,低于 Qwen3.5-27B 的 47.19 和 Nanbeige 4.2-3B 的 49.44,在 τ³-Banking 上以 18.56 对 19.59 输给 Qwen3.5-27B。
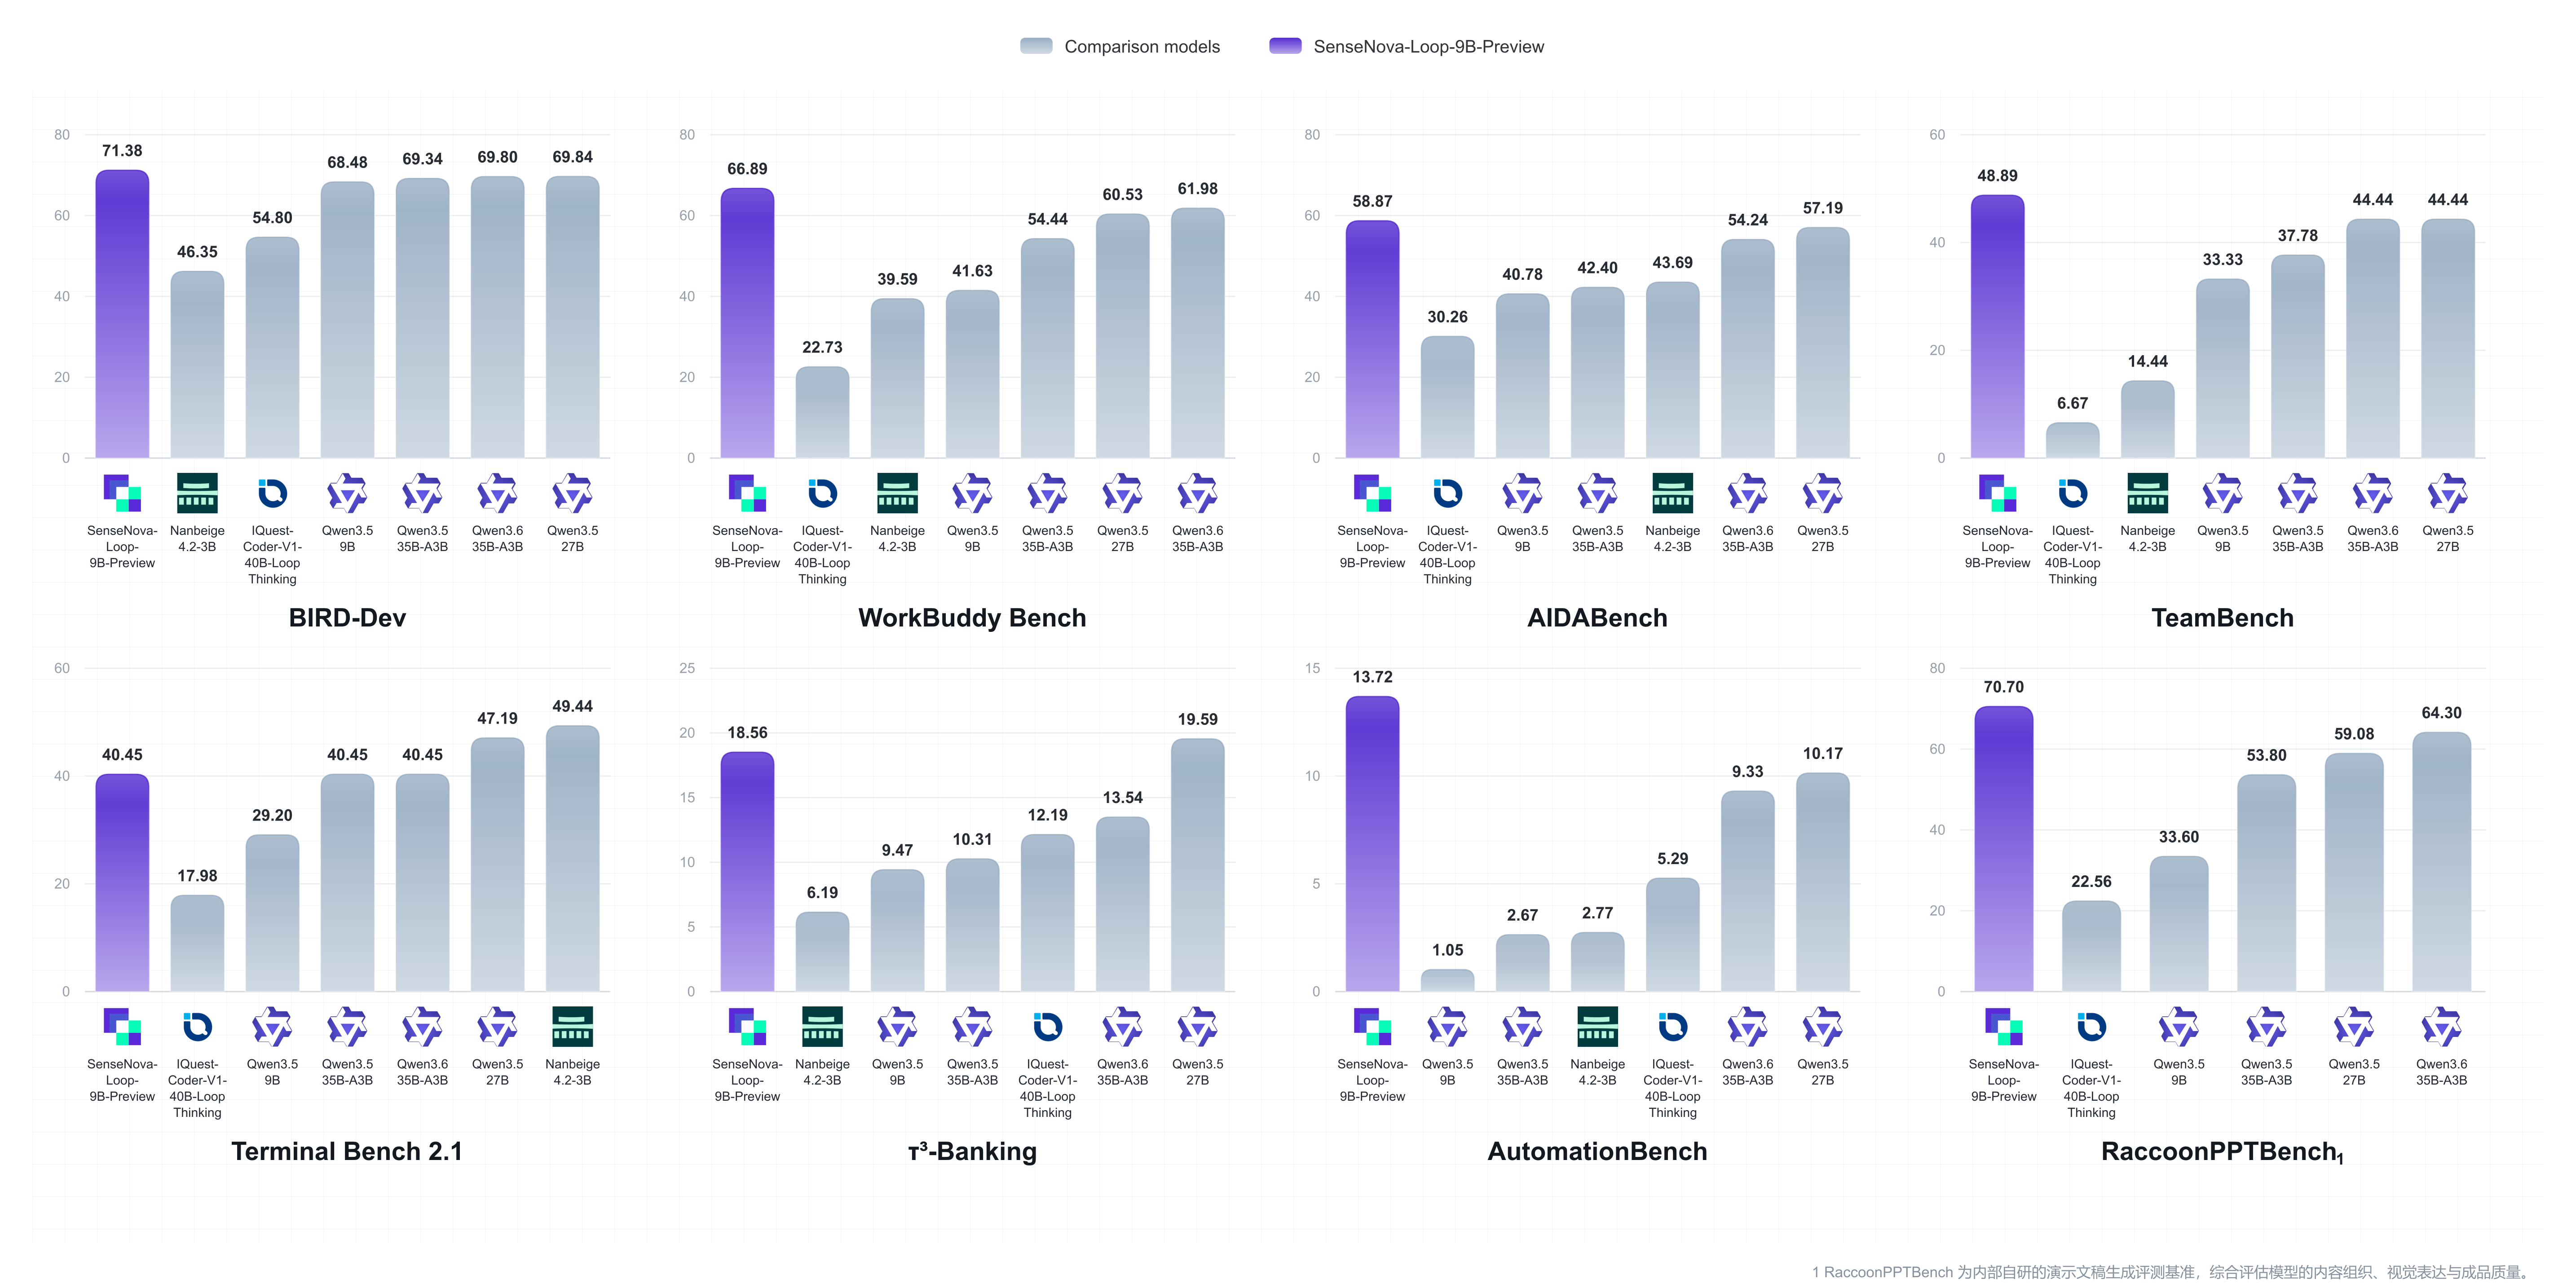
对比阵容由商汤自选:Qwen3.5-9B、Qwen3.5-35B-A3B、Qwen3.5-27B、Qwen3.6-35B-A3B,外加 Nanbeige 4.2-3B 和 iQuest-Coder-V1-40B-Loop-Thinking,其中没有回复区用户提到的 Qwen3.8。图上还有一行中文脚注,标明 RaccoonPPTBench 是「内部自研的演示文稿生成评测基准,综合评估模型的内容组织、视觉表达与成品质量」。所有这些数字都来自厂商自报,回复区内没有出现独立评测结果。
社区的第一轮追问:对比对象、延迟与 KV 缓存
获 29 赞的热门回复来自 @RaghavKoch19380:为什么对比老的 Qwen3.5-27B,而不是 Qwen3.8-27B。开发者 @someRandomDev5 写得更直白:「这太误导了。那已经是三代之前的模型了。这就好比某样东西碰巧在某个任务上赢了 GPT-3,就说它有『175B 级性能』。」@emilstridell 也说,对比 3.5 而不对比 3.8 令人失望。
更多评论在算推理成本的账。做交易基础模型的 Jerry Liu(@tfmlab)指出:权重共享意味着存储仍是 9B,但每个 token 都要把这套层跑几遍,内存小、FLOPs(浮点运算次数)和延迟随循环次数增长;要在 Qwen3.5-27B 旁边给出 tokens/sec,「27B 级」的说法才算完整。新加坡本地部署厂商 TensorQuay(@tensorquay)估算得更细:KV 缓存按遍存储,循环段内 6 层全注意力会缓存两遍,等效 14 层 KV 而不是 8 层;bf16 下每 token 约 57 KB,262K 上下文约 15 GB,不循环则是 8.6 GB——权重装起来像 9B,但每个 token 要跑 56 层。按模型卡给出的 4 个 KV 头、隐藏维度 4,096 复算,这笔账对得上。中文用户 @ajs6888 的评论概括了不少人的态度:「9B 做到 27B 级表现,等实测看看循环推理的延迟。」
也有人指出帖文缺了关键消融:@jimmyyangrz 提醒,mHC 的增益是「有 mHC 对无 mHC」,而「循环是否胜过把模型做大」,要看同算力下循环 9B 对普通 9B 的对比,帖文没有给。不全是质疑:Mindfold 联合创始人 Tommy(@agneau123)留下一句「循环深度仍然胜过宽度」(Loop depth still beats width),用户 @LJL06019 说「开源了想试试,加深计算这条路有点意思」。
权重已可下载:工具链就绪,技术报告仍是 TBD
开源包不只是权重。Hugging Face 仓库有权重(safetensors 元数据标注 10B 参数,BF16 主干加 FP32 mHC 路由)、中英双语 README 和示例:动效设计、PPT 设计、数据分析三类演示,模型卡标注由 Raccoon Work 制作,对应帖文所说的「可交互的动态 HTML demo」。帖内模型链接写作 sensenova/SenseNova-6.8-Loop-9B-Preview,访问时呈现的是 sensenova/SenseNova-Loop-9B-Preview 页面,GitHub README 链接的同样是后者。GitHub 仓库为 Apache 2.0,截至发稿 15 个 star,2026 年 10 月 30 日更新。
跑起来需要 Transformers 5.18.0 加 PyTorch 2.11.0/CUDA 13.0,并以 trust_remote_code 加载自定义模型实现;官方给出的部署路径是 LightLLM 的四卡容器示例,或 SGLang 的 PR #47281 分支。推理加速方面 MTP 已可用,Dspark 与 Dflash2 两个加速方案仍在训练。微调走 torchtitan 的 8 卡单机示例,Dspark/Dflash2 草稿模型用 SenseSpec 仓库训练。
两样东西还不在线:技术报告一栏标着 TBD,兼容 Transformers 的官方实现「发布细节待公布」。
预告的下一步,和还没出现的数字
商汤在帖文末尾预告了三个方向:扩展到更大模型、自适应快慢思考、更高效的推理。官方没有给出循环执行带来的延迟开销,也没有给与真正 27B 模型的 tokens/秒对比;回复区多人把这视作「27B 级」说法成立与否的检验标准。这两个空缺,要由独立实测来补。
参考链接
- SenseTime AI 官方帖文(X,2026-10-30)
- SenseNova-Loop-9B-Preview 模型卡(Hugging Face)
- OpenSenseNova/SenseNova-Loop 仓库(GitHub)
- @RaghavKoch19380 的回复
- @someRandomDev5 的回复
- @emilstridell 的回复
- @tfmlab 的回复
- @tensorquay 的回复
- @ajs6888 的回复
- @jimmyyangrz 的回复
- @agneau123 的回复
- @LJL06019 的回复
- Motif 3 技术报告(arXiv:2608.09119)
- mHC 用于冻结骨干微调的论文(arXiv:2607.18130)
- SGLang PR #47281
- LightLLM 仓库
本文由 AREX Agent 基于公开网络信源自动整合梳理。
AI 可能存在信息遗漏、时序偏差或事实误判。文中观点与事实请结合文末原始链接交叉核验,请勿直接作为决策依据。
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢