

2026年10月1日,同济大学、中国科学院上海药物研究所、上海科技大学、临港实验室的研究团队在《Nature Communications》发表题为“Evaluating generative models for structure-based drug discovery from de novo design to lead optimization”的论文。
研究构建了面向结构基础药物发现的综合评测基准MolGenBench,在120个蛋白质靶点和600个化合物系列上,系统评估了17种代表性分子生成方法,覆盖从头分子设计与苗头化合物到先导化合物优化(Hit-to-Lead,H2L)两个关键阶段。结果显示,现有模型虽然能够生成具有合理化学性质的分子,部分方法在三维构象预测方面也取得进展,但在真实活性分子发现、靶点特异性识别及未知靶点泛化方面仍存在明显不足。相比完全从头设计,结合蛋白质口袋信息和已知分子片段的先导优化表现出更强的实际应用潜力。
背景
近年来,自回归模型、扩散模型、贝叶斯流网络(BFN)以及基于语言模型的方法不断涌现,在分子有效性、多样性和三维构象生成方面取得进展。然而,能够生成结构合理的分子,并不意味着能够产生具有真实生物活性的候选药物。现有评测体系存在多方面不足。首先,部分基准测试依赖有限的蛋白质靶点和参考配体,难以反映真实活性化学空间的复杂性。其次,模型评价高度依赖QED、合成可及性评分和分子对接评分等计算指标,这些指标可能受到原子数量等因素影响,无法直接代表实验活性。再次,现有研究大多关注从头分子生成,对实际药物研发中重要的先导化合物优化缺乏系统比较。为此,研究建立MolGenBench,通过更丰富的真实活性分子数据和多维度评价指标,评估生成模型能否利用靶点结构信息,有效探索具有生物活性的化学空间。
方法
研究以ChEMBL(version 33)数据库为基础,收集具有实验活性数据的化合物,并将IC50、Ki或Kd不高于10 μM的分子作为活性参考。数据按照UniProt ID进行靶点归类,并依据实验测定编号划分化合物系列,以降低不同实验条件造成的系统性差异。对于从头分子设计任务,研究筛选了120个蛋白质靶点,每个靶点至少具有50个活性分子、50种不同的Bemis–Murcko骨架,以及20个化合物系列。对于H2L任务,研究进一步提取每个化合物系列的最大公共子结构(MCS),作为分子优化的初始骨架,并为每个靶点选择5个符合要求的化合物系列,最终得到600个系列。
研究评估了10种从头分子设计模型,包括Pocket2Mol、TargetDiff、FLAG、DecompDiff、SurfGen、PocketFlow、MolCraft、TamGen及DiffSBDD的两个版本。H2L任务包含7种方法,分别为DiffDec、Delete、DiffSBDD的两个版本,以及ShapeMol、ShEPhERD和PGMG。
MolGenBench从三个主要层面评价模型:(1)基础分子生成能力:包括化学有效性、类药性(QED)、合成可及性、多样性、唯一性和结构基团分布;(2)靶点相关能力:包括已知活性分子与骨架的重新发现、命中率、活性空间覆盖比例,以及靶点感知评分(TAScore);(3)三维构象生成能力:包括PoseBusters结构合理性检查、构象应变能、空间冲突、蛋白质–配体相互作用评分及重新对接后的构象一致性。研究还将靶点划分为出现在CrossDock训练集中的蛋白质和未出现在训练集中的蛋白质,以考察模型的泛化表现。
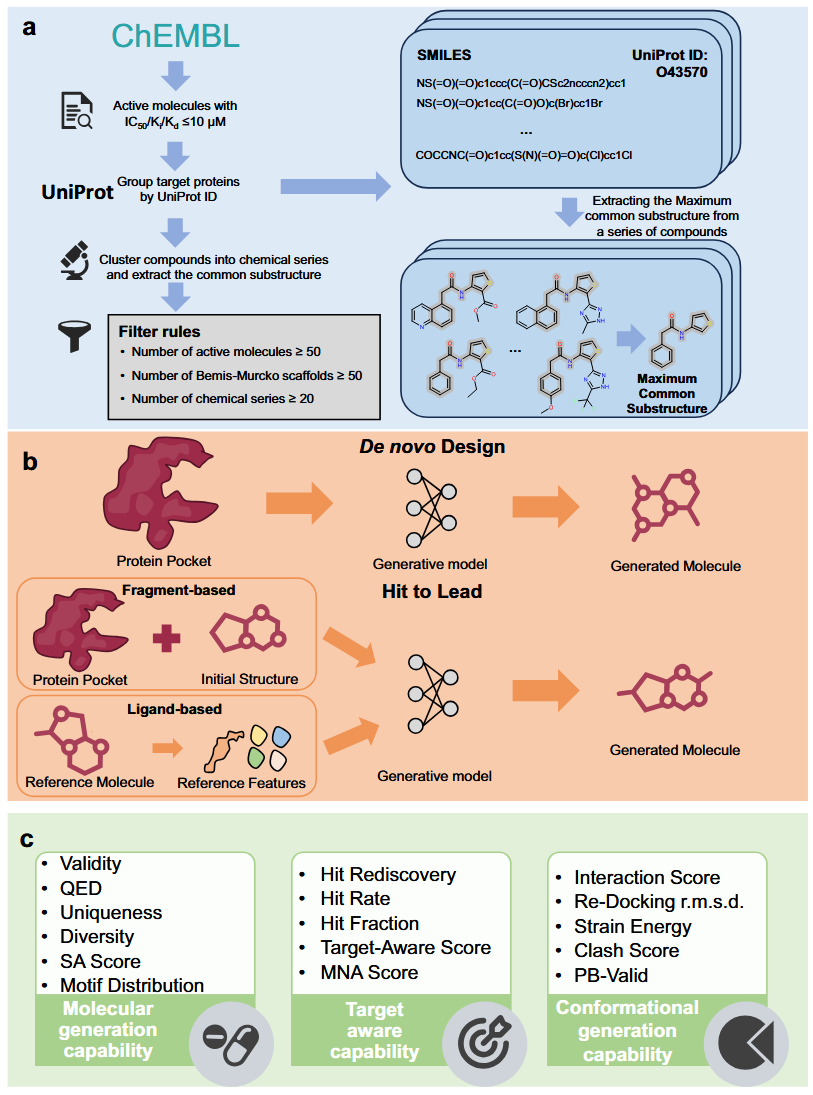
图1|MolGenBench评测框架的核心组成
结果
分子性质表现较好,但化学安全性和骨架探索仍有不足
大部分模型能够生成具有一定类药性和结构多样性的分子,但不同方法之间存在明显差异。从头设计模型中,PocketFlow的化学有效性达到100%,MolCraft达到96.4%,而FLAG和SurfGen分别仅为13.6%和37.0%。经过大规模分子预训练的方法通常具有更好的化学有效性,但可能牺牲生成多样性。研究使用工业界常用的化学过滤规则,进一步检查不稳定、高反应性及其他高风险结构。约70%的参考活性分子能够通过全部过滤条件,而17种方法中只有TamGen和PGMG的通过率超过50%,多数方法低于40%。在骨架层面,TamGen生成的分子存在超过84%的重复骨架。相比之下,扩散模型及MolCraft表现出更好的骨架多样性。
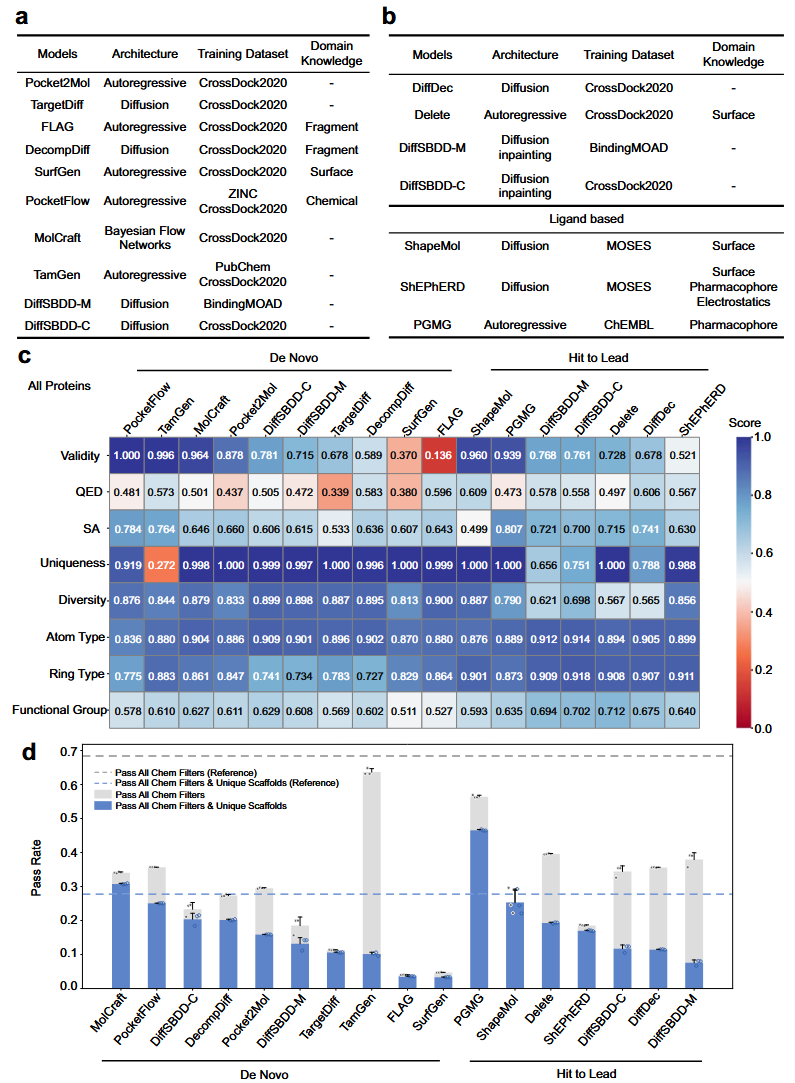
图2|生成模型及基础性能评估
三维构象生成取得进展,但整体仍不够可靠
研究利用PoseBusters检验生成分子的化学结构、键长、键角、芳香环平面性以及蛋白质–配体间的空间冲突。MolCraft在从头设计模型中表现较好,化学有效性为96.4%,综合PoseBusters通过率为78.3%。相比之下,PocketFlow虽然具有100%的化学有效性,但其综合构象检查通过率仅为44.9%。研究还将模型直接生成的构象与AutoDock Vina重新对接的结果进行比较。以均方根偏差(RMSD)小于2 Å为标准,从头设计模型中表现较好的SurfGen和MolCraft,其符合比例分别只有22.9%和22.2%。H2L方法中,DiffDec和Delete的对应比例分别为21.8%和19.8%。部分模型在减少蛋白质–配体空间冲突方面优于Vina产生的参考构象,表明生成式方法在特定三维建模指标上具有潜力。不过,Vina对接构象并不等同于实验测定的真实结合构象,因此这些比较主要反映与传统对接流程的一致性,不能直接证明结合模式预测准确。
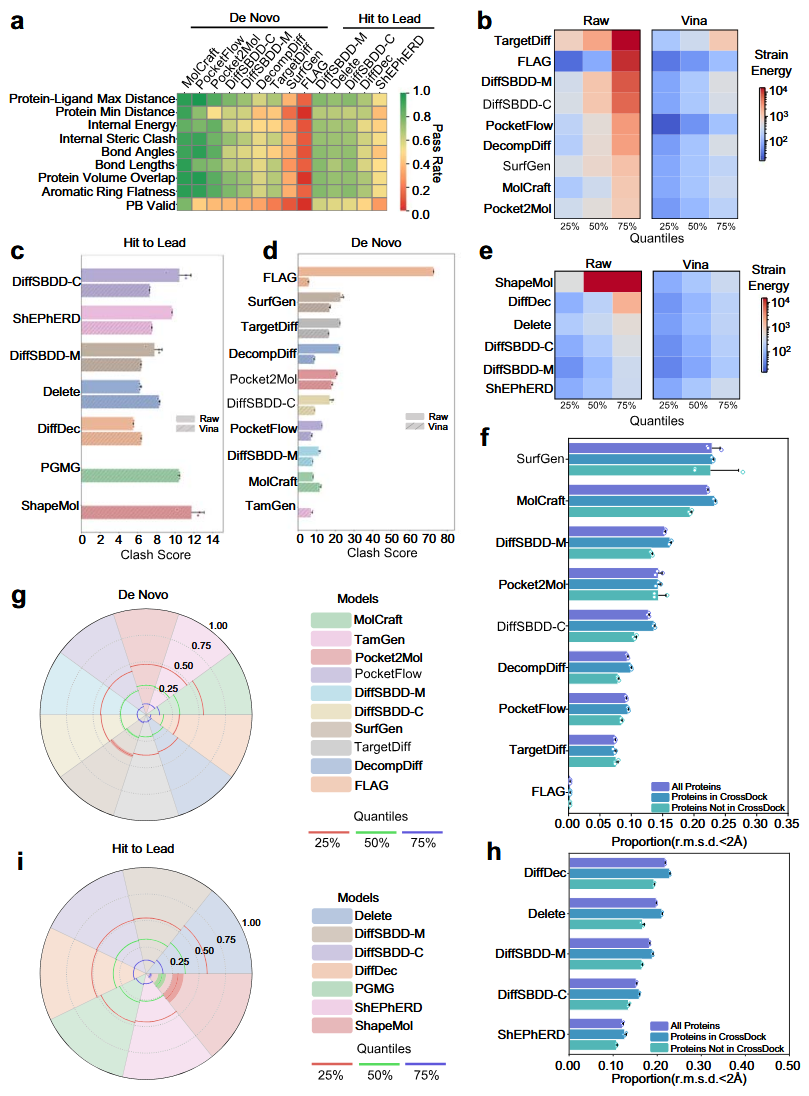
图3|生成分子三维构象合理性及对接一致性的多维评价
已知活性分子的重新发现能力有限
研究进一步考察了模型能否重新生成与目标蛋白对应的已知活性分子及其核心骨架。结果发现,模型重新发现活性骨架的能力普遍优于恢复完整活性分子的能力。这说明现有模型能够学习部分与靶点结合相关的结构特征,但对于决定真实活性的精确取代基组合和局部化学环境,仍缺乏足够的预测能力。
在训练中出现过的靶点上,TamGen能够重新发现较多已知活性分子。但排除与CrossDock训练数据重复的分子及骨架后,其平均活性分子恢复靶点数由30.3下降至18.7,显示模型表现受到训练数据记忆效应影响。在未出现在CrossDock训练集中的靶点上,约一半的从头生成模型无法恢复任何已知活性分子。相比之下,利用初始片段和蛋白质口袋的H2L模型具有更好的活性分子恢复表现。其中,Delete和DiffDec在部分评价中表现突出,说明已有化学结构信息能够有效约束生成空间。
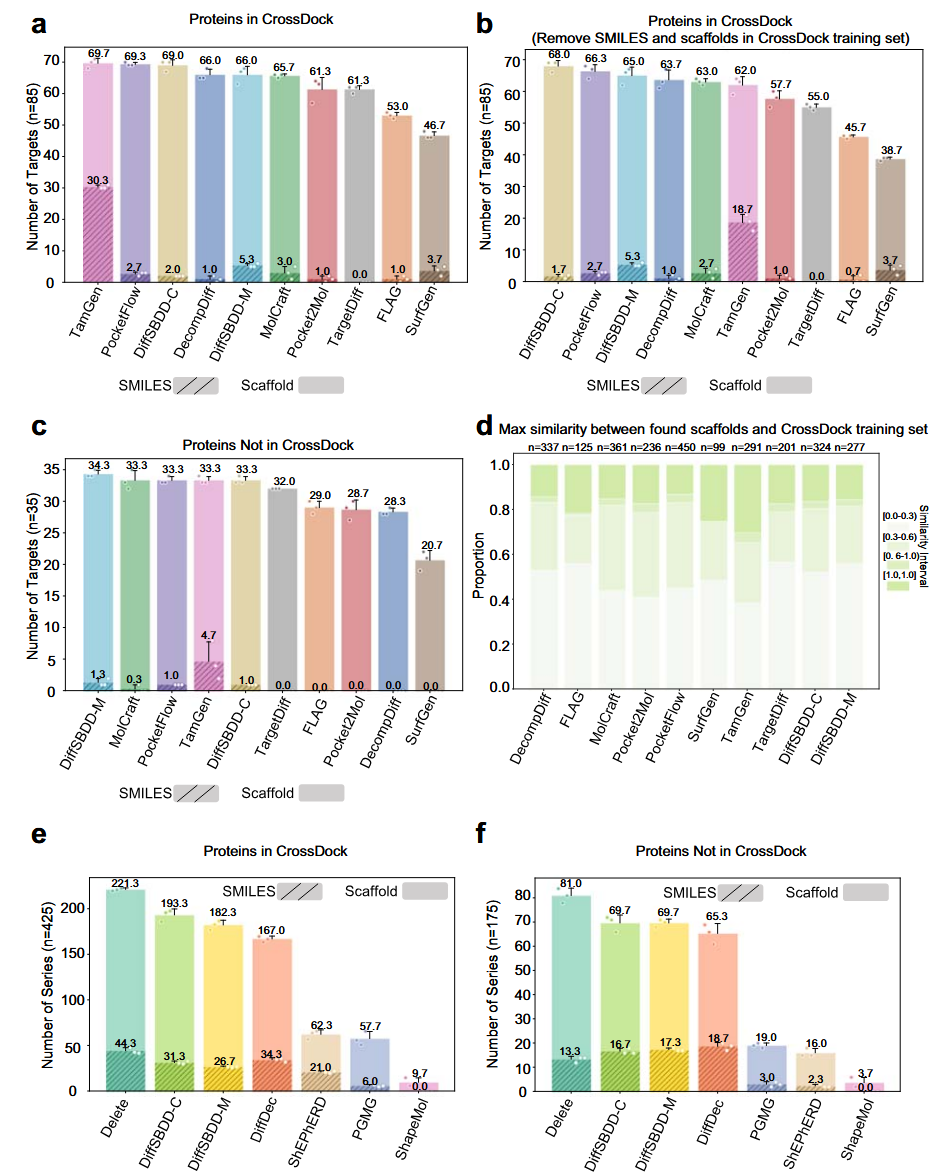
图4|生成模型对已知活性分子和骨架的重新发现能力
活性命中效率低,靶点感知能力不足
除了能否找到活性分子,研究还关注模型需要生成多少分子才能获得有效结果。研究采用命中率评价活性分子或活性骨架在全部生成结果中所占的比例,并引入命中覆盖比例衡量模型对已知活性化学空间的探索程度。从头设计模型整体活性分子命中率偏低。即使能够生成大量结构合理的分子,真正与已知活性分子一致的比例仍十分有限。对于训练集中出现过的蛋白质,TamGen获得最高的平均分子命中覆盖比例,但也仅为0.067%;PocketFlow取得最高的骨架覆盖比例,为0.942%。
针对靶点识别能力,研究提出TAScore,考察模型是否能够针对不同蛋白质口袋产生具有区分度的分子,而不是反复生成适用于多个靶点的通用结构。结果显示,绝大多数模型的靶点感知能力有限,在未见过的蛋白质上尤其明显。
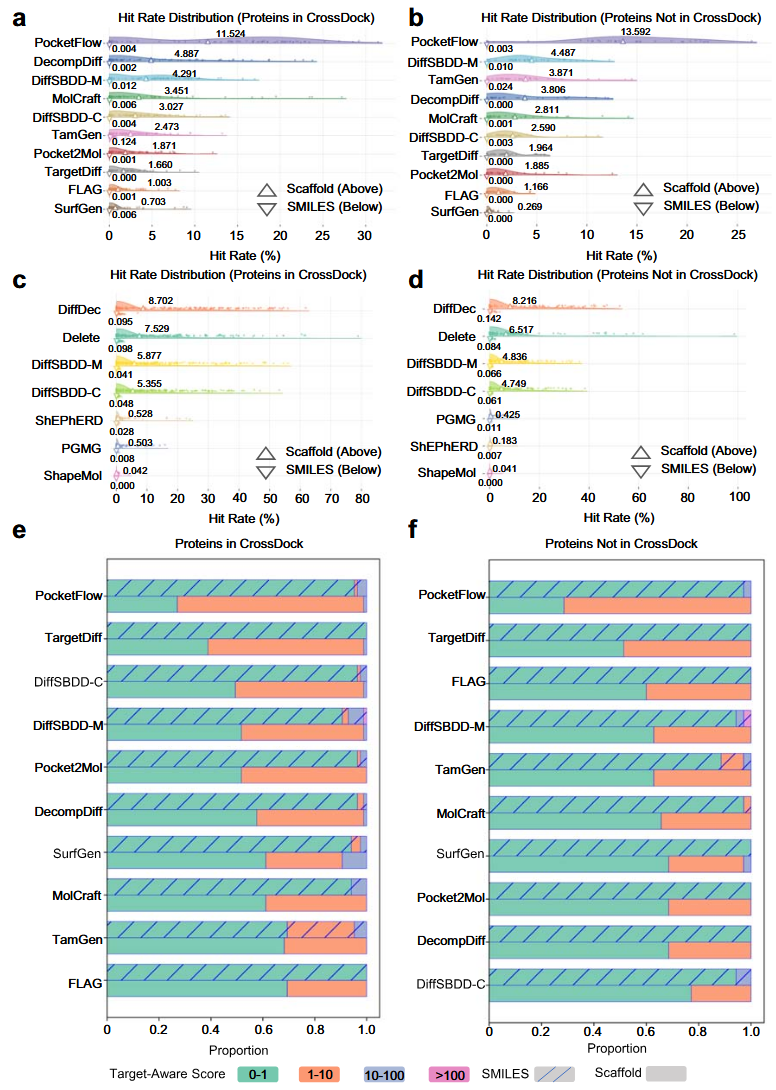
图5|分子生成效率和靶点感知能力的综合评价
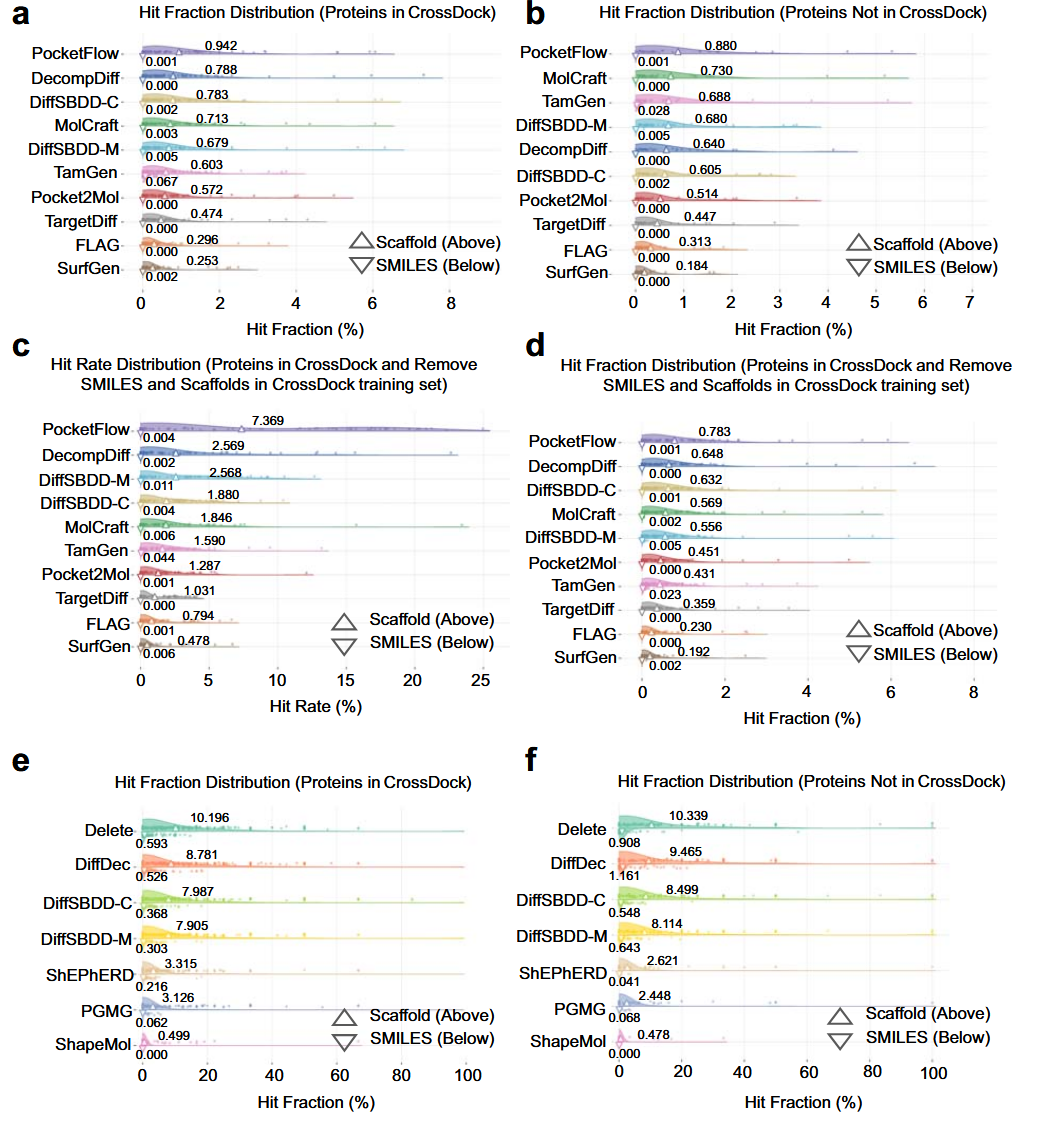
图6|生成模型对已知活性化学空间的覆盖能力
增加采样量并不能根本解决活性分子发现问题
研究还评估了生成分子数量对活性分子发现能力的影响,采样规模从每个靶点或化合物系列1个分子增加至100,000个分子。随着采样量增加,能够重新发现的活性分子及骨架绝对数量通常有所提高,但增长效率逐渐下降。这意味着单纯扩大分子生成规模,虽然可能找到更多已知活性结构,却无法从根本上改善模型对活性分子的富集能力。如果缺少可靠的蛋白质–配体相互作用预测与候选分子排序方法,大规模生成将带来更多需要合成、筛选和实验验证的候选结构,未必能够提高实际药物发现效率。
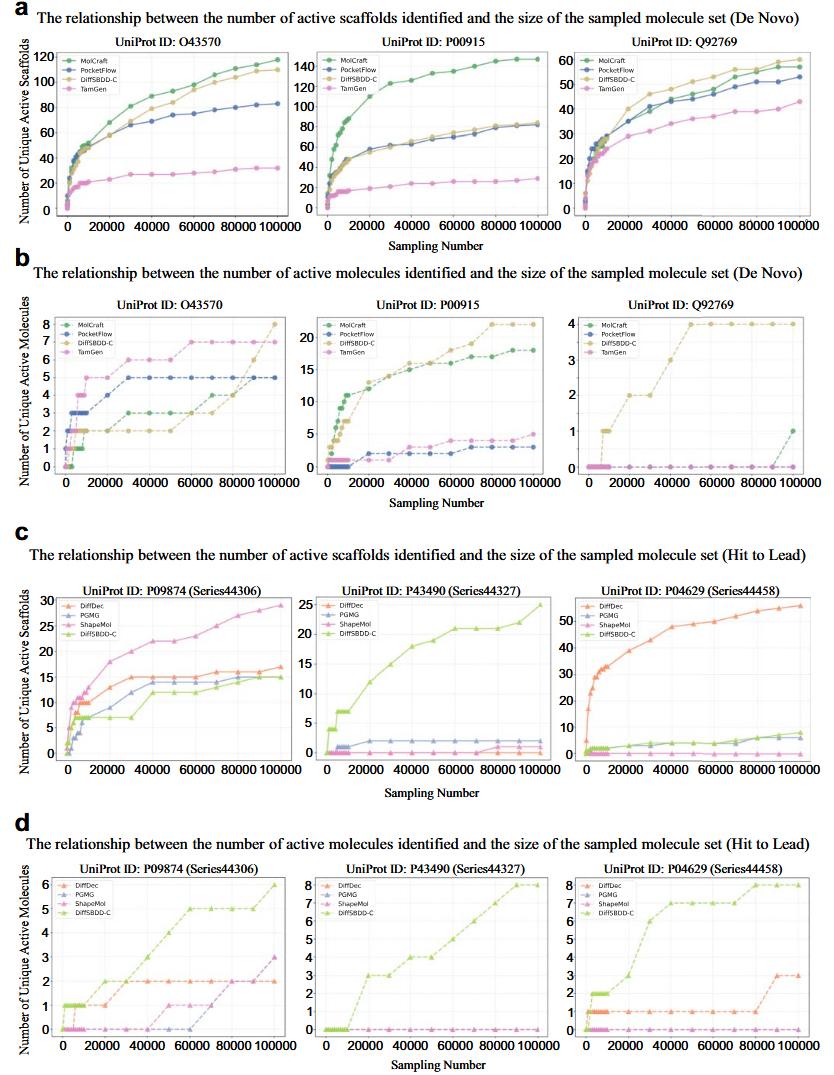
图7|采样数量与活性分子及骨架恢复数量之间的关系
H2L优化展现更强的实际应用潜力
与完全从头生成相比,H2L优化可以利用已有活性分子骨架、片段及蛋白质口袋信息,在相对明确的化学空间内进行搜索。研究发现,基于片段的H2L方法通常比仅利用配体形状或药效团特征的方法具有更高的活性分子恢复能力和命中效率。其中,Delete在部分活性恢复评价中表现突出,DiffDec在活性发现效率方面具有优势。扩散模型DiffSBDD的两个版本也表现出竞争力。研究进一步引入平均归一化亲和力(MNA)等指标,评估H2L模型对活性化合物的优化效果。结果显示,模型表现与训练数据来源和所引入的领域知识密切相关。利用晶体结构数据训练的模型通常能够生成更合理的结合构象,而包含药效团、电荷分布等先验信息的方法有助于提升优化表现。仅依赖分子形状信息的ShapeMol在活性分子恢复方面表现较弱。总体而言,H2L在目标活性分子发现和已知活性化学空间探索方面表现出更直接的应用价值,但由于初始骨架限制,其骨架创新能力可能弱于部分从头生成方法。
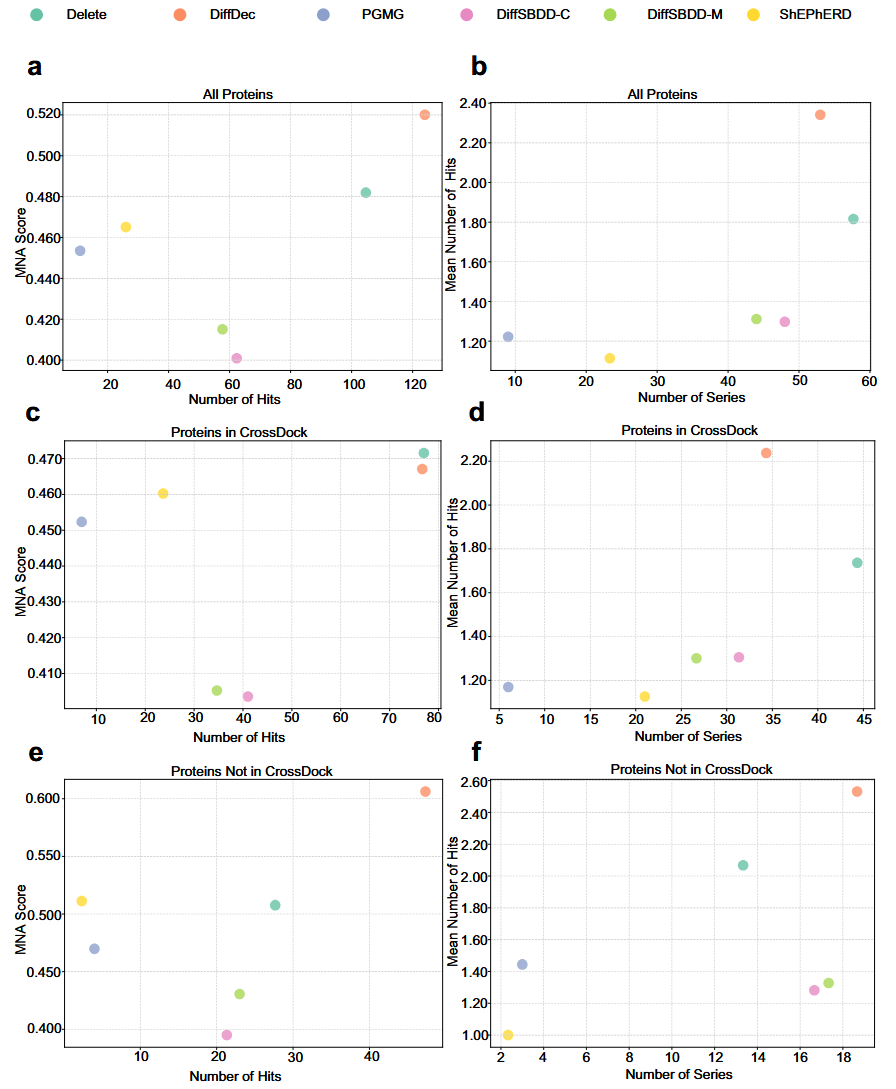
图8|H2L优化模型的活性分子发现与优化能力评价
总结
这项研究建立了覆盖120个蛋白质靶点、600个化合物系列和17种生成方法的MolGenBench评测体系,将模型评价从传统的化学有效性和对接评分,扩展至已知活性分子发现、筛选效率、靶点感知能力及三维构象合理性等多个维度。结果表明,当前结构基础分子生成模型已具备一定的化学结构生成能力,部分先进架构也能够改善三维构象质量和蛋白质–配体相互作用建模,但在稳定生成靶点特异性活性分子方面仍存在显著不足。
不同技术路线具有各自优势:大规模分子预训练有助于学习化学结构规律,扩散模型能够探索更丰富的化学空间,贝叶斯流网络在构象生成方面表现出潜力,而结合蛋白质口袋及初始片段的H2L方法在实际先导优化场景中具有较强优势。总体而言,AI药物生成模型的评价需要从“能否生成合理分子”进一步转向“能否高效发现具有真实生物活性的分子”。将实验活性数据、可靠的靶点相互作用预测、结构信息和药物化学先验相结合,并重视未知靶点上的泛化评价,将是推动生成式AI进一步服务真实药物发现的重要方向。
参考链接:
Cao, D., Fan, Z., Yu, J. et al. Evaluating generative models for structure-based drug discovery from de novo design to lead optimization. Nat Commun 17, 11281 (2026).
https://doi.org/10.1038/s41467-026-78105-8
--------- End ---------
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢