

DRUGONE
医学基础模型在疾病诊断和医学影像分析中展现出广泛应用潜力,但现有模型大多针对特定影像模态开发,缺乏跨临床任务的通用能力,同时难以提供透明、可验证的诊断依据,限制了其临床应用。
针对这些问题,研究人员开发了可解释医学视觉语言基础模型EVLF-FM(Explainable Vision Language Foundation Model for Medicine),将多模态影像理解、疾病诊断、医学视觉问答和像素级病灶定位整合于统一框架。模型开发与测试涉及来自18个全球数据集的超过130万份样本,覆盖10种医学影像模态和皮肤科、肝病学、眼科、病理学、呼吸医学及放射学六大临床领域,并使用另外17个独立数据集中的13,443份样本进行外部验证。
在内部疾病诊断评估中,EVLF-FM取得0.895的平均准确率,优于多种通用及专科模型。在医学视觉定位任务中,其跨九种影像模态的Acc@0.5达到0.842。模型结合监督微调和视觉强化微调,使诊断结果能够关联具体影像证据,并生成具有临床意义的解释。由临床医生开展的S.C.O.R.E.人工评价获得4.25分(满分5分),显示出较好的可解释性。研究表明,EVLF-FM有望为跨专科医学影像分析和临床辅助决策提供通用基础,但仍需要前瞻性临床研究验证其安全性和实际效益。
近年来,人工智能在医学领域的应用逐渐从针对单一疾病的监督学习模型转向能够处理多种临床任务的基础模型。传统医学影像算法通常依赖特定疾病标签进行训练,在既定场景下能够获得较高准确率,但对不同影像类型、疾病类别和临床环境的适应能力有限。相比之下,基础模型可以通过大规模预训练学习更加通用的医学特征,并利用少量标注数据适配不同任务,为构建通用医学人工智能系统创造了条件。
然而,现有医学基础模型仍面临两方面问题。一方面,许多模型主要针对眼底图像、病理切片或放射影像等单一模态开发,虽然在专科任务中表现突出,却难以覆盖复杂的临床工作流程。另一方面,多模态视觉语言模型虽然能够理解医学图像并生成自然语言回答,但在精细病灶定位和空间结构识别方面往往不及专门设计的分割模型。
可解释性是另一个重要挑战。传统医学影像算法通常仅输出疾病类别或风险评分,即使使用显著性热图等方法,也难以完整说明模型为何作出特定判断。视觉语言模型虽然可以生成看似合理的诊断解释,但这些文字未必真实反映模型所依据的影像证据,仍可能出现缺乏依据的推断。
因此,临床应用不仅要求模型具备准确的疾病识别能力,还要求其能够指出相关病灶区域,并通过可核查的影像特征解释诊断结果。研究人员由此提出EVLF-FM,希望在统一模型中兼顾广泛的医学影像处理能力、像素级定位精度和细粒度的诊断解释,为可信赖的临床人工智能提供技术基础。
方法
研究人员构建了融合通用视觉编码器、疾病级编码器和像素级编码器的多模态视觉语言架构,分别提取整体影像特征、疾病相关语义及局部空间信息,并通过连接模块输入语言模型生成诊断、问答和定位结果。训练数据涵盖X射线、CT、MRI、超声、PET、病理切片、皮肤镜、眼底摄影、光学相干断层扫描及内镜图像。模型采用两阶段训练策略:首先通过监督微调学习医学诊断和视觉定位,并利用经过筛选的临床推理数据建立影像特征与文字解释之间的联系;随后采用基于组相对策略优化(GRPO)的视觉强化微调,结合诊断正确性、病灶定位精度及临床解释一致性设计奖励机制,提高模型输出的准确性与可解释性。研究通过内部基准测试、独立外部数据集、零样本及少样本迁移实验,并结合医生人工评分、人口学亚组分析和消融实验评估模型性能。
结果
构建兼具诊断、定位和解释能力的临床多模态基础模型
研究人员首先构建了统一的医学视觉语言框架,使模型能够在不同影像模态之间共享表征,并同时完成疾病诊断、医学视觉问答和病灶定位三个主要任务。
EVLF-FM采用多层次视觉特征提取机制。通用视觉编码器负责获取影像整体信息,疾病级编码器重点提取与疾病分类相关的特征,像素级编码器则保留局部空间信息,使模型能够在回答问题或判断疾病时识别具体的异常区域。不同层次的视觉信息通过连接模块与语言模型整合,从而建立影像、疾病类别和文字解释之间的联系。
为增强模型的临床解释能力,研究人员进一步设计了监督微调与强化微调相结合的训练流程。监督阶段利用临床推理样本,使模型学习从影像观察到诊断判断的表达方式;强化阶段则通过可验证的诊断和定位结果,以及临床解释与参考内容的一致性,对模型输出进行优化。
这一设计使EVLF-FM不仅能够回答影像中是否存在某种疾病,还能够描述异常影像特征,并定位与诊断相关的区域。需要强调的是,这些解释属于模型生成的辅助性诊断依据,其与内部决策过程的一致性仍需独立评价。
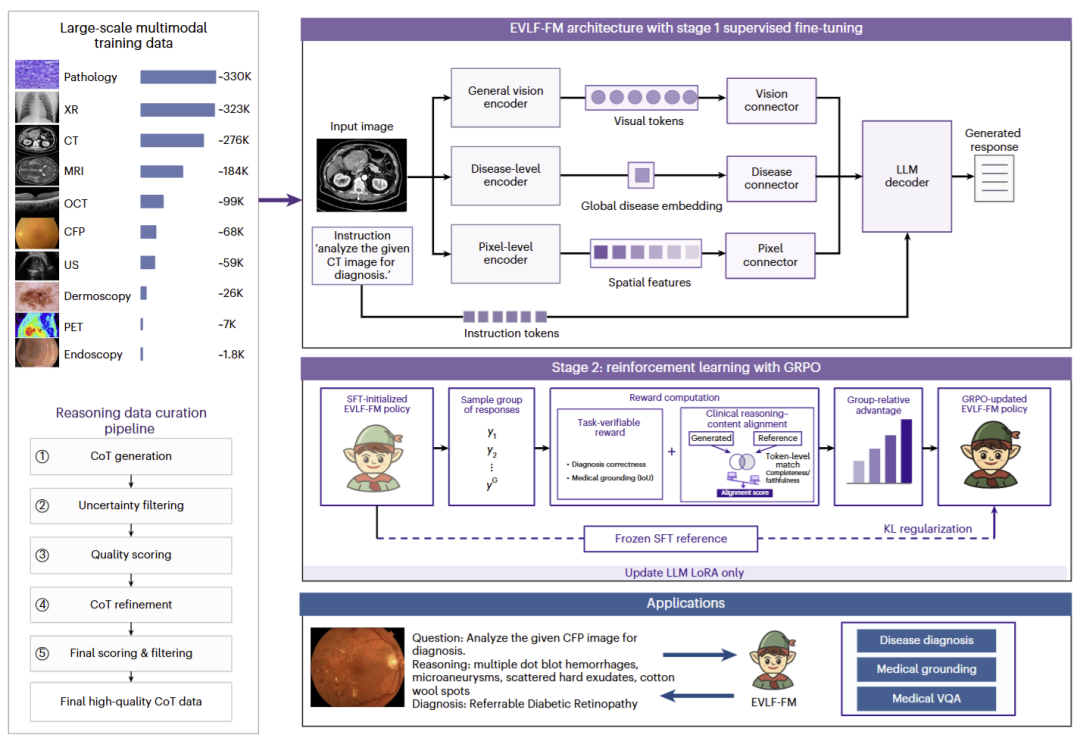
图1|EVLF-FM多模态架构、两阶段训练策略及临床应用框架。
EVLF-FM在多模态疾病诊断中取得较高准确率
研究人员首先在内部医学影像基准数据集上评估EVLF-FM的疾病诊断性能,并与LLaVA、Qwen、InternVL等通用视觉语言模型,以及多种专科基础模型和传统深度学习模型进行比较。
结果显示,EVLF-FM在多种医学影像任务中取得较为稳定的表现,整体平均诊断准确率达到0.895,高于所有参与比较的通用和专科模型。在BCN20000皮肤镜数据集、BUSI乳腺超声数据集及OAEFD-OCT眼科数据集上,其准确率分别达到0.949、0.932和0.990。
在MedMNIST基准测试中,EVLF-FM的平均准确率和F1分数分别达到0.851和0.808,整体优于其他模型。其中,部分专科模型在特定任务上仍具有优势,例如病理组织分类和肺炎识别,但其性能优势通常局限于对应的专业领域。
研究人员还对胸部X射线影像开展了疾病类别层面的分析。EVLF-FM在NIH ChestX-ray14、VinDr-CXR和外部AIMx数据集上的平均F1分数分别达到0.545、0.629和0.668。尽管部分比较模型在个别疾病类别上获得更高准确率,但其F1分数较低,提示类别不平衡可能影响准确率的解释。
总体而言,EVLF-FM在不同器官、疾病类别和影像模态之间表现出较好的综合诊断能力,减少了针对每种医学影像任务分别构建专用模型的需求。
模型具备医学视觉问答和精细病灶定位能力
除疾病分类外,研究人员进一步评估了EVLF-FM对医学图像与自然语言问题的联合理解能力。
在VQA-RAD、SLAKE和Path-VQA三个医学视觉问答数据集上,模型在封闭式问题中的准确率均保持在约90%的水平。对于需要生成自由文本答案的开放式问题,EVLF-FM在VQA-RAD和SLAKE数据集上的召回率均超过80%,表现优于其他参与比较的模型。这表明其不仅能够识别影像中的主要异常,还能够根据问题生成具有一定上下文关联性的回答。
在视觉定位任务中,研究人员使用BiomedParse和VinDr-CXR数据集,评估模型识别病灶或解剖结构所在区域的能力。测试覆盖MRI、病理切片、X射线、CT、OCT、眼底摄影、超声、皮肤镜及内镜九种影像模态。
EVLF-FM的平均Acc@0.5达到0.842,平均交并比(mIoU)达到0.741,均高于比较模型的0.755和0.656。在眼底摄影和内镜影像中,定位性能改善尤其明显,说明同时保留疾病语义和像素级空间信息,有助于提高病灶区域识别的准确性。
这些结果表明,将疾病分类、视觉问答和空间定位整合于同一模型具有可行性,也为建立影像证据与诊断解释之间的联系提供了基础。
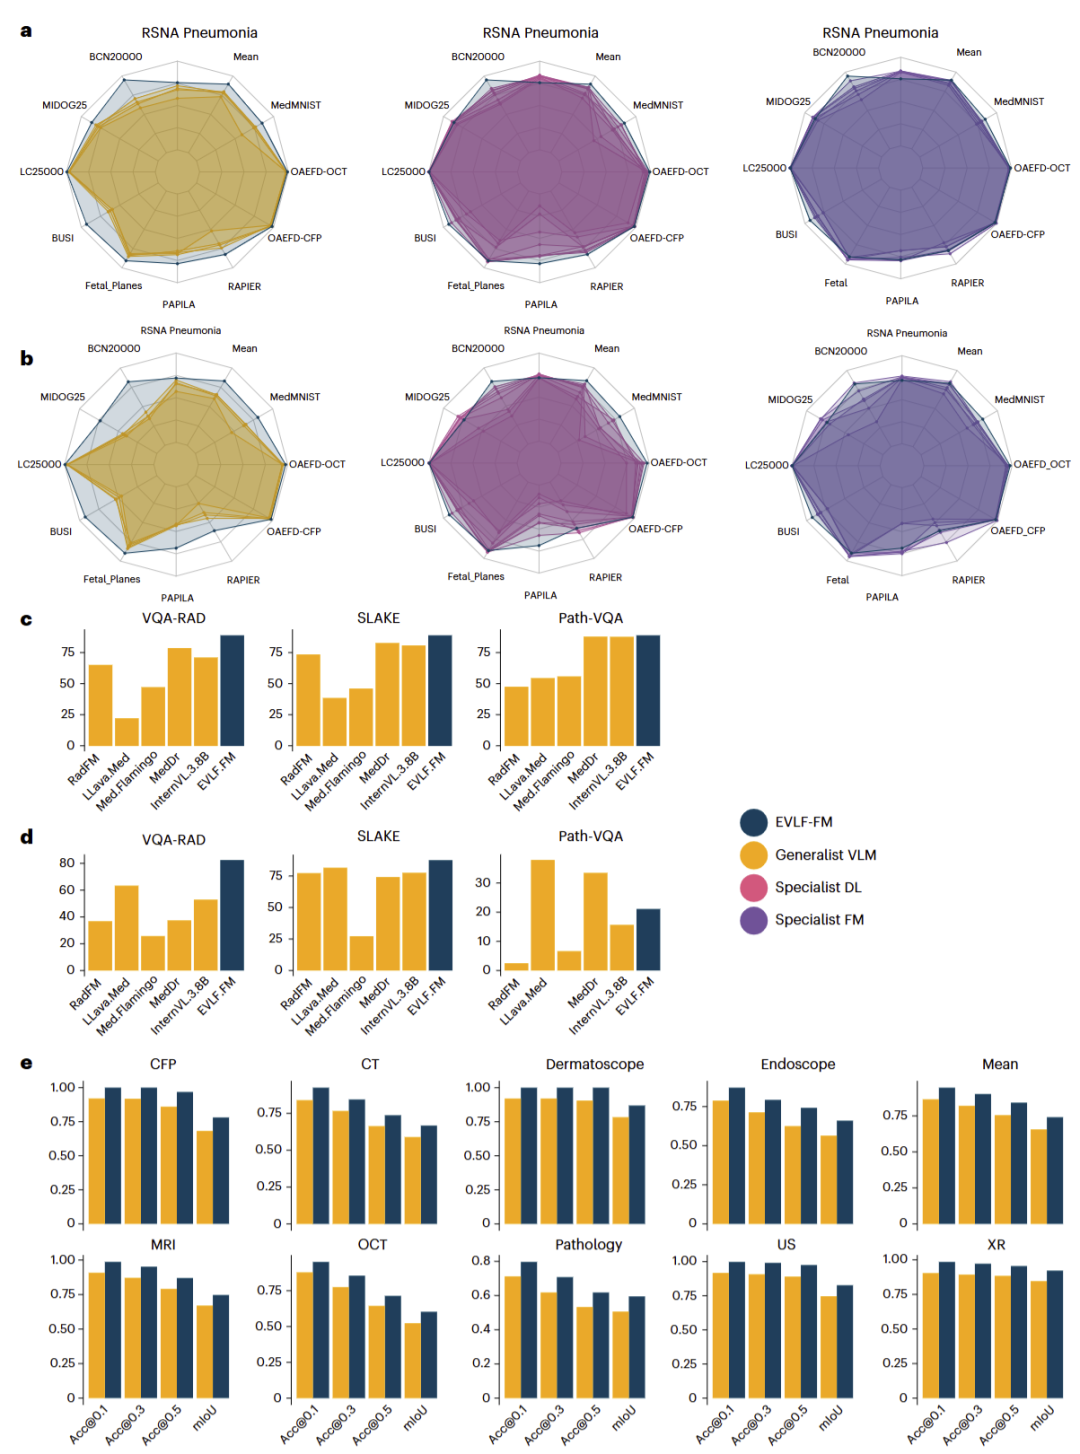
图2|EVLF-FM在内部疾病诊断、医学视觉问答和多模态病灶定位任务中的性能比较。
EVLF-FM在外部数据集上表现出较好的泛化能力
为检验模型在未见过的数据中的适用性,研究人员进一步选取12个独立外部诊断数据集,并与多种医学视觉语言模型比较零样本和少样本性能。
在零样本诊断条件下,EVLF-FM在8个数据集上获得最高的准确率和F1分数,包括COVID-19相关CT影像、肺炎胸部X射线、眼底图像及OCT等任务。其中,在HRCTCov19数据集上的准确率达到0.972,在CXR-Pneumonia数据集上达到0.894。
值得注意的是,EVLF-FM采用约80亿参数的模型规模,但在多个任务上仍能够与参数规模更大的MedGemma 27B和MedDr 32B竞争,说明多层次视觉编码与针对性的训练策略能够提高模型的参数利用效率。
在少样本实验中,研究人员分别引入8、16、32和64个示例进行适配。多数任务的诊断性能随示例增加而改善。例如,RetinalOCT数据集的准确率由零样本条件下的0.503提高至64样本条件下的0.797。不过,更多训练示例并不总能带来持续提升,部分任务在较少示例时已接近最佳表现。
研究人员还在Med-GRIT-270k外部定位数据集上进行测试。EVLF-FM在零样本条件下取得0.360的平均Acc@0.5,高于MedGround的0.317;经过少样本微调后进一步提升至0.545,显示出较好的跨数据集定位能力。
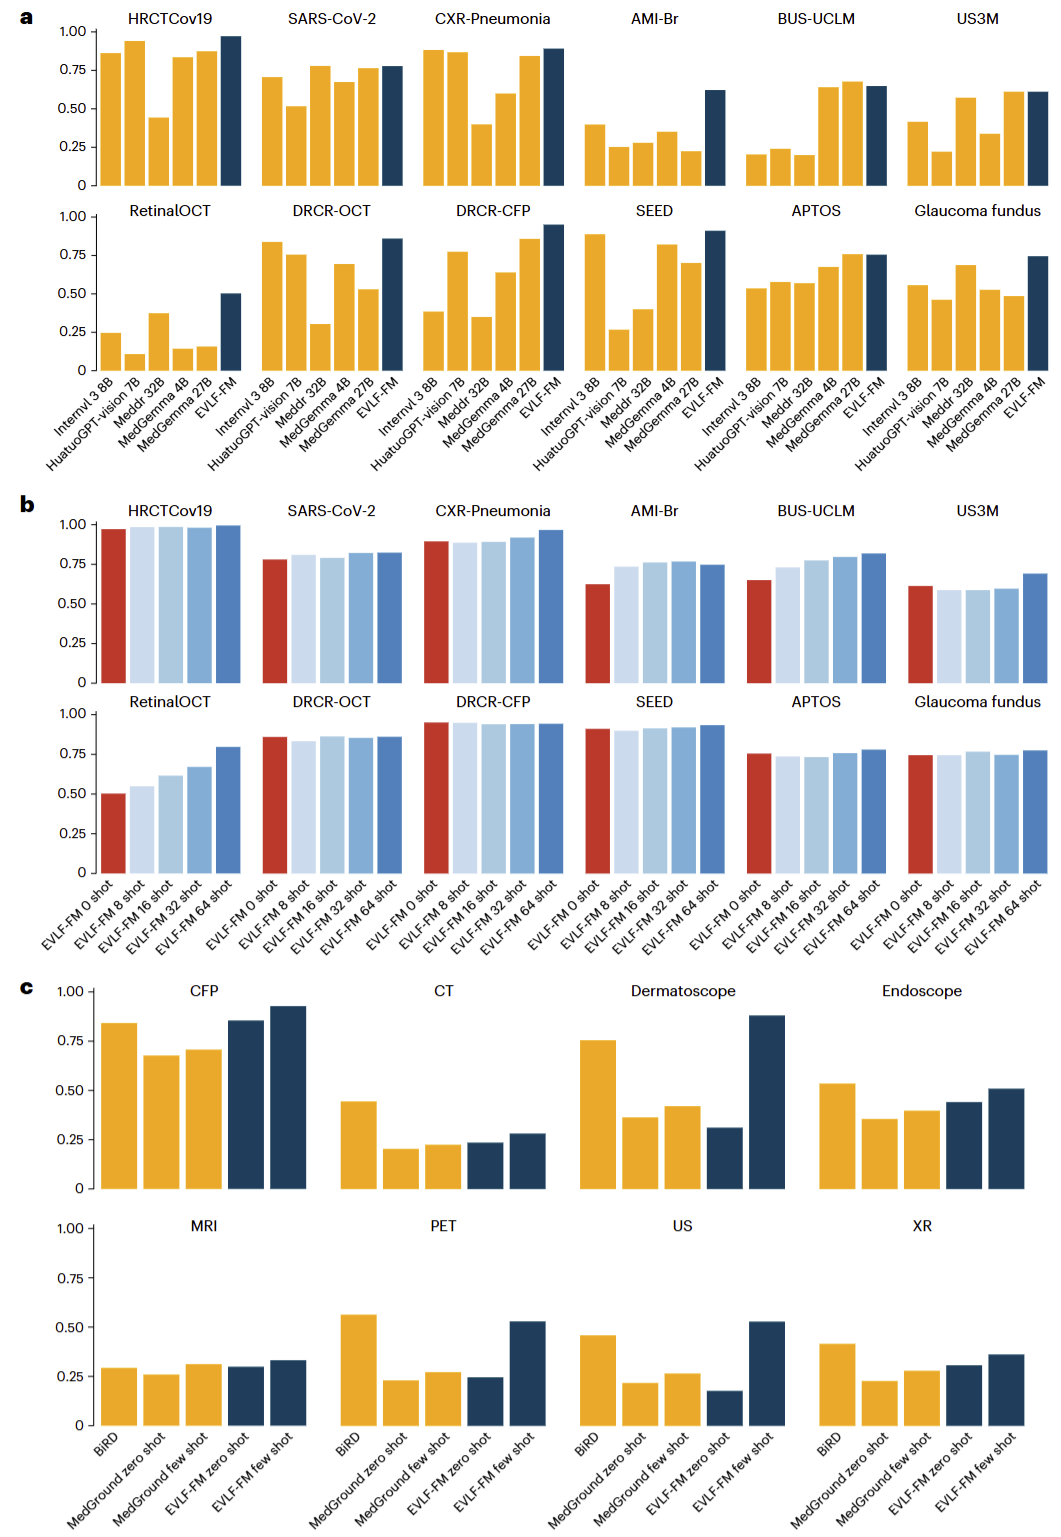
图3|EVLF-FM在独立外部数据集中的零样本、少样本诊断及视觉定位性能。
临床医生评价验证模型解释的可读性与合理性
为进一步评价模型生成解释的临床质量,研究人员邀请12名医生参与人工评估,其中包括4名初级医生和8名来自放射学、病理学及眼科学领域的专科医生。
评估采用S.C.O.R.E.框架,从安全性、临床共识与上下文一致性、客观性、可重复性以及可解释性五个维度进行评分,每个维度满分5分。
结果显示,EVLF-FM总体平均评分为4.25,其中客观性评分最高,达到4.36。不同影像模态中,OCT获得最高的综合评分4.73,说明模型在部分眼科影像中能够较好地将观察到的形态异常与诊断结果联系起来。
研究人员进一步比较了初级医生与专科医生的评价。总体而言,两组评分较为一致,但初级医生通常给出略高的分数。在CT影像中,两组差异达到统计学显著性,主要原因是模型依赖单张二维切片进行解释,而复杂CT诊断通常需要完整的三维影像信息。
具体案例分析显示,EVLF-FM能够识别糖尿病视网膜病变中的微动脉瘤、出血及硬性渗出,也能够根据胸部X射线中的网状间质影推断肺部纤维化。然而,模型偶尔遗漏对最终诊断并非决定性、但仍具有临床意义的次要异常,说明其解释完整性仍有改进空间。
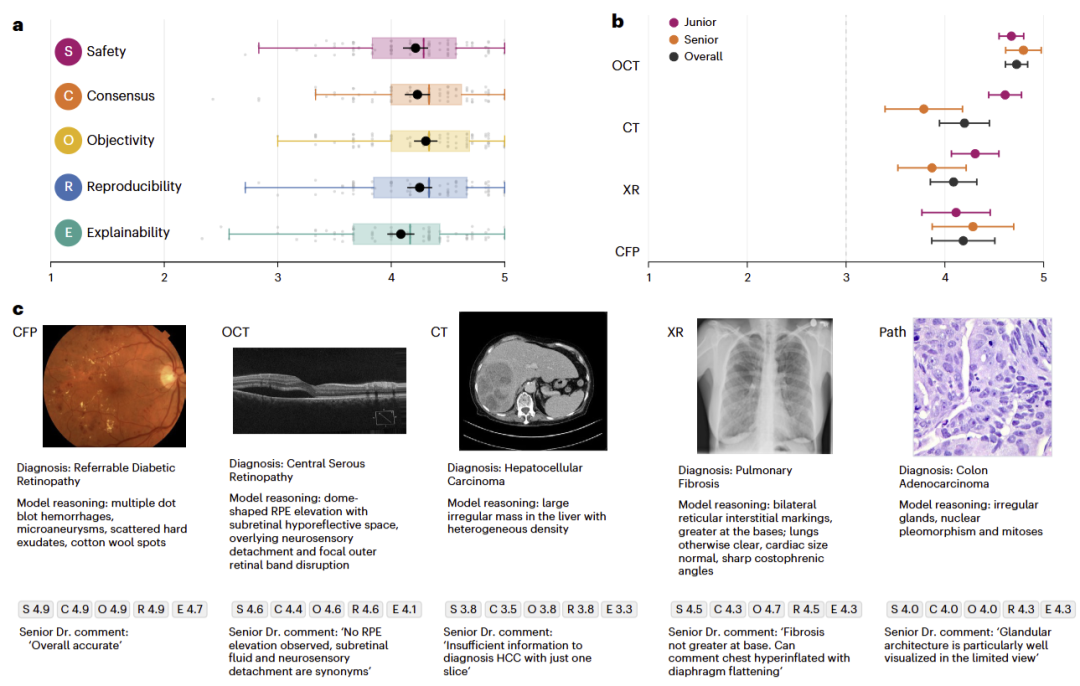
图4|基于S.C.O.R.E.框架的模型诊断解释质量评价及不同医学影像案例。
细粒度视觉定位提高诊断解释的可核查性
研究人员进一步展示了EVLF-FM在不同影像模态中的细粒度视觉定位结果,检验模型是否能够将自然语言描述与对应的图像区域准确关联。
在CT影像中,模型能够根据血管腔的高密度和规则边界等特征识别相应解剖区域,也能够定位肝实质中低密度病灶。在MRI中,模型可以根据异常信号强度及其分布范围,对脑组织病变进行描述和空间定位。
类似地,在皮肤镜图像中,模型能够依据病灶边缘不规则、色素分布不均及局部颜色变化定位异常区域;在内镜图像中,则能够识别隆起性息肉及其表面形态特征。超声影像中的心腔和胎儿头部结构也获得了较好的定位结果。
多个代表性案例的定位预测与人工标注高度重合,部分交并比接近1.0。上述结果说明,模型生成的影像描述能够在一定程度上对应具体可见的解剖结构或异常区域,使临床人员可以直接核查其判断依据,而不仅依赖文字解释。
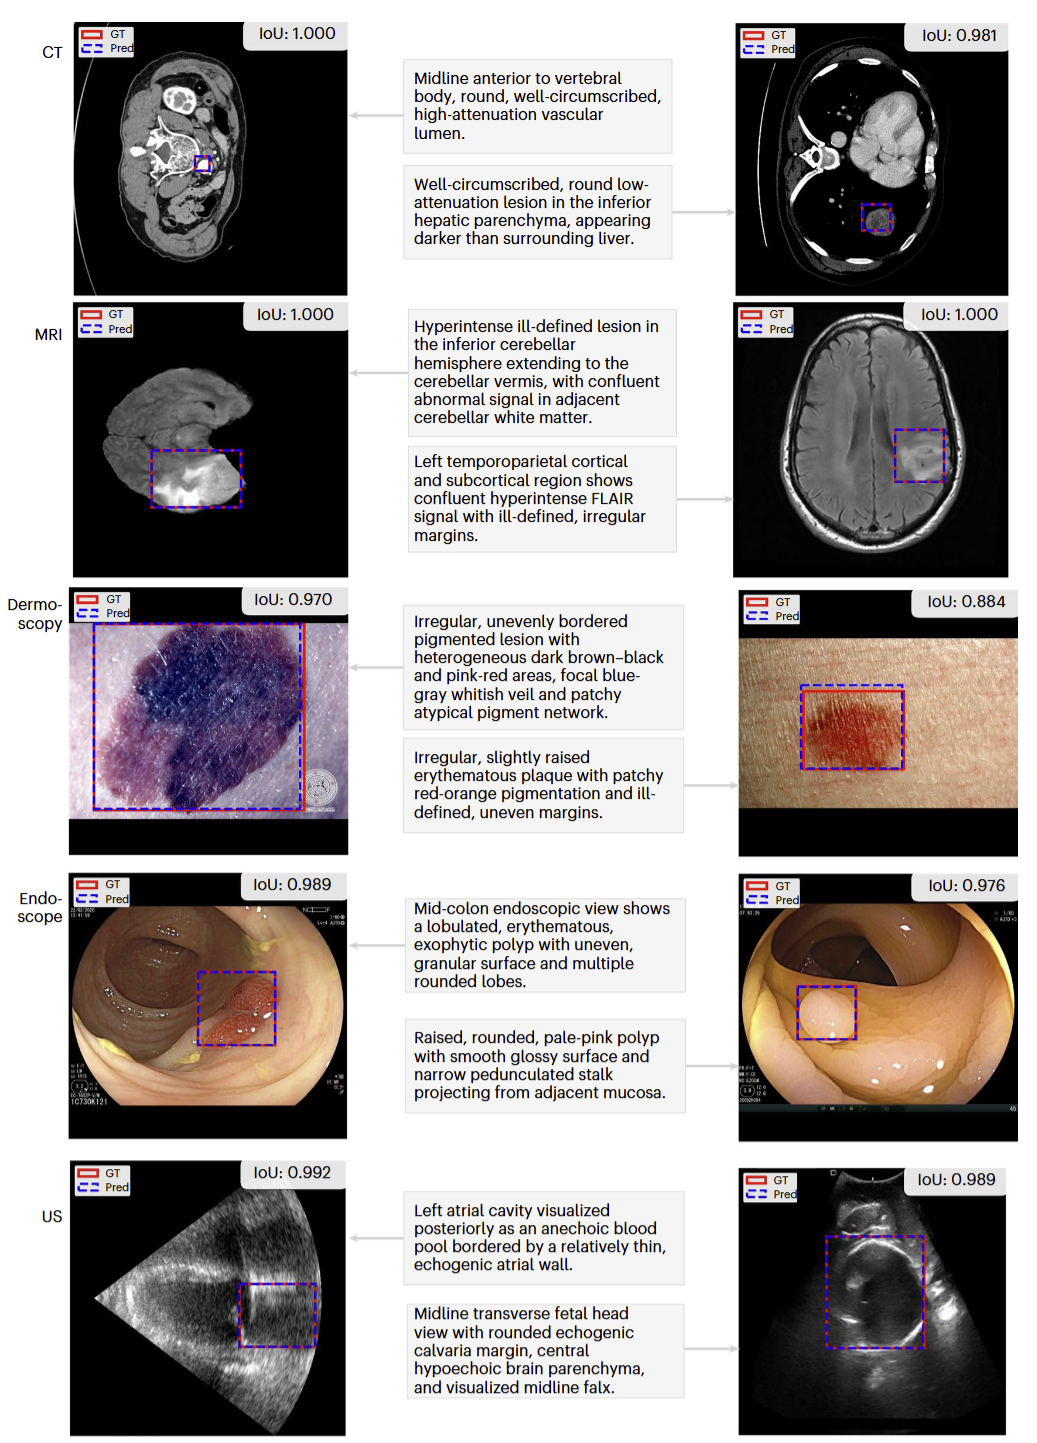
图5|EVLF-FM在CT、MRI、皮肤镜、内镜和超声影像中的细粒度视觉定位示例。
消融实验验证多层次编码和强化微调的作用
研究人员通过消融实验进一步分析EVLF-FM不同模块及训练策略的贡献。
在基础模型中加入经过筛选的临床推理数据后,平均准确率由0.766提高至0.811,F1分数由0.648提高至0.713。进一步引入疾病级编码器后,准确率提升至0.845,表明疾病相关特征学习对于提高诊断性能具有重要作用。
训练策略比较显示,仅使用强化学习而缺乏监督微调初始化时,模型性能明显下降。相比之下,在监督微调基础上加入GRPO强化优化后,准确率由0.845提高至0.858,F1分数由0.769提高至0.797。进一步引入临床解释一致性奖励,也能够带来一定程度的性能改善。
数据效率实验发现,即使只使用20%的强化微调数据,模型仍能够取得0.823的平均准确率和0.766的F1分数;随着训练数据增加至80%,性能已接近完整训练水平,表明模型在有限数据条件下仍具有较好的训练效率。
此外,研究人员通过改变临床问题的表述方式检验输出稳定性。采用不同提示语后,模型总体准确率和F1分数仅出现轻微变化,说明其对自然语言表达差异具有一定鲁棒性。
讨论
该研究提出的EVLF-FM将多模态医学影像理解、疾病诊断、视觉问答和细粒度病灶定位整合于统一框架,并通过监督微调与视觉强化微调提高诊断性能和解释质量。与传统单任务模型相比,其优势不仅体现在跨影像模态的适用性,还在于能够将诊断判断与具体影像特征关联,为临床人员提供更加直观、可核查的辅助信息。
研究结果显示,多层次视觉编码对于兼顾疾病级语义和像素级定位具有重要作用,而引入临床解释一致性奖励能够进一步改善模型输出。不过,较高的解释评分并不意味着模型内部推理过程已被完全验证,生成的诊断依据仍可能存在遗漏或不准确之处。
EVLF-FM目前主要处理静态二维图像,尚不能直接利用完整的三维CT、MRI及动态影像序列,其性能也未达到所有临床任务均可独立应用的水平。此外,不同患者群体、医疗机构和影像设备之间的差异仍可能影响模型表现,需要开展更广泛的外部验证和前瞻性研究。
总体而言,EVLF-FM为开发兼具通用性与可解释性的医学视觉语言基础模型提供了新的技术路径。随着临床数据质量、跨模态学习及解释可靠性评估方法的进一步完善,这类模型有望在医学影像辅助分析、临床工作流程支持和医学教育中发挥更大作用。
整理 | DrugOne团队
参考资料
Bai, Y., Cheng, H., Zhou, Y. et al. A clinical multimodal vision language foundation model with fine-grain explainability. Nat Med (2026).
https://doi.org/10.1038/s41591-026-04655-5
内容为【DrugOne】公众号原创|转载请注明来源
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢