

论文地址:https://arxiv.org/abs/2610.34878
Github地址:https://github.com/SirryChen/ClinVerse
Demo链接:https://sirrychen.github.io/blogs/ClinVerse/
核心观点: 真实医疗环境中,医疗 Agent 不仅需要回答“患者得了什么病”,还需要主动判断“接下来应该问什么、检查什么”。我们提出 ClinVerse,一个基于真实电子健康记录的多智能体临床诊断环境,支持医疗 Agent 的多轮交互、过程评测和自进化训练。
一、研究动机:会做医学题,不代表会完成临床诊断
在 MedQA、CMExam 等传统医学问答任务中,模型通常直接获得完整的症状、病史和检查结果,再预测疾病诊断。然而,在真实临床流程中,这些信息往往并不预先给出:医生需要主动询问患者、申请检查,并根据逐步获得的证据更新诊断假设。
核心区别在于:静态医学问答主要考察如何利用已知证据,而交互式诊断还需要考察如何主动获取证据。
构建这样的交互环境面临两大困难:
临床真实性与信息边界:直接向患者模拟器提供完整病历,可能泄漏诊断答案;对未记录的检查一律回复“无记录”或“正常”,则可能被模型利用于排除可能疾病。
过程级反馈与可扩展评测:仅评价最终诊断无法衡量问诊和检查策略;专家逐条评估成本高,而基于 LLM 的评审存在模型依赖和一致性问题。
为解决这两个问题,ClinVerse 将真实临床病例转化为能够开展多轮问诊、检查和诊断的交互环境,并提供基于规则的轨迹级反馈。
二、ClinVerse:六角色协作的交互式临床环境
2.1 ClinPatient:以15万真实病例支撑可扩展模拟
ClinVerse 基于 ClinPatient 构建病例环境,数据集包含约 150k 个病例,主要源自 MIMIC-IV、SICdb 及关联临床记录。原始电子病历经清洗和结构化处理后,被拆分为患者画像、临床状态,以及可追踪的 Information Units(临床信息单元)。信息单元可以是症状、既往病史或用药史等,用于标记哪些信息已经被医生获取。为了提升患者的真实感,被脱敏的患者社会背景使用 Synthea 工具条件生成补全;OCEAN 人格特征用于调控对话风格。
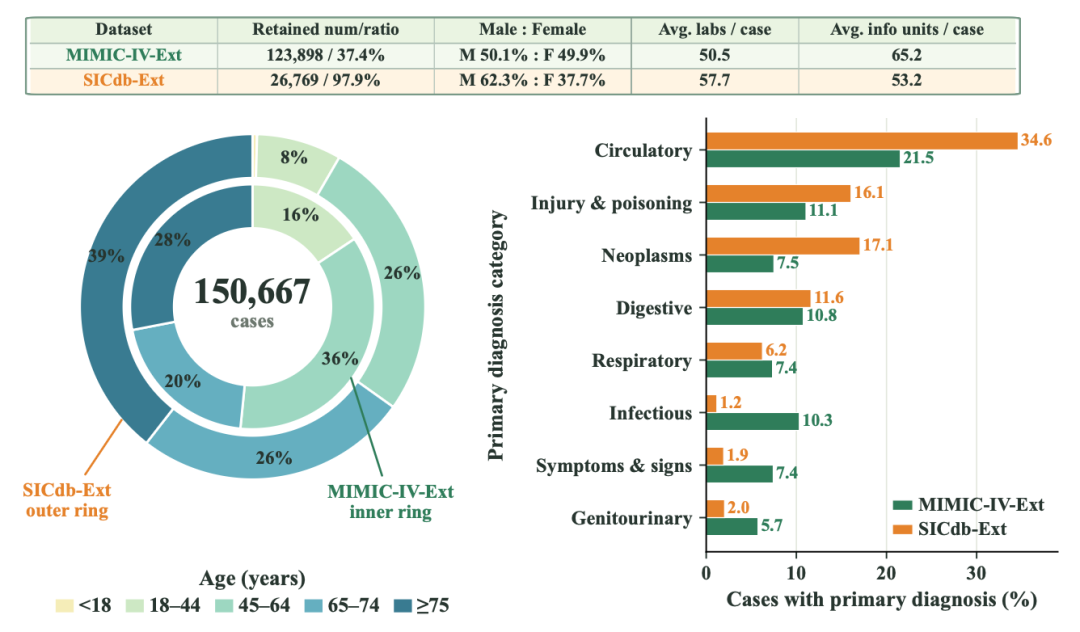
图1|ClinPatient 数据分布:展示 MIMIC-IV-Ext 与 SICdb-Ext 的病例规模、性别年龄构成、单病例检查和信息单元数量,以及主要诊断类别分布,反映真实 EHR 的病例多样性。
2.2 双层患者:控制信息披露,减少答案泄漏
为了从根本上降低患者模拟器在交互过程中泄漏诊断信息的风险,我们将患者模拟器拆分为两层。Observable Patient 只拥有真实场景下患者能够知晓的信息,Latent Patient 则保存包含诊断与检查结果的完整临床状态,两者之间设有访问边界。Self-check机制进一步检查患者回答是否存在无依据或越权披露。
2.3 ClinLab:支持未记录检查的开放式请求
真实 EHR 并不包含所有潜在检查项目,这限制了模拟交互中的自由度。如果对缺失项目返回正常或者不存在,则可能被医疗Agent利用于排除可能的疾病。ClinVerse 对有记录的检查优先返回原始结果;而对未记录的检查,利用经过训练得到的ClinLab 生理状态预测模型 推断具有临床合理性的结果。
2.4 轨迹级评测:不仅看诊断,也看如何获得证据
ClinVerse 用五个基于规则的指标,同时评估信息获取与最终诊断。通过区分信息获取过程与诊断结果,ClinVerse 可以更清楚地定位模型在不同临床环节中的能力短板。
衡量的问题 | |
ICR 信息收集率 | 是否问出了病例中的关键患者信息;关键信息拥有更高权重 |
TOC 检查覆盖率 | 是否请求了病例相关的检查 |
ATC 异常检查覆盖率 | 是否发现了病例中有异常的检查结果 |
DCA 诊断类别准确率 | ICD-10 block 是否匹配 |
DSA 细粒度诊断准确率 | ICD-10 三字符类别是否匹配 |
2.5 ClinVerse:基于真实电子健康记录的多智能体临床诊断环境
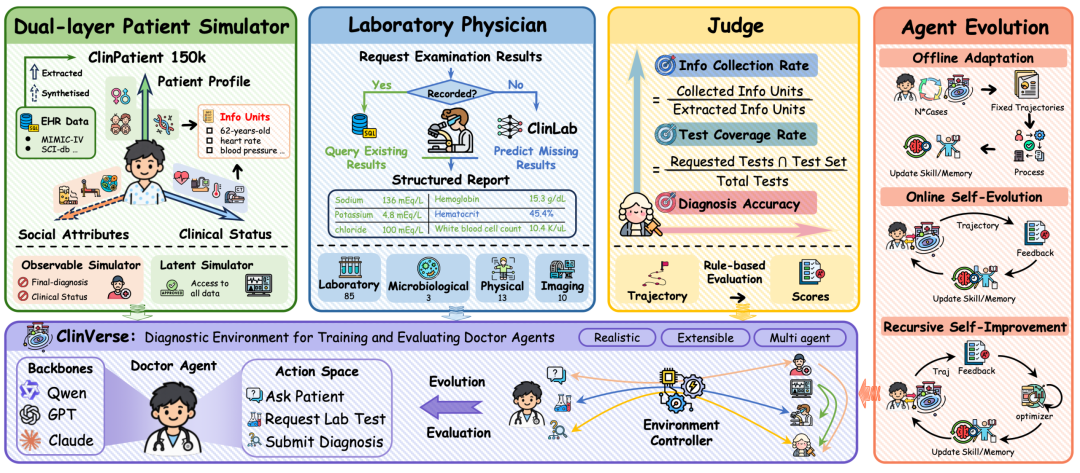
图2|ClinVerse 整体框架:以 ClinPatient 提供真实病例基础,通过双层患者、检查医师和环境控制器组织诊断交互,再由规则化评估器提供反馈,支持三类 Agent 自进化策略。
基于上述构造的ClinPatient和训练的ClinLab,我们构建了模拟真实医疗诊断环境的ClinVerse。环境中包括六类角色:
角色 | 主要职责 |
Doctor Agent | 主动问诊、请求检查并提交诊断,是训练与评测对象 |
Observable Patient | 根据患者可知的症状、病史等信息回答问题 |
Latent Patient | 保有完整临床状态,但不直接向医生披露 |
Laboratory Physician | 返回已记录或预测的检查结果 |
Environment Controller | 管理动作、访问权限、交互轮次和轨迹记录 |
Diagnostic Judge | 根据临床证据与诊断标签进行规则化评估 |
医生 Agent 在每轮可以执行三类动作:问诊(Ask Patient)、请求检查(Request Examination)或提交诊断(Submit Diagnosis)。检查请求涵盖体格、实验室、微生物和影像检查。由此,诊断不再是给定全部信息后的单次推理,而是逐步获取证据、持续修正假设的完整过程。
三、主要实验:ClinVerse 既支持评测,也能用于训练
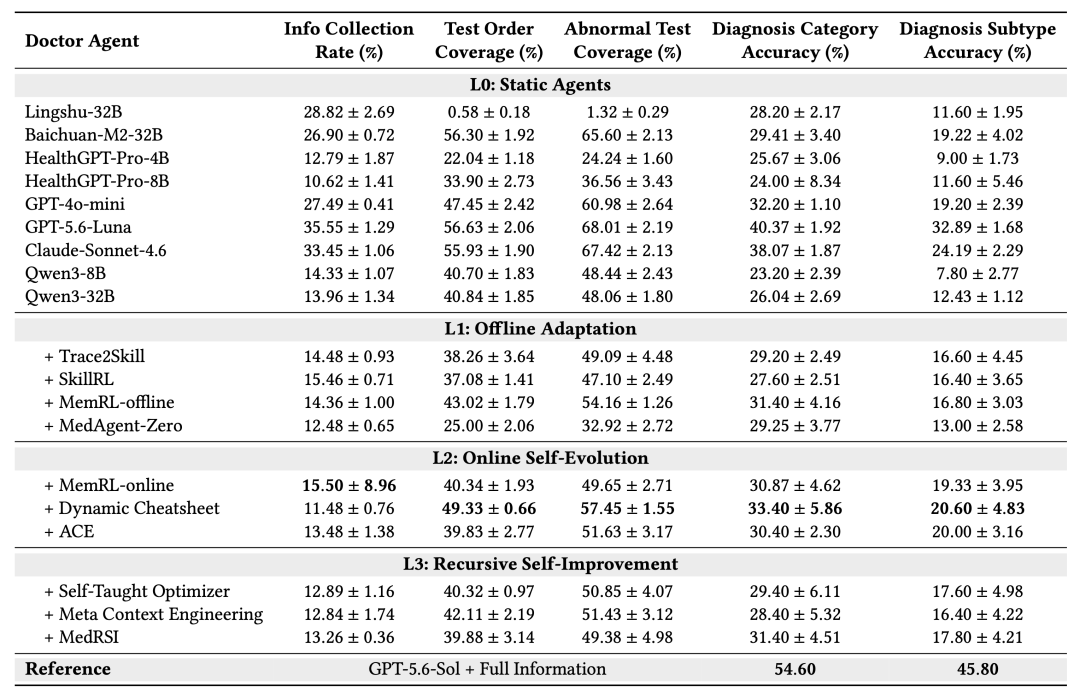
表1|医疗 Agent 评测与自进化实验:比较通用模型、医疗专用模型及三类适应策略在信息收集、检查覆盖和 ICD-10 诊断准确率上的表现;结果为独立重复实验的均值与标准差。
3.1 不同医疗 Agent 的交互诊断表现
GPT-5.6-Luna 在受评交互模型中表现最强,但与完整信息参考设置仍存在显著差距。不同模型也呈现明显不同的能力画像:Baichuan-M2-32B 的检查覆盖表现突出,但诊断准确率并没有很高;Lingshu-32B 则很少请求检查,更依赖既有知识与初始信息。这说明,最终诊断分数不能独立解释一个 Agent 的临床能力,必须结合其获得证据的方式理解结果。
3.2 三类自进化方法的训练表现
以 Qwen3-32B 为基线,论文测试三类方法:
L1 离线适应:Trace2Skill、SkillRL、MemRL-offline、MedAgent-Zero,侧重从固定轨迹学习技能与经验。
L2 在线自进化:MemRL-online、Dynamic Cheatsheet、ACE,在执行和反馈过程中持续更新策略或记忆。
L3 递归自改进:Self-Taught Optimizer、Meta Context Engineering、MedRSI,尝试进一步优化改进机制本身。
三类方法均能带来一定诊断收益。其中,Dynamic Cheatsheet 在该组适应实验中获得最突出的综合结果,诊断类别准确率为 33.40%,细粒度诊断准确率为 20.60%;同时,其信息收集并非最多。这表明利用交互反馈优化临床决策策略,可以在不一味增加问诊信息的情况下改善诊断表现。
四、进一步发现:真正重要的是证据质量,而非数量
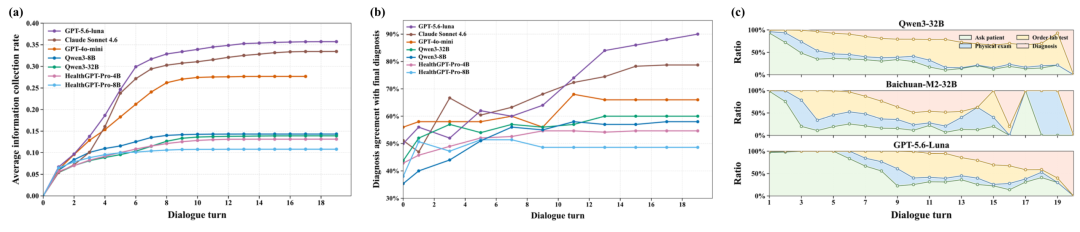
4.1 信息收集先趋于饱和,诊断仍可能继续改善
Agent 在前期更集中地询问患者,随着对话推进,新增信息逐渐减少,但诊断一致性仍可提升,这说明后续交互除了增加新信息,也可以帮助模型确认、筛选和重新解释已有证据。
4.2 信息获取更多,不保证诊断更准确
为了进一步分析不同自进化方法对医疗 Agent 能力的影响,我们选取了三个不同能力水平的模型,并分别应用三类代表性自进化策略。我们将五项评测指标整合为两个维度:信息获取能力(ICR、TOC、ATC 的平均值)与诊断准确率(DCA、DSA 的平均值),并以静态 Agent和完整信息设置作为参考,对比不同自进化策略带来的能力变化。
实验发现,不同模型和自进化方法呈现出明显不同的能力变化趋势。对于 Qwen3-32B,自进化通常能够同时改善信息获取与诊断表现;而对于能力更强的 GPT-5.6-Luna,部分方法在降低信息收集量的同时,仍能取得更高的诊断准确率。这一现象表明,医疗 Agent 的自进化并不只是获取更多临床信息,更重要的是学会筛选、优先获取并有效整合具有诊断价值的证据。
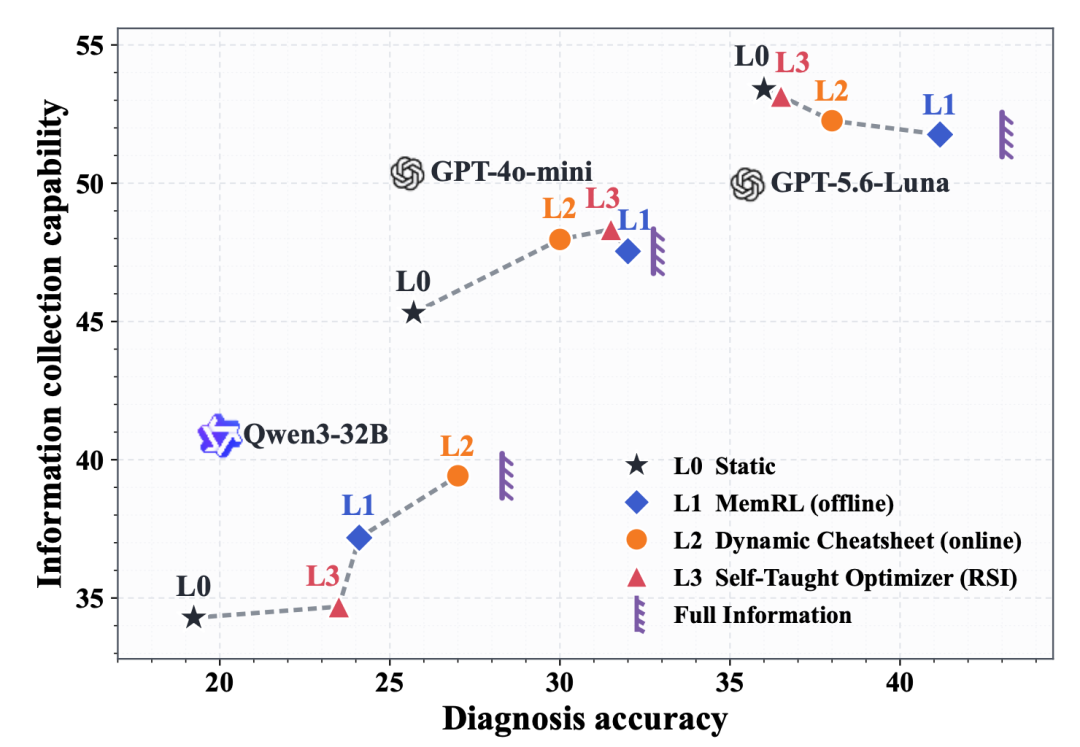
图4|信息获取—诊断能力关系:不同基座模型与自进化策略的散点分布显示,两种能力并非同步增长;更高诊断准确率可能来自证据选择与利用效率的改善。
4.3 跨模型学习依赖轨迹质量与能力匹配
我们进一步比较了 Qwen3-32B 和 GPT-5.6-Luna 生成的诊断轨迹对其他模型的训练效果。实验结果表明,较弱来源模型的轨迹可能无法有效指导更强目标模型,甚至产生负迁移;高能力来源模型生成的少量轨迹,则能够明显帮助部分较弱模型。
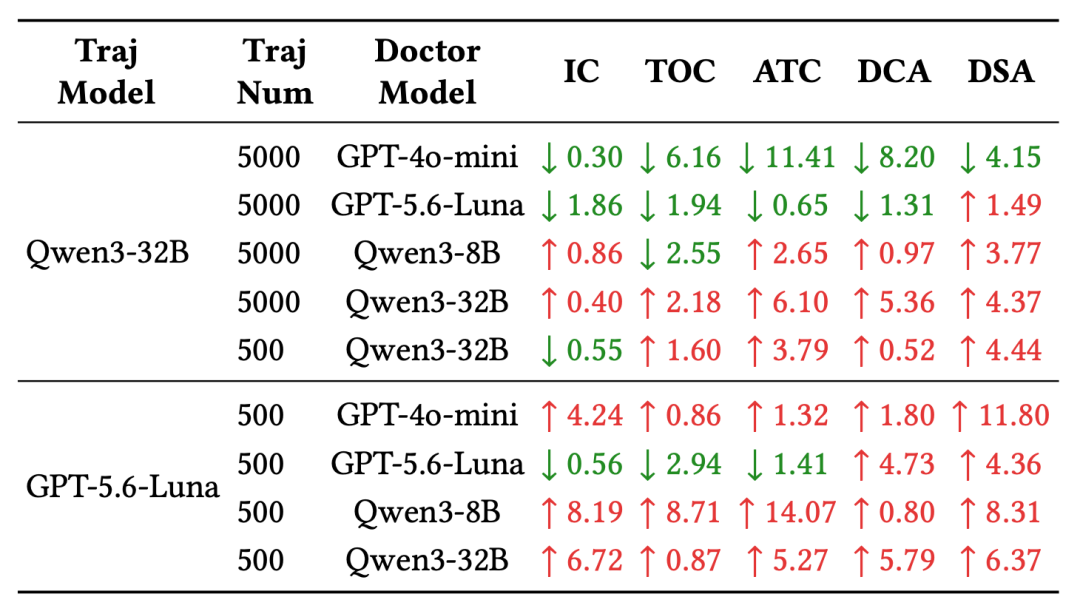
表2|跨模型学习能力分析:不同来源模型的诊断轨迹对目标 Agent 的提升效果存在明显差异,强模型生成的高质量轨迹通常具有更好的迁移效果,而弱模型轨迹可能导致负迁移。
4.4 自进化能力具有一定跨环境泛化性
为了验证 ClinVerse 中训练得到的能力是否具有跨环境泛化性,我们将不同自进化方法应用于 Qwen3-32B,并将训练后的 Agent 直接迁移至独立的医疗交互环境 AIHospital,在不进行额外适配的情况下评估其表现。实验结果表明,训练后的 Qwen3-32B 无需进一步适配,即可在独立环境 AIHospital 中体现部分诊断能力收益。
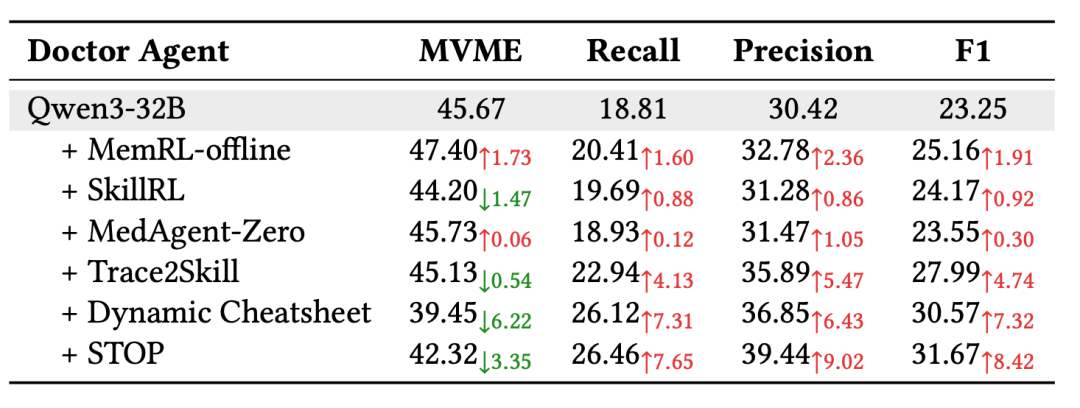
表3|跨环境泛化能力分析:ClinVerse 中学习的诊断能力能够迁移至 AIHospital,多种自进化方法提升了诊断表现,但部分方法存在诊断准确率与问诊质量之间的权衡。
Takeaways:实验揭示了什么?
证据获取是主要瓶颈。 模型具备医学知识,并不意味着能够在交互中主动找到关键证据。
更多信息不等于更好诊断。 临床决策更依赖证据选择、优先级和整合能力,而非信息数量本身。
自进化收益取决于经验质量。 高质量轨迹与合适的师生能力关系很重要,低质量经验可能造成负迁移;跨环境结果也提示应兼顾诊断准确率与问诊质量。
五、总结与展望
ClinVerse 通过真实 EHR 病例、六角色交互、双层患者模拟、ClinLab 检查预测与规则化轨迹评估,构建了既能评测、又能训练医疗 Agent 的诊断环境。
未来可以进一步考虑检查成本、侵袭性与安全约束,更丰富的多模态信息,以及随时间演变的疾病状态。对于预测检查结果,也需要更完善的不确定性处理与可靠性验证。
从“回答已有问题”到“主动提出临床问题并寻找答案”,是医疗 Agent 走向更完整临床决策能力的重要一步。
复旦大学数据智能与社会计算实验室
Fudan DISC
联系方式:disclab@fudan.edu.cn
地址:复旦大学袁天凡、慧敏校园C栋
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢