

近日,记忆张量 MemTensor 正式推出并开源记忆原生基础模型 MemT 1.0 系列。 MemT 1.0 将持续存在、能够更新的内部记忆纳入模型计算,让历史信息与任务经验能够被保留,并在后续相关任务中调用。我们希望,让“记住、更新、调用经验”成为模型可以学习的能力。 本次发布包括 MemT-1.0-Flash 与 MemT-1.0-Nano,参数规模分别为 288B、36B,激活参数分别为 17B、3B。在 11 项记忆基准上,两款模型的平均得分分别为 50.6、47.0,位列本次评估的参数化记忆方法第一、第二;这些结果均在查询上下文不提供原始历史文本的条件下取得。
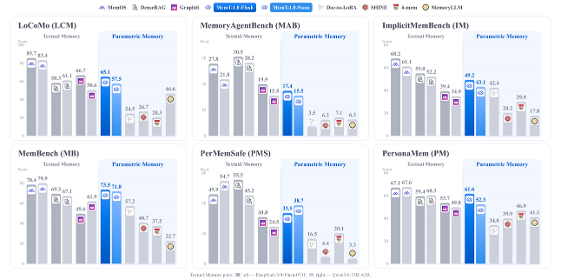
图:MemT 1.0 在基准测试中的记忆性能表现
10 月 20 日上线开源平台 Hugging Face 后,日均下载量已超过 1 万次,累计下载量破 10 万次,在大尺寸架构创新模型中处于领先地位。把记忆做成原生能力的开源模型,正在开发者中快速出圈。
记忆原生:从信息保存到可学习能力
基础模型正在将推理、多模态等能力内化到自身,记忆是另一项关键能力。它让模型能够承接此前的信息与经验,在持续交互中积累并使用这些信息。 此前,Metis 提出了记忆基础模型,探索将记忆作为模型的原生能力。MemT 1.0 在此基础上升级:在选定的 Transformer 模块中加入原生记忆模块,使原有注意力与记忆注意力并行运行,通过动态局部记忆和可训练的超记忆,共同支持信息存储与使用。
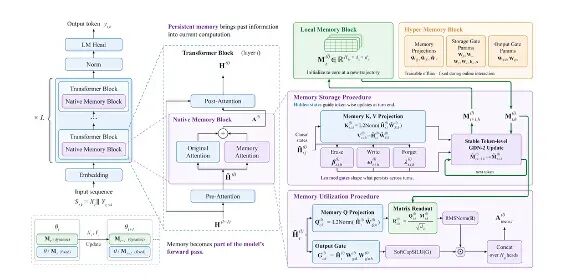
图:MemT 1.0 记忆原生架构
文本记忆方法在查询时提供历史原文或检索证据;MemT 1.0 则通过内部记忆状态利用此前写入的信息,无需再次提供原始历史文本。 创新的关键,是让模型学习如何保留、更新和读取记忆。在线交互时,主干与超记忆权重保持固定,变化的是各条交互轨迹独立维护的动态记忆状态。当前轮生成读取已有记忆,交互完成后,再将输入与回答写入记忆,供后续交互使用。
记忆机制:如何更新,如何扩容
MemT 1.0 的记忆机制围绕三个关键支点展开。
逐 token 稳定更新 采用基于 Gated DeltaNet-2 的稳定更新机制,在每轮交互结束后的存储过程中,逐 token 更新记忆,通过擦除、写入与遗忘机制,将新信息融入已有记忆。
混合存储扩容 引入 Mixture-of-Storage(MoS),将原生记忆模块扩展为多个记忆专家,通过独立的存储与使用路由分配信息。MoS 采用所有专家共同参与的稠密路由,为记忆容量扩展提供机制;本次主评测模型每个记忆层使用一个专家,多专家扩容另行开展对照实验。
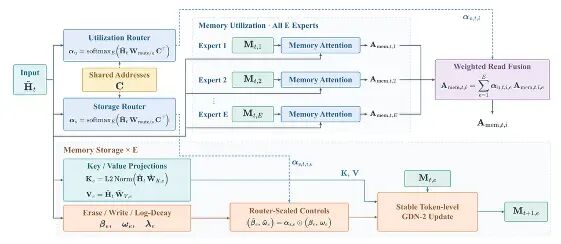
图:Mixture-of-Storage(MoS)
两阶段训练 通过持续预训练建立依赖记忆原生的语言建模能力,再通过后训练学习基于记忆完成任务。报告构建了 340 亿 token 的训练语料,其中持续预训练语料 200 亿、后训练语料 140 亿。后训练采用“上下文—查询—回答”格式,让学生模型仅凭记忆状态学习完整上下文教师的回答行为。
实测表现:记得住,也要用得稳
记忆原生模型既要用好历史信息,也要在记忆噪声下保持原有能力。我们从记忆能力与通用能力两个方面,评估了MemT 1.0的实际表现。
记忆能力:不看原文,能否用好历史
实验围绕 11 项记忆基准,评估不同历史长度下的信息保留与检索、动态更新与管理,以及个性化理解。历史按时间顺序写入记忆,随后模型回答相关问题;不同用户和历史之间的记忆严格隔离。 在查询上下文不提供原始历史文本的条件下,MemT-1.0-Flash、MemT-1.0-Nano 的平均得分分别为 50.6、47.0,位列本次评估的参数化记忆方法第一、第二,比其他参数化记忆方法的最高平均分分别高出 12.5 分、8.9 分。 两款模型各有侧重:Flash 在记忆操作、个性化理解、对话回忆和隐式学习方面表现更强;Nano 在 PerMemSafe、Memora 上得分更高。最强文本记忆系统整体仍有优势,尤其是在长历史测试中。如何让重要细节经受连续更新,并在需要时被准确读取,是记忆原生模型持续发展的关键。
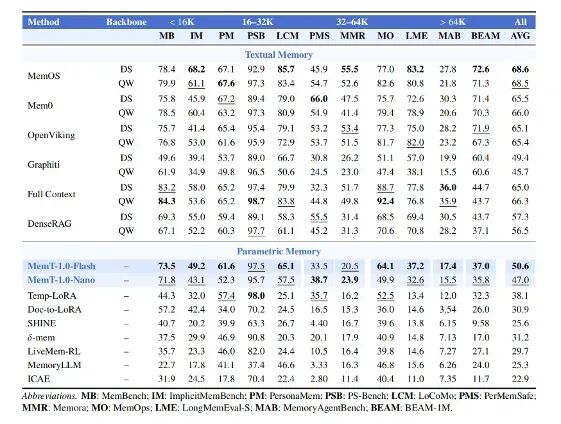 *11 项基准上的记忆能力评估。 基准按交互轨迹长度分组。DS 表示 DeepSeek-V4-Flash-0731,QW 表示 Qwen3.6-35B-A3B。原表中的粗体和下划线分别表示各记忆类别内的最佳和次佳结果。
通用能力:面对无关记忆,能否保持原有表现
模型还需要应对无关记忆的干扰。我们在评估前向记忆中写入无关信息,模拟持续交互中的干扰情形,并在知识与科学推理、指令遵循、长上下文理解和代码生成四个维度、六项基准上,与同一噪声设置下的对应主干模型进行比较。Flash的平均分与对应主干基本持平,Nano下降了0.9分。
首先是指令遵循:模型能否准确执行当前要求。表中的 IFE 指 IFEval,考察模型能否遵守指定格式、长度限制、必要关键词等明确要求,这关系到回答能否直接用于工作。在无关信息下,Flash相对对应主干提高 0.9 分,得分达到 93.9 分;Nano 提高了 3.3 分,达到 92.6 分,表明两款模型在这一测试中仍能较好地执行当前指令。
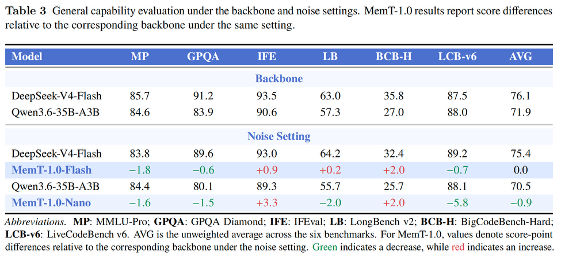
*噪声设置下的通用能力评估。MemT 1.0 的数值表示其相对于同一设置下对应主干模型的分数差。
其次,是大家关心的实用编程:生成的代码能否真正完成任务。BCB-H 指 BigCodeBench-Hard,要求模型理解复杂需求、组合调用软件库,并生成能够通过执行测试的代码,用以检验模型能否将编程知识转化为可运行的解决方案。在这一测试中,Flash 和 Nano 相对各自主干模型,均提高 2.0 分,分别达到 34.4 和27.7 分。不过,另一项代码测试 LiveCodeBench v6 分别下降 0.7 分、5.8 分,说明不同类型编程任务受到的影响存在差异,不能将单项改善扩大为编程能力的全面提升。
长文本理解关注:面对大量材料,模型能否理清信息并回答问题。LB 指 LongBench v2,覆盖长文档、多文档、长对话和代码仓库等任务,考察模型对长篇材料的理解与推理能力。在无关信息的干扰下,Flash 相对主干提高 0.2 分,得分达到 64.4 分,整体表现接近;Nano 则下降了 2.0 分。内部记忆对历史信息的保留,与模型对当前长篇材料的理解,需要分别检验。
这些结果表明,记忆能力与通用能力可以在整体上兼顾,但部分任务仍存在性能损失。让模型在持续积累信息的同时保持可靠表现,是记忆原生模型需要持续优化的方向。
经验致用:记忆如何改变下一步行动
MemT 1.0 探索大模型能力增长的新路径是在参数、数据与上下文之外,让有效经历得到保留,并在后续任务中发挥作用。 在 Coding Agent 中,问题复现方法、失败模式和验证流程等操作经验,经检索后写入模型内部记忆,再指导后续动作,无需持续以文本形式占用任务上下文。当前实验使用外部构建的经验库,并在 Nano 基础上进行应用专项后训练。 我们在 SWE-bench Verified 的 500 项任务和 SWE-bench Multilingual 覆盖九种编程语言的 300 项任务上,对比无经验、文本经验和记忆原生方式,每项任务独立执行三次。
在 Verified 方面,任务开始时提供经验,Nano 将平均成功率从 66.07% 提高到 69.33%,文本经验为 68.87%。由执行框架在关键断点触发经验写入时,平均成功率达到 69.73%,三次全部成功的任务比例从 54.00% 提高到 62.80%,提升 8.80 个百分点。
在 Multilingual 方面,执行框架触发设置下的平均成功率为 63.56%,高于无经验的 60.00% 和文本经验的 63.00%;三次全部成功的任务比例从 45.33% 提高到 55.33%。收益主要体现在平均成功率和重复执行的一致性,三次至少成功一次的比例并未持续提高。
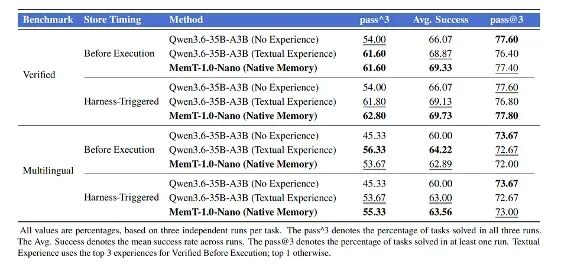 *SWE-bench Verified 和 SWE-bench Multilingual 上的智能体编程表现。原表中的粗体和下划线分别表示每个基准及经验提供设置内的最佳和次佳结果。
这里,我们用一个简单的游戏实验来帮助理解
*对比有无记忆原生时的迷宫探索表现,展示 MemT 1.0 如何借助历史成功经验,提升下一轮探索效率。视觉呈现经过美化。
存储运行效率:持续积累,状态可控
固定记忆配置下,新信息更新现有矩阵,持久化状态大小不会随历史持续扩大。主评测配置中,Nano 每条交互轨迹的 FP32 记忆状态为 40 MiB,Flash 为 1,280 MiB,不包含共享模型权重和当前轮 KV 缓存。 在 BEAM 历史的效率评估中,128K token 历史长度下,Nano 相比完整上下文方式实现约 1.86 倍端到端推理速度,持久化状态约为其 1/66;256K 历史下,端到端速度约为其 3.99 倍。 完成历史准备后,在 512 至 256K token 的评估范围内,Nano 的平均查询首 token 延迟约为 104—112 毫秒,基本保持稳定。端到端延迟包含历史准备及固定 128-token 回答的生成;查询首 token 延迟不包含历史准备。
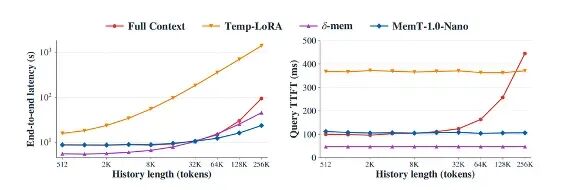
*效率评估结果,端到端延迟与查询首 token 延迟
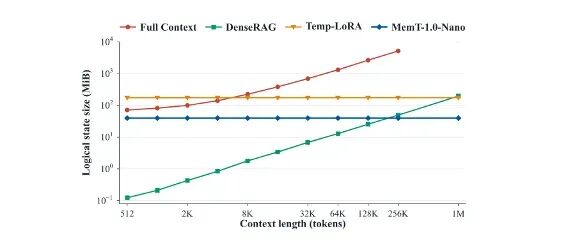 *每条交互轨迹的持久化存储占用结果
这些优势主要体现在长历史场景,短历史下 Nano 通常更慢。固定状态也意味着有限的信息容量;总存储仍随会话数量和配置容量增长。上述效率实验不能直接等同于编程任务成本下降,经验写入和额外验证仍有开销。
局限性与未来计划
我们看到,记忆原生模型的固定容量记忆需要在保留早期细节与接纳新信息之间权衡,精确信息的长期保真仍是挑战。当前经验应用还依赖外部经验构建和检索,尚未形成自主获取、验证并持续整合经验的完整闭环。 下一步,我们将提升长期记忆、扩展记忆容量,并降低记忆更新成本。还将进一步探索自主获取经验,以及跨任务持续整合记忆,逐步迈向能够通过记忆原生演进、从交互中学习的智能体。 记忆原生为持续学习及递归自我改进(RSI)提供基础,反馈、验证与更新机制仍需共同发展。
更多了解
参数塑造模型的能力起点,记忆打开智能的成长空间。 欢迎开发者与研究者了解 MemT 1.0 的模型,探索记忆原生的无限可能。 https://huggingface.co/collections/MemTensor/memt-1
本文由 Hugging Face 中文社区内容共建项目提供,稿件由社区成员投稿,经授权发布于 Hugging Face 公众号。文章内容不代表官方立场,文中介绍的产品和服务等均不构成投资建议。了解更多请关注公众号
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢