

关键词:具身智能; 视觉-语言-动作模型; 表征对齐
导 读
本文是对发表于机器人学习领域顶级会议 CoRL 2026 的论文 Semantic Anchoring for Robotic Action Representations 的解读。该论文由北京大学王亦洲课题组与宁波东方理工大学、上海交通大学合作完成。
预训练视觉—语言—动作(VLA)模型从视觉语言模型(VLM)中继承了丰富的语义表示,但这一结构可能在下游有限机器人示范数据的微调中逐渐退化。一个基础问题由此浮现:什么样的动作表示才是好的动作表示?受镜像神经元理论“观察与执行共享意图层面编码”这一洞见的启发,本工作检验了机器人的动作表示是否保留了预训练编码器所刻画的语义结构。系统性的探测表明,这一结构在微调过程中不断被侵蚀,而其质量与任务成功和分布外泛化均密切相关。
基于这一发现,本文进一步提出了一种在训练时将动作表示锚定到语义流形的方法,并将表示分解为共享语义通道与私有通道;所有辅助模块在推理时全部丢弃,部署模型保持不变。该方法在不同架构的 VLA 骨干、仿真与真实世界基准上得到验证,在真实分布内任务上最高带来 18.7% 的提升,在分布外泛化上最高带来 21.5% 的提升。
论文链接:
https://arxiv.org/abs/2607.13597
项目主页:
https://xy02-05.github.io/SemanticMN/
01
背景介绍
VLA 模型通过在机器人示范数据上微调预训练视觉语言模型(VLM)来构建通用机器人策略,原则上可以继承 VLM 中结构良好的语义表示,从而泛化到新物体、新场景和新指令。然而在实践中,下游微调所依赖的示范数据,其规模和多样性远小于 VLM 的预训练语料;仅以动作预测为目标的训练,可能使模型学到依赖表面线索的“捷径映射”,逐渐侵蚀继承而来的语义结构。一个更基本的问题由此浮现:什么样的动作表示才是好的表示?我们又如何判断它正在退化?
认知神经科学中的镜像神经元理论[1]为此提供了启发:灵长类大脑中,同一批神经元在观察和执行同一个目标导向动作时都会放电,并且这些神经元围绕“意图”组织,构成了意图层面的“运动词汇表”。近期的研究[2]进一步表明,这一机制在深度网络中同样存在:独立训练的动作理解模型与具身执行模型,其内部表征会自发对齐,且对齐程度与任务表现直接相关。类比到机器人学习,VLA 的动作表示不仅编码运动指令,还承载着模型对当前任务的理解——例如机器人正在拿起勺子、堆叠盘子,还是关上柜门。如果这种理解保持良好的组织,模型就能在相似任务之间迁移知识;一旦退化,模型就可能退回到依赖表面线索,失去泛化能力。
为了检验这一想法,本文设计了对齐探测框架:以独立预训练的文本编码器作为稳定的语义参照,在 π0 的完整 LIBERO 微调轨迹上追踪动作表示与指令嵌入之间的对齐程度。结果如图1所示:对齐度在微调早期急剧下降,之后仅部分恢复,训练后期再次下降,始终没有回到预训练水平;与此同时,分布内成功率几乎单调上升,而分布外成功率却与对齐度呈现出相似的先升后降趋势。进一步在单条轨迹层面分析,成功轨迹的对齐指标也系统性地高于失败轨迹。这些结果说明:仅以动作为监督的微调,会逐渐侵蚀从预训练继承的意图层面语义结构,而这一结构的质量与模型表现密切相关;因此,在微调中主动保留这一结构,有望得到更好的策略。
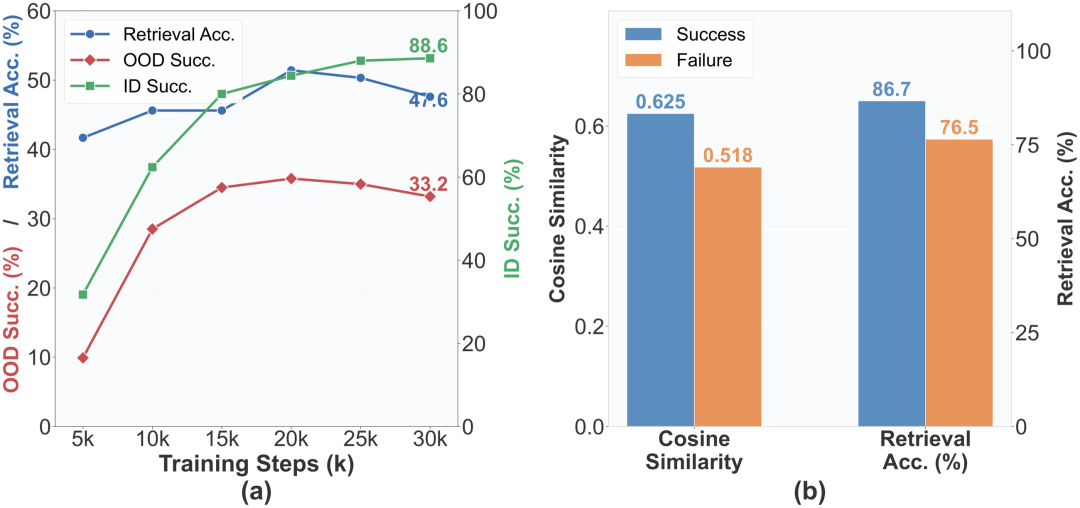
图1. LIBERO 上的对齐探测结果。
02
方法概览
语义锚定的整体框架如图2所示:在原有动作损失之外,引入一条只在训练阶段存在的辅助分支,一方面为动作表示提供稳定的任务语义参照,另一方面为动作执行所需的细节保留表达空间。具体包含两个关键设计。
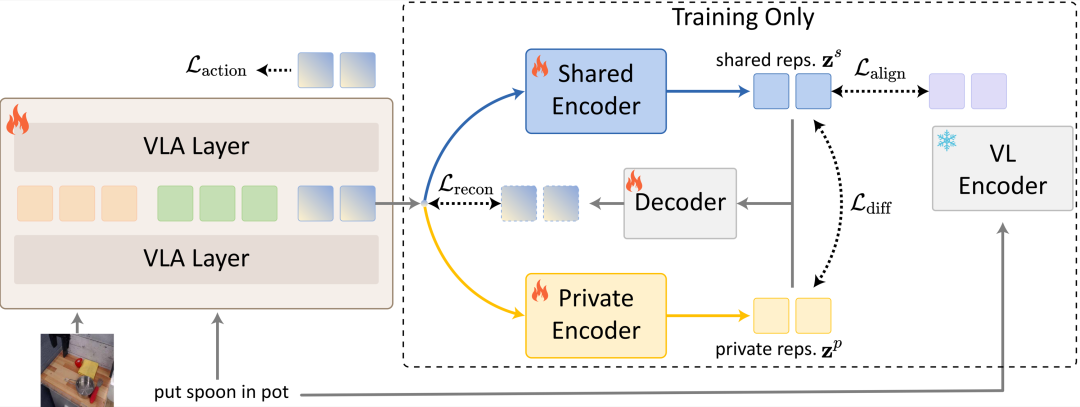
图2. 方法概览。
第一是将动作特征锚定到语义流形。如果以正在微调的 VLA 自身语言通路作为参照,参照本身也会随训练而退化;因此方法选用冻结的高质量外部文本编码器,把语言指令映射到稳定的语义空间,作为语义流形的具体代理。训练时,方法在主干网络中间层提取动作 token 的隐藏状态,通过注意力聚合得到整体表示,再与指令嵌入进行对比学习:同一任务的指令作为正样本,批次内其他任务的指令作为负样本。对齐梯度经投影头回传至主干中间层来影响动作表示。
第二是共享—私有分解。语义对齐希望表示对表面变化保持不变,而动作预测要求对物体位置、机械臂姿态等物理细节保持敏感,这对矛盾单靠损失加权难以化解。方法借鉴 Domain Separation Networks[3],将聚合后的动作特征分解为两个通道:共享通道编码意图层面的语义,只有它参与语义对齐;私有通道则保留机体几何、时序与运动细节等执行所需的信息。重建损失保证两个通道共同保留原始特征,角度去相关惩罚防止二者重新纠缠。最终的训练目标是动作损失与对齐、重建、去相关三项之和;部署时所有辅助模块全部丢弃,推理过程与仅用动作损失训练的基线完全相同,不增加任何开销。
03
实验结论
仿真评测覆盖两个基准:LIBERO 每个任务提供 50 条示范,考察小数据下的近分布能力;SimplerEnv 则在大规模真实机器人数据集 BridgeData V2 上微调后于仿真中评测,包含从真实到仿真的域偏移。实验选取了三种架构互异的骨干:π0、SpatialVLA 和 GR00T N1.6,均沿用各自官方的动作目标,仅额外添加对齐目标。
如表1所示,在 LIBERO 上语义锚定将 π0的平均成功率从 88.5% 提升至 90.8%,四个任务套件全部改善,说明对齐目标并不会损害分布内的任务表现;在 SimplerEnv 上,三种骨干分别提升 7.7、7.2 和 5.6 个百分点,说明这一收益能够跨动作建模架构迁移。
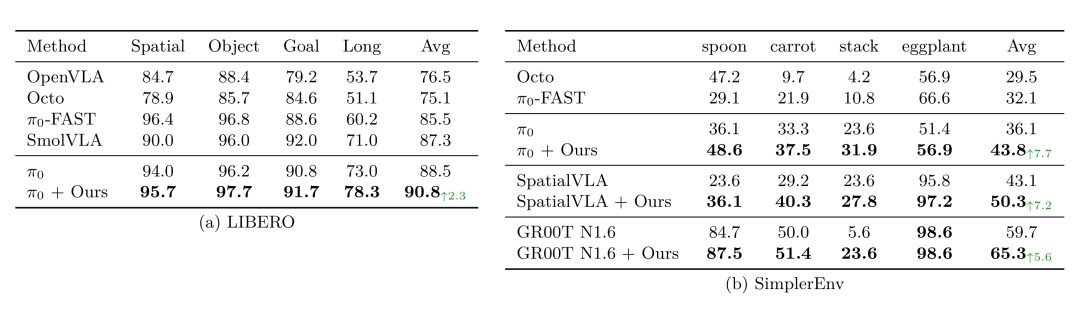
表1. 仿真成功率(%)。(a) LIBERO;(b) SimplerEnv。加粗表示优于对应基线。
实机实验在双臂 AgileX Cobot Magic V2 平台上进行,该平台配备两条 6 自由度机械臂和三个 RGB 相机。实验设计了四类任务。结果如图3所示:在四类分布内任务上,语义锚定将平均成功率从 51.3% 提升至 70.0%。在取放任务上,实验进一步沿语言改写、位置变化、新物体、视觉干扰和未见任务组合五个轴评测分布外泛化,平均成功率从 49.5% 提升至 71.0%。
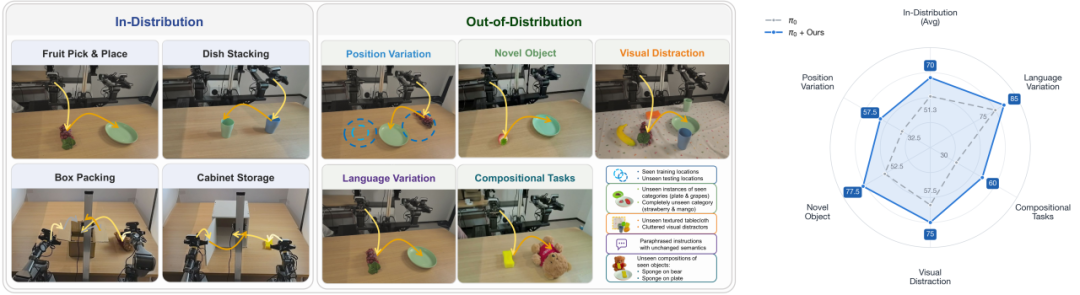
图3. 实机实验与结果。
在五类泛化测试中,未见任务组合尤其能体现“识别物体”与“理解任务关系”的区别:海绵和玩具熊都在训练中出现过,但“把海绵放到玩具熊上”是从未见过的搭配,机器人必须根据当前指令重新确定操作对象和放置目标。如图4所示,π0 基线经常无法理解新组合,出现停滞或抓取无关物体;加入语义锚定后,策略能够正确识别目标物体,并选择合适的机械臂完成放置。
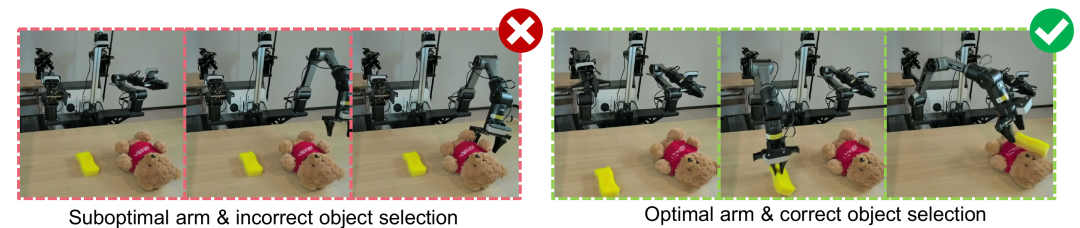
图4. 未见任务组合对比,指令为“将海绵放到玩具熊上”。左:π0 基线;右:Ours。
消融实验结果显示:仅加入对比对齐就能明显提升基线,再加入共享—私有分解后效果进一步改善;在对齐目标的选择上,具备视觉接地的编码器优于纯语言编码器,而在操作视频上预训练的编码器又优于更大规模的通用编码器;对齐层的扫描则表明,中间层(k=10)的语义结构质量最高,收益也最大。
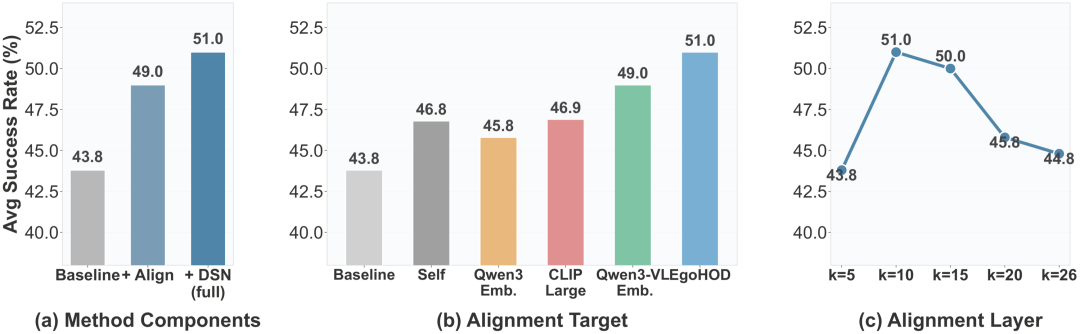
图5. 消融实验。(a) 方法组件;(b) 对齐目标编码器;(c) 对齐层 k。
04
总 结
本工作从动作表示的语义结构出发,揭示了一个容易被分布内成功率掩盖的现象:仅以动作为监督的 VLA 微调,会逐渐侵蚀从预训练继承的意图层面语义结构,而这一结构的质量与模型的表现密切相关。在镜像神经元理论的启发下,本文提出了语义锚定方法,训练时将动作表示锚定到稳定的语义流形,并以共享—私有分解兼顾执行细节,所有辅助模块在推理时移除,不增加部署开销。仿真与真实双臂机器人上的实验表明,该方法能为不同架构的 VLA 带来一致的性能提升。未来工作将探索把语义对齐扩展到 VLA 预训练阶段,并扩展到更广泛的数据源,迈向更可泛化的机器人操作。
参考文献
[1] Giacomo Rizzolatti and Laila Craighero. The Mirror-Neuron System. Annual Review of Neuroscience, 27:169–192, 2004.
[2] Wentao Zhu, et al. Embodied Representation Alignment with Mirror Neurons. ICCV, 2025.
[3] Konstantinos Bousmalis et al. Domain Separation Networks. NeurIPS, 2016.
图文 | 许苑
Computer Vision and Digital Art (CVDA)
About CVDA
The Computer Vision and Digital Art (CVDA) research group was founded in 2007 within the National Engineering Research Center of Visual Technology at Peking University led be Prof. Yizhou Wang. The group focuses on developing computational theories and models to solve challenging computer vision problems in light of biologically plausible evidences of visual perception and cognition. The primary goal of CVDA is to establish a mathematical foundation of understanding the computational aspect of the robust and efficient mechanisms of human visual perception, cognition, learning and even more. We also believe that the marriage of science and art will stimulate exciting inspirations on producing creative expressions of visual patterns.
CVDA近期科研动态
ICLR 2026 | 交互的两个大模型,内部表征会“同步”?

— 版权声明 —
本微信公众号所有内容,由北京大学前沿计算研究中心微信自身创作、收集的文字、图片和音视频资料,版权属北京大学前沿计算研究中心微信所有;从公开渠道收集、整理及授权转载的文字、图片和音视频资料,版权属原作者。本公众号内容原作者如不愿意在本号刊登内容,请及时通知本号,予以删除。
点击“阅读原文”转论文链接
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢