

---------------------
课程 | 2026年斯坦福CS 329Z《Agent工程》| 第2讲:给开发者的LLM原理
课程 | 2026年斯坦福CS 329Z《Agent工程课》| 第1讲:智能体系统入门
---------------------
这是「斯坦福 Agent 工程课」系列的第 3 篇。课程是 Stanford 2026 年秋季的 CS 329Z《Engineering AI Agents》,讲师是 Diyi Yang、Michael Ryan 和 John Yang。课件在课程官网公开,我每讲写一篇,按课件逐页讲,一页不跳。
第 3 讲在官网课表上是 9 月 30 日,标题是「Retrieval-Augmented Generation (RAG)」,课件封面写的是 RAG + Agents,主讲是 Diyi Yang,一共 63 页。课件右下角印的页码从第 21 页起比 PDF 多 1,本文的页码一律按 PDF 算。
这一讲要回答的问题,写在第 9 页的学习目标里:RAG 的流程是怎么搭起来的,会在哪里出问题,该给什么建索引,又该怎么搜。
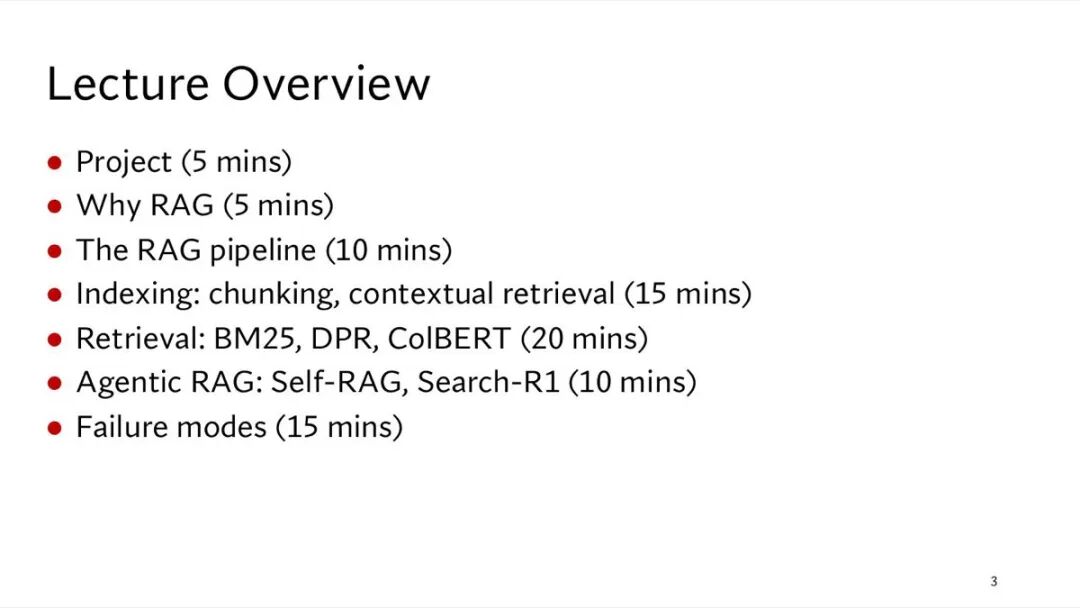
下面是这一讲的大纲,一共七块:课程项目,为什么要 RAG,RAG 的流程,建索引,检索,Agentic RAG,失败模式。每块后面的括号是课上分给它的分钟数。后文按这个顺序走。
开场
开场两页是封面和课程通知,交代了接下来两周的几个日期。
第 1 页是封面,课程名下面是这一讲的标题 RAG + Agents,讲师一栏只有 Diyi Yang。封面页没有别的信息,并进这里一起讲。
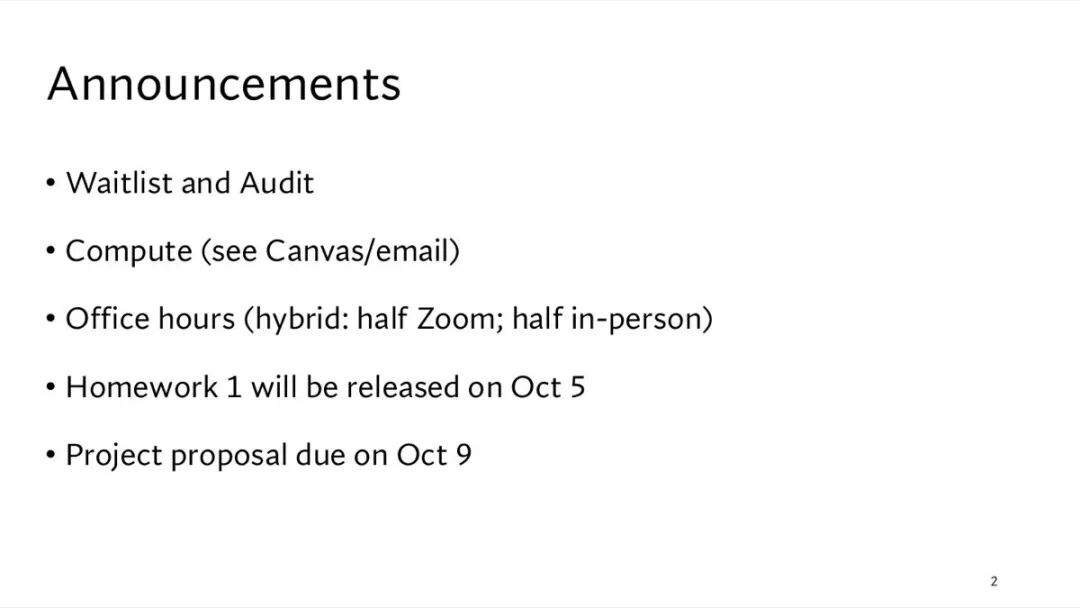
第 2 页是通知,五条。候补和旁听的事项。算力资源见 Canvas 和邮件。office hours 改成混合形式,一半在 Zoom 上,一半线下。作业 1 在 10 月 5 日发布。项目开题报告 10 月 9 日截止。
第 3 页是大纲,已经放在本文开头。
一、课程项目
项目要自己设计,搭建并评估一个 agent 系统;课件要求评估做得严格,只跑通一次的 demo 拿不到高分。
第 4 页让学生挑一个自己感兴趣的题目,列了五个要先想清楚的问题:你的 agent 做什么任务?背后是什么研究问题?需要哪些数据或 API?用哪些框架?怎么评估?
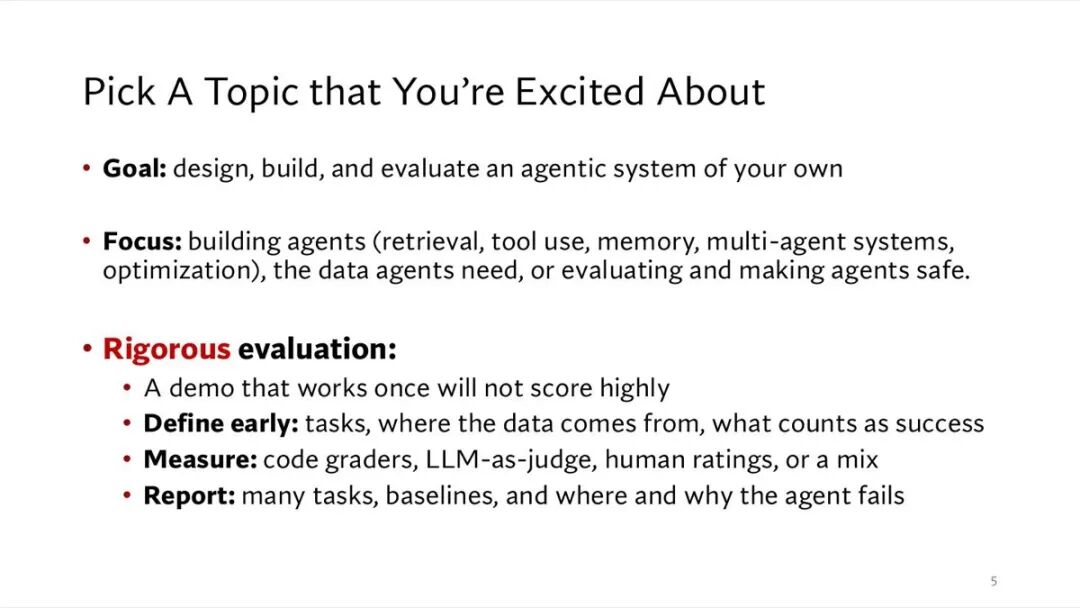
第 5 页把项目要求说得更具体。目标是设计,搭建和评估一个你自己的 agent 系统。重点可以放在三类方向上:搭 agent 本身,包括检索,工具使用,记忆,多 agent 系统和优化;agent 需要的数据;或者评估 agent,让 agent 更安全。
这一页把「严格」一词标成红色,后面跟着「评估」,下面有四条。只跑通一次的 demo 拿不到高分。要尽早定义清楚:任务是什么,数据从哪里来,什么算成功。衡量的办法可以是代码评分器,LLM 当裁判,人工打分,或者混着用。报告里要有很多个任务,要有基线,还要说清 agent 在哪里失败,为什么失败。
补充「LLM 当裁判」(LLM-as-judge)是让一个语言模型按评分标准去给另一个系统的输出打分。官网课表上 11 月 9 日那一讲专门讲这个话题。
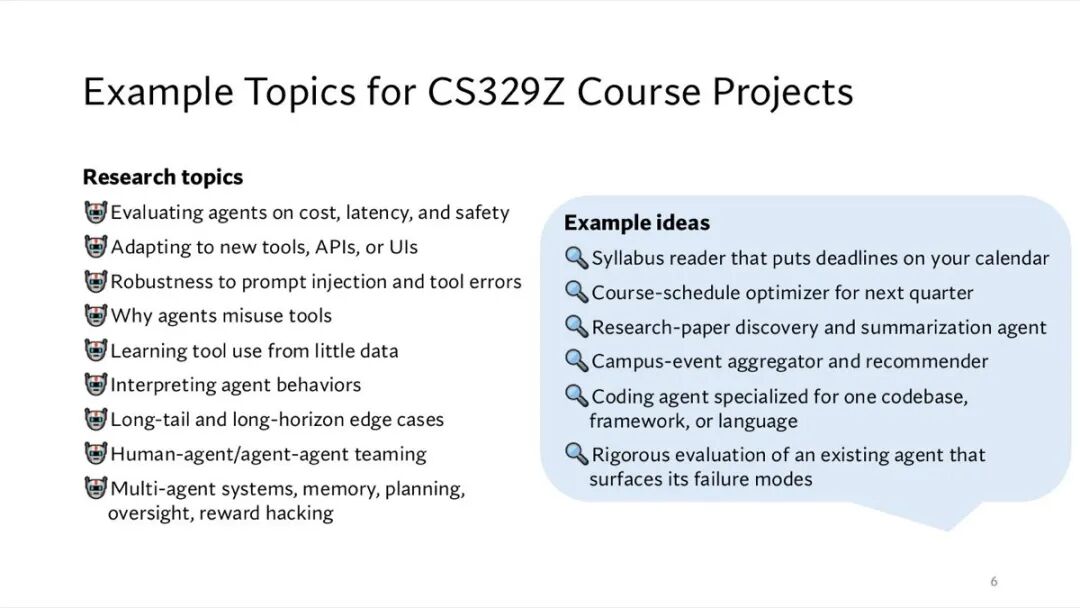
第 6 页是项目题目的例子,分两栏。
左栏是研究方向,九条:在成本,延迟和安全上评估 agent;适应新的工具,API 或界面;对提示注入和工具报错的鲁棒性;agent 为什么会用错工具;从少量数据里学会用工具;解释 agent 的行为;长尾和长周期任务里的边界情况;人和 agent 协作,以及 agent 之间协作;多 agent 系统,记忆,规划,监督,奖励投机。
右栏是具体点子,六条:读课程大纲,把截止日期放进日历的 agent;给下一学季排课的优化器;发现论文并做总结的 agent;校园活动的汇总和推荐;专门针对一个代码库,框架或语言的编程 agent;对一个现成的 agent 做严格评估,把它的失败模式找出来。
补充提示注入(prompt injection)指的是在 agent 会读到的内容里藏进指令,让 agent 去做用户没让它做的事。奖励投机(reward hacking)指的是模型找到了拿高分的捷径,分数上去了,任务本身没做好。
第 7 页是组队和要考虑的事。建议 1 到 3 人一组。组员之间要把分工划清楚。有需要就联系教学团队。可以和旁边的同学聊,也可以用 Ed Discussion 讨论区。要考虑数据,agent 框架,算力和评估手段是不是拿得到。最后一条用红字写着:项目点子的例子这周晚些时候发出来。
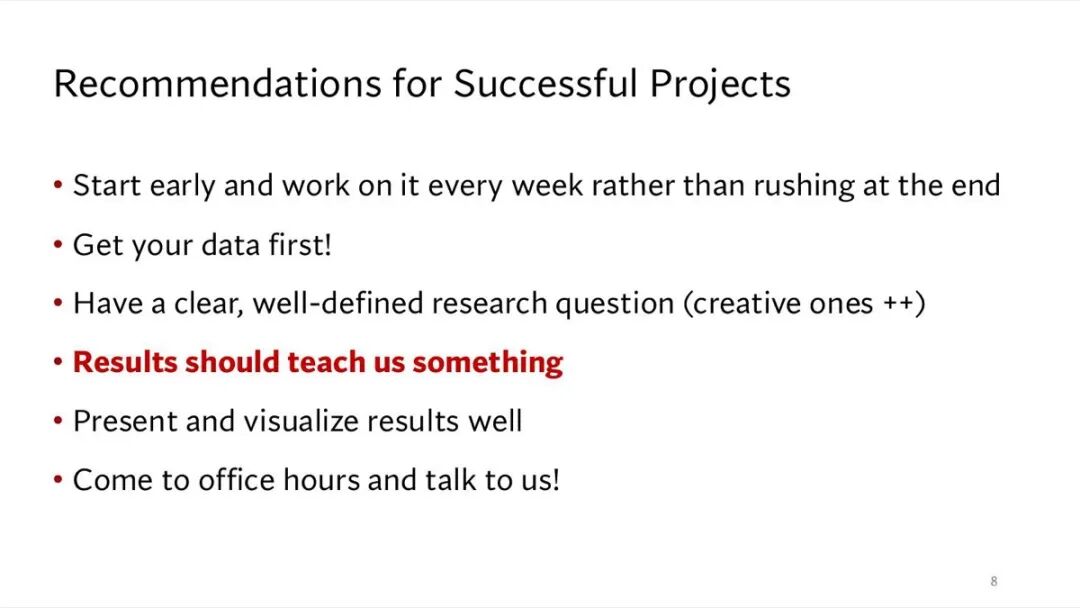
第 8 页是项目成功的建议,六条。早点开始,每周推进,不要最后赶工。先把数据拿到手。要有一个清楚,定义明确的研究问题,有创意的加分。用红色加粗的一条是:结果要能让我们学到点东西。结果要好好呈现,做好可视化。来 office hours 找我们聊。
二、为什么要 RAG
语言模型自己记不住所有东西,也记不住新东西;检索让它在回答前先查到相关内容,而且能指出答案出自哪份文档。
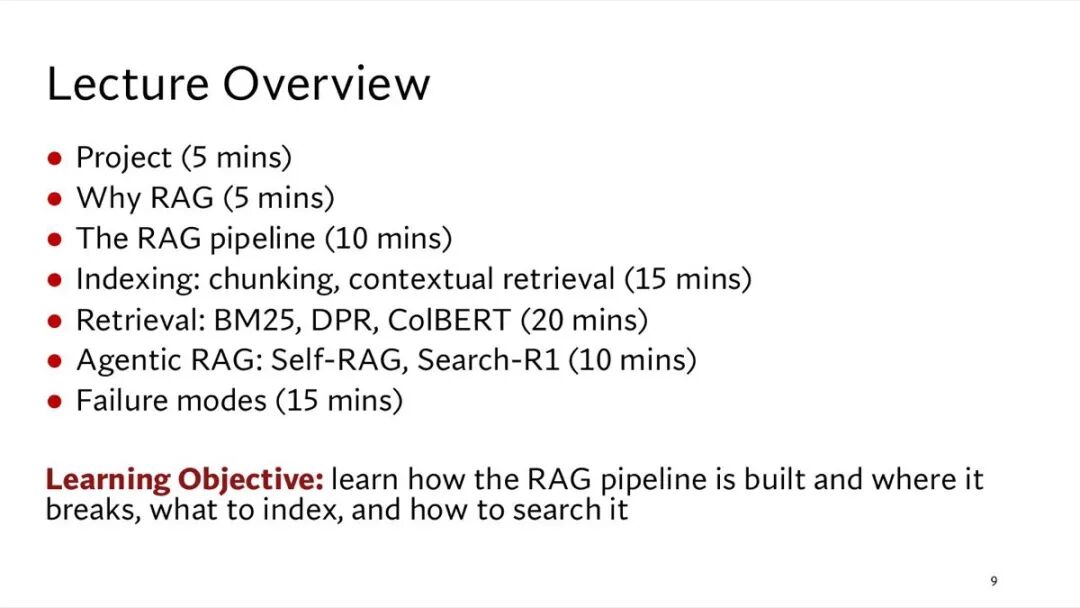
第 9 页又是一次大纲,这次多了学习目标那一句,也就是本文开头引的那句:学会 RAG 的流程怎么搭,在哪里出问题,该给什么建索引,怎么搜。
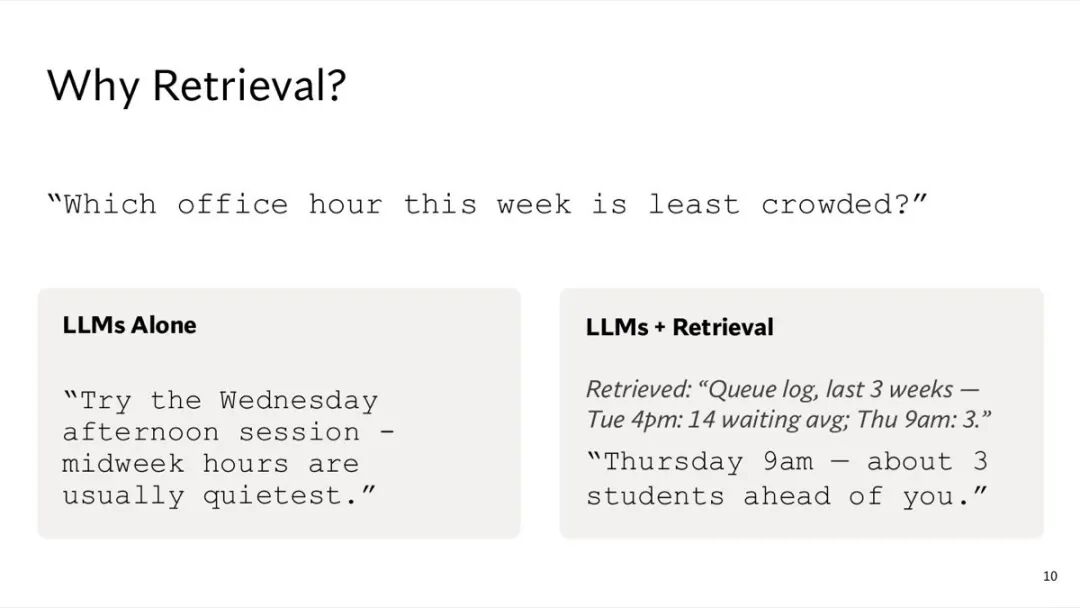
第 10 页用一个课程里的问题开场:「这周哪一场 office hours 人最少?」
左边是只靠 LLM 的回答:「试试周三下午那场,一周中间的时段通常最清静。」
右边是 LLM 加上检索。先检索到一条记录:「排队日志,最近 3 周:周二下午 4 点平均 14 人在等;周四上午 9 点,3 人。」然后回答:「周四上午 9 点,你前面大约 3 个学生。」
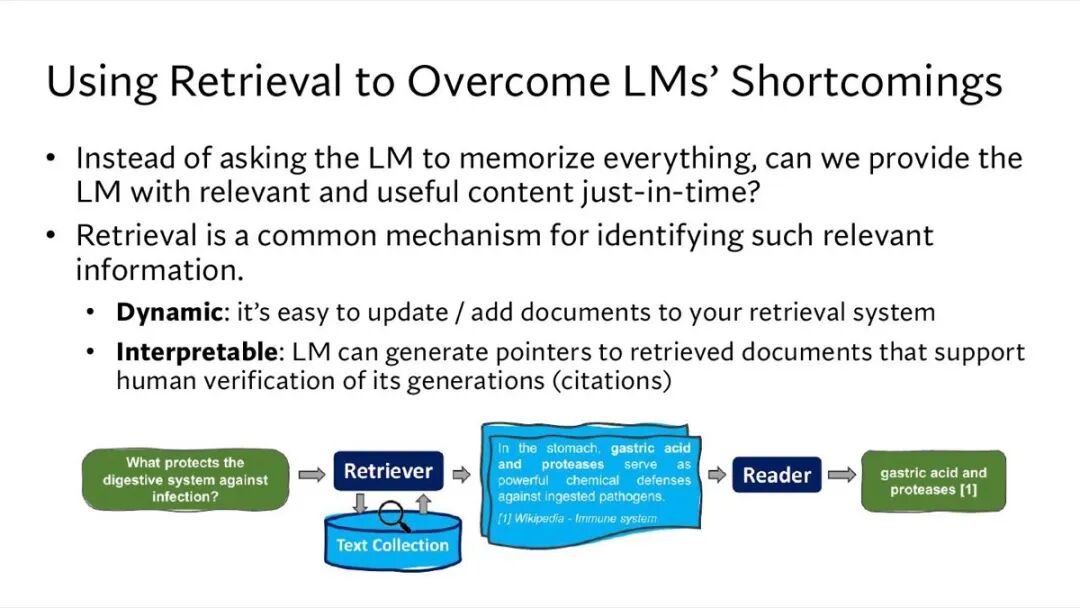
第 11 页讲用检索弥补语言模型的不足。与其让语言模型把所有东西都背下来,能不能在需要的时候,把相关又有用的内容及时递给它?检索就是找出这类内容的常用办法。课件列了它的两个好处。
一是动态:往检索系统里更新或添加文档很容易。
二是可解释:语言模型可以给出指向检索文档的引用,方便人去核对它生成的内容。
页面底部是一条流程图。问题是「什么在保护消化系统不受感染?」,先进检索器,检索器从文本库里取回一段话:「在胃里,胃酸和蛋白酶是抵御摄入病原体的强力化学防线。」这段话标着出处 [1] Wikipedia 的 Immune system 词条。这段话再交给阅读器,最后输出的答案是「胃酸和蛋白酶 [1]」,带着引用编号。
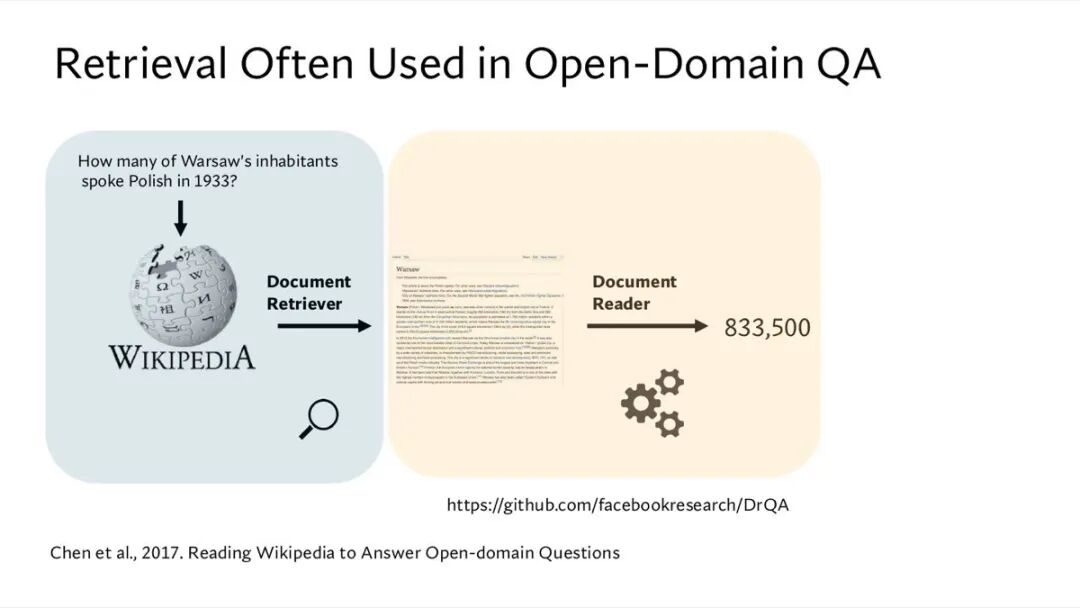
第 12 页说检索常用在开放域问答上,例子来自 Chen 等人 2017 年的论文《Reading Wikipedia to Answer Open-domain Questions》,系统叫 DrQA,课件附了它的 GitHub 地址。
问题是「1933 年华沙有多少居民说波兰语?」。左半边是文档检索器,从维基百科里找出相关的文章;右半边是文档阅读器,从找到的文章里读出答案:833,500。
补充开放域问答指的是问题不限定范围,也不提前给出包含答案的文章,系统要自己去一个大文档库里找。
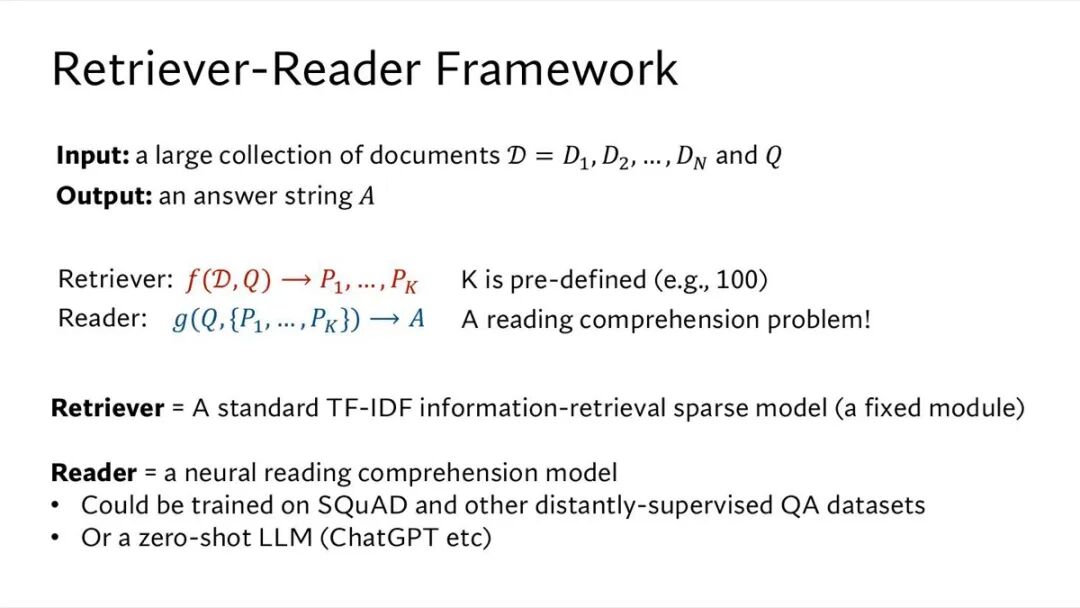
第 13 页把上一页的做法写成一个框架,叫检索器加阅读器。
输入是一大批文档 D1 到 DN,加上一个问题 Q;输出是一个答案字符串 A。
检索器是一个函数,输入文档库和问题,输出 K 段文字 P1 到 PK,K 是事先定好的,比如 100。阅读器是另一个函数,输入问题和这 K 段文字,输出答案 A。课件在旁边注了一句:这就是一个阅读理解问题。
课件写的检索器是一个标准的 TF-IDF 稀疏检索模型,是固定的模块。阅读器是一个神经网络阅读理解模型,可以在 SQuAD 和其他远程监督的问答数据集上训练;课件还写了另一种做法,直接用一个零样本的 LLM,比如 ChatGPT。
补充TF-IDF 按词打分:一个词在这篇文档里出现得越多,在整个文档库里越少见,它对这篇文档的分就越高。「稀疏」是说每篇文档表示成一个很长的向量,每一维对应词表里的一个词,绝大多数维度是 0。SQuAD 是 Stanford 的阅读理解数据集,给一段维基百科文章和一个问题,答案是文章里的一段原文。
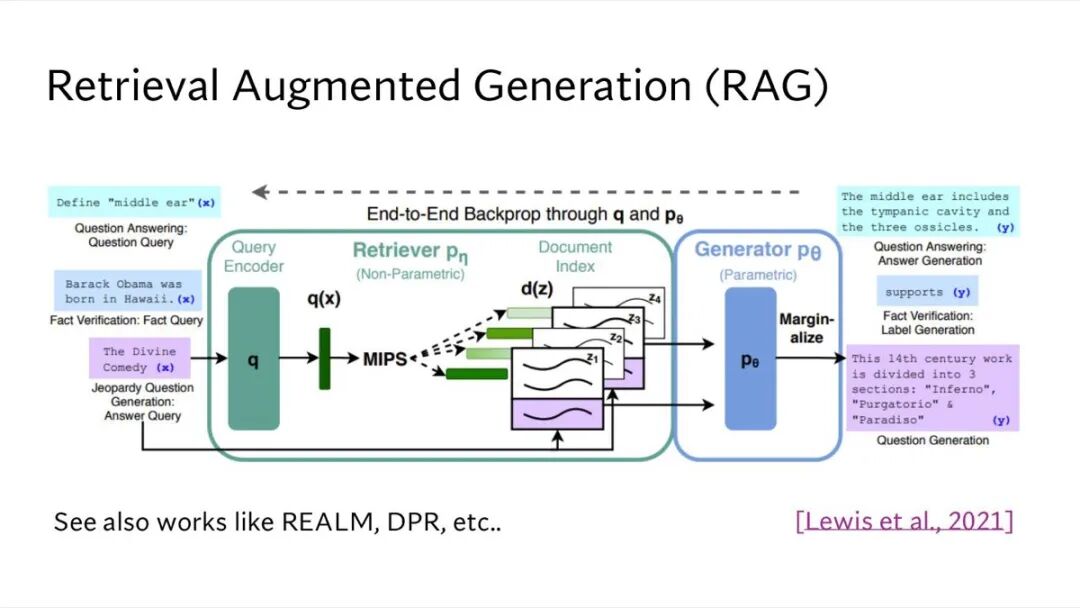
第 14 页是 RAG 这个名字的出处,图来自 Lewis 等人的论文,课件标的年份是 2021,旁边写着:另见 REALM,DPR 等工作。
图从左往右读。左边是三种任务的输入:问答任务的问题,例如「给『中耳』下定义」;事实核查任务的陈述,例如「奥巴马生于夏威夷」;Jeopardy 出题任务的答案,例如「神曲」。
输入先进查询编码器,得到向量 q(x)。检索器 p_η 是「非参数」的,它拿 q(x) 去文档索引里做 MIPS 搜索,取回几篇文档 z1 到 z4,每篇文档有自己的向量 d(z)。这些文档交给生成器 p_θ,生成器是「参数」的,生成结果再做一步边缘化,得到输出。
右边是三种任务的输出:问答的答案「中耳包括鼓室和三块听小骨」;事实核查的标签「supports」,也就是支持;Jeopardy 出的题是「这部 14 世纪的作品分为三部分:地狱,炼狱,天堂」。
图底部还有一条线,把原始输入 x 也送进生成器,和取回的文档一起用,第 19 页会讲到拼接。图上方有一条虚线箭头,写着:端到端反向传播,经过 q 和 p_θ。也就是说训练时查询编码器和生成器一起更新。
补充「参数」和「非参数」是论文自己的说法。参数记忆指的是存在模型权重里的知识;非参数记忆指的是外挂的文档索引。它的好处是,换一批文档就换了知识,不用重新训练。MIPS 是最大内积搜索,第 18 页会讲。课程官网把这篇论文列为本讲必读,版本是 NeurIPS 2020。
三、RAG 的流程
RAG 由检索器和生成器两部分组成,可以一起训练;在开放域问答上它比只靠模型参数的做法好,后来又发展出加了前后处理和模块化的变体。
第 15 页是大纲,第一项「为什么要 RAG」变灰,进入「RAG 的流程」。从这一页起,大纲不再列「课程项目」那一项。
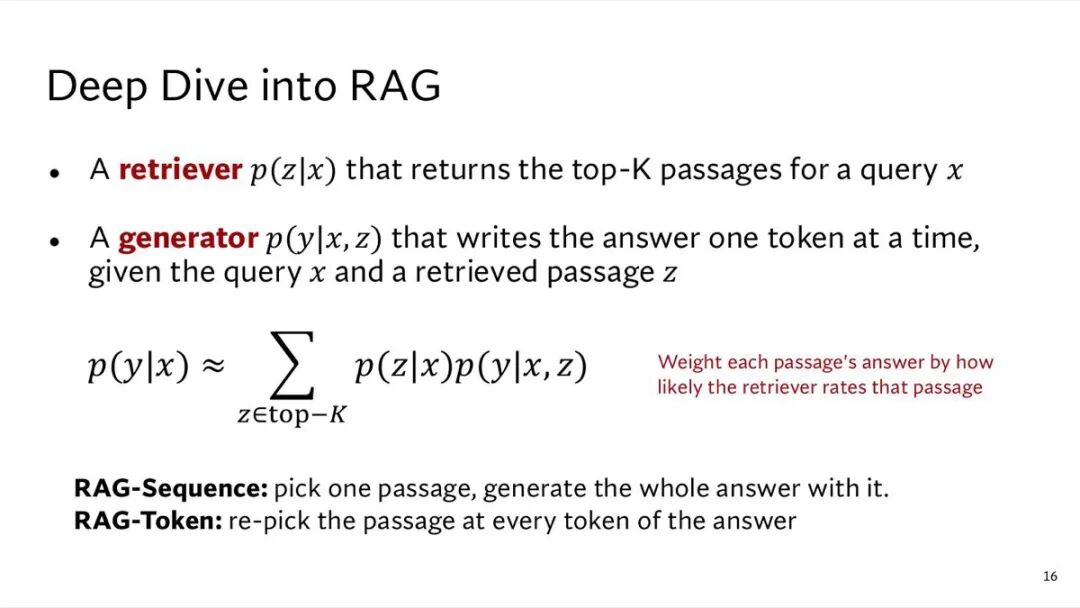
第 16 页把 RAG 拆开看。两个部件。
检索器 p(z|x):给一个查询 x,返回前 K 段文字。
生成器 p(y|x,z):给定查询 x 和一段检索到的文字 z,一个 token 一个 token 地写出答案。
两者合起来,答案 y 的概率近似等于对前 K 段文字求和,每一段的贡献是「检索器给这段的概率」乘以「用这段文字生成答案 y 的概率」。课件用红字解释了这个公式:每段文字生成的答案,按检索器对这段文字的打分来加权。
下面是两种做法。RAG-Sequence:挑一段文字,用它生成整个答案。RAG-Token:答案的每个 token 都重新挑一次文字。
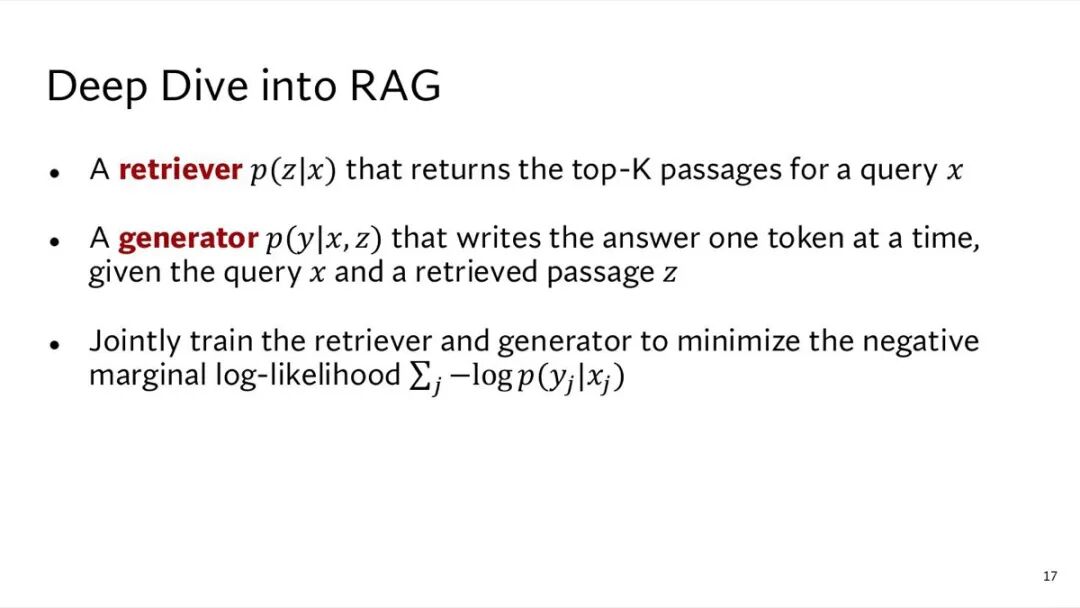
第 17 页在上一页基础上多了第三条:检索器和生成器一起训练,目标是让负的边缘对数似然最小。也就是对每个训练样本 j,让模型给正确答案 yj 的概率尽量高。
补充这里训练的只有正确答案,不需要标注「哪段文字是对的」。检索器是靠「它挑的文字能不能帮生成器写出正确答案」间接学习的。
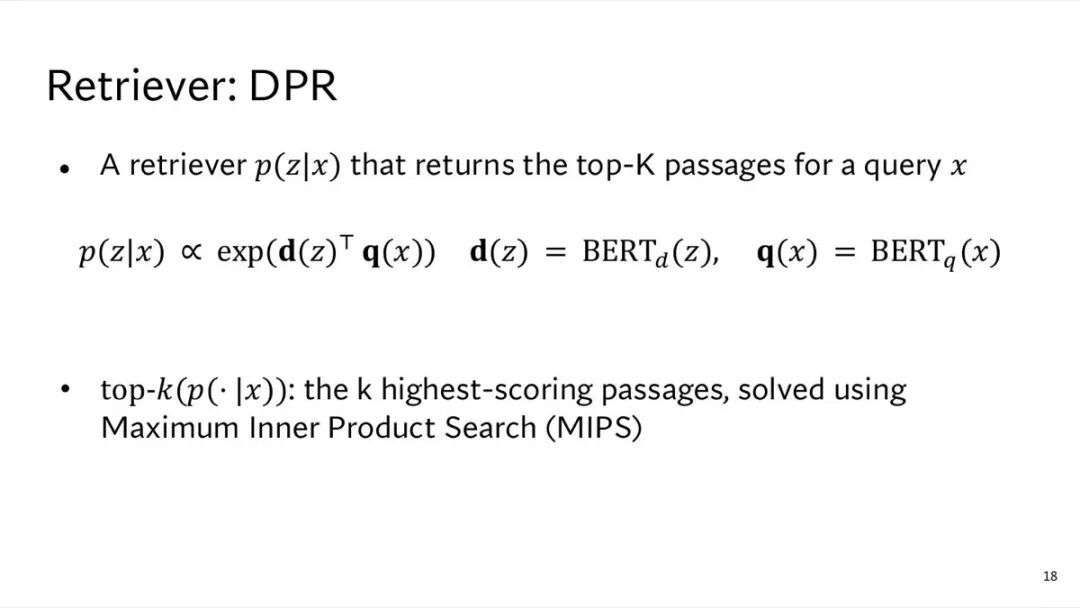
第 18 页讲检索器用的是 DPR。
一段文字 z 和查询 x 的匹配程度,正比于 exp(d(z)ᵀq(x))。d(z) 是用一个 BERT 把文字编码成的向量,q(x) 是用另一个 BERT 把查询编码成的向量,两个向量做内积。
前 k 个,就是打分最高的 k 段文字,用最大内积搜索(MIPS)来找。
补充BERT 是 Google 2018 年发布的编码器模型,能把一段文字变成向量。这里查询和文档用的是两个各自独立的 BERT,下标 q 和 d 就是区分这两个。
第 19 页讲生成器用的是 BART。生成器可以用任何一种编码器加解码器的模型来做。用 BART 生成时,查询 x 和检索到的文字 z 直接拼在一起作为输入。
补充BART 是 Facebook 2019 年发布的模型,编码器读入整段输入,解码器逐个 token 写出输出,常用来做摘要和问答。
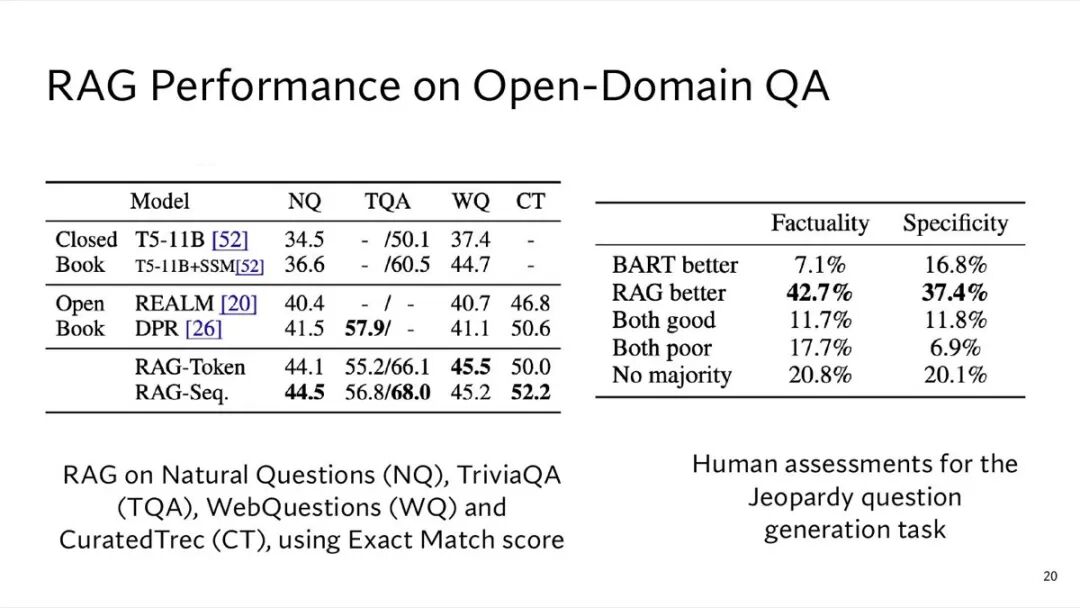
第 20 页是 RAG 在开放域问答上的成绩,两张表。
左表用精确匹配分数,数据集是 NQ,TriviaQA(TQA),WebQuestions(WQ)和 CuratedTrec(CT)。闭卷一栏是只靠模型参数作答的 T5-11B,NQ 34.5;加了 SSM 预训练的 T5-11B,NQ 36.6。开卷一栏是 REALM,NQ 40.4;DPR,NQ 41.5。RAG 两行在最下面:RAG-Token 的 NQ 是 44.1,RAG-Sequence 是 44.5。各列加粗的最好成绩是:NQ 是 RAG-Sequence 的 44.5,WQ 是 RAG-Token 的 45.5,CT 是 RAG-Sequence 的 52.2。TQA 一列有两个数,斜杠前最高的是 DPR 的 57.9,斜杠后最高的是 RAG-Sequence 的 68.0。
右表是 Jeopardy 出题任务上的人工评估,让人比较 BART 和 RAG 出的题。事实性一栏:认为 BART 更好的占 7.1%,认为 RAG 更好的占 42.7%,两个都好 11.7%,两个都差 17.7%,没有多数意见 20.8%。具体性一栏:BART 更好 16.8%,RAG 更好 37.4%。
补充TQA 一列有两个数,斜杠前后对应论文里 TriviaQA 的两种测试集划分。闭卷指的是不查任何资料、只靠训练时记进参数里的知识作答。
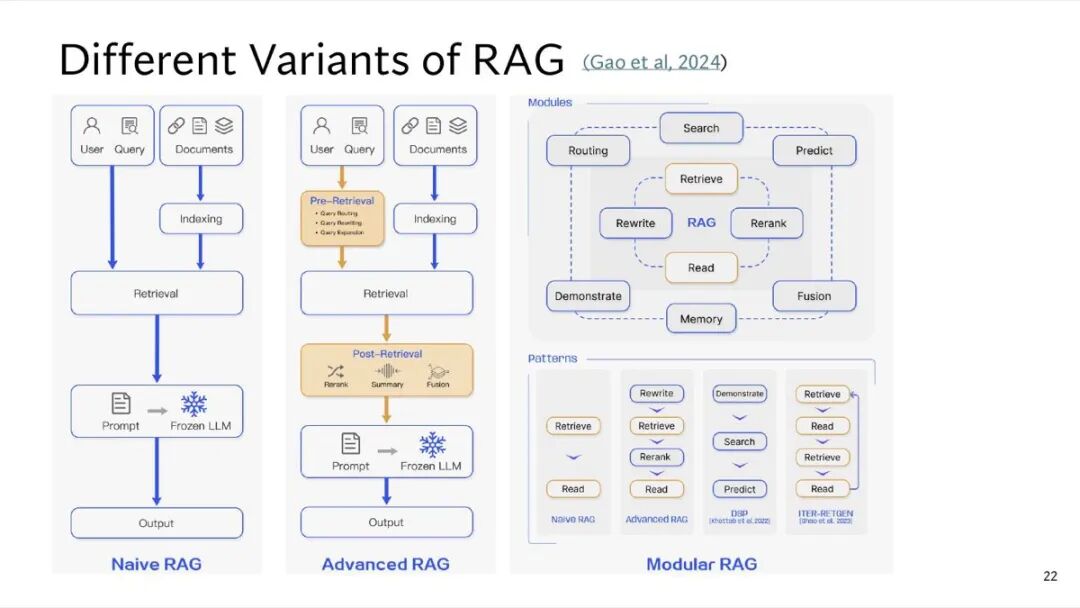
第 21 页是 RAG 的几种变体,图来自 Gao 等人 2024 年的综述,三栏。
朴素 RAG:文档先建索引;用户的查询去检索;检到的内容组成提示词,交给一个冻结的 LLM,输出答案。
进阶 RAG:在检索前加了一步预处理,图里列了查询路由,查询改写和查询扩展;在检索后加了一步后处理,包括重排序,摘要和融合。
模块化 RAG:把各个环节拆成模块,图里有搜索,路由,预测,检索,改写,重排序,阅读,示范,融合,记忆。下面列了几种把模块串起来的模式:朴素 RAG 是检索再阅读;进阶 RAG 是改写,检索,重排序,阅读;DSP 是示范,搜索,预测,出处标的是 Khattab 等人 2022 年;ITER-RETGEN 出处标的是 Shao 等人 2023 年,它是检索和阅读交替做两轮,最后一步阅读有箭头指回第一步检索。
补充「冻结」指的是 LLM 的权重不动,只改喂给它的内容。这和第 14 页那种一起训练检索器和生成器的做法不同。
四、建索引
建索引先要切块:块太小缺上下文,太大又混进好几个主题。课件讲了几种把上下文补回块里的办法;讲了在块之上建树或建图,用来回答需要综合全局的问题;还讲了怎样在大量向量里快速找到最近的那几个。
第 22 页是大纲,前两项变灰,进入「建索引:切块,上下文检索」。
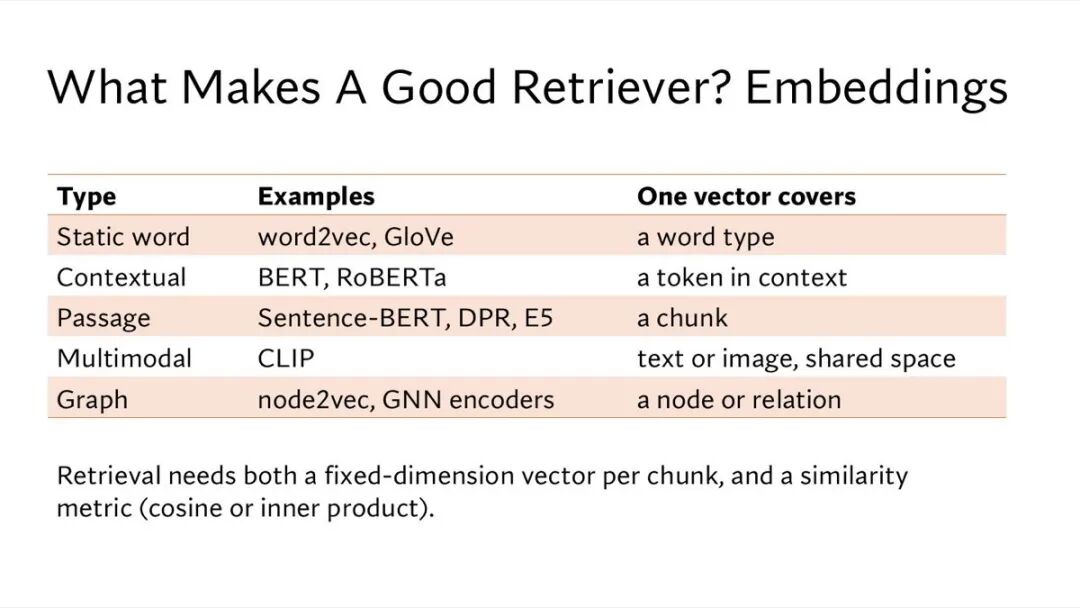
第 23 页问:什么样的检索器是好的检索器?先看 embedding,也就是把内容变成向量。课件列了五类。
静态词向量,例子是 word2vec 和 GloVe,一个向量对应一个词,不管上下文。上下文向量,例子是 BERT 和 RoBERTa,一个向量对应上下文里的一个 token。段落向量,例子是 Sentence-BERT,DPR,E5,一个向量对应一个块。多模态向量,例子是 CLIP,文字和图片在同一个空间里。图向量,例子是 node2vec 和图神经网络编码器,一个向量对应一个节点或一条关系。
表下面一句:检索需要两样东西,每个块一个固定维度的向量,再加一个相似度度量,余弦相似度或者内积。
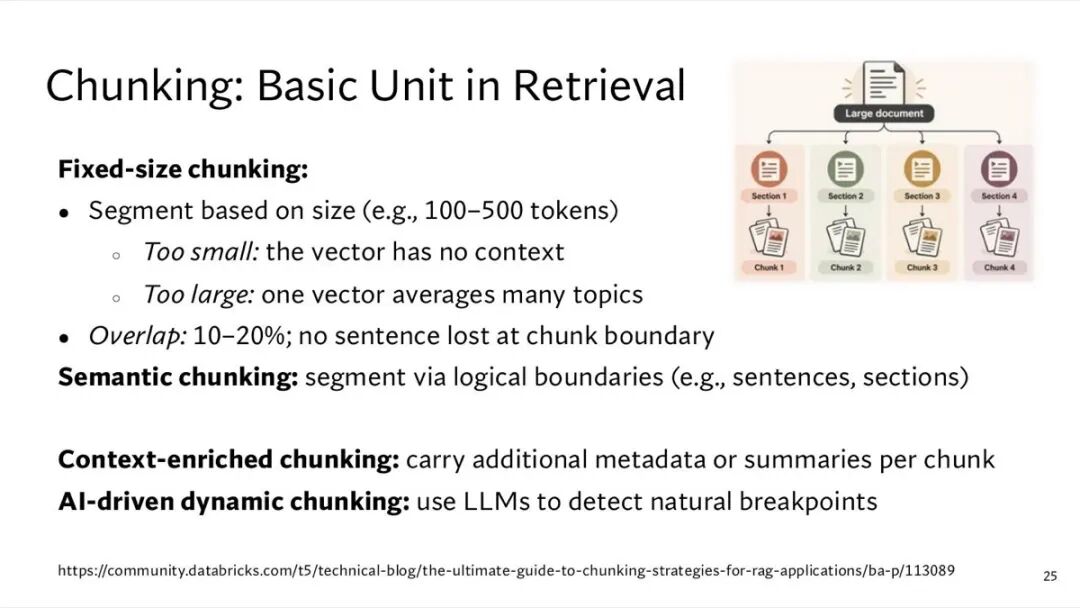
第 24 页讲切块,它是检索的基本单位。
固定大小切块:按长度切,比如 100 到 500 个 token。太小,向量里没有上下文;太大,一个向量把好几个主题平均到了一起。块与块之间重叠 10% 到 20%,这样不会有句子在边界上被切丢。
语义切块:按逻辑边界切,比如句子,章节。
加上下文的切块:每个块额外带上元数据或摘要。
AI 驱动的动态切块:用 LLM 找自然的断点。
这一页的出处是 Databricks 社区的一篇切块策略指南,链接在页面底部。
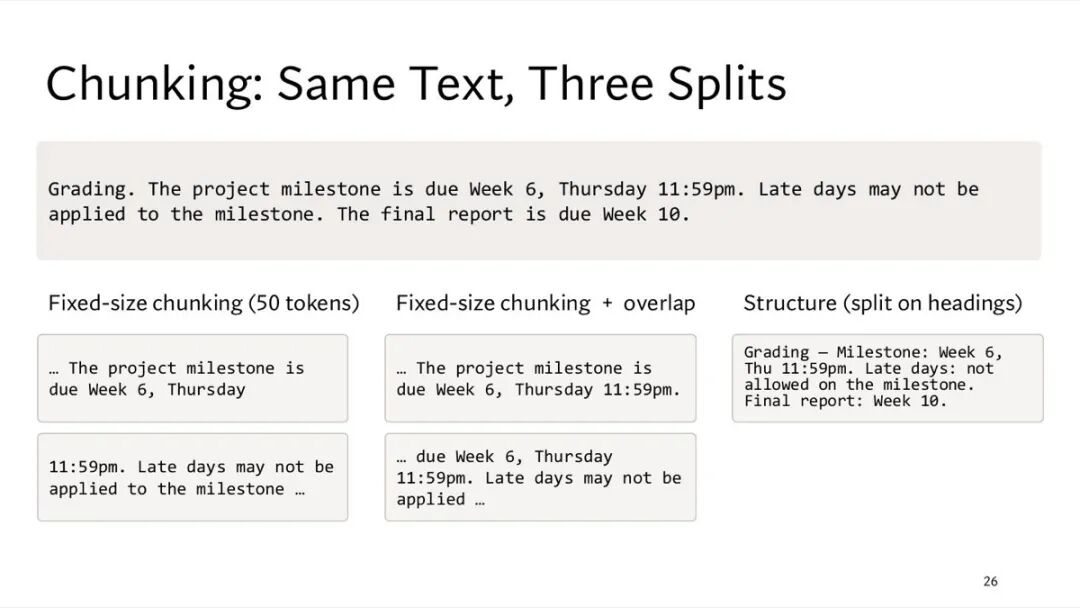
第 25 页用同一段文字演示三种切法。原文是一段课程评分说明:「评分。项目中期节点在第 6 周周四晚 11:59 截止。中期节点不能使用迟交天数。最终报告在第 10 周截止。」
第一种是固定 50 个 token 切块。第一块结尾是「项目中期节点在第 6 周周四」,第二块开头是「晚 11:59。中期节点不能使用迟交天数」。截止时间被切成了两半,查「中期节点几点截止」时,两块单独看都不完整。
第二种是固定大小加重叠。第一块结尾变成了「第 6 周周四晚 11:59」,第二块开头又重复了「第 6 周周四晚 11:59」。时间在两块里都是完整的。
第三种是按标题结构切,整段归在「评分」这个标题下,改写成了一张紧凑的清单:中期节点,第 6 周周四晚 11:59;迟交天数,中期节点不可用;最终报告,第 10 周。
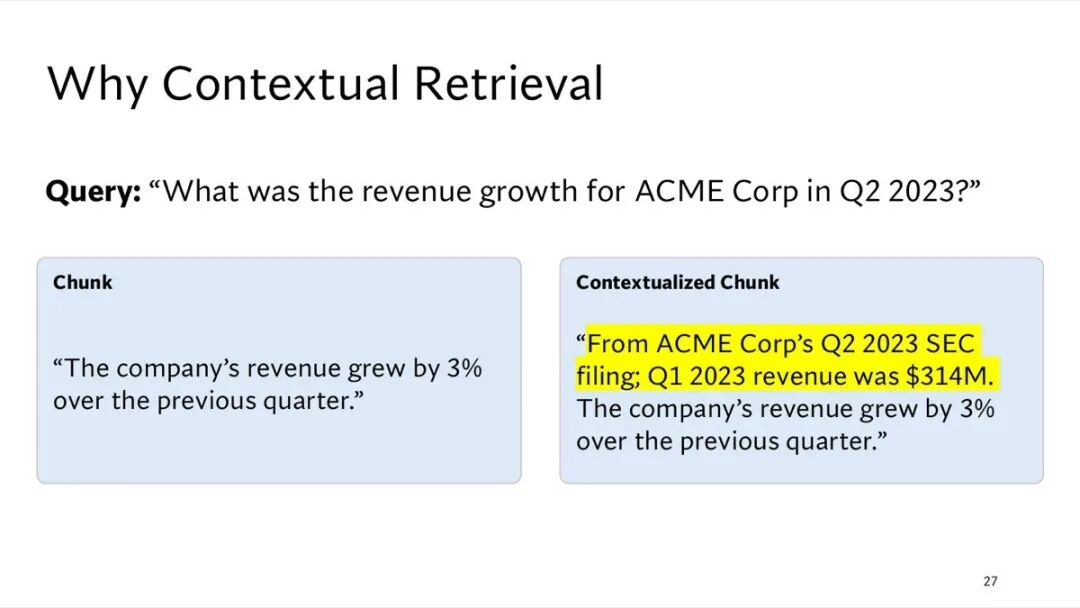
第 26 页说明为什么要做上下文检索。查询是「ACME 公司 2023 年第二季度的营收增长是多少?」
左边是原始的块:「公司营收比上一季度增长了 3%。」这个块里既没有公司名,也没有季度。
右边是加了上下文的块,开头多了一句黄色高亮的话:「出自 ACME 公司 2023 年第二季度的 SEC 文件;2023 年第一季度营收为 3.14 亿美元。」后面才是原来那句。
补充SEC 文件是美国上市公司向证券交易委员会提交的财报等公开文件。
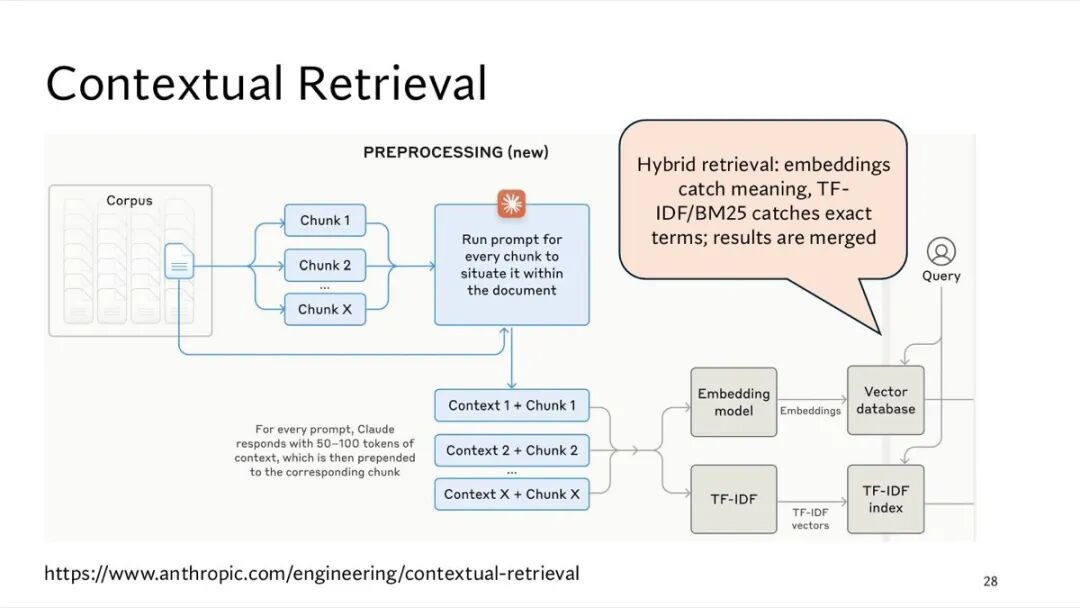
第 27 页是上下文检索的流程图,出自 Anthropic 的工程博客《Contextual Retrieval》,链接在页面底部。
图里标着「预处理(新增)」的部分是这样走的:文档库里的每篇文档先切成块 1 到块 X;对每个块跑一次提示词,让模型结合整篇文档给这个块配一段上下文;得到「上下文 1 + 块 1」到「上下文 X + 块 X」。图上的小字说:每次提示,Claude 返回 50 到 100 个 token 的上下文,接在对应的块前面。
这些加了上下文的块走两条路:一条进 embedding 模型,存进向量数据库;一条算 TF-IDF,存进 TF-IDF 索引。用户的查询同时去两个库里查。
页面上的气泡写着:混合检索,embedding 抓的是意思,TF-IDF 或 BM25 抓精确的词,两边的结果合并。
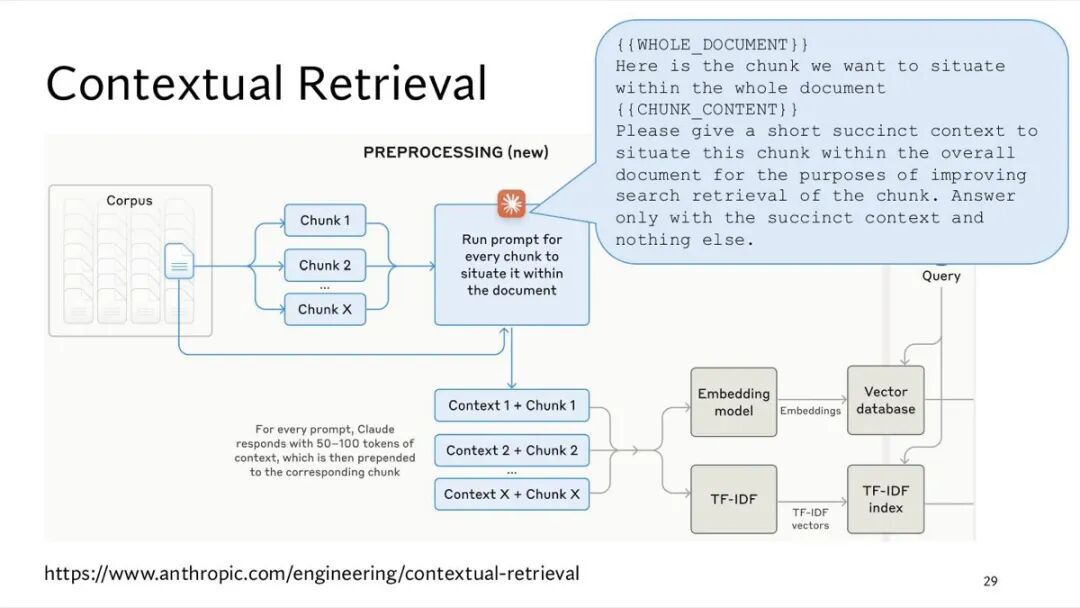
第 28 页是同一张流程图,气泡换成了生成上下文用的提示词原文。大意是:这里是整篇文档 {{WHOLE_DOCUMENT}};这里是我们想放回整篇文档里去理解的那个块 {{CHUNK_CONTENT}};请给出一段简短的上下文,说明这个块在整篇文档里的位置,目的是改善这个块的检索效果;只回答这段上下文,别的什么都不要说。
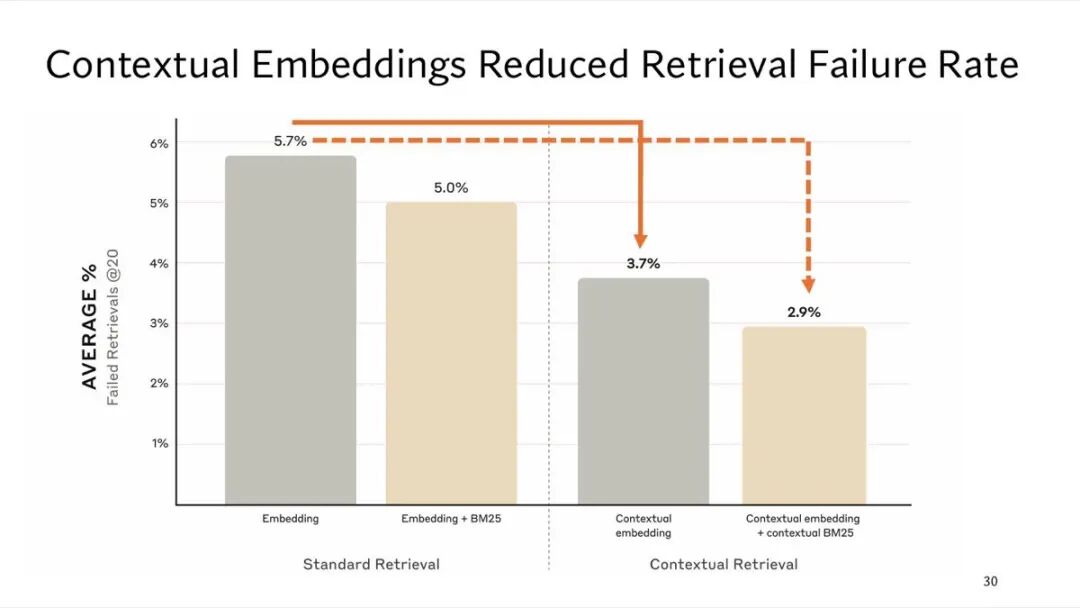
第 29 页的标题是:上下文 embedding 降低了检索失败率。纵轴是平均的「前 20 条检索失败率」,越低越好。四根柱子分两组。
标准检索:只用 embedding,5.7%;embedding 加 BM25,5.0%。
上下文检索:上下文 embedding,3.7%;上下文 embedding 加上下文 BM25,2.9%。
图上两条橙色箭头,分别从 5.7% 那根柱子指向 3.7% 和 2.9%。
补充纵轴写的是「Failed Retrievals @20」。按 Anthropic 那篇博客的原文,它的口径是 1 减 recall@20,也就是相关的块里有多少没进前 20 条,对应第 46 页的 Recall@k;它和第 45 页的 Failed@k 名字相近,算法不同。同一篇博客里,5.7% 降到 3.7% 是失败率减少 35%,降到 2.9% 是减少 49%。
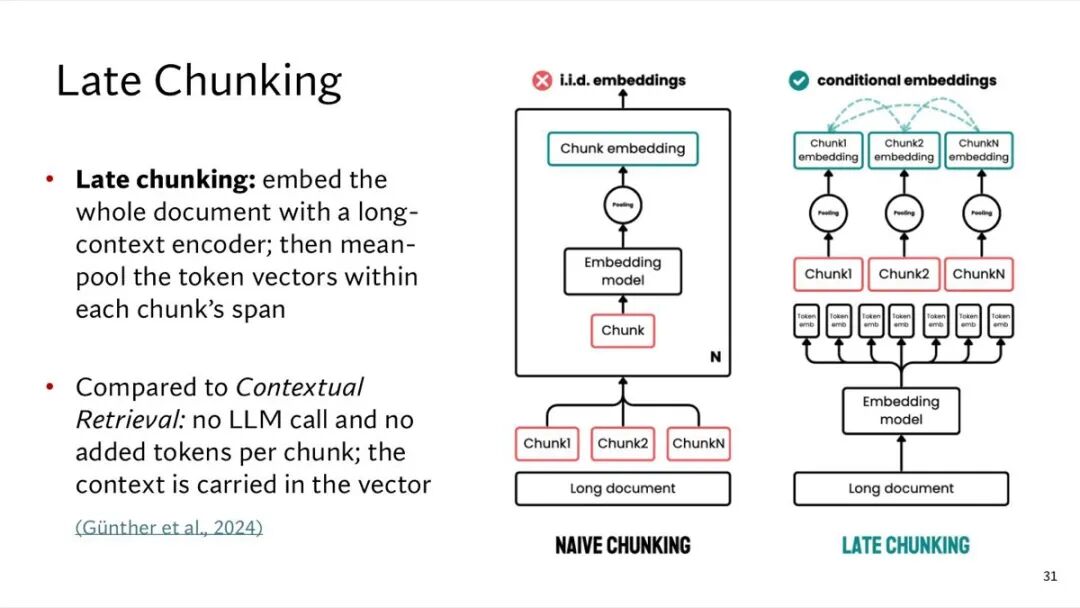
第 30 页讲延迟切块(late chunking),出自 Günther 等人 2024 年的论文。
做法是:先用一个长上下文编码器把整篇文档一起编码,得到每个 token 的向量;再按每个块的范围,把块内 token 的向量取平均,作为这个块的向量。
和上下文检索比:不用调用 LLM,每个块也不用多加 token,上下文是带在向量里的。
右边的图左右对比。左边是朴素切块,标着红叉「独立同分布的 embedding」:长文档先切成块 1 到块 N,每块单独进 embedding 模型,再池化成块向量,N 次互不相干。右边是延迟切块,标着绿勾「条件 embedding」:整篇长文档一次进 embedding 模型,得到一排 token 向量,再按块的范围分别池化,得到块 1 到块 N 的向量,三个块向量之间有虚线互相连着。
补充池化(pooling)是把一组向量合成一个向量,这里用的是取平均。延迟切块的前提是编码器能一次读下整篇文档,所以要用长上下文编码器。
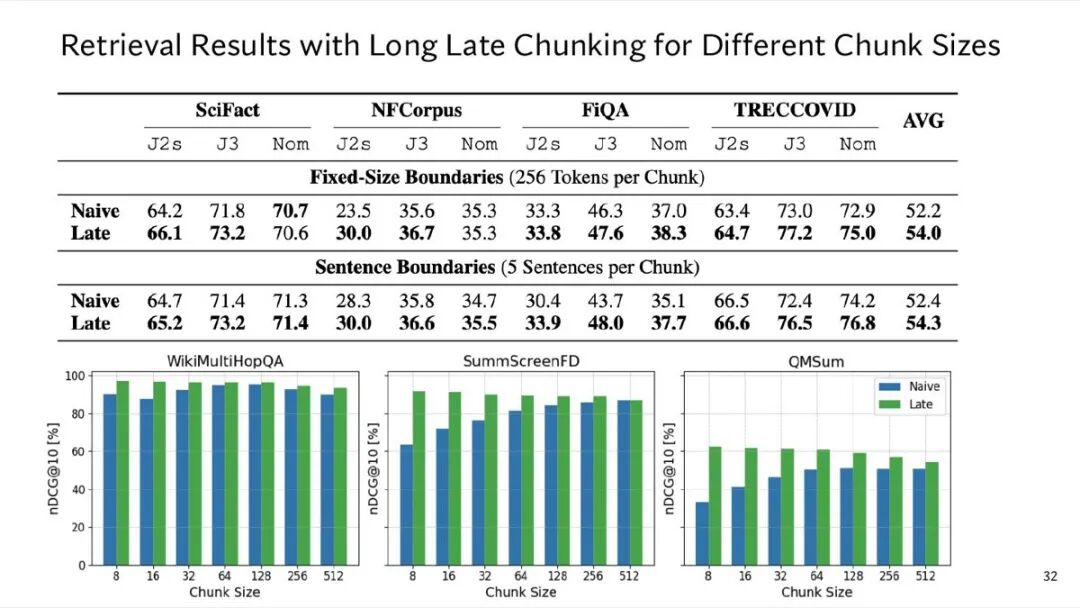
第 31 页是延迟切块在不同块大小下的检索结果。
上面的表用了四个数据集,SciFact,NFCorpus,FiQA,TRECCOVID,每个数据集下面三列,J2s,J3,Nom,是三个模型的缩写。每格比较朴素切块(Naive)和延迟切块(Late)。按固定 256 个 token 切块时,平均分从 52.2 升到 54.0。按句子边界切、每块 5 句时,平均分从 52.4 升到 54.3。
下面三张柱状图的数据集是 WikiMultiHopQA,SummScreenFD 和 QMSum,横轴是块大小,从 8 到 512 个 token,纵轴是 nDCG@10,蓝柱是朴素切块,绿柱是延迟切块。SummScreenFD 和 QMSum 上,块越小,延迟切块领先越多;块大到 512 时差距很小,SummScreenFD 上两根柱子差不多一样高。WikiMultiHopQA 上两者一直很接近,延迟切块只领先几个点。
补充nDCG@10 衡量前 10 条结果排得好不好,相关的结果排得越靠前分越高,第 45 页有它的公式。
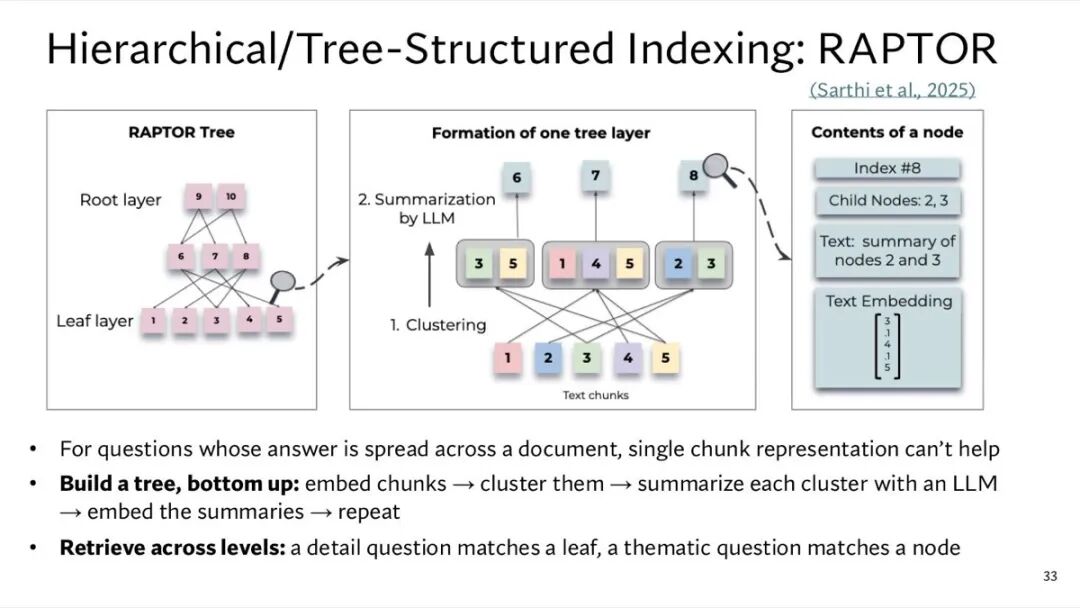
第 32 页讲层次化的树状索引,方法叫 RAPTOR,课件标的出处是 Sarthi 等人 2025 年。
为什么需要它:有的问题,答案分散在一篇文档的好几处,单个块的表示帮不上忙。
建树是自底向上的:先把块做成向量,再给它们聚类,用 LLM 给每一类写一段摘要,把摘要做成向量,再重复。
检索时跨层找:问细节的问题会匹配到叶子节点,问主题的问题会匹配到上层节点。
图分三格。左格是 RAPTOR 树,最底下是叶子层的 5 个文本块,往上是 6,7,8 三个节点,再往上是根层的 9 和 10。中格是一层树怎么形成:第一步聚类,把 1 到 5 号块分成三组,有的块同时进了两组;第二步用 LLM 给每组写摘要,得到 6,7,8 号节点。右格是一个节点里存了什么:编号 8,子节点是 2 和 3,文本是 2 号和 3 号节点的摘要,还有这段文本的向量。
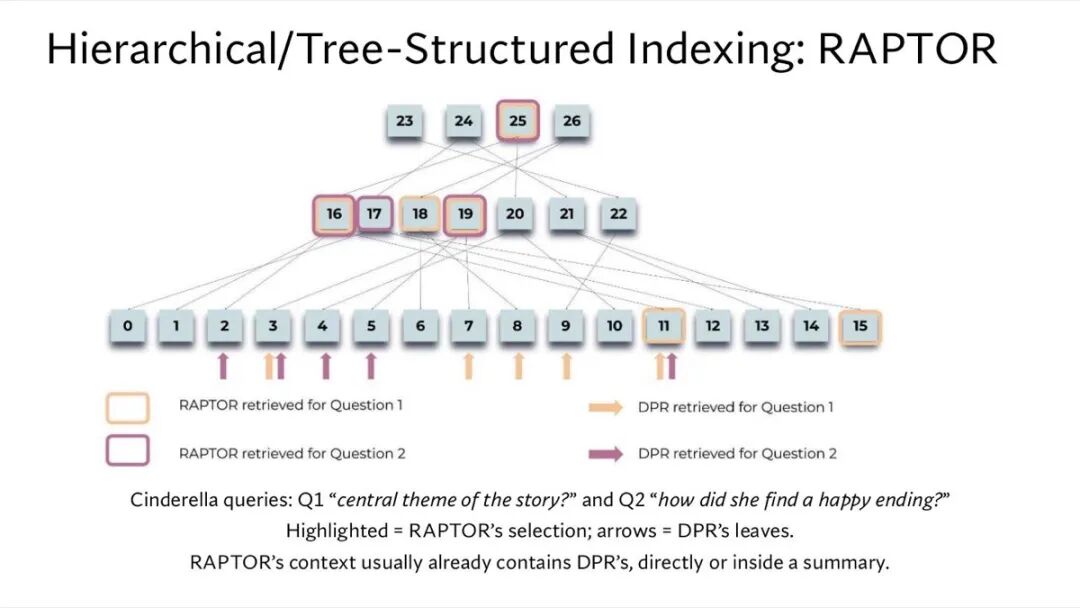
第 33 页是 RAPTOR 的一个检索例子,文档是灰姑娘的故事,两个问题。Q1 是「这个故事的中心主题是什么?」,Q2 是「她是怎么得到幸福结局的?」
树的最底层是 0 到 15 号叶子,往上一层是 16 到 22 号,最上层是 23 到 26 号。高亮框是 RAPTOR 选中的节点,橙框对应 Q1,紫框对应 Q2。Q1 选中了 25,16,18,19 这几个摘要节点,还有 11 和 15 两片叶子;Q2 选中了 25,16,17,19,没有选叶子。底下的箭头是 DPR 找到的叶子,橙色箭头对应 Q1,紫色箭头对应 Q2。
页面底部总结了一句:RAPTOR 取到的上下文,通常已经包含了 DPR 取到的内容,要么直接包含,要么包含在某个摘要里。
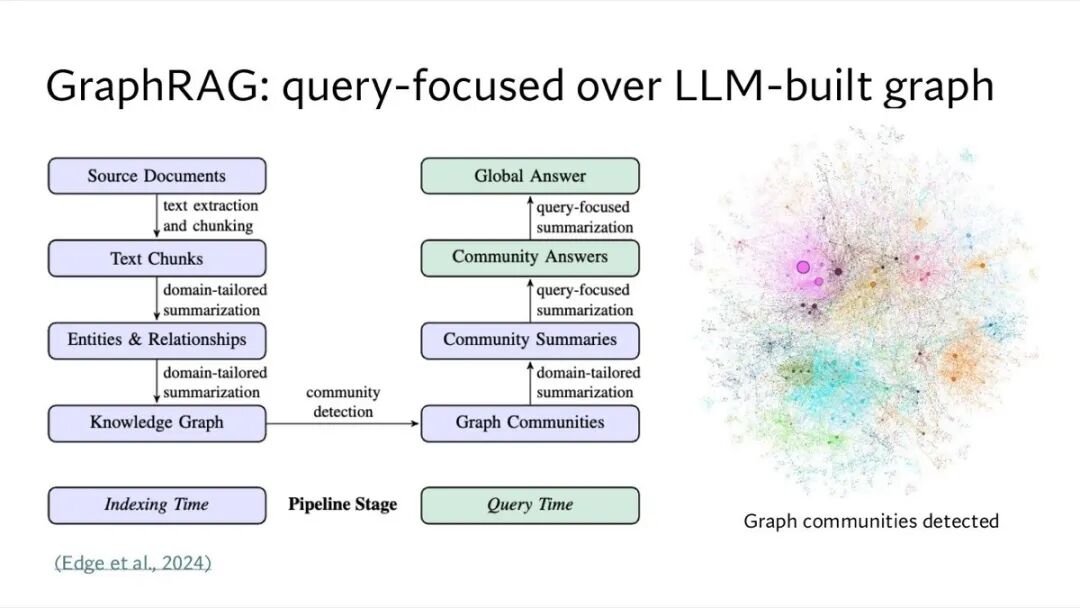
第 34 页讲 GraphRAG,出自 Edge 等人 2024 年的论文,标题的意思是:在 LLM 建出来的图上,做面向查询的总结。
流程分两段。建索引时:源文档经过文本抽取和切块,变成文本块;文本块经过领域定制的摘要,抽出实体和关系;实体和关系再经过一轮摘要,组成知识图谱;在知识图谱上做社区检测,得到图社区;每个社区再写一份社区摘要。
查询时:针对问题,用每份社区摘要分别写一个社区答案;再把社区答案汇总成一个全局答案。
右边是一张检测出来的图社区,不同颜色的点群就是不同的社区。
补充社区检测是图算法里的一类方法,把连得紧密的一群节点划成一组。GraphRAG 先把文档变成一张实体和关系的图,再按图的结构分组写摘要,所以能回答「整个文档库讲了哪些主题」这类问题。单靠检索几个块,回答不了这类问题。
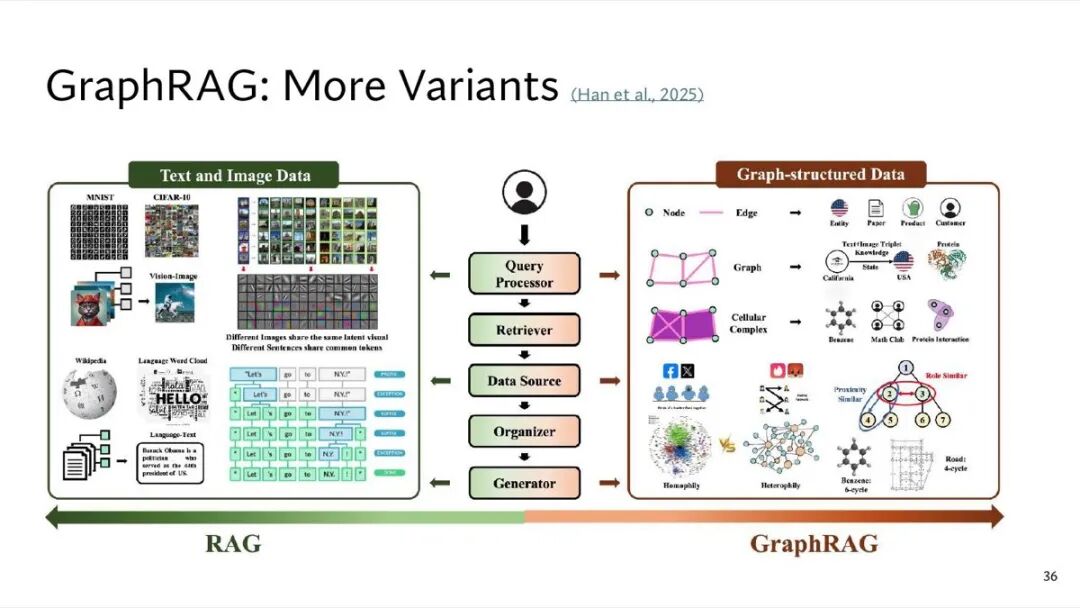
第 35 页是 GraphRAG 的更多变体,出自 Han 等人 2025 年的综述。中间是一条共用的流水线:查询处理器,检索器,数据源,组织器,生成器。左边是 RAG 面对的数据,文本和图片,例子有 MNIST,CIFAR-10,维基百科,词云等。右边是 GraphRAG 面对的图结构数据,有节点和边,例子有知识图谱,分子,社交网络,道路网。底部是一根两头带箭头的色带,左端标 RAG,右端标 GraphRAG;中间五个模块都有箭头同时指向左右两边。
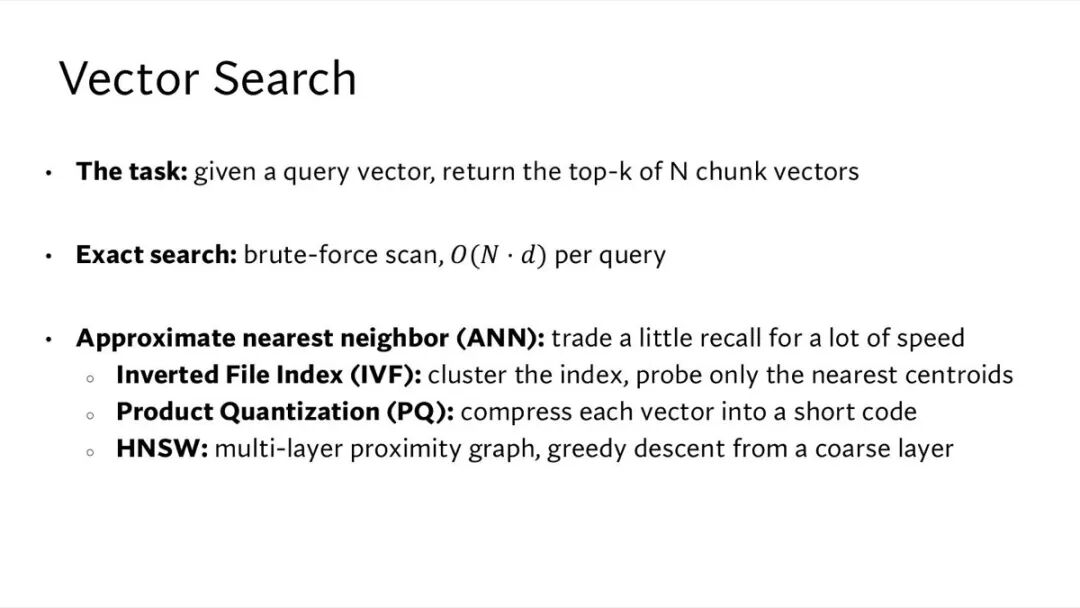
第 36 页讲向量搜索。
任务是:给一个查询向量,从 N 个块的向量里返回最近的 k 个。
精确搜索:暴力扫一遍,每次查询的开销是 O(N·d),d 是向量的维度。
近似最近邻(ANN):牺牲一点召回,换来大幅提速。课件列了三种。倒排文件索引(IVF):先把索引聚类,查询时只看离得最近的几个聚类中心。乘积量化(PQ):把每个向量压成一串很短的编码。HNSW:多层的近邻图,从粗的一层开始贪心地往下走。
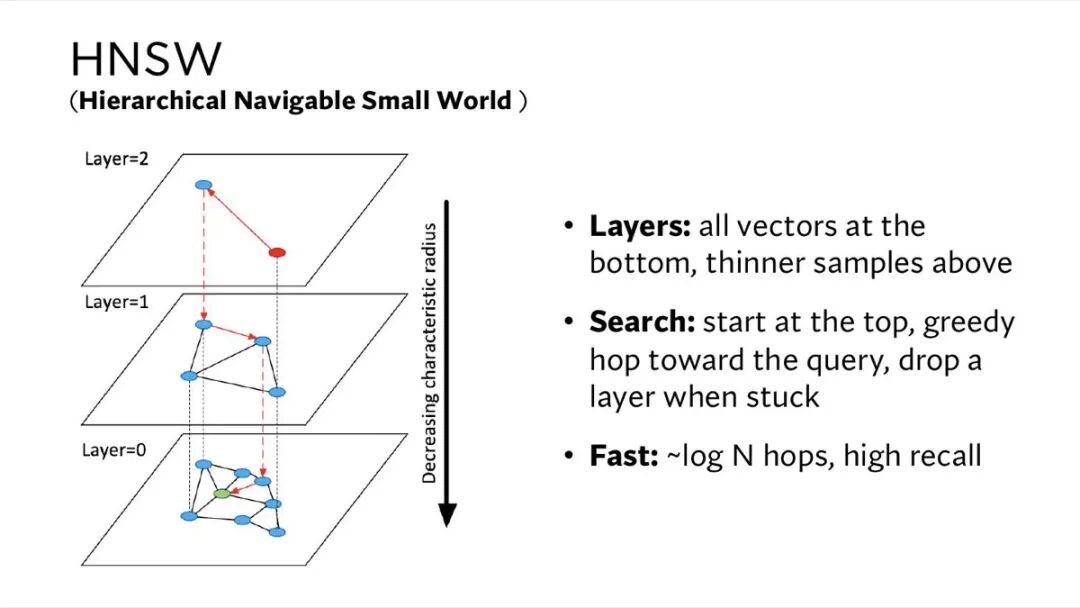
第 37 页单讲 HNSW,全名是 Hierarchical Navigable Small World,可分层导航的小世界图。
左图是三层平面,从上到下是第 2 层,第 1 层,第 0 层,旁边的箭头标着「特征半径逐层减小」。最上层只有两个点,最下层点最多,红色的线和虚线画出一次搜索走过的路径,最后停在第 0 层一个绿色的点上。
右边三条说明。分层:所有向量都在最底层,越往上是越稀疏的抽样。搜索:从最上层开始,贪心地往离查询更近的点跳,跳不动了就下一层。快:大约 log N 次跳跃,召回率高。
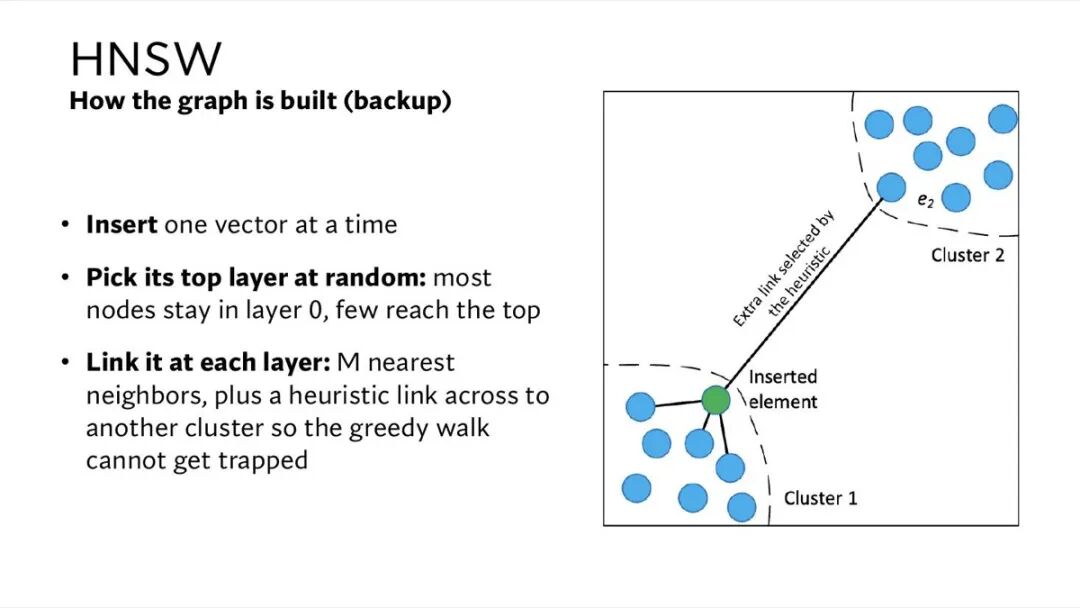
第 38 页讲 HNSW 的图是怎么建出来的,标题里标着「备用」(backup)。
每次插入一个向量。随机决定它最高到哪一层:大多数节点只在第 0 层,很少能到最上层。在它所在的每一层,把它和 M 个最近的邻居连起来;再按一条启发式规则,额外连一条跨到另一个聚类的边,这样贪心的搜索不会被困在一个聚类里。
右边的图正是这种情况:绿色的新插入元素在聚类 1 里,和身边几个点连着;还有一条长边伸到右上角的聚类 2,边上写着「由启发式规则选中的额外连接」。
五、检索
检索器分三类:按词重合打分的 BM25,把文字变成向量的 DPR,按 token 做匹配的 ColBERT。BM25 和向量检索出错的地方不同,所以可以把两者的结果合起来用,再用更慢更准的模型做重排序。
第 39 页是大纲,前三项变灰,进入「检索:BM25,DPR,ColBERT」。
第 40 页问:我们的检索系统,该怎么找出相关的段落?三类检索器。词重合,代表是 BM25。向量检索,代表是 DPR 和句子向量。其他的神经网络系统,代表是 ColBERT。
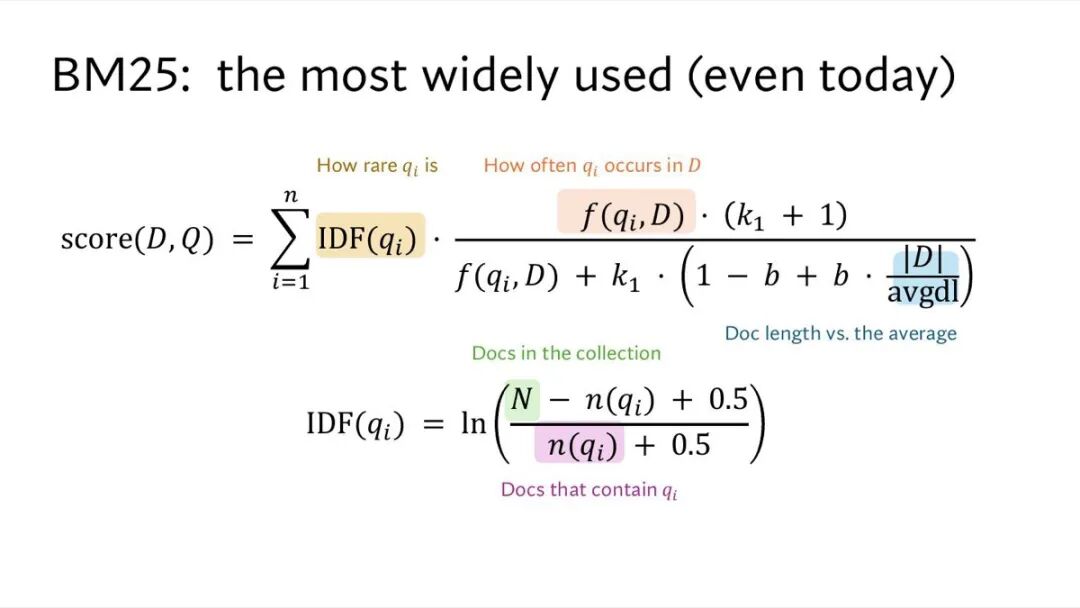
第 41 页是 BM25,标题写着:用得最广的方法,到今天还是。
一篇文档 D 对查询 Q 的得分,是对查询里每个词 qi 求和。每个词的贡献是两部分相乘。
第一部分是 IDF(qi),课件标注为「qi 有多罕见」。
第二部分是一个分式。分子是 qi 在 D 里出现的次数 f(qi,D) 乘以 (k1+1),课件标注为「qi 在 D 里出现得多频繁」。分母是 f(qi,D) 加上 k1 乘以一个长度修正项,修正项里有 |D|/avgdl,课件标注为「文档长度和平均长度的比」。
下面是 IDF 的公式:ln((N − n(qi) + 0.5) / (n(qi) + 0.5))。N 标注为「文档库里的文档数」,n(qi) 标注为「包含 qi 的文档数」。
补充k1 和 b 是两个可调的参数。k1 控制词频的作用多快饱和,b 控制文档长度修正的力度,b 取 0 就是不做长度修正。长文档自然会包含更多词,长度修正就是为了不让它们白占便宜。
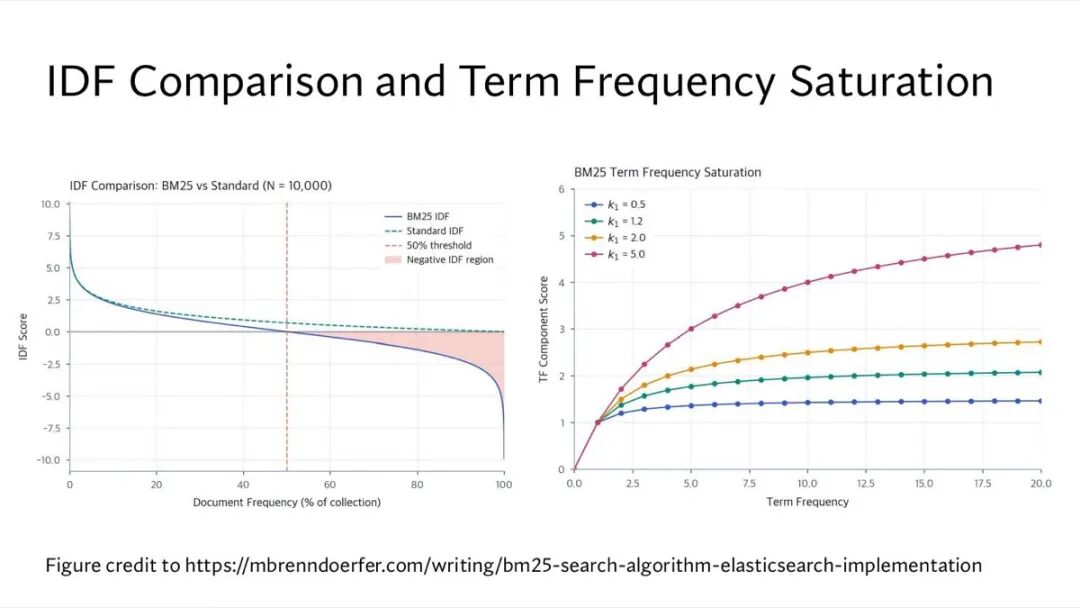
第 42 页是两张图,出处是 mbrenndoerfer.com 上一篇讲 BM25 的文章。
左图比较 BM25 的 IDF 和标准 IDF,文档库大小是 10,000。横轴是包含这个词的文档占全库的百分比,纵轴是 IDF 分数。两条曲线都随文档频率下降。标准 IDF 始终不为负,到 100% 时降到 0。BM25 的 IDF 在 50% 那条红色虚线处穿过 0,之后变成负数,越往右越负,图上把这块标成「负 IDF 区域」,涂成了粉色。
右图是 BM25 的词频饱和。横轴是词频,从 0 到 20;纵轴是词频那一部分的得分。四条线对应 k1 取 0.5,1.2,2.0,5.0。四条线都经过同一点:词频为 1 时,得分都是 1。之后每条线都是先涨后平。k1 越大,线涨得越久,最后停得越高:k1 = 0.5 的线很快就平在 1.5 以下,k1 = 5.0 的线到词频 20 时还在涨,接近 5。
补充词频饱和的意思是,一个词在文档里出现第 1 次和第 2 次时加分很多,出现第 20 次和第 21 次时几乎不再加分。这样一篇反复堆砌某个词的文档,得分不会无限上涨。
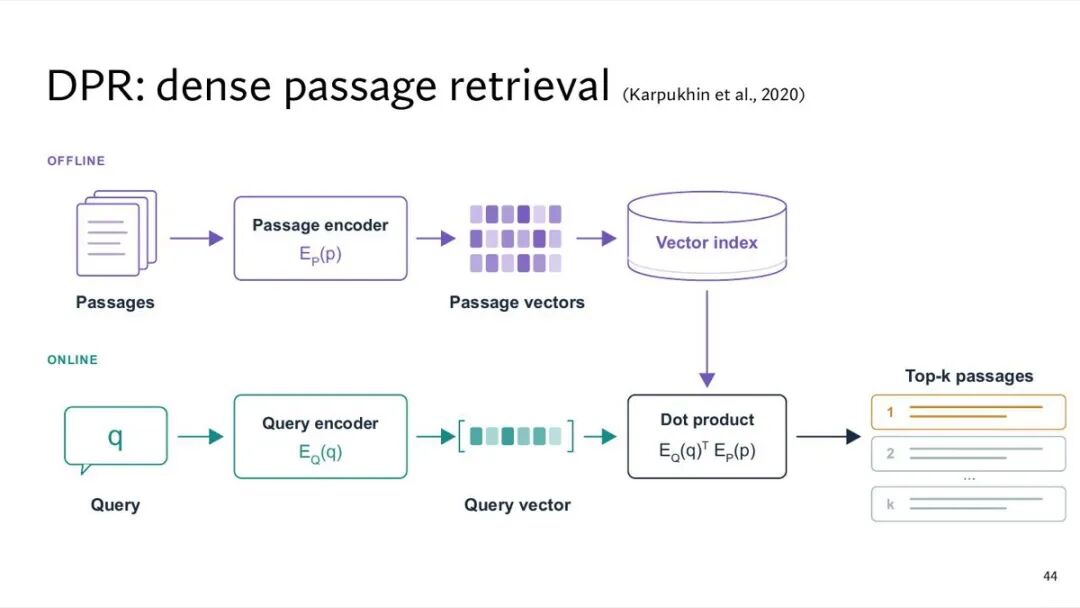
第 43 页是 DPR,稠密段落检索,出自 Karpukhin 等人 2020 年的论文。图分离线和在线两部分。
离线:所有段落经过段落编码器 E_P(p),变成段落向量,存进向量索引。
在线:查询经过查询编码器 E_Q(q),变成查询向量;查询向量和索引里的段落向量做点积 E_Q(q)ᵀE_P(p);按得分排出前 k 个段落。
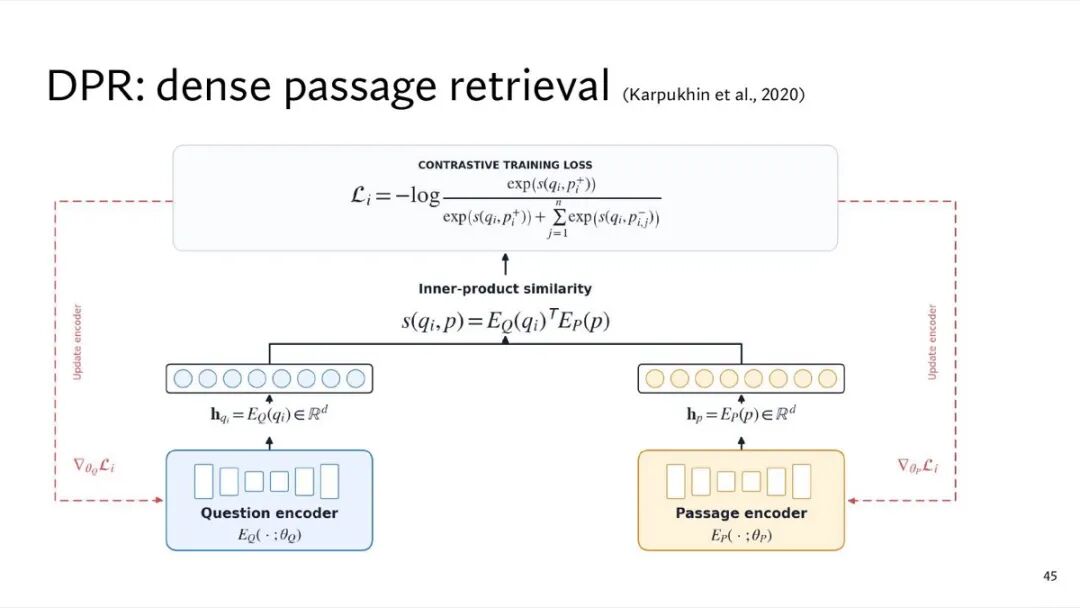
第 44 页是 DPR 的训练方式。
问题编码器和段落编码器各自把输入变成 d 维向量,两者的内积就是相似度 s(q,p)。训练损失是对比损失。分子是问题和正确段落 p⁺ 的相似度,取指数,分母是这一项再加上 n 个错误段落 p⁻ 的相似度指数之和,整体取负对数。图两侧的红色虚线表示,损失的梯度同时回传,更新问题编码器和段落编码器。
补充对比损失的直觉是,把问题和正确段落的向量拉近,和错误段落的向量推远。
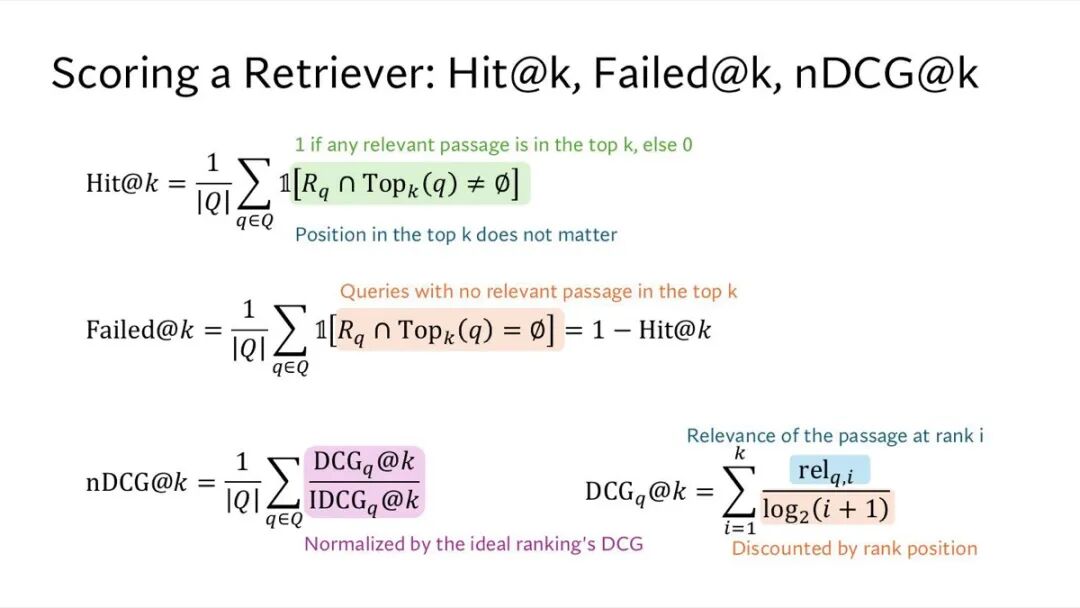
第 45 页讲怎么给检索器打分,先讲三个指标。
Hit@k:对每个查询,只要前 k 条里有任何一条相关的,就记 1,否则记 0;再对所有查询取平均。课件标注:在前 k 条里排第几不重要。
Failed@k:有些查询,前 k 条里一条相关的都没有,Failed@k 就是这类查询所占的比例,等于 1 减 Hit@k。
nDCG@k:先算每个查询的 DCG@k,把排在第 i 位的那条结果的相关度,除以 log₂(i+1) 再求和,排得越靠后打折越多;再除以理想排序下的 DCG 做归一化;最后对所有查询取平均。
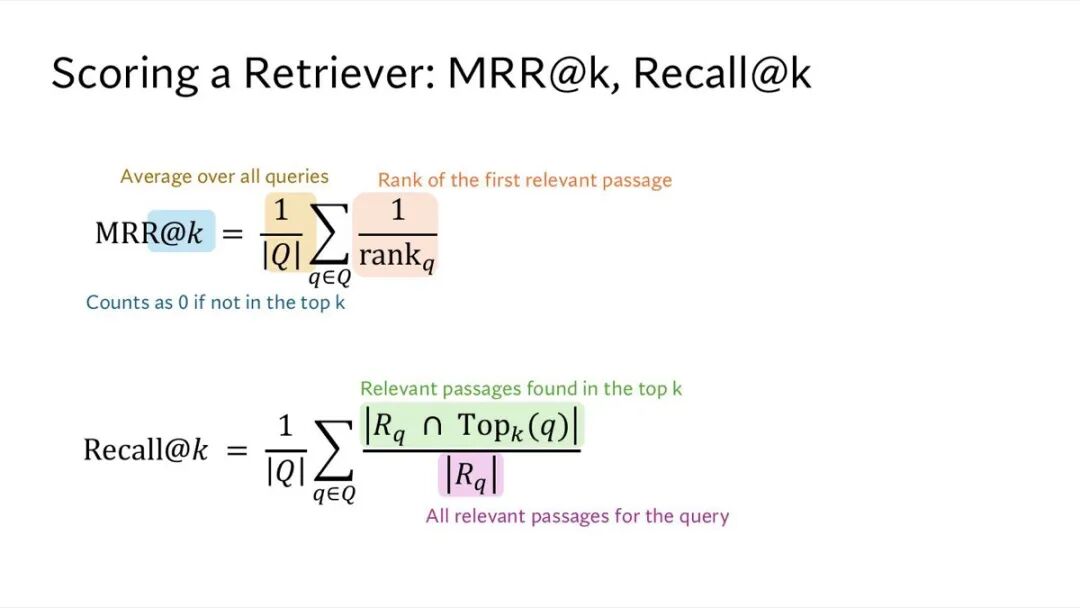
第 46 页再讲两个指标。
MRR@k:对每个查询,找到第一条相关结果的排名,取倒数;对所有查询取平均。第一条相关结果不在前 k 条里,就记 0。
Recall@k:对每个查询,前 k 条里找到的相关段落数,除以这个查询所有的相关段落数;对所有查询取平均。
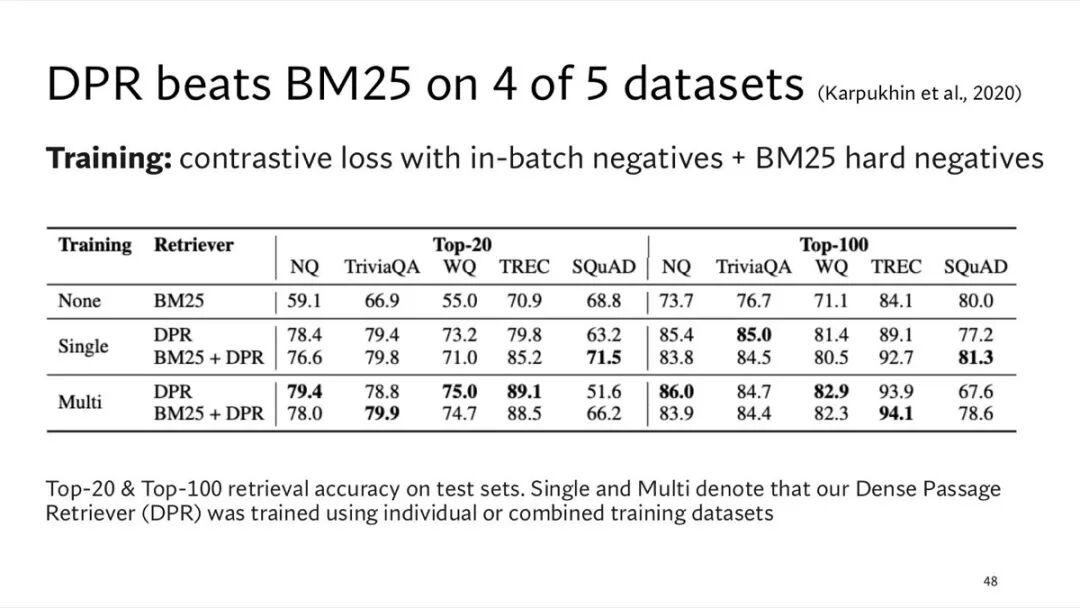
第 47 页的标题是:DPR 在 5 个数据集里的 4 个上胜过 BM25。训练方式写在表上方:对比损失,负例用同一批里其他问题的正确段落,再加上 BM25 找出来的难负例。
表里是前 20 条和前 100 条的检索准确率。看前 20 条:BM25 在 NQ 上是 59.1,单数据集训练的 DPR 是 78.4;TriviaQA 是 66.9 对 79.4;WQ 是 55.0 对 73.2;TREC 是 70.9 对 79.8。第五个数据集 SQuAD 上反过来,BM25 是 68.8,DPR 是 63.2。
表里还有两种组合。单数据集训练的 BM25 加 DPR,在 SQuAD 上前 20 条是 71.5,前 100 条是 81.3,都是这一列加粗的最好成绩。多数据集一起训练的 DPR(Multi),在 NQ,WQ,TREC 上的前 20 条成绩更高;在 TriviaQA 上略低,是 78.8;在 SQuAD 上低得多,只有 51.6。
补充同一批里的负例,是说一个训练批次里有很多个问题,每个问题的正确段落,对其他问题来说就是现成的错误段落,不用另外去找。难负例是看起来很像答案、其实不对的段落,用 BM25 找出来的就是和问题词重合很多的那些。
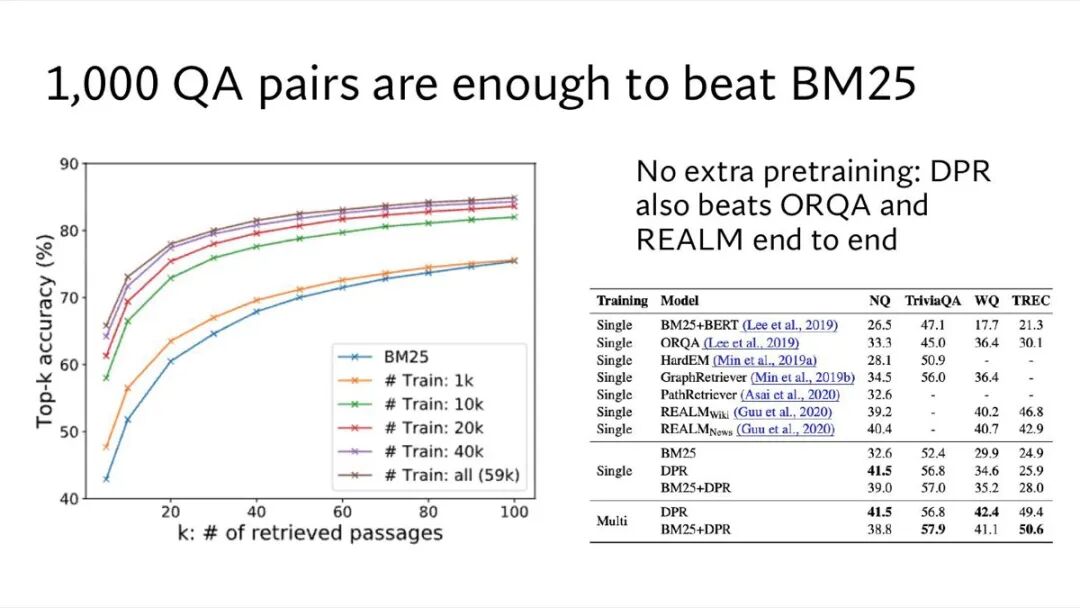
第 48 页的标题是:1,000 个问答对,就足够胜过 BM25。
左图横轴是检索的段落数 k,从 1 到 100,纵轴是前 k 条的准确率。蓝线是 BM25,其余五条是用不同数量训练数据的 DPR:1k,10k,20k,40k,全部 59k。用 1k 数据训练的那条橙线,在前段就高于 BM25。到 k = 100 时,这两条线在约 75% 处靠在一起。训练数据越多,线越高,40k 和 59k 的两条几乎重合在最上面。
右边写着:不需要额外的预训练,DPR 在端到端问答上也胜过 ORQA 和 REALM。右表是问答的精确匹配分数。单数据集训练时,DPR 在 NQ 上是 41.5,ORQA 是 33.3,REALM 的两个版本是 39.2 和 40.4,BM25 是 32.6。多数据集训练时,DPR 在 WQ 上是 42.4,BM25 加 DPR 在 TREC 上是 50.6。
补充ORQA 和 REALM 训练检索器之前,都先在大量文本上做了一轮专门为检索设计的预训练。DPR 只用问答对做训练,省掉了这一步。
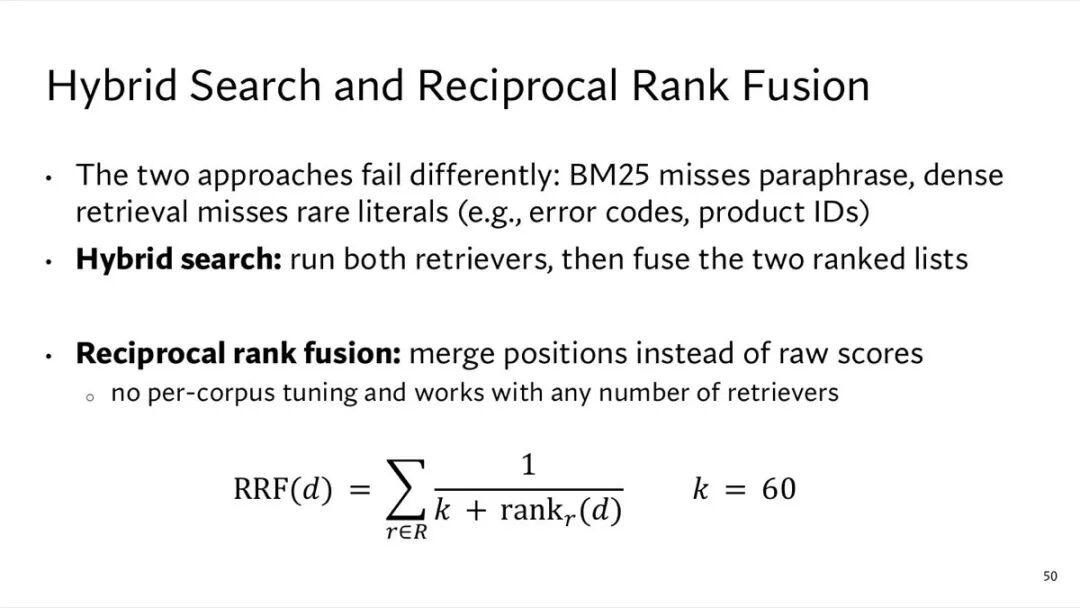
第 49 页讲混合搜索和倒数排名融合。
两种方法出错的地方不同:BM25 抓不到换了说法的同义表达,稠密检索抓不到罕见的字面串,比如错误码和产品编号。
混合搜索:两个检索器都跑一遍,再把两份排名列表融合起来。
倒数排名融合(RRF):合并的是排名,不是原始分数。好处是不用针对每个文档库调参,检索器有几个都能用。
公式:一篇文档 d 的融合得分,是对每个检索器 r 求和,每一项是 1/(k + 这篇文档在 r 里的排名)。课件给的 k 取 60。
补充不同检索器的原始分数量纲不同,BM25 的分可以是十几,DPR 用的内积没有固定范围,两者的量纲完全不同,直接相加没有意义。只看排名就绕开了这个问题。k = 60 让排名靠前的几条之间分差不会太悬殊。
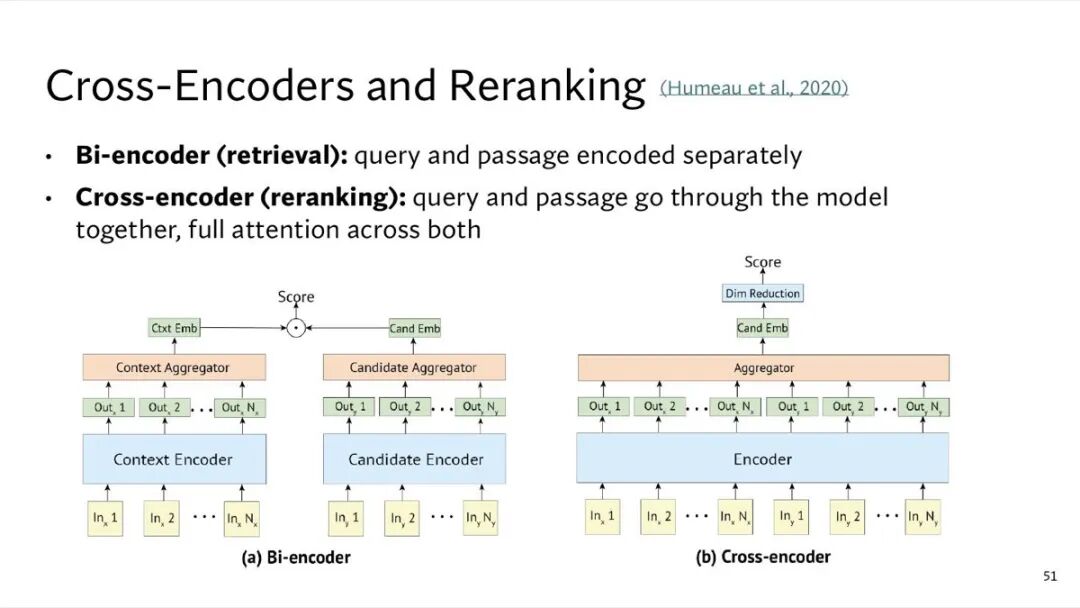
第 50 页讲交叉编码器和重排序,图来自 Humeau 等人 2020 年的论文。
双编码器用于检索:查询和段落分开编码。交叉编码器用于重排序:查询和段落一起进模型,两者之间做完整的注意力。
左图是双编码器:上下文和候选各有一个编码器,各自聚合成一个向量,两个向量做点积得到分数。右图是交叉编码器:两段输入拼在一起进同一个编码器,聚合后降维得到分数。
补充双编码器的段落向量可以提前算好存起来,查询时只要算一次查询向量,所以能在整个文档库里搜。交叉编码器每来一个查询,都要把查询和每个候选段落一起重新跑一遍模型,所以只能用在少量候选上。常见的做法是先用快的检索器捞出几十上百条,再用交叉编码器重新排一遍。
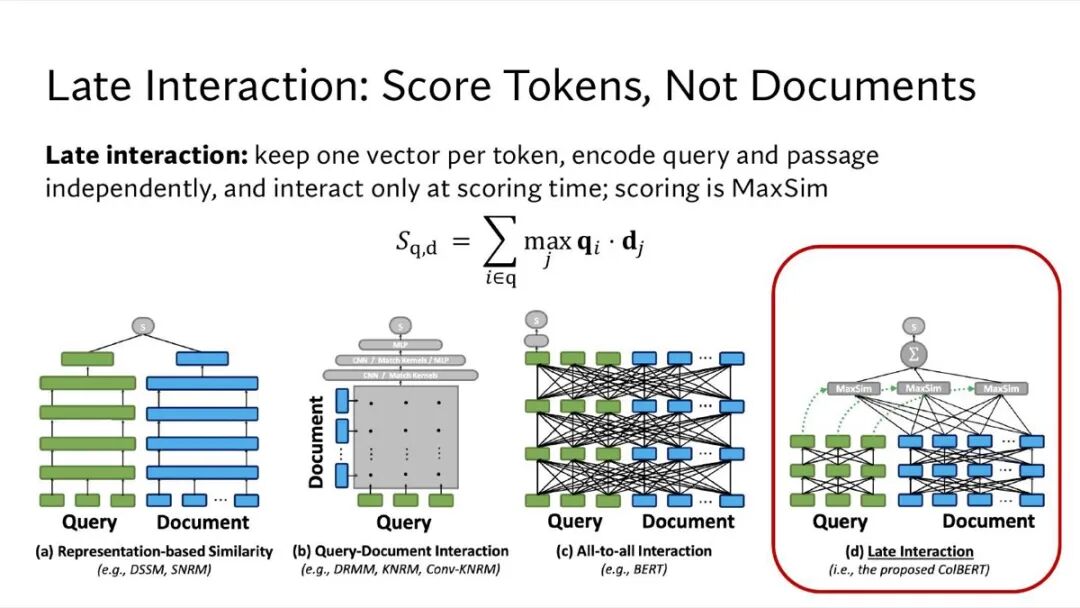
第 51 页讲延迟交互:给 token 打分,不给整篇文档打分。
做法是:每个 token 保留一个向量;查询和段落各自独立编码,只在打分时才交互;打分方式叫 MaxSim。公式是:对查询里的每个 token 向量 qi,在文档的所有 token 向量 dj 里找内积最大的那个,再把这些最大值加起来。
下面四张小图对比了四种范式。(a) 基于表示的相似度,例子是 DSSM 和 SNRM,查询和文档各压成一个向量再比。(b) 查询和文档交互,例子是 DRMM,KNRM,Conv-KNRM,先算两边 token 两两之间的相似度矩阵,再在矩阵上做卷积或核函数。(c) 全对全交互,例子是 BERT,两边所有 token 在每一层都互相注意。(d) 延迟交互,用红框圈出,就是 ColBERT。
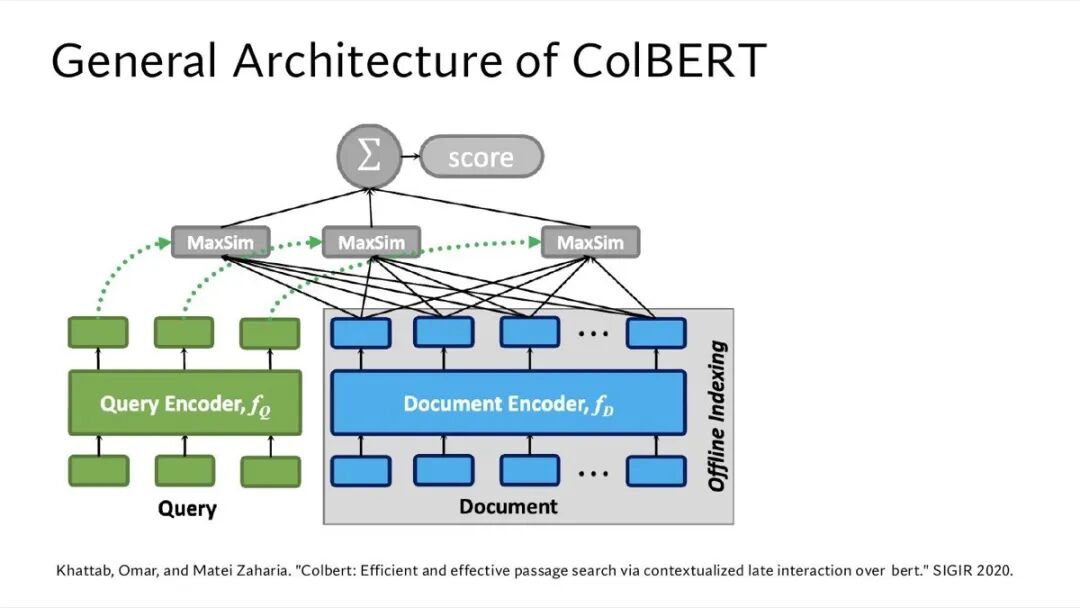
第 52 页是 ColBERT 的整体结构,出自 Khattab 和 Zaharia 发在 SIGIR 2020 的论文。
左边绿色是查询编码器 f_Q,查询的每个 token 输出一个向量。右边蓝色是文档编码器 f_D,文档的每个 token 输出一个向量,整块用灰底框起来,旁边竖写着「离线建索引」。上方有三个 MaxSim 框,每个查询 token 向量进一个框,每个框连着所有文档 token 向量,取最大值;三个最大值进求和符号,输出分数。
补充这篇论文是课程官网列的本讲选读。
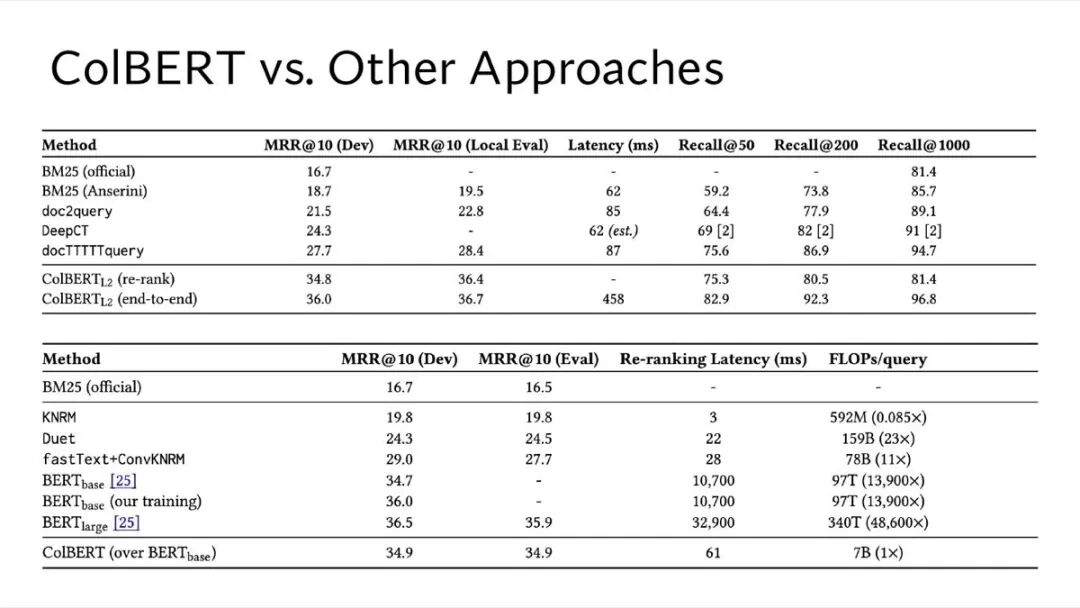
第 53 页是 ColBERT 和其他方法的比较,两张表,数据集是 MS MARCO。
上表比较几种检索方法,里面也有一行 ColBERT 做重排序。官方 BM25 的 MRR@10 是 16.7。Anserini 实现的 BM25 是 18.7,延迟 62 毫秒,Recall@1000 是 85.7。docTTTTTquery 是 27.7,延迟 87 毫秒,Recall@1000 是 94.7。ColBERT 做重排序时 MRR@10 是 34.8;端到端检索时是 36.0,延迟 458 毫秒,Recall@50 是 82.9,Recall@200 是 92.3,Recall@1000 是 96.8。
下表是重排序。BERT-base 有两行,MRR@10 分别是 34.7 和 36.0,重排序延迟 10,700 毫秒,每次查询 97T 次浮点运算,是 ColBERT 的 13,900 倍。BERT-large 是 36.5,延迟 32,900 毫秒,计算量是 ColBERT 的 48,600 倍。ColBERT 基于 BERT-base,MRR@10 是 34.9,延迟 61 毫秒,每次查询 7B 次浮点运算。
补充MS MARCO 是微软的段落检索数据集,问题来自真实的 Bing 搜索。两张表里 ColBERT 有三个 MRR@10 数,34.8,36.0,34.9,对应不同的设置,以原论文为准。
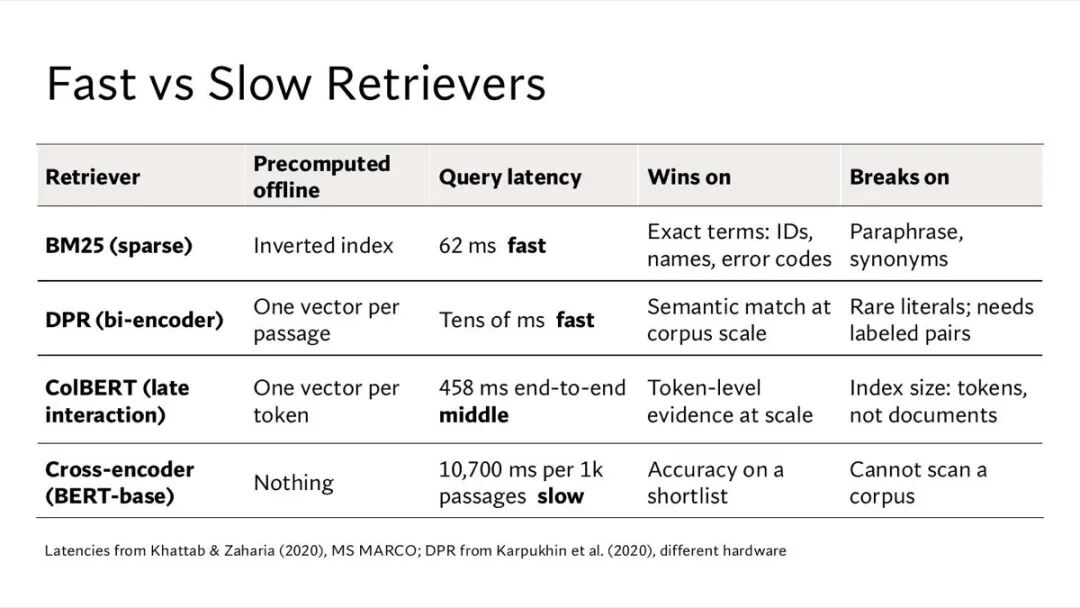
第 54 页把四种检索器排成一张表,按快慢比。
BM25,稀疏检索:离线预先算好的是倒排索引;查询延迟 62 毫秒,快;擅长精确词,比如编号,人名,错误码;败在换说法和同义词。
DPR,双编码器:离线算好每个段落一个向量;查询延迟几十毫秒,快;擅长文档库规模上的语义匹配;败在罕见字面串,而且需要标注好的问答对来训练。
ColBERT,延迟交互:离线算好每个 token 一个向量;端到端 458 毫秒,中等;擅长在大规模上找到 token 级别的证据;问题在索引大小,按 token 数算,不按文档数算。
交叉编码器,BERT-base:离线什么都不用算;每 1,000 个段落 10,700 毫秒,慢;擅长在一份候选短名单上做准;没法扫描整个文档库。
表下面注明:延迟数据来自 Khattab 和 Zaharia 2020 年在 MS MARCO 上的测量;DPR 的数据来自 Karpukhin 等人 2020 年的论文,用的硬件不同。
六、Agentic RAG
前面讲的都是把一次检索做好;agent 还要自己决定要不要检索,搜什么,结果够不够好。课件讲了三种做法:模型学会自我批评,用一个评估器给检索打分,用强化学习学搜索策略。
第 55 页是大纲,前四项变灰,进入「Agentic RAG:Self-RAG,Search-R1」。
第 56 页讲把检索放进循环里。
页面开头一段话:到目前为止讲的东西,都是把一个问题回答好。它们都不决定要不要检索,该问什么,什么时候停。
中间是三个机器人的连环画:第一个看着任务清单,第二个拿放大镜翻文档,第三个对着打了勾的清单。
下面两条。检索应该是 agent 采取的一个动作。三个决定:一,检索还是直接回答;二,发出什么样的查询;三,检索结果够不够好。
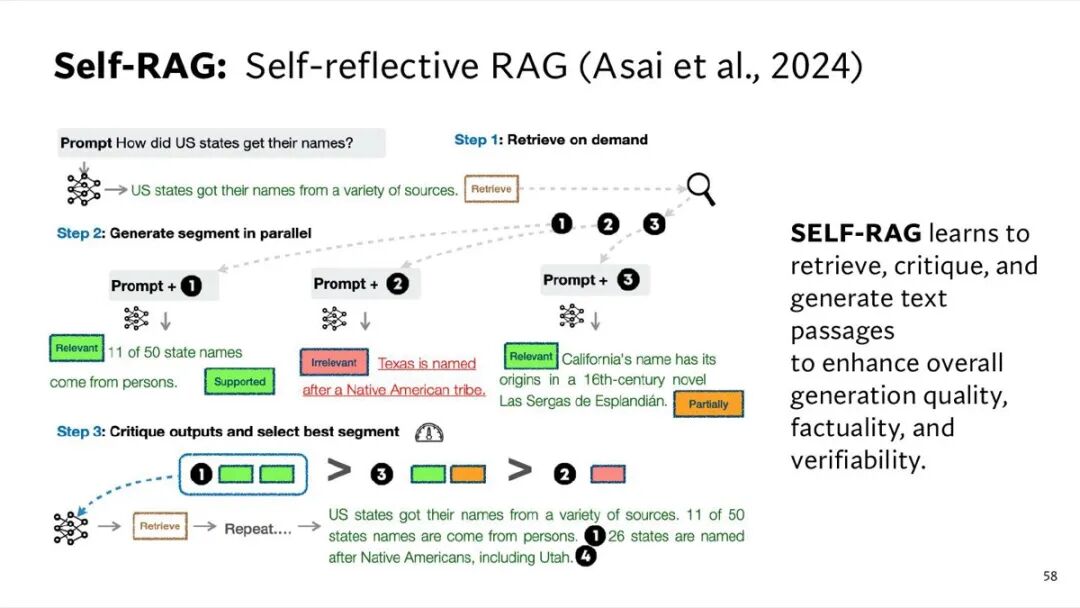
第 57 页是 Self-RAG,自我反思的 RAG,出自 Asai 等人 2024 年的论文。右边写着:Self-RAG 学会检索,批评,生成文本段落,以提升整体的生成质量,事实性和可核查性。
左边是一个例子,提示词是「美国各州的名字是怎么来的?」
第一步,按需检索。模型先写了一句「美国各州的名字来源多样」,然后输出一个「检索」标记,去检索。
第二步,并行生成几个片段。检索回来三段文字,模型分别配着每段写一个续写,并给自己打标签。第 1 段:标为「相关」,写的是「50 个州名里有 11 个来自人名」,标为「有支持」。第 2 段:标为「不相关」,写的是「得克萨斯州得名于一个美洲原住民部落」。第 3 段:标为「相关」,写的是「加利福尼亚这个名字源自 16 世纪的一部小说《埃斯普兰迪安的功绩》」,标为「部分支持」。
第三步,批评输出,选出最好的片段。排序是 1 好于 3,3 好于 2。然后接着检索,重复。最后的输出是:「美国各州的名字来源多样。50 个州名里有 11 个来自人名。26 个州以美洲原住民命名,包括犹他州。」句子后面标着引用的编号。
补充Self-RAG 的做法是在训练时让模型学会输出几种特殊的「反思标记」,比如要不要检索,检索到的内容相关不相关,生成的话有没有被支持。推理时模型按这些标记来决定下一步。
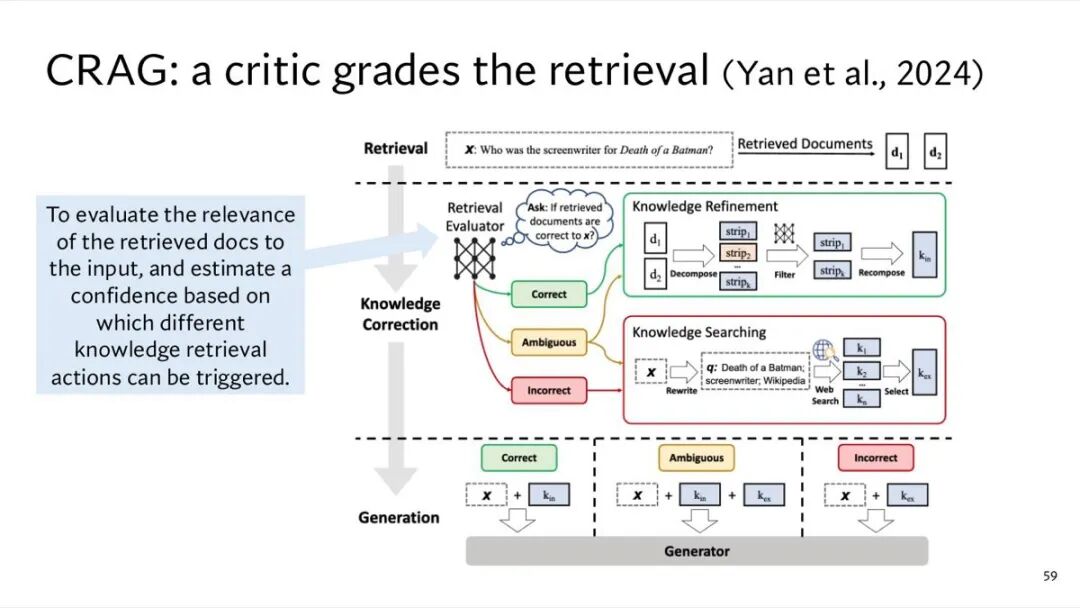
第 58 页是 CRAG,用一个评判器给检索结果打分,出自 Yan 等人 2024 年的论文。左边的说明是:评估检索到的文档和输入的相关程度,估计一个置信度,根据置信度触发不同的知识检索动作。
图分三段。检索:问题是「《Death of a Batman》的编剧是谁?」,检索回两篇文档 d1 和 d2。
知识修正:检索评估器问自己「检索到的文档对 x 来说正确吗?」,给出三种判断。正确:走知识精炼,把文档拆成小条,过滤掉无关的,再重新组合,得到内部知识 k_in。错误:走知识搜索,先改写查询,比如改成「Death of a Batman; screenwriter; Wikipedia」,去网上搜,再挑出结果,得到外部知识 k_ex。模糊:两条路都走。
生成:判断为正确时,把问题和 k_in 交给生成器;模糊时,交的是问题,k_in 和 k_ex;错误时,交的是问题和 k_ex。
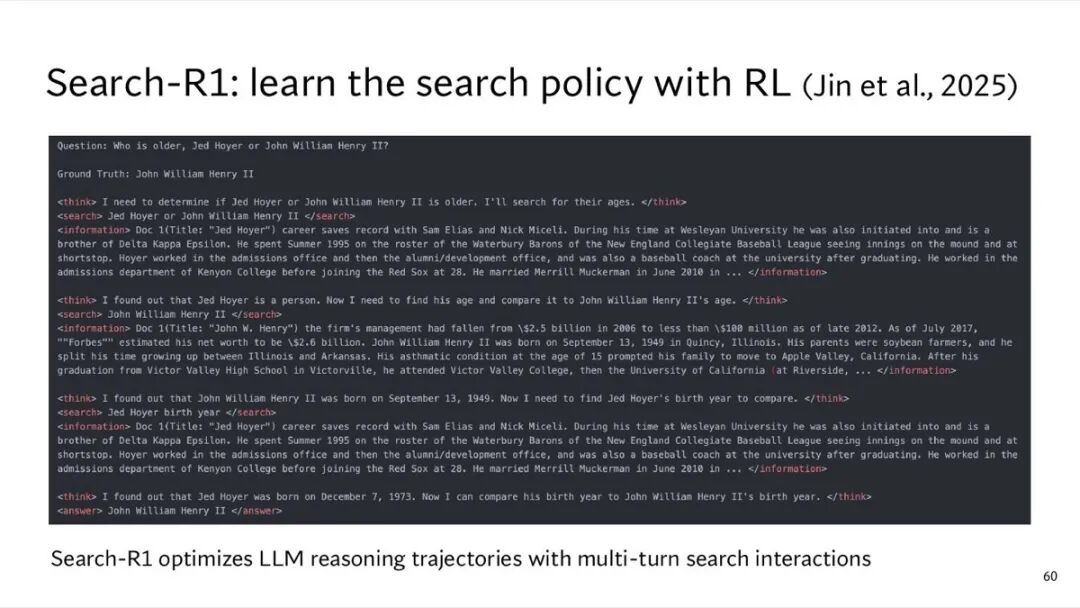
第 59 页是 Search-R1,用强化学习学搜索策略,出自 Jin 等人 2025 年的论文。页面底部写着:Search-R1 优化的是 LLM 推理时走过的轨迹,轨迹里有多轮搜索交互。
页面中间是一段完整的轨迹。问题是「Jed Hoyer 和 John William Henry II,谁年纪大?」标准答案是 John William Henry II。
模型先在 think 标签里想:要判断两人谁年纪大,去搜他们的年龄。第一次搜索的查询是「Jed Hoyer or John William Henry II」,返回的是 Jed Hoyer 的词条片段,讲他的大学棒球经历和工作经历。
模型想:Jed Hoyer 是一个人,现在要找他的年龄,和 John William Henry II 比。第二次搜「John William Henry II」,返回的片段里写着他生于 1949 年 9 月 13 日。
模型想:John William Henry II 生于 1949 年 9 月 13 日,现在要找 Jed Hoyer 的出生年份。第三次搜「Jed Hoyer birth year」,返回的还是第一次那段 Jed Hoyer 的词条片段。
模型接着想:Jed Hoyer 生于 1973 年 12 月 7 日,现在可以比较了。最后在 answer 标签里给出 John William Henry II。
补充截图里第三次检索返回的片段,和第一次一字不差,片段以省略号结尾,截图显示的部分里没有出现 1973 年 12 月 7 日这个日期。课件没有对这一点做说明。
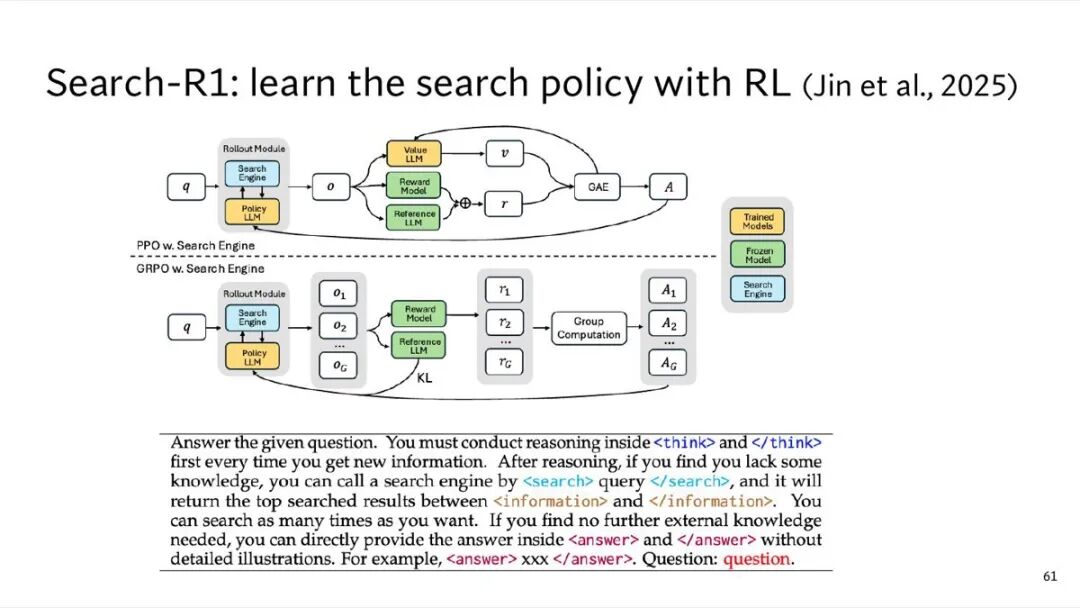
第 60 页是 Search-R1 的训练框架和提示词模板。
上半部分是两种强化学习算法。PPO 加搜索引擎:策略 LLM 和搜索引擎组成一个 rollout 模块,输入问题 q,产生输出 o。输出同时交给价值 LLM,奖励模型和参考 LLM:价值 LLM 给出 v,后两者合成奖励 r,v 和 r 一起进 GAE,算出优势 A。GRPO 加搜索引擎:同一个问题一次产生 G 个输出 o1 到 oG,每个输出得到一个奖励 r1 到 rG,在组内比较算出各自的优势 A1 到 AG,参考模型通过 KL 项约束策略不要偏太远。图例里,黄色是要训练的模型,绿色是冻结的模型,蓝色是搜索引擎。
下半部分是提示词模板,大意是:回答给定的问题。每次拿到新信息,都要先在 think 标签里推理。推理之后,如果发现缺少知识,可以用 search 标签调用搜索引擎,它会把排在前面的搜索结果放在 information 标签里返回。想搜几次都可以。如果不再需要外部知识,就直接在 answer 标签里给出答案,不用详细说明。
补充PPO 和 GRPO 都是强化学习里更新策略的算法。PPO 需要一个额外的价值模型来估计每一步的好坏;GRPO 去掉了价值模型,改成对同一个问题采样一组答案,用组内的相对好坏来算优势。课程第 2 讲讲后训练时提到过可验证奖励,按 Search-R1 论文,这里的奖励是按规则判答案对不对,图里的奖励模型框指的就是这个打分规则,不是一个训练出来的打分模型。
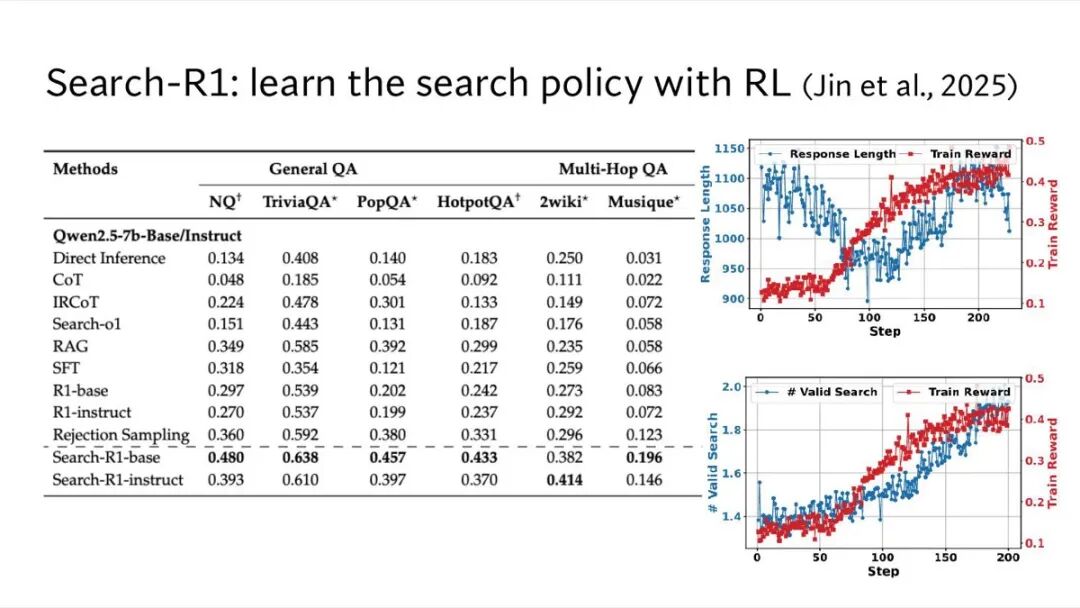
第 61 页是 Search-R1 的结果。
左表的基座模型是 Qwen2.5-7B 的 Base 和 Instruct 版本,论文里用的指标是精确匹配。数据集分两类:一般问答,NQ,TriviaQA,PopQA;多跳问答,HotpotQA,2wiki,Musique。
几行对照:直接推理在 NQ 上是 0.134;思维链 CoT 是 0.048;普通 RAG 是 0.349;监督微调 SFT 是 0.318;拒绝采样是 0.360。Search-R1-base 在 NQ 上是 0.480,TriviaQA 是 0.638,PopQA 是 0.457,HotpotQA 是 0.433,Musique 是 0.196,这五列都是全表最高。2wiki 一列最高的是 Search-R1-instruct,0.414。
右边两张训练曲线,横轴都是训练步数,从 0 到 200 多步。上图是回答长度和训练奖励:奖励前 70 多步基本持平在 0.1 出头,之后上涨到 0.4 以上;回答长度在前 100 步里有所下降,最低降到 1,000 以下,之后又回升。下图是有效搜索次数和训练奖励:有效搜索次数从 1.4 左右涨到接近 2,和奖励一起往上走。
补充多跳问答指的是答案需要把两条以上的信息串起来才能得到,比如上一页那个「谁年纪大」的问题,就要分别查到两个人的出生日期再比较。
七、失败模式
RAG 出问题的地方分三处:检索那一侧,读检索结果的模型那一侧,agent 循环那一侧,每处课件列了三种。
第 62 页是大纲,最后一项「失败模式」亮起。
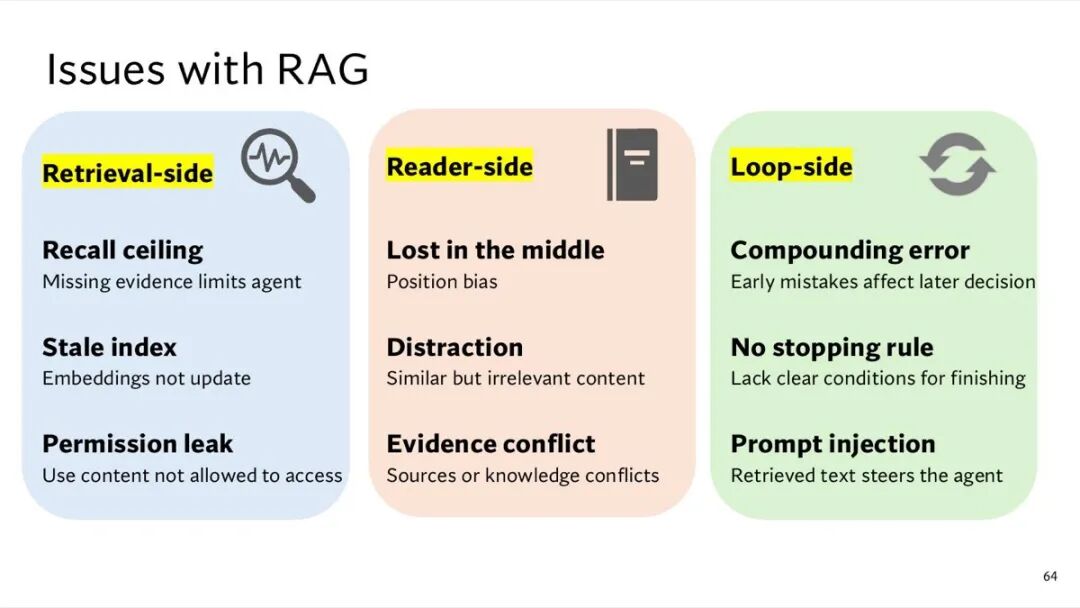
第 63 页是 RAG 的问题,三栏,每栏三条。
检索侧。召回上限:证据没被检索到,agent 能做的就有限。索引过期:embedding 没有更新。权限泄漏:用到了本不该访问的内容。
阅读侧。迷失在中间:模型对位置有偏好。干扰:内容相似,但其实不相关。证据冲突:不同来源之间,或者来源和模型自己的知识之间互相矛盾。
循环侧。错误累积:早期的错误影响后面的决定。没有停止规则:缺少明确的结束条件。提示注入:检索到的文本操纵了 agent。
补充「迷失在中间」出自 Liu 等人 2023 年的论文《Lost in the Middle》:相关信息放在长上下文的开头或结尾时,模型用得最好;放在中间时,表现明显下降。
最后
这一讲的课件到第 63 页就结束了,没有总结页。把这 63 页压成几段话:
检索让语言模型在回答前先查到相关内容。好处有两个:文档随时可以更新,答案能指回出处。RAG 把检索器和生成器接在一起,可以一起训练,在开放域问答上比只靠模型参数的做法好。
建索引的第一件事是切块,块太小缺上下文,太大混主题。上下文检索让 LLM 给每个块补一句背景,延迟切块让编码器先读完整篇再切,RAPTOR 和 GraphRAG 往上建摘要层,用来回答需要综合全局的问题,RAPTOR 针对一篇长文档,GraphRAG 针对整个文档库。向量多了要用近似最近邻,HNSW 是其中一种。
检索器有三类。BM25 靠词重合,到今天还在广泛使用,擅长编号和错误码这类精确的词。DPR 把问题和段落变成向量,在 5 个数据集里的 4 个上胜过 BM25,1,000 个问答对就够。ColBERT 每个 token 留一个向量,速度介于快的检索器和交叉编码器之间,在 MS MARCO 上的重排序精度和 BERT 交叉编码器相当。两种检索器出错的地方不同,可以用倒数排名融合合起来,再用交叉编码器在短名单上重排。
放进 agent 以后,检索变成 agent 的一个动作,要决定搜不搜,搜什么,结果够不够。Self-RAG 让模型学会给自己打标签,CRAG 用评估器决定要不要去网上补搜,Search-R1 用强化学习学会多轮搜索。
出问题的地方分三侧:检索侧有召回上限,索引过期,权限泄漏;阅读侧有迷失在中间,干扰,证据冲突;循环侧有错误累积,没有停止规则,提示注入。
据课程官网,这一讲的必读是 Lewis 等人的《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》,NeurIPS 2020,第 14 页的图就出自这一篇:
https://arxiv.org/abs/2005.11401
选读是 Khattab 和 Zaharia 的 ColBERT 论文,SIGIR 2020,第 51 到 53 页的图出自这一篇:
https://arxiv.org/abs/2004.12832
按官网课表,下一讲是 10 月 5 日的「Tool Use & Function Calling」,内容包括 REPL,函数调用 API,MCP,怎样设计好用的工具,代码执行沙箱,错误处理和重试,还有一段动手环节:从零搭一个会用工具的系统。作业 1 也在同一天发布。
本文是斯坦福 CS 329Z《Engineering AI Agents》(Fall 2026)第 3 讲课件的逐页讲解,非官方笔记,内容以课件原件为准。课件版权归讲师 Diyi Yang、Michael Ryan、John Yang。课程主页 https://cs329z.stanford.edu/ ,本讲课件 PDF https://drive.google.com/file/d/1q6HIZHlfIKgV8GOXubSdz1EkDukOm7pE/view (链接来自课程主页课表里第 3 讲的 Slides)。

内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢